- 임커밋의 딥러닝 / 머신러닝 강의 정리
논문이 헷갈리는 이유
2023년 무렵부터 생성 모델 논문에는 diffusion과 함께 flow matching, rectified flow 같은 말이 자주 나온다. 그런데 flow matching 논문(Lipman et al., 2023, Flow Matching for Generative Modeling)을 펴면 처음부터 헷갈림이 쌓인다.
- 초록에서 continuous normalizing flow(CNF), Neural ODE, diffusion을 한꺼번에 언급한다.
- 본론에 들어가자마자 확률 경로(probability path)가 등장한다.
- 모델이 vector field를 예측한다고 한다.
- 손실은 익숙한 MSE처럼 생겼는데, 정답 자리에 다시 vector field가 들어 있다.
- 그러고는 적분을 하더니 “marginal vector field가 marginal probability path를 만든다”라고 한다.
이 글은 이 순서를 풀어 간다. 먼저 vector field가 무엇인지, 그것을 “회귀한다”는 말이 무슨 뜻인지, 그리고 그것이 어떻게 생성 모델이 되는지를 보고, 마지막으로 논문의 손실이 실제로 계산 가능한 형태가 되는 과정과 코드를 정리한다.
Vector field: 나를 움직이게 하는 기운
▶ 시각화로 이해하는 flow matching: vector field
Vector field(벡터장)는 공간의 각 점에 벡터 하나씩을 대응시킨 것이다. 물리학에서는 흐름이나 움직임의 크기와 방향을 나타낼 때 쓴다. 중력장이나 전기장이 대표적인 예이다. 간단히 말하면 vector field는 어떤 위치에 있을 때 나를 어느 방향으로 얼마나 움직이게 하는가를 알려 주는 기운이다.
중요한 점은 vector field가 위치에 대한 함수라는 것이다.
\[u : \mathbb{R}^d \to \mathbb{R}^d, \qquad x \mapsto u(x)\]위치 \(x\)를 넣으면 그 위치에서의 벡터 \(u(x)\)가 나온다. 함수를 알면 어느 위치에서든 벡터를 알 수 있으므로, vector field는 특정한 점 하나가 아니라 공간 전체에 대한 개념이다. Flow matching에서는 시간 \(t \in [0, 1]\)에 따라 장이 바뀔 수 있어서 \(u_t(x)\)로 쓴다.
Vector field를 따라 움직이는 점의 궤적은 상미분 방정식(ODE)으로 정해진다.
\[\frac{dx_t}{dt} = u_t(x_t)\]그래서 아무 데나 점을 놓고 그 위치의 화살표를 따라 조금씩 움직이기를 반복하면, 장이 정해 주는 길을 따라가게 된다.
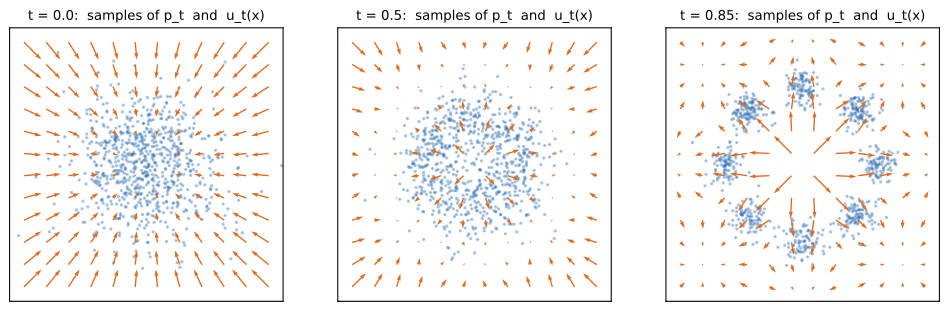 시간에 따라 바뀌는 vector field \(u_t(x)\)(주황 화살표)와 그 시점의 점들(파랑). \(t = 0\)에서는 점들이 가우시안 노이즈이고, 화살표가 데이터(원 위의 8개 덩어리)가 있는 쪽으로 점들을 민다. \(t = 0.85\)에서는 점들이 거의 덩어리에 도착했고, 화살표는 각 덩어리 중심을 향한다.
그런데 여기서 두 가지 의문이 생긴다.
- 딥러닝 모델은 데이터로 학습한다. vector field는 함수인데, 함수가 어떻게 학습 데이터가 되는가?
- 생성 모델은 노이즈에서 이미지를 만든다. 공간에 대한 화살표 모음인 vector field가 이미지 생성과 무슨 상관인가?
Vector field를 회귀한다는 말
▶ 시각화로 이해하는 flow matching: regression
논문은 “모델이 flow matching 손실로 vector field를 회귀(regress)한다”라고 쓴다. 회귀한다는 말은 사실상 예측한다에 가깝다. 어떤 입력에서 집값을 맞히는 모델에 대해 “the model regresses the house price”라고 말하는 것과 같다.
헷갈리는 부분은 회귀하는 대상이 집값 같은 숫자가 아니라 함수라는 점이다. 하지만 이것은 표현의 차이일 뿐이다. 같은 집값 모델을 이렇게도 말할 수 있다.
- The model regresses the house price. (모델이 집값을 회귀한다.)
- The model regresses the function whose input is a house and whose output is its price. (모델이 “입력이 집이고 출력이 가격인 함수”를 회귀한다.)
두 문장은 같은 뜻이다. 뒤의 표현이 더 학술적으로 들릴 뿐이다. 결국 “함수를 회귀한다”는 말은 이런 입력에 이런 출력을 내도록 학습시킨다는 뜻이다.
Vector field에 적용하면 다음과 같다. vector field는 위치를 받아 그 위치의 벡터를 내는 함수이므로, 이를 회귀하는 모델 \(v_\theta\)는
- 입력: 위치 \(x\) (그리고 시간 \(t\)),
- 출력: 그 위치에서의 변화량, 즉 벡터 \(v_\theta(t, x) \in \mathbb{R}^d\)
이다. 이것이 flow matching에서 신경망이 하는 역할의 전부이다. 논문의 flow matching(FM) 손실은 이 출력과 정답 vector field \(u_t\)의 MSE이다.
\[\mathcal{L}_{\text{FM}}(\theta) = \mathbb{E}_{t \sim \mathcal{U}[0,1],\ x \sim p_t(x)}\left\lVert v_\theta(t, x) - u_t(x)\right\rVert^2\]여기서 \(p_t\)는 시간 \(t\)에서 점들의 분포로, \(p_0\)는 노이즈 분포 \(\mathcal{N}(0, I)\), \(p_1\)은 데이터 분포 \(q\)에 가깝게 되도록 정한다. 시간에 따라 이어지는 분포의 열 \(\{p_t\}\)가 확률 경로(probability path)이고, \(u_t\)는 점들을 그 경로대로 옮기는 vector field이다.
그런데 논문은 곧바로 이 정답 \(u_t(x)\)를 계산할 수 없다고 한다. VAE의 posterior도, normalizing flow의 우도도 처음에는 계산할 수 없다고 했다가 어떤 기법으로 풀어냈던 것과 같은 패턴이다. 여기서는 그 기법이 conditional flow matching이다. 무엇이 계산할 수 없고 어떻게 해결되는지는 생성 과정을 먼저 본 뒤에 정리한다.
Vector field가 생성 모델이 되는 방법
▶ 시각화로 이해하는 flow matching: 생성 모델
VAE, GAN, flow 기반 모델, diffusion 모두 생성은 같은 세 단계를 따른다. 가우시안 노이즈를 샘플링하고, 딥러닝 모델에 통과시키고, 이미지를 얻는다. Flow matching도 같다.
Flow matching 모델의 입력과 출력은 데이터와 같은 shape이다. 만드는 이미지가 높이, 너비, 채널이 \(28 \times 28 \times 1\)이면 입력도 출력도 \(28 \times 28 \times 1\)이다. 이 두 텐서의 의미를 이해하려면 벡터의 차부터 보면 된다.
벡터의 차와 이동
두 벡터의 차 \(a - b\)는 같은 위치의 성분끼리 뺀 벡터이다. 그래서 두 벡터의 성분 수가 같아야 하고, 결과도 같은 크기이다. 임의 차원의 텐서도 마찬가지로 shape이 같으면 성분별로 뺄 수 있다.
텐서의 차도 방정식처럼 이항할 수 있다. \(a - b = c\)이면 \(a = b + c\)이다. 이것을 “\(b\)에 있던 점이 벡터 \(c\)만큼 이동하면 \(a\)에 도착한다”라고 읽을 수 있다.
Flow matching 모델은 바로 이 \(b\)를 입력받아 \(c\)를 출력한다. 엄밀히는 모델 출력에 작은 상수(시간 간격 \(\Delta t\))를 곱한 것이 \(c\)이다. 그러면 \(a = b + c\)로 다음 위치를 구하고, 그 \(a\)를 다시 새로운 \(b\)로 모델에 넣는 과정을 반복한다.
노이즈에서 고양이로
이미지로 옮겨 보자. 처음 \(b\)는 순수한 노이즈 \(x_0\)이다. 모델은 “고양이 이미지 빼기 노이즈”, 즉 노이즈에서 고양이로 향하는 차이 \(x_1 - x_0\)를 출력한다. 이를 16등분해서(\(\Delta t = 1/16\)을 곱해서) 더하면, \(\tfrac{15}{16}\)은 노이즈이고 \(\tfrac{1}{16}\)은 고양이인 이미지가 된다. 이것을 다시 모델에 넣어 차이를 얻고 16등분해서 더하면 \(\tfrac{2}{16}\)만큼 고양이인 이미지가 된다. 이렇게 14번 더 반복하면 \(\tfrac{16}{16}\), 즉 완전한 고양이 이미지가 된다.
\[x_{t + \Delta t} = x_t + \Delta t \cdot v_\theta(t, x_t), \qquad t = 0, \tfrac{1}{16}, \dots, \tfrac{15}{16}\]이것은 앞의 ODE \(dx_t/dt = v_\theta(t, x_t)\)를 오일러 방법(Euler method)으로 푸는 것과 같다.
숫자로 확인. 한 픽셀만 보자. 노이즈 값이 \(x_0 = -1.2\), 고양이 이미지의 값이 \(x_1 = 0.8\)이고 모델이 차이 \(x_1 - x_0 = 2.0\)을 정확히 출력한다고 하자. 한 단계에 \(2.0/16 = 0.125\)씩 이동하므로
- 1단계 후: \(-1.2 + 0.125 = -1.075 = \tfrac{15}{16}(-1.2) + \tfrac{1}{16}(0.8)\)
- 8단계 후: \(-1.2 + 1.0 = -0.2\) (노이즈와 고양이의 정확히 중간)
- 16단계 후: \(-1.2 + 2.0 = 0.8 = x_1\)
이다. 매 단계의 값이 노이즈와 고양이를 \((1 - t) : t\)로 섞은 값과 정확히 일치한다.
이제 vector field와의 관계가 분명하다. vector field는 “움직이게 하는 기운”이었다. 현재 상태 \(b\)를 넣었을 때 모델이 내는 \(c\)가 바로 현재 상태를 고양이 쪽으로 움직이게 하는 기운이다. 모델은 공간의 모든 위치(노이즈가 조금 낀 이미지, 많이 낀 이미지 등)에서 “어느 쪽으로 가야 데이터가 되는가”를 알려 주는 vector field이고, 생성은 그 장을 따라 조금씩 흘러가는 것이다.
계산할 수 없는 정답과 conditional flow matching
이 절은 영상 시리즈가 다음 편으로 미룬 부분으로, 논문(Lipman et al., 2023)의 내용을 정리한 것이다.
무엇이 계산 불가능한가
위의 고양이 예에서는 노이즈 \(x_0\)와 고양이 \(x_1\)이 짝지어져 있었다. 하지만 생성할 때 모델은 어느 고양이로 갈지 모른다. 어떤 노이즈 이미지 \(x\)는 수많은 데이터 \(x_1\)로 향하는 길 위에 동시에 있을 수 있기 때문이다. 그 위치의 진짜 정답 \(u_t(x)\)는 그 모든 가능성의 평균이다.
\[u_t(x) = \int u_t(x \mid x_1)\,\frac{p_t(x \mid x_1)\,q(x_1)}{p_t(x)}\,dx_1, \qquad p_t(x) = \int p_t(x \mid x_1)\,q(x_1)\,dx_1\]- \(q(x_1)\): 데이터 분포. \(p_t(x \mid x_1)\): 데이터 하나 \(x_1\)로 가는 조건부 확률 경로(conditional probability path).
- \(u_t(x \mid x_1)\): 그 경로를 만드는 조건부 vector field.
- \(u_t(x)\), \(p_t(x)\): 모든 데이터에 대해 평균한 marginal vector field와 marginal probability path.
논문의 “marginal vector field가 marginal probability path를 만든다”는 문장이 바로 이 식이다. 문제는 적분이 데이터 분포 전체에 걸쳐 있다는 것이다. 이미지 데이터셋의 모든 이미지에 대해 이 적분을 매 학습 스텝마다 계산할 수는 없다.
해결: 데이터 하나에 조건을 건다
해결책은 diffusion 손실 유도에서 \(x_0\)에 조건을 걸었던 것과 비슷하다. 정답을 marginal 대신 데이터 하나에 조건을 건 vector field로 바꾼다. Conditional flow matching(CFM) 손실은 다음과 같다.
\[\mathcal{L}_{\text{CFM}}(\theta) = \mathbb{E}_{t,\ x_1 \sim q,\ x \sim p_t(x \mid x_1)}\left\lVert v_\theta(t, x) - u_t(x \mid x_1)\right\rVert^2\]논문의 핵심 정리는 두 손실의 기울기가 같다는 것이다: \(\nabla_\theta \mathcal{L}_{\text{FM}} = \nabla_\theta \mathcal{L}_{\text{CFM}}\). 이유는 짧다. 두 제곱을 전개하면 \(\Vert v_\theta\Vert ^2\) 항의 기댓값은 같고(어느 쪽이든 \(x \sim p_t\)), \(\Vert u\Vert ^2\) 항은 \(\theta\)와 무관하다. 남은 교차항은 위의 marginal 정의에 의해
\[\mathbb{E}_{p_t(x)}\langle v_\theta(t, x), u_t(x)\rangle = \mathbb{E}_{q(x_1)\,p_t(x \mid x_1)}\langle v_\theta(t, x), u_t(x \mid x_1)\rangle\]로 같다. 그래서 계산할 수 있는 CFM으로 학습해도 모델은 결국 marginal \(u_t(x)\)를 회귀하게 된다. 같은 위치 \(x\)에 서로 다른 정답이 여러 번 주어지면 MSE를 최소화하는 출력은 그 평균이기 때문이다.
가장 단순한 경로: 직선
조건부 경로로는 노이즈와 데이터를 잇는 직선이 가장 많이 쓰인다. 논문은 \(\sigma_{\min}\)이라는 작은 값을 둔 형태를 제시한다.
\[x_t = \psi_t(x_0) = \left(1 - (1 - \sigma_{\min})\,t\right)x_0 + t\,x_1, \qquad \frac{d}{dt}\psi_t(x_0) = x_1 - (1 - \sigma_{\min})\,x_0\]\(\sigma_{\min} = 0\)으로 두면 rectified flow와 같은 형태가 된다.
\[x_t = (1 - t)\,x_0 + t\,x_1, \qquad u_t(x_t \mid x_1) = x_1 - x_0\]- \(x_0 \sim \mathcal{N}(0, I)\)는 노이즈, \(x_1 \sim q\)는 데이터, \(t \sim \mathcal{U}[0, 1]\)이다.
- 정답 벡터는 \(t\)와 무관하게 “데이터 빼기 노이즈”이다. 영상에서 모델 출력이 “고양이 빼기 노이즈”였던 것이 이것이다.
조건부 경로는 직선이지만, 무작위로 짝지어진 수많은 직선을 평균한 marginal vector field는 일반적으로 곡선 궤적을 만든다.
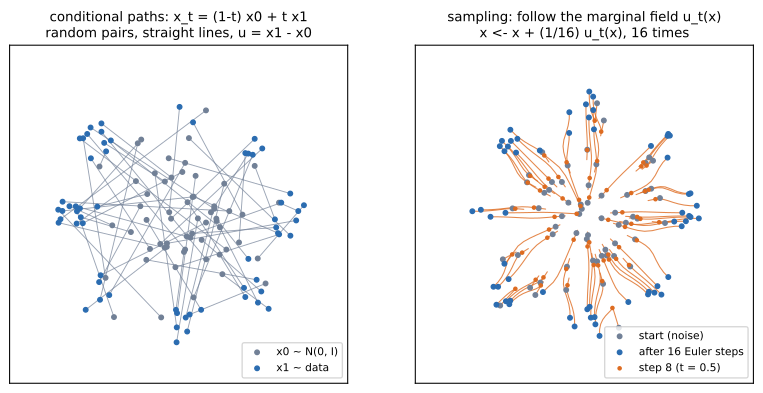 왼쪽: 학습 때 쓰는 조건부 경로. 노이즈(회색)와 데이터(파랑)를 무작위로 짝지은 직선이며, 정답은 \(x_1 - x_0\)이다. 직선들이 서로 엇갈린다. 오른쪽: 생성 때 따라가는 marginal vector field. 같은 위치의 엇갈리는 정답들이 평균되어, 궤적은 서로 교차하지 않고 휘어지며 대체로 가까운 덩어리로 간다. 16번의 오일러 스텝으로 데이터에 도착한다.
PyTorch 구현
코드는 놀라울 만큼 짧다. 학습은 “노이즈와 데이터를 뽑고, 무작위 \(t\)로 섞고, 그 위치에서 \(x_1 - x_0\)를 예측하게 한다”가 전부이고, 생성은 위의 오일러 반복이다.
import torch
import torch.nn as nn
import torch.nn.functional as F


class VelocityMLP(nn.Module):
    def __init__(self, dim=2, hidden=256):
        super().__init__()
        self.net = nn.Sequential(nn.Linear(dim + 1, hidden), nn.SiLU(),
                                 nn.Linear(hidden, hidden), nn.SiLU(),
                                 nn.Linear(hidden, hidden), nn.SiLU(), nn.Linear(hidden, dim))

    def forward(self, t, x):                              # t: (B,) in [0, 1], x: (B, dim)
        return self.net(torch.cat([x, t[:, None]], dim=1))


def cfm_loss(model, x1):
    x0 = torch.randn_like(x1)                             # noise
    t = torch.rand(x1.shape[0], device=x1.device)
    t_ = t.view(-1, *([1] * (x1.dim() - 1)))              # broadcast over data dims
    x_t = (1 - t_) * x0 + t_ * x1                         # point on the straight path
    target = x1 - x0                                      # conditional vector field
    return F.mse_loss(model(t, x_t), target)


@torch.no_grad()
def sample(model, x0, n_steps=16):
    x, dt = x0, 1.0 / n_steps
    for k in range(n_steps):
        t = torch.full((x.shape[0],), k * dt, device=x.device)
        x = x + dt * model(t, x)                          # a = b + c
    return x


model = VelocityMLP()
opt = torch.optim.Adam(model.parameters(), lr=1e-3)
data = torch.randn(4096, 2) * 0.3 + torch.tensor([2.0, 0.0])   # stand-in dataset

for step in range(500):
    x1 = data[torch.randint(0, len(data), (256,))]
    loss = cfm_loss(model, x1)
    opt.zero_grad(); loss.backward(); opt.step()

x = sample(model, torch.randn(1000, 2))
print(x.mean(0))                                          # close to (2, 0)
Diffusion의 DDPM 코드와 비교하면 차이가 잘 보인다.
| DDPM | Flow matching (직선 경로) | |
|---|---|---|
| 시간 방향 | \(t = 0\)이 데이터, \(t = T\)가 노이즈 | \(t = 0\)이 노이즈, \(t = 1\)이 데이터 |
| 학습 입력 | \(\sqrt{\bar\alpha_t}\,x_0 + \sqrt{1-\bar\alpha_t}\,\epsilon\) | \((1-t)\,x_0 + t\,x_1\) |
| 정답 | 섞은 노이즈 \(\epsilon\) | 속도 \(x_1 - x_0\) |
| 계수 테이블 | \(\beta_t\), \(\bar\alpha_t\) 등을 미리 계산 | 필요 없음 |
| 생성 | 확률적, 1000단계 | 결정론적 ODE, 오일러 몇 십 단계 (고차 solver도 가능) |
정리
- Vector field는 위치(와 시간)를 넣으면 그 위치에서의 이동 방향 벡터를 내는 함수이다. 공간 전체에 대한 개념이다.
- Vector field를 회귀한다는 것은 모델이 위치 \(x_t\)와 시간 \(t\)를 입력받아 그 위치의 벡터를 출력하도록 학습한다는 뜻이다. 입출력은 데이터와 같은 shape이다.
- 생성은 노이즈에서 시작해 \(x \leftarrow x + \Delta t \cdot v_\theta(t, x)\)를 반복하는 것이다. 벡터의 차 \(a - b = c\)를 \(a = b + c\)로 읽는 것과 같고, ODE를 오일러 방법으로 푸는 것이다.
- 정답 marginal vector field는 데이터 전체에 대한 적분이라 계산할 수 없다. 대신 데이터 하나에 조건을 건 conditional flow matching 손실을 쓰면 기울기가 같다.
- 직선 경로 \(x_t = (1-t)x_0 + t x_1\)에서 정답은 \(x_1 - x_0\)이고, 손실은 그 MSE이다.
Vector field를 따라 흐르며 분포를 옮긴다는 관점은 Neural ODE의 continuous normalizing flow와 같다. 차이는 Neural ODE가 ODE를 풀며 우도로 학습하는 반면, flow matching은 정답 벡터를 직접 회귀하므로 학습 중에 ODE를 풀 필요가 없다는 점이다.