- 임커밋의 딥러닝 / 머신러닝 강의 정리
Neural ODE(Chen et al., NeurIPS 2018 best paper)라는 이름에는 미분 방정식, 수치해, 신경망이라는 세 단어가 겹쳐 있어서 처음 보면 막막하다. 이 글은 그 세 단어를 차례로 풀어 간다.
- 미분 방정식의 해는 숫자가 아니라 함수이다.
- 해를 “수치적으로 구한다”는 것은 원하는 곳의 도함수 값을 알고, 그것을 조금씩 쌓아 함수값을 얻는다는 뜻이다.
- Neural ODE는 그 도함수, 즉 속도를 신경망이 예측하게 하는 방법이다.
방정식과 미분 방정식
방정식(equation)은 미지수가 들어 있는 등식이다. \(2x = 0\)이나 \(x + 5 = 0\)처럼 쓰고, 등식을 참으로 만드는 미지수를 찾는 것을 방정식을 푼다고 한다. 이때 구한 해(solution)는 숫자이다(\(x = 0\), \(x = -5\)).
미분 방정식(differential equation)도 방정식이다. 다만 헷갈리기 쉬운 차이가 하나 있다.
미분 방정식의 미지수는 함수이고, 따라서 해도 숫자가 아니라 함수이다.
미분 방정식은 미지 함수 \(f\)의 도함수(derivative)가 들어 있는 등식이다. 예를 들어
\[f'(x) + 5 = 0\]은 도함수 \(f'\)이 들어 있으므로 미분 방정식이다. 이 식을 참으로 만드는 함수를 찾으려면 \(f'(x) = -5\)의 양변을 \(x\)로 적분하면 된다.
\[f(x) = -5x + C\]\(C\)는 아무 상수이다. 즉 “기울기가 \(-5\)인 모든 직선”이 이 미분 방정식의 해이다. 숫자 하나를 답으로 내는 방정식과 달리, 미분 방정식을 푼다는 것은 어떤 꼴의 함수인지를 알아내는 것이다. 여기에 한 점의 값, 예를 들어 \(f(0) = 3\)을 초기 조건(initial condition)으로 주면 \(C = 3\)으로 정해져 해가 하나로 정해진다.
상미분 방정식(ordinary differential equation, ODE)은 미지 함수의 변수가 하나뿐인 미분 방정식이다. Neural ODE에서 그 변수는 시간 \(t\)이고, 보통 다음 꼴을 다룬다.
\[\frac{dy(t)}{dt} = f\big(t, y(t)\big), \qquad y(t_0) = y_0\]\(y(t)\)는 시간에 따라 변하는 상태(위치, 은닉 벡터 등)이고, \(f\)는 “지금 시각 \(t\)에 상태가 \(y\)라면 어느 방향으로 얼마나 빨리 변하는가”, 즉 속도를 알려 주는 함수이다.
수치해: 도함수를 쌓아 함수값을 얻는다
대부분의 미분 방정식은 위 예처럼 깔끔한 해의 식을 구할 수 없다. 그래서 컴퓨터의 반복 계산으로 해를 근사한다. 이것을 수치적으로(numerically) 푼다고 한다.
보통 방정식이라면 뜻이 분명하다. 어려운 방정식 \(g(x) = 0\)에 대해 알고리즘이 \(g(1.9) = 0.001\)을 찾아냈다면 “해는 약 1.9”라고 말할 수 있다. 그런데 해가 함수라면 “함수를 수치적으로 구한다”는 말은 무슨 뜻일까?
답은 이렇다. 해 함수 \(y(t)\)의 식은 몰라도, 원하는 아무 지점에서 도함수 값 \(y'(t)\)를 계산할 수 있다면 해를 수치적으로 구한 것으로 본다. 도함수를 알면, 기준이 되는 한 점의 값만 있으면 원하는 지점의 함수값을 쌓아서 얻을 수 있기 때문이다.
예를 들어 \(y(1)\)을 알고 \(y(2)\)를 구하고 싶다고 하자. 짧은 구간 \(h = 0.1\) 동안에는 기울기가 거의 일정하다고 보고
\[y(1.1) \approx y(1) + 0.1 \cdot y'(1), \qquad y(1.2) \approx y(1.1) + 0.1 \cdot y'(1.1), \qquad \dots\]를 10번 반복하면 \(y(2)\)의 근삿값이 나온다. 일반적으로 쓰면 이것이 오일러 방법(Euler method)이다.
\[y_{n+1} = y_n + h \, f(t_n, y_n), \qquad t_{n+1} = t_n + h\]“기울기 \(\times\) 구간 길이 = 그 구간 동안의 변화량”을 계속 더해 가는 것이다.
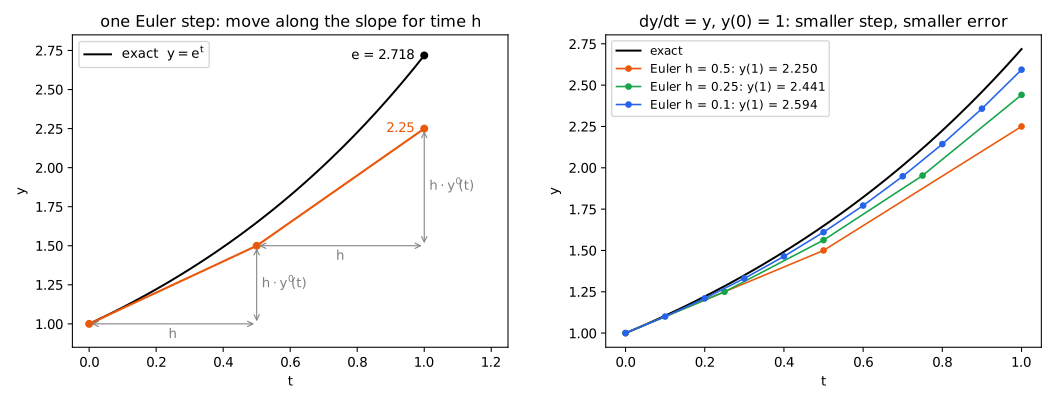 \(dy/dt = y\), \(y(0) = 1\)의 정확한 해는 \(y = e^t\)이다. 왼쪽: 오일러 방법의 한 스텝은 현재 점의 기울기를 따라 \(h\)만큼 직진하는 것이다. 오른쪽: 스텝 \(h\)를 줄일수록 \(y(1)\)의 근삿값이 \(e = 2.718\)에 가까워진다.
구간 길이 \(h\)는 정확도와 계산량을 맞바꾸는 손잡이이다. \(dy/dt = y\), \(y(0) = 1\)로 \(y(1) = e\)를 근사해 보면 다음과 같다.
| 스텝 \(h\) | 반복 횟수 | \(y(1)\) 근삿값 | 오차 |
|---|---|---|---|
| 0.5 | 2 | 2.2500 | 0.468 |
| 0.25 | 4 | 2.4414 | 0.277 |
| 0.1 | 10 | 2.5937 | 0.125 |
| 0.01 | 100 | 2.7048 | 0.013 |
오차는 대략 \(h\)에 비례해서 줄어든다(오일러 방법은 1차 방법이다).
def euler(f, y0, t0, t1, h):
    y, t = y0, t0
    for _ in range(round((t1 - t0) / h)):
        y = y + h * f(t, y)      # 기울기 x 구간 길이만큼 이동
        t = t + h
    return y

for h in [0.5, 0.25, 0.1, 0.01]:
    print(h, euler(lambda t, y: y, 1.0, 0.0, 1.0, h))
# 0.5 2.25 / 0.25 2.44140625 / 0.1 2.5937... / 0.01 2.7048...
실전의 ODE solver는 같은 아이디어를 더 정교하게 쓴다. 한 스텝 안에서 기울기를 여러 번 계산해 평균 내는 Runge-Kutta 방법(4차 RK4는 같은 \(h = 0.25\)로도 오차가 \(7 \times 10^{-5}\) 정도이다)이나, 오차를 추정해 스텝 크기를 자동으로 조절하는 적응형 solver(예: Dormand-Prince, dopri5)가 그렇다. 어느 것이든 입력은 같다. 속도 함수 \(f\), 시작 상태 \(y_0\), 원하는 시각들을 주면 그 시각들의 상태를 돌려준다.
Neural ODE: 신경망이 속도를 예측한다
이제 Neural ODE의 정의를 다시 읽으면 뜻이 보인다. “미분 방정식의 해를 신경망을 이용해 수치적으로 구한다”는 것은 위 식의 속도 함수 \(f\)를 신경망 \(f_\theta\)로 두겠다는 뜻이다.
\[\frac{dy(t)}{dt} = f_\theta\big(t, y(t)\big)\]\(\theta\)는 신경망의 파라미터이다. Neural ODE는 새로운 층 구조가 아니다. 신경망 자체는 평범한 MLP여도 되고, 달라지는 것은 출력의 의미이다. 출력이 다음 위치가 아니라 지금 위치에서의 속도(도함수)이고, 위치는 ODE solver로 적분해서 얻는다.
왜 필요한가: 간격이 일정하지 않은 시계열
야생 동물에 단 위치 추적기처럼, 어떤 대상이 언제 어디 있었는지를 기록한 데이터를 생각해 보자. 데이터는 \((t_1, y_1), (t_2, y_2), (t_3, y_3), \dots\) 꼴인데, 관측 간격이 1초일 때도 있고 10분일 때도 있다.
이것을 RNN으로 모델링하면 \(y_1 \to y_2 \to y_3\)을 한 스텝씩 같은 간격의 시퀀스로 다룬다. 1초 뒤의 관측과 10분 뒤의 관측이 똑같은 “한 스텝”이 되므로 시간 정보가 사라진다.
Neural ODE는 이 문제가 없다. 속도장 \(f_\theta\)를 배워 두면 어떤 시각이든 적분 구간만 바꿔서 상태를 계산할 수 있다. 1초 뒤든 10분 뒤든 \(\operatorname{ODESolve}(f_\theta, y_1, t_1, t_2)\)를 부르면 된다. 즉 Neural ODE는 RNN을 연속 시간으로 확장한 것으로 볼 수 있다.
학습: 속도로 보내고 위치로 교정한다
문제는 정답 속도 데이터가 없다는 것이다. 관측한 것은 위치뿐이다. 모델의 출력(속도)과 데이터(위치)의 종류가 달라서 바로 비교할 수 없다.
해결책은 모델 출력 뒤에 ODE solver를 붙이는 것이다.
- 데이터의 한 지점 \(y(t_i)\)에서 출발해, 신경망이 예측한 속도로 solver가 상태를 굴려 \(\hat{y}(t_{i+1}), \hat{y}(t_{i+2}), \dots\)를 만든다.
- 이 예측 위치를 실제 관측 위치와 비교해 손실을 만든다.
속도를 잘 예측했다면 적분한 위치가 실제 위치와 겹치고, 틀렸다면 엇나간다. solver의 연산(덧셈, 곱셈, 신경망 호출)은 모두 미분 가능하므로 손실의 기울기를 \(\theta\)까지 역전파할 수 있다.
Adjoint sensitivity method
solver 내부의 모든 스텝을 그대로 역전파하면, 스텝 수에 비례하는 중간값을 전부 메모리에 저장해야 한다. 논문은 이를 피하기 위해 adjoint sensitivity method를 쓴다. adjoint 상태 \(a(t) = \partial \mathcal{L} / \partial y(t)\)를 정의하면, 이것도 하나의 ODE를 따른다.
\[\frac{da(t)}{dt} = -a(t)^\top \frac{\partial f_\theta(t, y(t))}{\partial y}, \qquad \frac{d\mathcal{L}}{d\theta} = -\int_{t_1}^{t_0} a(t)^\top \frac{\partial f_\theta(t, y(t))}{\partial \theta}\,dt\]즉 \(y(t)\), \(a(t)\), 파라미터 기울기를 함께 시간을 거꾸로 적분해 기울기를 구한다. 중간값을 저장하지 않으므로 메모리 사용량이 스텝 수와 무관하다. 대신 역방향에서 ODE를 한 번 더 풀어야 한다. torchdiffeq에서는 odeint 대신 odeint_adjoint를 쓰면 이 방식으로 바뀐다.
예제 코드: 나선 궤적의 속도장 맞추기
논문 저자들이 공개한 torchdiffeq의 ode_demo.py를 데이터, 모델, 학습의 세 단계로 보자.
데이터. 정답 속도 규칙은 다음과 같다. 모델은 이 규칙을 모르고, 이 규칙으로 움직인 위치 기록만 본다.
\[\frac{dy}{dt} = (y^{\circ 3})\,A, \qquad A = \begin{bmatrix} -0.1 & 2.0 \\ -2.0 & -0.1 \end{bmatrix}\]\(y = (y_1, y_2)\)는 행벡터이고, \(y^{\circ 3}\)은 성분별 세제곱이다. 예를 들어 \((2, 0)\)에서는 \(y^{\circ 3} = (8, 0)\)이고 속도는 \((8, 0)A = (-0.8, 16)\)이다. 왼쪽으로 조금, 위로 빠르게 움직인다. \((1, 1)\)에서는 \((1, 1)A = (-2.1, 1.9)\)로 왼쪽 위(약 11시 방향)로 움직인다. 시작점 \((2, 0)\)에서 \(t \in [0, 25]\)를 1000개 시각으로 나눠 이 규칙대로 적분한 궤적이 true_y이다.
미니배치. get_batch는 궤적에서 임의의 출발점 20개를 고르고, 각 출발점부터 10개 시각(\(0, 0.025, \dots, 0.225\)만큼 지난 시각)의 실제 위치를 정답으로 묶는다.
모델과 학습. ODEFunc는 2차원 입력을 50차원으로 넓혔다가 2차원 속도를 내는 작은 MLP이다. 출력을 속도로 보고 odeint로 적분한 위치와 정답 위치의 L1 거리를 줄인다.
import torch
import torch.nn as nn
from torchdiffeq import odeint

torch.manual_seed(0)

# 데이터: 정답 속도 규칙 dy/dt = y^3 A 를 따라 움직인 궤적 (모델은 규칙을 모른다)
true_y0 = torch.tensor([[2.0, 0.0]])
t = torch.linspace(0.0, 25.0, 1000)
true_A = torch.tensor([[-0.1, 2.0], [-2.0, -0.1]])

class Lambda(nn.Module):
    def forward(self, t, y):
        return (y ** 3) @ true_A

with torch.no_grad():
    true_y = odeint(Lambda(), true_y0, t, method="dopri5")   # (1000, 1, 2)

def get_batch(batch_size=20, batch_time=10):
    s = torch.randint(0, len(t) - batch_time, (batch_size,))
    batch_y0 = true_y[s]                                     # (B, 1, 2) 출발점
    batch_t = t[:batch_time]                                 # 0, 0.025, ..., 0.225
    batch_y = torch.stack([true_y[s + i] for i in range(batch_time)])  # (T, B, 1, 2)
    return batch_y0, batch_t, batch_y

# 모델: 위치 y를 받아 그 위치의 속도 dy/dt를 출력한다
class ODEFunc(nn.Module):
    def __init__(self):
        super().__init__()
        self.net = nn.Sequential(nn.Linear(2, 50), nn.Tanh(), nn.Linear(50, 2))

    def forward(self, t, y):
        return self.net(y ** 3)

# 학습: 예측한 속도로 적분해 얻은 위치를 실제 위치와 비교한다
func = ODEFunc()
opt = torch.optim.RMSprop(func.parameters(), lr=1e-3)
for it in range(1, 5001):
    batch_y0, batch_t, batch_y = get_batch()
    pred_y = odeint(func, batch_y0, batch_t)                 # 속도 -> 위치
    loss = (pred_y - batch_y).abs().mean()
    opt.zero_grad(); loss.backward(); opt.step()
    if it % 1000 == 0:
        with torch.no_grad():
            full = odeint(func, true_y0, t)                  # 처음부터 끝까지 굴려 보기
            print(it, (full - true_y).abs().mean().item())
모델은 짧은 구간(0.225 시간)의 조각들만 보고 학습했지만, 학습이 끝난 뒤 시작점에서 \(t = 25\)까지 한 번에 적분해도 실제 궤적을 거의 그대로 따라간다. 위 코드에서 전체 궤적의 평균 오차는 5000번 반복 후 약 0.08이다. 속도를 배웠기 때문에, 짧은 조각에서 배운 규칙이 긴 시간에도 그대로 통하는 것이다.
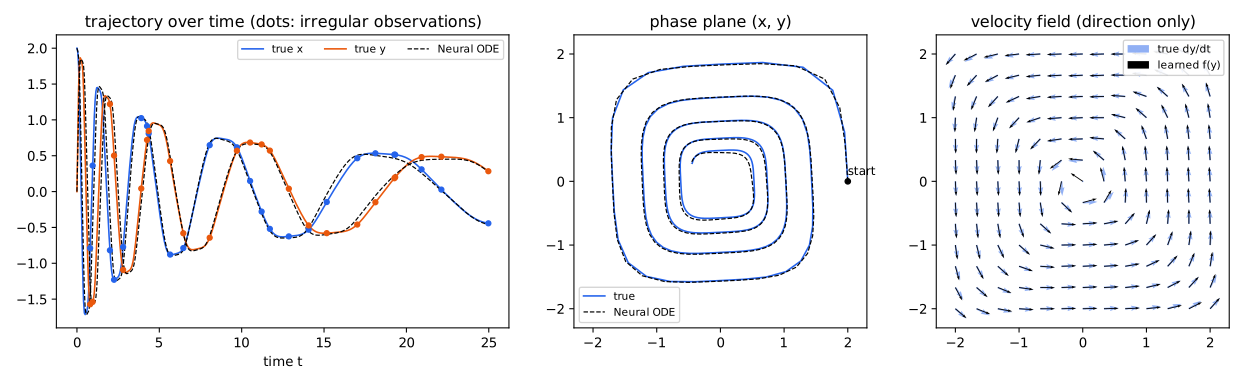 위 코드로 학습한 결과. 왼쪽: 시간에 따른 두 좌표. 점은 불규칙한 시각에 관측했다고 가정한 예로, Neural ODE는 어느 시각이든 적분해 값을 낼 수 있다. 가운데: \((y_1, y_2)\) 평면의 나선 궤적. 실선은 정답, 점선은 Neural ODE. 오른쪽: 각 위치의 속도 방향. 연한 파란 화살표는 정답 \((y^{\circ 3})A\), 검은 화살표는 학습된 \(f_\theta(y)\)이다.
한 문장으로 정리하면, Neural ODE로 모델링한다는 것은 “물체가 다음에 어디에 있을까”를 예측하는 것이 아니라 “물체가 어떤 속도로 움직이는가”를 예측하는 것이다.
ResNet과 continuous normalizing flow
논문은 이 이야기를 ResNet에서 시작한다. Residual block은
\[h_{k+1} = h_k + g_{\theta_k}(h_k)\]이고, 이것은 스텝 크기 \(h = 1\)인 오일러 방법 \(y_{n+1} = y_n + h\,f(t_n, y_n)\)과 모양이 같다. 층 번호 \(k\)를 시간으로 보고 스텝을 0으로 보내면 층이 연속적으로 이어진 ResNet, 즉 \(dh/dt = f_\theta(t, h(t))\)가 된다. 깊이를 미리 정하지 않고 solver가 필요한 만큼 스텝을 밟으며, 파라미터는 모든 “층”이 공유한다. 위의 시계열 예제(연속 시간 RNN)를 이해했다면 같은 아이디어를 깊이 방향에 적용한 것으로 보면 된다.
같은 논문은 생성 모델에도 이 틀을 쓴다. Flow 기반 모델이 가역 층을 여러 개 쌓아 가우시안을 데이터로 옮겼다면, 그 변환을 ODE 하나로 표현할 수 있다. 이때 변수 변환 공식은 행렬식 대신 대각합(trace)이 들어간 미분 방정식이 된다.
\[\frac{d \log p\big(z(t)\big)}{dt} = -\operatorname{tr}\left(\frac{\partial f_\theta}{\partial z(t)}\right)\]이것이 continuous normalizing flow(CNF)이고, 나중에 Flow Matching은 이 속도장을 ODE를 풀지 않고 직접 회귀로 학습하는 방법을 제시한다.
정리
| 개념 | 내용 |
|---|---|
| 미분 방정식 | 미지 함수의 도함수가 들어 있는 등식. 해는 숫자가 아니라 함수이다 |
| 수치해 | 원하는 지점의 도함수 값을 계산할 수 있으면, 기준점에서 출발해 함수값을 쌓아 얻을 수 있다 |
| 오일러 방법 | \(y_{n+1} = y_n + h\,f(t_n, y_n)\). \(h\)가 작을수록 정확하지만 반복이 늘어난다 |
| Neural ODE | 속도 \(dy/dt = f_\theta(t, y)\)를 신경망이 예측하고, 위치는 ODE solver로 적분한다 |
| 학습 | 정답 속도가 없으므로, 적분한 위치를 관측 위치와 비교한다. 기울기는 역전파 또는 adjoint method로 구한다 |
| 장점 | 관측 간격이 불규칙한 시계열을 자연스럽게 다룬다. ResNet의 연속 버전, CNF로도 확장된다 |