- 임커밋의 딥러닝 / 머신러닝 강의 정리
두 개의 과정: 노이즈를 더하는 q, 걷어내는 p
Diffusion 모델은 흔히 “노이즈가 Markov chain으로 조금씩 더해지는 forward process가 있고, 그 반대인 reverse process를 신경망이 학습한다”라고 설명된다. 틀린 말은 아니지만, 논문(Ho et al., 2020, Denoising Diffusion Probabilistic Models)을 읽거나 코드를 고치려면 이 정도로는 부족하다. 손실 함수가 어디서 왔는지, 그리고 그 수식이 코드의 어느 줄에 들어가 있는지를 알아야 한다. 이 글은 그 연결을 따라간다.
DDPM 논문은 첫머리에서 두 과정을 바로 보여 준다. 데이터 \(x_0\)에서 시작해 \(T\)단계에 걸쳐 노이즈를 섞는 forward process(diffusion process) \(q\)와, 순수한 노이즈 \(x_T\)에서 시작해 노이즈를 걷어내는 reverse process \(p_\theta\)이다.
\[q(x_{1:T} \mid x_0) = \prod_{t=1}^{T} q(x_t \mid x_{t-1}), \qquad q(x_t \mid x_{t-1}) = \mathcal{N}\!\left(x_t;\ \sqrt{1-\beta_t}\,x_{t-1},\ \beta_t I\right)\] \[p_\theta(x_{0:T}) = p(x_T)\prod_{t=1}^{T} p_\theta(x_{t-1} \mid x_t), \qquad p_\theta(x_{t-1} \mid x_t) = \mathcal{N}\!\left(x_{t-1};\ \mu_\theta(x_t, t),\ \Sigma_\theta(x_t, t)\right)\]- \(x_0\)는 데이터(이미지), \(x_1, \dots, x_T\)는 점점 노이즈가 많아지는 같은 크기의 잠재 변수(latent variable)이다. \(p(x_T) = \mathcal{N}(0, I)\)이다.
- \(\beta_t \in (0, 1)\)는 \(t\)번째 단계에서 섞는 노이즈의 양으로, 미리 정해 둔 노이즈 스케줄(noise schedule)이다. 논문은 \(T = 1000\), \(\beta_1 = 10^{-4}\)에서 \(\beta_T = 0.02\)까지 선형으로 늘린다.
- \(q\)에는 학습할 파라미터가 없다. 학습 대상은 \(p_\theta\)뿐이고, 아래첨자 \(\theta\)가 신경망이라는 표시이다. 평균 \(\mu_\theta\)(와 분산 \(\Sigma_\theta\))를 신경망이 출력한다는 점은 VAE의 디코더가 평균과 분산을 예측하던 것과 닮았다.
Forward process는 \(\alpha_t = 1 - \beta_t\), \(\bar\alpha_t = \prod_{s=1}^{t}\alpha_s\)로 두면 한 번에 건너뛸 수 있다. 가우시안을 여러 번 섞어도 가우시안이기 때문이다.
\[q(x_t \mid x_0) = \mathcal{N}\!\left(x_t;\ \sqrt{\bar\alpha_t}\,x_0,\ (1-\bar\alpha_t) I\right) \quad\Longleftrightarrow\quad x_t = \sqrt{\bar\alpha_t}\,x_0 + \sqrt{1-\bar\alpha_t}\,\epsilon,\ \ \epsilon \sim \mathcal{N}(0, I)\]논문의 스케줄로 계산하면 \(\bar\alpha_{100} \approx 0.897\), \(\bar\alpha_{250} \approx 0.524\), \(\bar\alpha_{500} \approx 0.079\), \(\bar\alpha_{1000} \approx 4.0 \times 10^{-5}\)이다. \(t = 1000\)에서 데이터 쪽 계수 \(\sqrt{\bar\alpha_T}\)는 약 0.006이므로, \(x_T\)는 사실상 표준 정규분포에서 뽑은 노이즈와 구별되지 않는다.
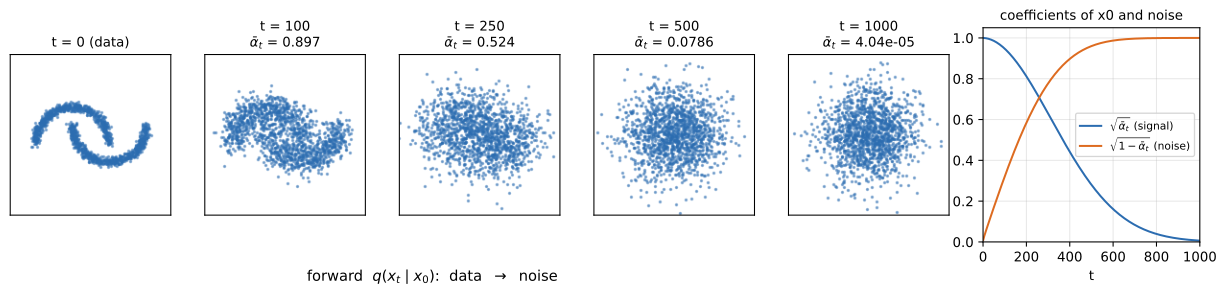 2차원 장난감 데이터(two moons)에 \(q(x_t \mid x_0)\)를 적용한 모습. 오른쪽은 \(x_0\)의 계수 \(\sqrt{\bar\alpha_t}\)(파랑)와 노이즈의 계수 \(\sqrt{1-\bar\alpha_t}\)(주황)이다. \(t = 500\) 무렵에 이미 데이터의 모양이 거의 사라진다.
손실 함수 유도: 조건과 대상의 자리 바꾸기
첫 번째 손실 식이 이상해 보이는 이유
논문은 곧바로 음의 로그 가능도(negative log-likelihood)의 상한(variational bound)을 손실로 제시한다(논문 식 3).
\[\mathbb{E}\left[-\log p_\theta(x_0)\right] \le \mathbb{E}_q\!\left[-\log p(x_T) - \sum_{t \ge 1} \log \frac{p_\theta(x_{t-1} \mid x_t)}{q(x_t \mid x_{t-1})}\right] =: L\]VAE의 ELBO와 비슷한 꼴이지만 위화감이 있다. 분자 \(p_\theta(x_{t-1} \mid x_t)\)는 \(x_t\)가 주어졌을 때 \(x_{t-1}\)의 분포이고, 분모 \(q(x_t \mid x_{t-1})\)은 반대로 \(x_{t-1}\)이 주어졌을 때 \(x_t\)의 분포이다. 조건과 대상이 뒤집혀 있으니 둘을 직접 “닮게” 만들 수가 없다. \(p_\theta\)가 \(q\)를 그대로 따라 하면 노이즈를 걷어내는 대신 오히려 더하게 될 것 같다.
논문은 몇 줄 뒤에 같은 손실을 다음처럼 다시 쓴다(논문 식 5).
\[L = \mathbb{E}_q\Big[\underbrace{D_{KL}\big(q(x_T \mid x_0)\,\Vert \,p(x_T)\big)}_{L_T} + \sum_{t>1} \underbrace{D_{KL}\big(q(x_{t-1} \mid x_t, x_0)\,\Vert \,p_\theta(x_{t-1} \mid x_t)\big)}_{L_{t-1}} \underbrace{-\log p_\theta(x_0 \mid x_1)}_{L_0}\Big]\]이번에는 \(q\)의 자리가 \(q(x_{t-1} \mid x_t, x_0)\)로 바뀌어 있다. 이제 두 분포가 모두 “\(x_t\)가 주어졌을 때 \(x_{t-1}\)의 분포”이므로 KL divergence로 비교할 수 있다. 본문에는 설명이 없고 부록(식 17-22)에 수식만 있는데, 핵심은 바로 이 자리 바꾸기이다.
필요한 도구 두 가지
복잡한 정리는 필요 없고 두 가지만 알면 된다.
- 베이즈 정리(Bayes’ rule): \(p(a \mid b) = \dfrac{p(b \mid a)\,p(a)}{p(b)}\). 모든 확률에 같은 조건 \(c\)를 붙여도 성립한다.
- Markov 성질: \(x_t\)의 분포는 직전 상태 \(x_{t-1}\)이 주어지면 그 이전 상태들(\(x_{t-2}, \dots, x_0\))과 독립이다. 즉 \(q(x_t \mid x_{t-1}, x_0) = q(x_t \mid x_{t-1})\)이다.
자리 바꾸기
Markov 성질을 거꾸로 써서 쓸데없어 보이는 조건 \(x_0\)를 붙인 뒤, \(x_0\)를 조건으로 둔 베이즈 정리를 적용한다.
\[q(x_t \mid x_{t-1}) = q(x_t \mid x_{t-1}, x_0) = \frac{q(x_{t-1} \mid x_t, x_0)\, q(x_t \mid x_0)}{q(x_{t-1} \mid x_0)}\]\(x_0\)를 붙인 이유는 이렇다. \(q(x_{t-1} \mid x_t)\)는 모든 데이터에 대해 적분해야 해서 계산할 수 없지만, \(x_0\)까지 주어진 \(q(x_{t-1} \mid x_t, x_0)\)는 아래에서 보듯 깔끔한 가우시안이다.
식 17에서 22까지
\(t = 1\)인 항을 합에서 따로 꺼내고(식 19), \(t > 1\)인 항의 분모에 위의 자리 바꾸기를 대입한다(식 20).
\[L = \mathbb{E}_q\!\left[-\log p(x_T) - \sum_{t>1} \log\!\left(\frac{p_\theta(x_{t-1} \mid x_t)}{q(x_{t-1} \mid x_t, x_0)} \cdot \frac{q(x_{t-1} \mid x_0)}{q(x_t \mid x_0)}\right) - \log \frac{p_\theta(x_0 \mid x_1)}{q(x_1 \mid x_0)}\right]\]로그 안의 곱을 합으로 쪼개면 두 번째 분수의 합은 망원급수(telescoping sum)가 된다. 분자와 분모에 같은 항이 엇갈려 나타나서 양 끝만 남는다.
\[\sum_{t=2}^{T} \log \frac{q(x_{t-1} \mid x_0)}{q(x_t \mid x_0)} = \log \frac{q(x_1 \mid x_0)}{q(x_2 \mid x_0)} + \log \frac{q(x_2 \mid x_0)}{q(x_3 \mid x_0)} + \cdots = \log \frac{q(x_1 \mid x_0)}{q(x_T \mid x_0)}\]남은 \(q(x_1 \mid x_0)\)는 따로 꺼내 둔 \(t = 1\) 항의 분모와 약분되고, \(q(x_T \mid x_0)\)는 \(p(x_T)\) 쪽으로 붙는다(식 21).
\[L = \mathbb{E}_q\!\left[-\log \frac{p(x_T)}{q(x_T \mid x_0)} - \sum_{t>1} \log \frac{p_\theta(x_{t-1} \mid x_t)}{q(x_{t-1} \mid x_t, x_0)} - \log p_\theta(x_0 \mid x_1)\right]\]\(-\log(p/q)\)의 \(q\)에 대한 기댓값이 KL divergence이므로, 앞의 두 항은 각각 \(L_T\)와 \(L_{t-1}\)이 되고 식 22, 즉 처음에 슬쩍 자리가 바뀌어 나왔던 식 5가 된다.
세 항의 의미는 다음과 같다.
| 항 | 의미 | 학습 |
|---|---|---|
| \(L_T\) | 마지막 노이즈가 표준 정규분포와 얼마나 다른가 | \(q\)와 \(p(x_T)\) 모두 고정이므로 상수, 무시 |
| \(L_{t-1}\) | 한 단계 노이즈를 걷어낸 분포가 정답 posterior와 얼마나 다른가 | 핵심 학습 대상 |
| \(L_0\) | 마지막 단계에서 원래 픽셀 값을 복원하는 가능도 | 아래에서 따로 다룬다 |
신경망의 역할: 노이즈를 예측한다
▶ [ Diffusion ] 2. loss 설명(계속)
닮아야 할 분포: forward process의 posterior
\(L_{t-1}\)에서 \(p_\theta\)가 닮아야 할 분포는 가우시안이다(논문 식 6, 7).
\[q(x_{t-1} \mid x_t, x_0) = \mathcal{N}\!\left(x_{t-1};\ \tilde\mu_t(x_t, x_0),\ \tilde\beta_t I\right)\] \[\tilde\mu_t(x_t, x_0) = \frac{\sqrt{\bar\alpha_{t-1}}\,\beta_t}{1-\bar\alpha_t}\,x_0 + \frac{\sqrt{\alpha_t}\,(1-\bar\alpha_{t-1})}{1-\bar\alpha_t}\,x_t, \qquad \tilde\beta_t = \frac{1-\bar\alpha_{t-1}}{1-\bar\alpha_t}\,\beta_t\]논문은 “tractable하다”며 결과만 주지만, 유도는 앞에서와 같은 두 도구로 시작한다. 베이즈 정리로
\[q(x_{t-1} \mid x_t, x_0) = \frac{q(x_t \mid x_{t-1}, x_0)\, q(x_{t-1} \mid x_0)}{q(x_t \mid x_0)} = \frac{q(x_t \mid x_{t-1})\, q(x_{t-1} \mid x_0)}{q(x_t \mid x_0)}\]로 바꾸면(두 번째 등호가 Markov 성질), 세 항이 모두 이미 아는 가우시안이다. \(q(x_t \mid x_{t-1})\)는 forward 한 단계, 나머지 둘은 한 번에 건너뛰는 식이다. 분모는 \(x_{t-1}\)과 무관하므로, \(x_{t-1}\)에 대한 지수 부분만 보면
\[-\frac{1}{2}\left[\frac{(x_t - \sqrt{\alpha_t}\,x_{t-1})^2}{\beta_t} + \frac{(x_{t-1} - \sqrt{\bar\alpha_{t-1}}\,x_0)^2}{1-\bar\alpha_{t-1}}\right] + \text{const}\]이다. 이것을 \(x_{t-1}\)에 대한 완전제곱식으로 정리하면 가우시안의 꼴 \(-\frac{(x_{t-1} - \tilde\mu)^2}{2\tilde\beta}\)가 되고, \(x_{t-1}^2\)의 계수에서 분산이, 일차항에서 평균이 나온다. 예를 들어 \(x_{t-1}^2\)의 계수는 \(\dfrac{\alpha_t}{\beta_t} + \dfrac{1}{1-\bar\alpha_{t-1}} = \dfrac{1-\bar\alpha_t}{\beta_t(1-\bar\alpha_{t-1})}\)이고, 그 역수가 \(\tilde\beta_t\)이다. (\(\alpha_t(1-\bar\alpha_{t-1}) + \beta_t = \alpha_t - \bar\alpha_t + 1 - \alpha_t = 1 - \bar\alpha_t\)를 쓴다.)
KL divergence가 MSE가 된다
\(p_\theta(x_{t-1} \mid x_t)\)의 분산을 학습하지 않고 \(\sigma_t^2 I\)로 고정하면, 분산이 같은 두 가우시안 사이의 KL divergence는 평균 차이의 제곱에 비례한다(논문 식 8).
\[L_{t-1} = \mathbb{E}_q\!\left[\frac{1}{2\sigma_t^2}\left\lVert \tilde\mu_t(x_t, x_0) - \mu_\theta(x_t, t)\right\rVert^2\right] + C\]의미는 단순하다. 신경망은 \(x_0\)에 \(t\)단계만큼 노이즈를 먹인 \(x_t\)를 입력받아, \(q\)의 입장에서 본 “한 단계 덜 노이즈 낀” \(x_{t-1}\)의 평균을 출력하도록 학습된다.
노이즈 예측으로 바꾸기
식 9-12는 이 식을 정리하는 산수이다. 여러 번 주고받을 돈을 마지막에 차액만 정산하듯, 중간 변수 \(x_0\)를 \(x_t\)와 노이즈로 바꿔 지운다. \(x_t = \sqrt{\bar\alpha_t}\,x_0 + \sqrt{1-\bar\alpha_t}\,\epsilon\)에서 \(x_0 = (x_t - \sqrt{1-\bar\alpha_t}\,\epsilon)/\sqrt{\bar\alpha_t}\)를 \(\tilde\mu_t\)에 대입하면
\[\tilde\mu_t = \frac{1}{\sqrt{\alpha_t}}\left(x_t - \frac{\beta_t}{\sqrt{1-\bar\alpha_t}}\,\epsilon\right)\]이 된다. \(x_t\)는 입력으로 주어지므로 모르는 것은 \(\epsilon\)뿐이다. 그래서 \(\mu_\theta\)도 같은 꼴로 두고 노이즈만 신경망 \(\epsilon_\theta\)가 예측하게 한다(식 11).
\[\mu_\theta(x_t, t) = \frac{1}{\sqrt{\alpha_t}}\left(x_t - \frac{\beta_t}{\sqrt{1-\bar\alpha_t}}\,\epsilon_\theta(x_t, t)\right)\]이를 식 8에 넣으면
\[L_{t-1} - C = \mathbb{E}_{x_0, \epsilon}\!\left[\frac{\beta_t^2}{2\sigma_t^2\,\alpha_t\,(1-\bar\alpha_t)} \left\lVert \epsilon - \epsilon_\theta\!\left(\sqrt{\bar\alpha_t}\,x_0 + \sqrt{1-\bar\alpha_t}\,\epsilon,\ t\right)\right\rVert^2\right]\]이다(식 12). 앞의 가중치를 떼어 낸 것이 실제로 쓰는 단순화된 손실(simplified loss)이다(식 14).
\[L_{\text{simple}}(\theta) = \mathbb{E}_{t, x_0, \epsilon}\!\left[\left\lVert \epsilon - \epsilon_\theta\!\left(\sqrt{\bar\alpha_t}\,x_0 + \sqrt{1-\bar\alpha_t}\,\epsilon,\ t\right)\right\rVert^2\right], \quad t \sim \text{Uniform}\{1, \dots, T\}\]식 8의 “노이즈를 한 단계 걷어낸 \(x_{t-1}\)을 찾는다”와 식 12의 “걷어낼 노이즈 \(\epsilon\)을 예측한다”는 글자만 다를 뿐 같은 말이다. \(x_t\)를 알고 있으니 둘 중 하나를 알면 다른 하나가 정해진다.
숫자로 확인. 1차원에서 \(x_0 = 1\), \(\epsilon = 0.5\), \(t = 250\)이라 하자. \(\beta_{250} \approx 0.00506\), \(\bar\alpha_{250} \approx 0.5241\), \(\bar\alpha_{249} \approx 0.5268\)이다.
- \[x_t = \sqrt{0.5241}\cdot 1 + \sqrt{0.4759}\cdot 0.5 \approx 0.7239 + 0.3449 = 1.0689\]
- 식 7: \(\tilde\mu = 0.00772 \cdot x_0 + 0.99188 \cdot x_t \approx 1.0679\)
- 노이즈 형태: \(\tilde\mu = (x_t - 0.00506/\sqrt{0.4759}\cdot 0.5)/\sqrt{0.99494} \approx 1.0679\)
두 값이 같다. 한 단계에서 걷어내는 양은 0.001 정도로 아주 작다.
마지막 항과 샘플링의 분산
\(L_0\)는 0부터 255까지의 정수 픽셀 값을 \([-1, 1]\)로 옮긴 뒤, 마지막 단계에서 정확한 정수 값이 나올 확률을 계산하기 위한 이산 디코더(discrete decoder) 항이다. 하지만 논문은 \(L_{\text{simple}}\)에서 \(t = 1\)인 경우가 이를 근사하므로 따로 나눌 필요 없이 같은 식에 \(t = 1\)까지 넣어 학습하면 된다고 한다.
샘플링에서 쓸 분산 \(\sigma_t^2\)는 \(\beta_t\)나 \(\tilde\beta_t\) 중 하나를 쓰며, 논문에 따르면 결과가 비슷하다.
학습과 샘플링 알고리즘
정리하면 diffusion 모델이 하는 일은, 데이터가 아주 조금씩 노이즈에 덮여 가는 과정을 보고 수학적으로 모델링된 그 역과정을 학습하는 것이다. 논문의 두 알고리즘은 다음과 같다.
Algorithm 1 (학습): 반복한다.
- 데이터셋에서 \(x_0\)를 하나 꺼낸다.
- \(t \sim \text{Uniform}\{1, \dots, T\}\), \(\epsilon \sim \mathcal{N}(0, I)\)를 뽑는다.
- \(\nabla_\theta \left\lVert \epsilon - \epsilon_\theta(\sqrt{\bar\alpha_t}\,x_0 + \sqrt{1-\bar\alpha_t}\,\epsilon, t)\right\rVert^2\)로 경사 하강을 한다.
Algorithm 2 (샘플링): \(x_T \sim \mathcal{N}(0, I)\)에서 시작해 \(t = T, \dots, 1\)에 대해
\[x_{t-1} = \frac{1}{\sqrt{\alpha_t}}\left(x_t - \frac{1-\alpha_t}{\sqrt{1-\bar\alpha_t}}\,\epsilon_\theta(x_t, t)\right) + \sigma_t z, \qquad z \sim \mathcal{N}(0, I)\ (t > 1),\ \ z = 0\ (t = 1)\]를 반복하고 \(x_0\)를 반환한다. (\(1 - \alpha_t = \beta_t\)이므로 괄호 안은 식 11의 \(\mu_\theta\)이다.)
데이터셋 전체를 한 번에 학습할 수 없어서 미니배치를 쓰듯이, 모든 데이터에 대해 모든 \(t = 1, \dots, 1000\)을 한 번에 학습할 수도 없다. 그래서 배치의 각 샘플마다 \(t\)를 무작위로 하나씩 뽑는다. 이것이 아래 코드에서 계수를 꺼내는 함수가 필요한 이유이다.
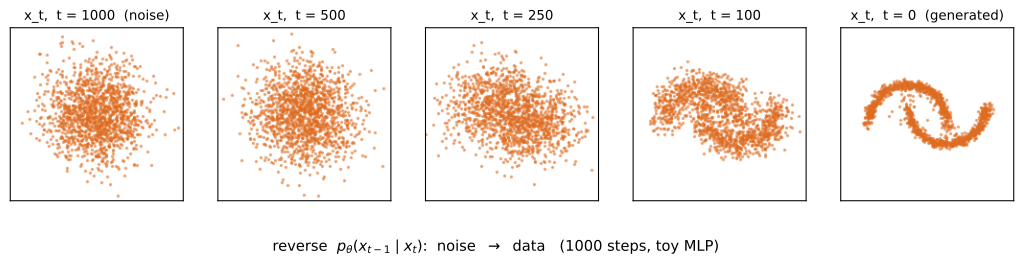 아래 코드로 학습한 작은 MLP로 Algorithm 2를 돌린 결과. 1000단계 동안 노이즈에서 two moons 모양이 서서히 드러난다. 첫 번째 그림의 forward process를 거꾸로 되감은 모습이다.
PyTorch 구현
DDPM 코드에는 논문을 옆에 두고 읽으면 바로 보이는 두 가지 특징이 있다.
1. 계수 테이블과 register_buffer. \(\beta_t\), \(\alpha_t\), \(\bar\alpha_t\)와 그 제곱근, 역수 등은 학습 전에 \(t = 1, \dots, T\)에 대해 미리 계산해 둔다. torch.linspace로 \(\beta\)를, 1 - betas로 \(\alpha\)를, 누적 곱 torch.cumprod로 \(\bar\alpha\)를 만든다. 예를 들어 \(\bar\alpha_4 = \alpha_1\alpha_2\alpha_3\alpha_4\)이다. 샘플링에 필요한 \(\bar\alpha_{t-1}\)은 \(\bar\alpha\)를 한 칸 뒤로 밀고 맨 앞에 1(아직 아무것도 곱하지 않았다는 뜻)을 채워 만든다.
이 값들을 단순한 인스턴스 변수 대신 self.register_buffer로 등록하는 이유는 state_dict이다. 버퍼는 학습되는 파라미터는 아니지만 state_dict에 포함되므로 모델을 저장하고 불러올 때 같이 따라다니고, .to(device)도 함께 적용된다.
2. 계수 꺼내기(extract, gather_and_expand). 배치마다 \(t\)가 다르므로, 각 샘플의 \(t\)에 해당하는 계수를 테이블에서 꺼내 데이터 shape에 맞춰야 한다. 예를 들어 배치 크기 4에서 \(t\)가 [183, 500, 99, 875]로 뽑혔다면, \(\sqrt{\bar\alpha_t}\) 테이블(길이 1000)에서 이 네 위치를 gather로 가져와 shape (4,)를 만들고, 이미지 x0의 shape이 (4, 3, 32, 32)이면 (4, 1, 1, 1)로 view해서 브로드캐스팅되게 한다. 데이터가 2차원 벡터든 4차원 이미지든 남는 차원 수만큼 1을 붙인다.
샘플링의 평균은 Algorithm 2의 식 대신, 같은 값을 주는 두 단계 계산으로 구현하는 경우가 많다. 먼저 노이즈 예측에서 \(\hat x_0 = (x_t - \sqrt{1-\bar\alpha_t}\,\epsilon_\theta)/\sqrt{\bar\alpha_t}\)를 구하고, 이를 식 7의 \(\tilde\mu_t(x_t, \hat x_0)\)에 넣는 것이다. 수학적으로 식 11과 같지만(위의 숫자 예), 중간의 \(\hat x_0\)를 데이터 범위로 자르는(clipping) 등의 처리를 끼워 넣기 쉽다. 분산은 \(\tilde\beta_t\)를 썼다.
import torch
import torch.nn as nn
import torch.nn.functional as F


def gather_and_expand(v, t, x_shape):
    """v: (T,) table, t: (B,) indices -> (B, 1, 1, ...) to broadcast with x."""
    out = v.gather(0, t)
    return out.view(-1, *([1] * (len(x_shape) - 1)))


class DDPM(nn.Module):
    def __init__(self, model, T=1000, beta_1=1e-4, beta_T=0.02):
        super().__init__()
        self.model, self.T = model, T
        betas = torch.linspace(beta_1, beta_T, T)
        alphas = 1.0 - betas
        alphas_bar = torch.cumprod(alphas, dim=0)
        alphas_bar_prev = F.pad(alphas_bar[:-1], (1, 0), value=1.0)

        # forward: x_t = sqrt(abar) x0 + sqrt(1 - abar) eps
        self.register_buffer("sqrt_alphas_bar", alphas_bar.sqrt())
        self.register_buffer("sqrt_one_minus_alphas_bar", (1 - alphas_bar).sqrt())
        # x0_hat = x_t / sqrt(abar) - sqrt(1/abar - 1) eps
        self.register_buffer("sqrt_recip_alphas_bar", (1 / alphas_bar).sqrt())
        self.register_buffer("sqrt_recipm1_alphas_bar", (1 / alphas_bar - 1).sqrt())
        # posterior q(x_{t-1} | x_t, x0): mean = coef_x0 * x0 + coef_xt * x_t
        self.register_buffer("coef_x0", alphas_bar_prev.sqrt() * betas / (1 - alphas_bar))
        self.register_buffer("coef_xt", alphas.sqrt() * (1 - alphas_bar_prev) / (1 - alphas_bar))
        self.register_buffer("posterior_var", betas * (1 - alphas_bar_prev) / (1 - alphas_bar))

    def loss(self, x0):                                   # Algorithm 1
        t = torch.randint(0, self.T, (x0.shape[0],), device=x0.device)
        eps = torch.randn_like(x0)
        x_t = (gather_and_expand(self.sqrt_alphas_bar, t, x0.shape) * x0
               + gather_and_expand(self.sqrt_one_minus_alphas_bar, t, x0.shape) * eps)
        return F.mse_loss(self.model(x_t, t), eps)

    @torch.no_grad()
    def sample(self, x_T):                                # Algorithm 2
        x_t = x_T
        for step in reversed(range(self.T)):
            t = torch.full((x_t.shape[0],), step, dtype=torch.long, device=x_t.device)
            eps = self.model(x_t, t)
            x0_hat = (gather_and_expand(self.sqrt_recip_alphas_bar, t, x_t.shape) * x_t
                      - gather_and_expand(self.sqrt_recipm1_alphas_bar, t, x_t.shape) * eps)
            mean = (gather_and_expand(self.coef_x0, t, x_t.shape) * x0_hat
                    + gather_and_expand(self.coef_xt, t, x_t.shape) * x_t)
            z = torch.randn_like(x_t) if step > 0 else torch.zeros_like(x_t)
            x_t = mean + gather_and_expand(self.posterior_var, t, x_t.shape).sqrt() * z
        return x_t
코드의 인덱스 t는 0부터 \(T-1\)까지이므로 논문의 \(t\)보다 1 작다. alphas_bar_prev의 맨 앞이 1이라서 마지막 단계(논문의 \(t = 1\))에서는 posterior_var가 0이 되고, \(z = 0\)과 함께 노이즈 없이 \(\hat x_0\) 쪽으로 끝난다.
신경망 model(x_t, t)는 \(x_t\)와 같은 shape의 노이즈를 출력하기만 하면 된다. 이미지에서는 다운샘플링 후 업샘플링하는 U-Net(PixelCNN++ 구조 기반)을 쓰고, 위 두 번째 그림은 2차원 데이터에 대해 다음과 같은 작은 MLP로 학습한 것이다. 나머지는 평범한 학습 루프와 같다.
class EpsMLP(nn.Module):
    def __init__(self, dim=2, hidden=256, T=1000):
        super().__init__()
        self.t_emb = nn.Embedding(T, hidden)               # one vector per timestep
        self.inp = nn.Linear(dim, hidden)
        self.net = nn.Sequential(nn.SiLU(), nn.Linear(hidden, hidden), nn.SiLU(),
                                 nn.Linear(hidden, hidden), nn.SiLU(), nn.Linear(hidden, dim))

    def forward(self, x, t):
        return self.net(self.inp(x) + self.t_emb(t))


ddpm = DDPM(EpsMLP())
opt = torch.optim.Adam(ddpm.parameters(), lr=1e-3)
data = torch.randn(4096, 2) * 0.3 + torch.tensor([1.0, -1.0])   # stand-in dataset

for step in range(200):
    x0 = data[torch.randint(0, len(data), (256,))]
    loss = ddpm.loss(x0)
    opt.zero_grad(); loss.backward(); opt.step()

samples = ddpm.sample(torch.randn(500, 2))
print(samples.shape, "coef_x0" in ddpm.state_dict())   # torch.Size([500, 2]) True
논문에서 쓴 EMA(exponential moving average) 같은 부가 기법은 생략했다. 코드를 디버깅할 때는 논문을 옆에 펴 두고 학습과 샘플링의 각 계수가 맞는 식에 들어갔는지 확인하는 것이 가장 빠르다.
Classifier-free guidance (CFG)
▶ 시각화로 이해하는 Classifier free guidance(CFG)
생성 모델 코드에는 cfg, guidance_scale 같은 이름이 자주 보인다. CFG는 classifier-free guidance(Ho & Salimans, 2022)의 줄임말이다. 논문의 배경 설명은 \(\lambda\)와 \(\nabla\)로 가득해서 겁이 나지만, 그것은 이 방법이 왜 문제없는지를 보이는 이론이고, 적용 방법 자체는 간단하다.
Guidance란
생성 모델에서 guidance는 “이런 이미지를 만들어라”라는 지시이다. 손글씨 숫자 생성 모델이라면 “숫자 0을 만들어라”가 지시이고, 지시가 없다는 것은 “학습 때 본 그림 중 아무거나 만들어라”이다.
지시를 반영하는 가장 단순한 방법은 노이즈 입력 옆에 조건 \(c\)(예: 클래스 레이블)를 같이 넣는 것이다. 조건 “1”이 들어올 때는 항상 숫자 1 그림만 보여 주면 모델은 조건의 의미를 배운다. 그런데 모델은 조건뿐 아니라 노이즈도 입력받고, 이 노이즈는 어떤 숫자를 학습할 때든 계속 바뀌며 쓰인다. 그래서 모델은 두 입력의 역할을 완전히 분리하지 못하고, 조건을 줘도 결과가 조건을 충분히 또렷하게 반영하지 않을 수 있다. CFG는 이 흐릿함을 보정한다.
방법
학습: 하나의 모델이 조건부와 무조건부를 함께 배우도록, 일정 확률 \(p_{\text{uncond}}\)(논문에서는 0.1이나 0.2)로 조건을 “조건 없음”을 뜻하는 빈 토큰 \(\varnothing\)로 바꿔서 학습한다. 조건이 없을 때 모델은 0부터 9까지 모든 숫자를 보게 되므로 “가장자리는 어둡고 가운데에 무늬가 있다” 정도의 평균적인 모습을 배운다.
샘플링: 매 단계마다 모델을 두 번 계산한다. 한 번은 조건 \(c\)를 넣고(cond), 한 번은 \(\varnothing\)를 넣는다(uncond). 그리고 두 출력을 섞는다.
\[\tilde\epsilon_\theta(x_t, c) = (1+w)\,\epsilon_\theta(x_t, c) - w\,\epsilon_\theta(x_t, \varnothing) = \epsilon_\theta(x_t, c) + w\left(\epsilon_\theta(x_t, c) - \epsilon_\theta(x_t, \varnothing)\right)\]샘플링 식의 \(\epsilon_\theta\) 자리에 \(\tilde\epsilon_\theta\)를 쓰면 된다.
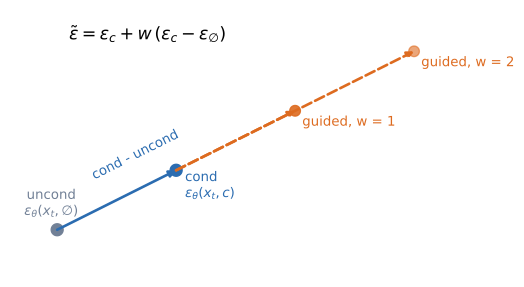 CFG의 기하학적 의미. 회색 점(uncond)에서 파란 점(cond)으로 향하는 차이 벡터를 cond에서부터 \(w\)배 더 연장한 곳이 guided 출력이다.
직관
뒤쪽 형태에서 \(\epsilon_c - \epsilon_\varnothing\)는 조건 없는 모호한 출력에서 조건을 준 출력으로 향하는 방향 벡터이다. 엄밀한 설명은 아니지만 직관은 이렇다. cond 출력에도 노이즈 때문에 모호함이 묻어 있으니, “모호한 쪽에서 뚜렷한 쪽으로 가는 방향”을 한 번 더 더해서 조건이 더 강하게 반영되게 한다. \(w\)는 그 방향을 얼마나 세게 밀지 정하는 guidance scale이다. \(w = 0\)이면 평범한 조건부 샘플링이다. \(w\)를 키우면 조건에 더 충실하지만 다양성은 줄어든다.
이론적으로는 \(\epsilon_\theta(x_t, \cdot) \approx -\sqrt{1-\bar\alpha_t}\,\nabla_{x_t}\log p(x_t \mid \cdot)\)이고 베이즈 정리로 \(\nabla\log p(c \mid x_t) = \nabla\log p(x_t \mid c) - \nabla\log p(x_t)\)이므로, \(\epsilon_c - \epsilon_\varnothing\)는 “암묵적인 분류기(implicit classifier)” \(\log p(c \mid x_t)\)의 기울기 방향에 해당한다. 별도의 분류기를 학습하지 않고 같은 모델의 두 출력 차이로 그 역할을 대신한다는 점이 “classifier-free”라는 이름의 이유이다.
두 가지 표기. 원 논문은 cond에서 출발하지만, 다른 논문이나 코드에서는 uncond에서 출발해 \(\epsilon_\varnothing + s\,(\epsilon_c - \epsilon_\varnothing)\)로 쓰기도 한다. 전개하면 \(s = 1 + w\)일 때 두 식이 같으므로, scale을 1만큼 다르게 잡는 것뿐이다. (예: Stable Diffusion의 guidance_scale=7.5는 이 \(s\)이다.)
class CondEpsMLP(nn.Module):
    def __init__(self, num_classes, dim=2, hidden=256, T=1000):
        super().__init__()
        self.null = num_classes                           # extra index = "no condition"
        self.t_emb = nn.Embedding(T, hidden)
        self.c_emb = nn.Embedding(num_classes + 1, hidden)
        self.inp = nn.Linear(dim, hidden)
        self.net = nn.Sequential(nn.SiLU(), nn.Linear(hidden, hidden), nn.SiLU(),
                                 nn.Linear(hidden, dim))

    def forward(self, x, t, c):
        return self.net(self.inp(x) + self.t_emb(t) + self.c_emb(c))


def cfg_loss(ddpm, x0, c, p_uncond=0.1):
    t = torch.randint(0, ddpm.T, (x0.shape[0],))
    eps = torch.randn_like(x0)
    x_t = (gather_and_expand(ddpm.sqrt_alphas_bar, t, x0.shape) * x0
           + gather_and_expand(ddpm.sqrt_one_minus_alphas_bar, t, x0.shape) * eps)
    drop = torch.rand(c.shape[0]) < p_uncond              # randomly forget the label
    c = torch.where(drop, torch.full_like(c, ddpm.model.null), c)
    return F.mse_loss(ddpm.model(x_t, t, c), eps)


def guided_eps(model, x_t, t, c, w):
    eps_c = model(x_t, t, c)                                  # cond
    eps_u = model(x_t, t, torch.full_like(c, model.null))    # uncond
    return eps_c + w * (eps_c - eps_u)                        # = (1 + w) eps_c - w eps_u


ddpm_c = DDPM(CondEpsMLP(num_classes=10))
x0, c = torch.randn(8, 2), torch.randint(0, 10, (8,))
print(cfg_loss(ddpm_c, x0, c).item() > 0,
      guided_eps(ddpm_c.model, x0, torch.full((8,), 500), c, w=3.0).shape)
샘플링 루프는 DDPM.sample에서 eps = self.model(x_t, t)를 guided_eps(...)로 바꾸기만 하면 된다. 실제 구현에서는 cond와 uncond 입력을 배치 방향으로 이어 붙여 모델을 한 번만 호출하는 경우가 많다.
정리
| 개념 | 핵심 |
|---|---|
| Forward process \(q\) | 고정된 스케줄 \(\beta_t\)로 노이즈를 섞는다. \(x_t = \sqrt{\bar\alpha_t}\,x_0 + \sqrt{1-\bar\alpha_t}\,\epsilon\)로 한 번에 건너뛸 수 있다 |
| Reverse process \(p_\theta\) | 한 단계씩 노이즈를 걷어내는 가우시안. 평균을 신경망이 예측한다 |
| 손실 유도의 핵심 | Markov 성질 + 베이즈 정리로 \(q(x_t \mid x_{t-1})\)를 \(q(x_{t-1} \mid x_t, x_0)\)로 바꾸고 망원급수로 정리한다 |
| 신경망의 역할 | \(x_{t-1}\)의 평균을 맞히는 것 = 넣은 노이즈 \(\epsilon\)을 맞히는 것. 손실은 실제 노이즈와 예측 노이즈의 MSE |
| 구현 | 계수 테이블을 register_buffer로, 배치별 \(t\)의 계수는 gather 후 view로 브로드캐스팅 |
| CFG | 조건을 가끔 지우며 학습하고, 샘플링 때 \(\epsilon_c + w(\epsilon_c - \epsilon_\varnothing)\)로 조건을 강조한다 |
같은 “노이즈를 데이터로 옮기기”를 확률적인 1000단계 대신 결정론적인 벡터장(vector field)을 따라가는 ODE로 풀면 Flow Matching이 된다.