- UC Berkeley CS 182 (Spring 2021) Discussion 3 정리
- 관련 강의: Deep Learning 5, Deep Learning 6
전반부는 역전파 계산을 손으로 해 보고(문제 1~3), 후반부는 합성곱 연산을 소개한다(문제 4~6).
준비: 소프트맥스의 그래디언트. 소프트맥스 \(p: \mathbb{R}^k \to \mathbb{R}^k\), \(p_i(z) = \frac{e^{z_i}}{\sum_{j=1}^k e^{z_j}}\)의 편미분은 Discussion 1에서 구했다.
\[\frac{\partial p_i(z)}{\partial z_j} = p_i(z)(\delta_{ij} - p_j(z)), \qquad \nabla p_i(z) = p_i(z)(e_i - p(z))\]\(e_i\)는 \(i\)번째 성분만 1인 단위벡터다. 다중 클래스 로지스틱 회귀의 손실은 정답 레이블의 음의 로그우도다.
\[L(x, y, W, b) = -\log p_y(Wx + b)\]1. 선형 층 매개변수에 대한 그래디언트
문제
연쇄 법칙으로 \(L(x, y, W, b)\)의 \(W\)와 \(b\)에 대한 그래디언트를 구하라.
풀이
\(z = Wx + b\)라 하자. 먼저 로그의 그래디언트는 다음과 같다.
\[\nabla_z \log p_y(z) = \frac{\nabla p_y(z)}{p_y(z)} = e_y - p(z)\]손실은 음의 로그우도이므로 부호를 뒤집으면 \(\nabla_z L = p(z) - e_y\)다.
편향 \(b\). \(\frac{\partial z_i}{\partial b_j} = \delta_{ij}\)이므로 야코비안 \(\frac{\partial z}{\partial b}\)는 단위행렬이다.
\[\nabla_b L = \frac{\partial z}{\partial b}\nabla_z L = I\,(p(z) - e_y) = p(z) - e_y\]가중치 \(W\). \(z_k = \sum_j W_{kj}x_j + b_k\)이므로 \(\frac{\partial z_k}{\partial W_{ij}} = \delta_{ik}x_j\)다. \(W_{ij}\)는 \(z_i\)에만 영향을 주므로 다음과 같다.
\[\frac{\partial L}{\partial W_{ij}} = \frac{\partial L}{\partial z_i}x_j, \qquad \nabla_W L = (p(z) - e_y)\,x^T\]예측 확률과 정답의 차이에 입력을 외적한 형태로, 5강의 선형 층 공식 \(\delta a^T\)와 같다.
2. 입력에 대한 그래디언트
문제
\(W, b\)가 다층 신경망의 마지막 층이라면, 앞쪽 층의 매개변수로 역전파하기 위해 입력에 대한 그래디언트도 필요하다. \(L\)의 \(x\)에 대한 그래디언트를 구하라.
풀이
\(z_i = \sum_j W_{ij}x_j + b_i\)이므로 \(\frac{\partial z_i}{\partial x_j} = W_{ij}\)다.
\[\frac{\partial L}{\partial x_j} = \sum_{i=1}^k \frac{\partial L}{\partial z_i}\frac{\partial z_i}{\partial x_j} = \sum_{i=1}^k \frac{\partial L}{\partial z_i}W_{ij}\]벡터로 쓰면 다음과 같다.
\[\nabla_x L = W^T\nabla_z L = W^T(p(z) - e_y)\]여기에 활성화 함수의 역전파만 더하면 완전 연결 순방향 신경망 전체를 역전파할 수 있다.
3. 비선형 계산 그래프에서의 그래디언트
문제
\(y = W_2\,\sigma(W_1x) + x\)이고 \(\sigma\)는 ReLU다. 출력에 대한 손실의 그래디언트를 \(\delta_y\)라 할 때, 입력 \(x\)에 대한 그래디언트를 구하라. 이런 구조를 스킵 연결(skip connection) 이라 하며, ResNet에서 다시 등장한다.
풀이
\(x\)는 두 경로로 \(y\)에 기여한다. 일반적인 순방향 경로 \(W_2\sigma(W_1x)\)와 스킵 연결 \(x\)다.
순방향 경로. \(z = W_1x\), \(a = \sigma(z)\)라 하자. 선형 층 공식에 의해 다음과 같다.
\[\frac{\partial L}{\partial a} = W_2^T\delta_y\]ReLU의 역전파를 위해 \(R(z)\)를 \(z_i > 0\)이면 \(R(z)_{ii} = 1\), 아니면 0인 대각행렬로 둔다. ReLU의 역전파는 활성화 후 그래디언트에 \(R(z)\)를 곱하는 것이다.
\[\frac{\partial L}{\partial z} = R(z)\frac{\partial L}{\partial a} = R(z)W_2^T\delta_y\]다시 선형 층을 지나면 순방향 경로의 기여는 \(W_1^T R(W_1x) W_2^T \delta_y\)다.
합치기. 스킵 연결의 야코비안은 단위행렬이므로 기여는 \(\delta_y\) 그대로다. 여러 경로가 있으면 각 경로의 기여를 더한다.
\[\frac{\partial L}{\partial x} = W_1^T R(W_1x) W_2^T\delta_y + \delta_y\]스킵 연결 덕분에 그래디언트가 층을 거치며 줄어들지 않고 그대로 전달되는 경로가 생긴다.
4. 합성곱의 크기 계산
문제
먼저 합성곱(convolution)을 정의한다. 딥러닝에서 “합성곱”이라 부르는 연산은 사실 필터 인덱스를 뒤집지 않는 교차 상관(cross-correlation) 이며, PyTorch의 합성곱 층도 마찬가지다. 1차원 입력 \(x \in \mathbb{R}^n\)과 필터 \(w \in \mathbb{R}^k\)에 대해 다음과 같이 계산한다.
- 필터를 \(x\)의 앞부분에 맞추고, \(w\)와 \(x[0 : k-1]\)의 내적을 첫 출력으로 한다(파이썬식 0-인덱스).
- 스트라이드(stride)가 \(s\)이면 필터를 \(s\)칸 옮겨 \(x[s : k-1+s]\)와의 내적을 다음 출력으로 한다.
- 입력이 끝날 때까지 반복한다.
스트라이드 1이면 출력은 \(y_j = \sum_{i=1}^k w_ix_{i+j-1}\), \(j = 1, \dots, n-k+1\)이다. 출력이 입력보다 짧아지므로, 흔히 입력 양 끝에 0을 붙이는 제로 패딩(zero-padding) 을 쓴다. 이미지처럼 공간 차원이 둘이면 필터를 두 방향으로 모두 민다.
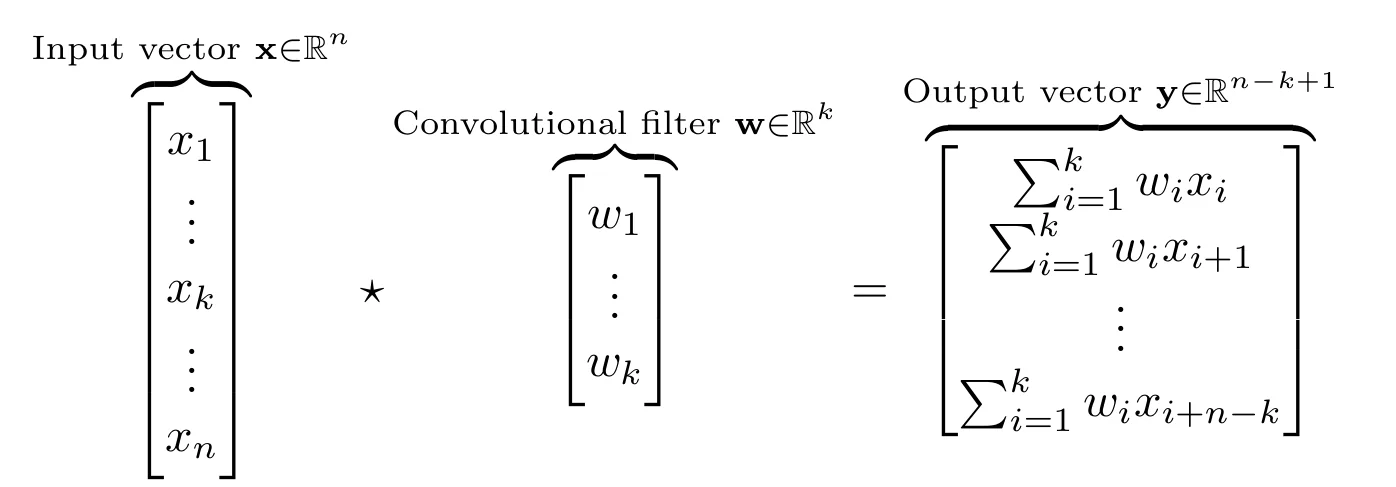 스트라이드 1인 1차원 합성곱. 길이 \(n\)인 입력 \(x\)와 길이 \(k\)인 필터 \(w\)로 길이 \(n-k+1\)인 출력 \(y\)를 만든다. 출처: CS 182 Discussion 3.
출력 벡터의 각 행이 필터를 한 칸씩 민 결과다. 첫 행 \(\sum_{i=1}^k w_ix_i\)는 필터를 \(x_1, \dots, x_k\)에 맞춘 내적이고, 둘째 행 \(\sum_{i=1}^k w_ix_{i+1}\)은 한 칸 옮겨 \(x_2, \dots, x_{k+1}\)에 맞춘 내적이다. 마지막 행은 필터의 끝이 \(x_n\)에 닿는 위치, 즉 \(x_{n-k+1}, \dots, x_n\)과의 내적이다. 필터가 입력 밖으로 나가지 않는 위치는 \(n-k+1\)개뿐이므로 출력이 입력보다 \(k-1\)만큼 짧아진다. 예를 들어 \(n = 5\), \(k = 3\)이면 출력 길이는 3이다.
다음을 답하라.
- \(32 \times 32 \times 3\) 이미지에 \(5 \times 5 \times 3\) 필터를 스트라이드 1, 패딩 0으로 적용하면 출력 크기는?
- 입력을 2만큼 제로 패딩하면?
- 이 필터 10개를 쌓고 패딩 2를 유지하면 출력 크기와 (편향을 제외한) 매개변수 수는?
- \(1 \times 1\) 합성곱 뒤의 공간 크기는? 이 연산은 무엇을 하는가?
풀이
일반적으로 입력 크기 \(n\), 필터 크기 \(k\), 패딩 \(p\), 스트라이드 \(s\)일 때 출력 크기는 다음과 같다.
\[\left\lfloor \frac{n + 2p - k}{s} \right\rfloor + 1\]- \(32 - 5 + 1 = 28\)이므로 출력은 \(28 \times 28\)이고 채널은 1개다. 필터의 깊이 3이 입력 채널 3개를 모두 덮으므로 채널 방향으로는 미끄러지지 않는다.
- \(32 + 4 - 5 + 1 = 32\)이므로 \(32 \times 32\)로, 입력과 같은 크기가 유지된다.
- 필터마다 출력 채널이 하나씩 생기므로 \(32 \times 32 \times 10\)이다. 필터 하나의 매개변수는 \(5 \cdot 5 \cdot 3 = 75\)개이므로 총 \(750\)개다. 편향을 포함하면 필터당 76개, 총 760개다.
- \(1 \times 1\) 합성곱은 공간 크기를 바꾸지 않는다. 각 공간 위치에서 입력 채널들에 같은 선형 사상을 적용하는 것이므로, 실제로는 채널 수를 바꾸는 데 유용하다.
5. 합성곱을 행렬 곱으로 표현하기
문제
합성곱은 선형 연산이므로 행렬로 표현할 수 있다. 입력 \(x \in \mathbb{R}^4\), 필터 \(w \in \mathbb{R}^3\)이고, 양 끝을 1씩 제로 패딩한 입력을 \(\bar{x} = (0, x_1, x_2, x_3, x_4, 0) \in \mathbb{R}^6\)이라 하자. \(W\bar{x} = \bar{x} * w\)가 되는 \(4 \times 6\) 행렬 \(W\)를 구하라.
풀이
합성곱을 직접 계산하면 다음과 같다.
\[\bar{x} * w = \begin{bmatrix} x_1w_2 + x_2w_3 \\ x_1w_1 + x_2w_2 + x_3w_3 \\ x_2w_1 + x_3w_2 + x_4w_3 \\ x_3w_1 + x_4w_2 \end{bmatrix}\]각 출력은 \(\bar{x}\)의 연속한 세 성분과 \(w\)의 내적이므로, 행마다 \(w\)를 한 칸씩 밀어 놓은 행렬이 된다.
\[W = \begin{bmatrix} w_1 & w_2 & w_3 & 0 & 0 & 0 \\ 0 & w_1 & w_2 & w_3 & 0 & 0 \\ 0 & 0 & w_1 & w_2 & w_3 & 0 \\ 0 & 0 & 0 & w_1 & w_2 & w_3 \end{bmatrix}\]이 행렬에서 몇 가지를 알 수 있다.
- 필터가 입력보다 훨씬 작으면 행렬은 대부분 0인 희소 행렬이다. 합성곱이 공간적 지역성(locality)을 이용한다는 뜻이다.
- 같은 필터 가중치가 여러 번 반복되는 매개변수 공유가 있다.
- 따라서 합성곱 층은 임의의 행렬을 쓰는 완전 연결 층보다 표현력이 낮다.
- 반대로, 행렬 곱은 고도로 최적화되어 있으므로 합성곱을 행렬 곱으로 바꿔 계산하면(예: 과제 1의 im2col) 공간 차원을 도는 순진한 반복문보다 훨씬 빠른 경우가 많다.
6. 합성곱의 역전파
문제
패딩 없이 \(y = x * w \in \mathbb{R}^2\)이고 \(w \in \mathbb{R}^3\), \(x \in \mathbb{R}^4\)다. 출력에 대한 그래디언트 \(\nabla_yL\)이 주어질 때, \(x\)와 \(w\)에 대한 그래디언트를 구하라. 이 그래디언트들도 합성곱으로 표현할 수 있는가?
풀이
\(\delta_i = \frac{\partial L}{\partial y_i}\)라 하자. 순전파는 \(y_1 = w_1x_1 + w_2x_2 + w_3x_3\), \(y_2 = w_1x_2 + w_2x_3 + w_3x_4\)다.
입력에 대한 그래디언트. 각 \(x_j\)가 어느 출력에 어떤 가중치로 들어가는지 모은다.
\[\frac{\partial L}{\partial x_1} = w_1\delta_1, \quad \frac{\partial L}{\partial x_2} = w_2\delta_1 + w_1\delta_2, \quad \frac{\partial L}{\partial x_3} = w_3\delta_1 + w_2\delta_2, \quad \frac{\partial L}{\partial x_4} = w_3\delta_2\]이는 \(\delta\)의 양 끝을 2씩(\(k - 1\)만큼) 제로 패딩한 \((0, 0, \delta_1, \delta_2, 0, 0)\)에, 필터를 뒤집은 \(\tilde{w} = (w_3, w_2, w_1)\)로 합성곱한 결과다. 예를 들어 첫 출력은 \((0, 0, \delta_1) \cdot (w_3, w_2, w_1) = w_1\delta_1\)이다. 순전파에서 필터를 오른쪽으로 밀면 \(x_j\)는 필터의 뒤쪽 가중치부터 만나므로, 역방향에서는 필터 순서가 뒤집힌다.
필터에 대한 그래디언트.
\[\frac{\partial L}{\partial w_1} = \delta_1x_1 + \delta_2x_2, \quad \frac{\partial L}{\partial w_2} = \delta_1x_2 + \delta_2x_3, \quad \frac{\partial L}{\partial w_3} = \delta_1x_3 + \delta_2x_4\]이는 입력 \(x\)를 \(\nabla_yL\)로 패딩 없이 합성곱한 것과 같다.
\[\nabla_wL = x \star \nabla_yL\]즉 합성곱의 역전파도 합성곱이다. 입력 그래디언트는 패딩한 출력 그래디언트와 뒤집은 필터의 합성곱이고, 필터 그래디언트는 입력과 출력 그래디언트의 합성곱이다.
정리
- 소프트맥스 + 음의 로그우도에서 \(\nabla_zL = p(z) - e_y\)이고, 선형 층 \(z = Wx + b\)를 지나면 \(\nabla_WL = (p - e_y)x^T\), \(\nabla_bL = p - e_y\), \(\nabla_xL = W^T(p - e_y)\)다.
- ReLU의 역전파는 \(z_i > 0\)인 성분만 통과시키는 대각행렬 \(R(z)\)를 곱하는 것이다.
- 한 변수가 여러 경로로 출력에 영향을 주면 경로별 그래디언트를 더한다. 스킵 연결 \(y = F(x) + x\)는 그래디언트에 \(\delta_y\)를 그대로 더한다.
- 합성곱 출력 크기는 \(\lfloor (n + 2p - k)/s \rfloor + 1\)이고, 필터 수가 출력 채널 수, 필터당 매개변수는 \(k \times k \times C_{\text{in}}\)이다. \(1 \times 1\) 합성곱은 채널 수를 바꾼다.
- 합성곱은 희소하고 가중치를 공유하는 행렬 곱이다. 역전파도 합성곱이며, 입력 그래디언트는 뒤집은 필터로, 필터 그래디언트는 입력과 출력 그래디언트로 계산한다.