- UC Berkeley CS 182 (Spring 2021) Discussion 7 정리
- 관련 강의: Deep Learning 11, Deep Learning 12
배경: 어텐션 메커니즘
번역이나 캡션 생성에서 출력의 각 부분은 입력의 일부에만 주로 의존한다. 번역할 단어 하나를 만들 때 입력 문장 전체가 필요한 것은 아니며, 오히려 혼란을 줄 수도 있다. RNN은 이전 입력을 기억하는 상태를 갖지만, 그 상태 하나에 많은 과거 정보를 담아야 하므로 장기 의존성이 있는 작업에서 어렵다. 어텐션(attention) 은 네트워크가 데이터의 특정 부분에 주목하고, 과거 입력의 처리 결과에 임의 접근(random access)할 수 있게 한다.
Luong 어텐션
Luong 어텐션은 신경망 기계 번역(neural machine translation)에서 널리 쓰인 방식이다. 인코더가 원문을 읽으며 만든 은닉 상태 \(h_t\)들을 일종의 메모리로 보고, 디코더가 디코딩 중에 이 메모리에 접근한다. 디코더 단계 \(l\)의 은닉 상태를 \(h_l\)이라 하자.
- 각 인코더 상태와의 정렬 점수(alignment score) \(e_{t,l} = \text{score}(h_l, h_t)\)를 구한다. 원 논문은 여러 점수를 제안했는데, 내적 \(h_l^\top h_t\), 일반형(general) \(h_l^\top W_a h_t\), 디코더 상태만 쓰는 위치 기반(location) \(W_a h_l\) 등이 있다.
- softmax로 어텐션 가중치 \(\alpha_{t,l}\)를 얻는다.
- 문맥 벡터(context vector) \(c_l = \sum_t \alpha_{t,l} h_t\)를 구한다.
- 문맥 벡터와 디코더 상태를 이어 붙여 변환한다: \(\tilde{h}_l = \tanh(W_c [c_l;\, h_l])\). 이것으로 최종 출력을 계산한다.
초기 기계 번역 시스템은 인코더의 마지막 은닉 상태만 디코더에 넘겼지만, 이 방식은 인코더의 모든 은닉 상태를 활용한다.
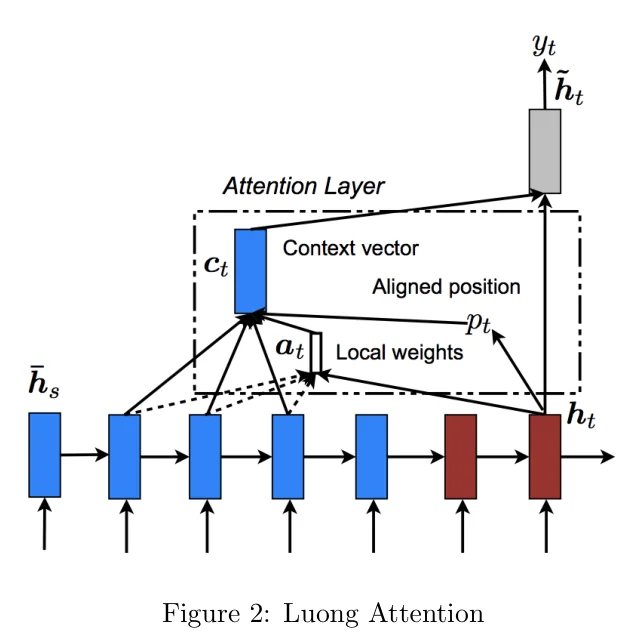 Luong 어텐션. 파란 막대는 인코더 상태 \(\bar{h}_s\), 빨간 막대는 디코더 상태이며, 어텐션 가중치 \(a_t\)로 만든 문맥 벡터 \(c_t\)가 \(h_t\)와 합쳐져 \(\tilde{h}_t\)와 출력 \(y_t\)가 된다. 출처: CS 182 Discussion 7.
그림을 오른쪽 아래의 현재 디코더 상태 \(h_t\)부터 읽는다. \(h_t\)에서 출발한 화살표들이 어텐션 층(점선 상자) 안으로 들어가 인코더 상태들과의 점수를 계산하고, 그 결과가 가중치 \(a_t\)(Local weights)다. 인코더 상태들에서 위로 모이는 화살표가 가중합이며, 그 결과가 문맥 벡터 \(c_t\)다. 마지막으로 \(c_t\)와 \(h_t\)가 회색 상자로 함께 올라가 \(\tilde{h}_t = \tanh(W_c[c_t; h_t])\)가 되고, 이것으로 \(y_t\)를 예측한다. 그림에 있는 “Aligned position \(p_t\)“는 원 논문의 지역(local) 어텐션 변형에서 쓰는 것으로, 원문에서 볼 중심 위치 \(p_t\)를 먼저 예측하고 그 주변 창 안의 인코더 상태에만 어텐션한다. 모든 인코더 상태를 보는 전역(global) 어텐션에서는 이 부분이 없다. 여기서 \(t\)는 디코더 단계로, 본문의 \(l\)에 해당한다.
Transformer의 셀프 어텐션
셀프 어텐션도 비슷한 절차를 따른다. 입력 임베딩에 서로 다른 변환을 적용해 쿼리 \(Q\), 키 \(K\), 값 \(V\)를 만든다. 각 쿼리와 각 키의 내적으로 점수를 구하고(행렬 곱으로 모든 시간 단계에 대해 한 번에 계산된다), softmax로 가중치를 만든 뒤 값의 가중합을 구한다. Luong 어텐션과 비교하면 쿼리는 디코더 상태 \(h_l\)에, 키와 값은 인코더 상태 \(h_t\)에 대응한다.
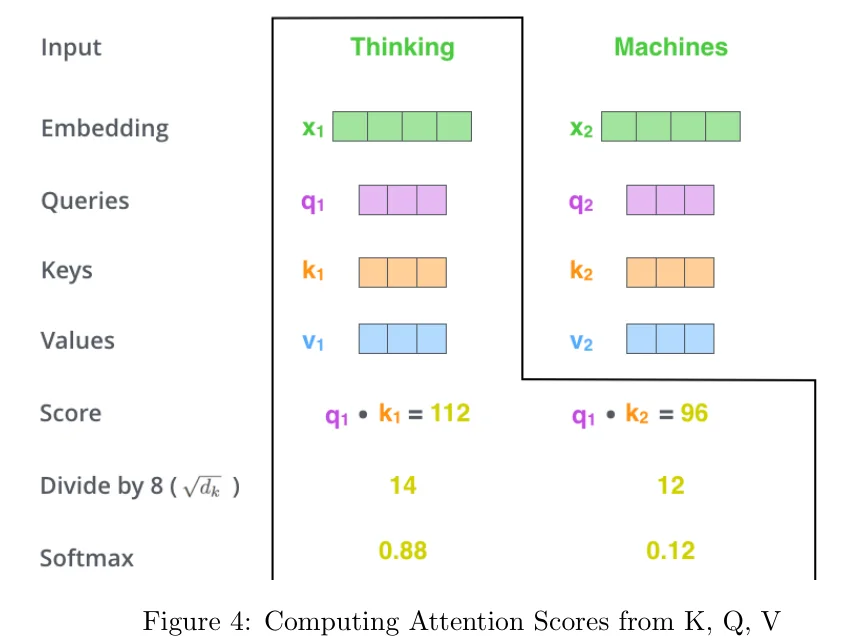 두 단어 “Thinking Machines”에서 첫 단어의 쿼리 \(q_1\)로 어텐션 가중치를 구하는 예. 점수 112와 96을 \(\sqrt{d_k} = 8\)로 나눈 14와 12에 softmax를 적용하면 0.88과 0.12가 된다. 출처: CS 182 Discussion 7.
그림을 위에서 아래로 따라가면 계산 순서가 그대로 보인다. 각 단어의 임베딩 \(x_1, x_2\)에 같은 행렬 \(W^Q, W^K, W^V\)를 곱해 \(q_i, k_i, v_i\)를 만든다. 첫 단어의 출력을 구할 때는 \(q_1\)을 모든 키와 내적한다. \(q_1 \cdot k_1 = 112\), \(q_1 \cdot k_2 = 96\)이다. 이를 키 차원의 제곱근 \(\sqrt{d_k} = 8\)(\(d_k = 64\))로 나누면 14와 12가 되고, softmax를 취하면 \(e^{14}/(e^{14}+e^{12}) = 1/(1+e^{-2}) \approx 0.88\), 나머지가 0.12다. 첫 단어의 출력은 \(0.88\, v_1 + 0.12\, v_2\)다.
나누기 단계가 없으면 점수 차이 16이 그대로 softmax에 들어가 가중치가 \(1/(1+e^{-16}) \approx 0.9999999\)로 사실상 한 위치에만 몰린다. 차원이 클수록 내적의 크기가 커지므로 이 현상이 심해지고, softmax의 기울기도 거의 0이 된다. 이것이 아래 1.3에서 다루는 스케일링의 필요성이다.
1.1 RNN에 어텐션 넣기
문제
RNN 모델에 셀프 어텐션을 어떻게 넣는지 높은 수준에서 설명한다.
풀이
각 은닉 상태가 자기 시퀀스의 이전 은닉 상태들에 어텐션하게 한다. 시점 \(t\)의 상태 \(h_t\)가 이전 상태 \(h_j\) (\(j < t\))에 대해 점수를 구하고,
\[e_{t,j} = \text{score}(h_t, h_j)\]softmax로 이전 상태들에 대한 어텐션 분포를 얻는다.
\[\alpha_{t,j} = \frac{\exp(e_{t,j})}{\sum_{j'=1}^{t-1} \exp(e_{t,j'})}\]어텐션 출력은 이전 상태들의 가중합이다.
\[a_t = \sum_{j=1}^{t-1} \alpha_{t,j} h_j\]이 \(a_t\)를 출력 계산이나 다음 단계의 입력에 함께 사용한다. 그러면 RNN이 은닉 상태 하나에 의존하지 않고 먼 과거의 상태에 직접 접근할 수 있다.
1.2 행렬 형태의 일반화된 어텐션
문제
쿼리 \(q\)를 키 \(k_1, \dots, k_t\)와 비교해 값 \(v_1, \dots, v_t\)에 어텐션하는 형태를 생각한다. 쿼리가 \(q_1, \dots, q_l\)로 여러 개일 때 이를 행렬로 표기한다.
풀이
쿼리, 키, 값을 각각 행으로 쌓아 행렬 \(Q \in \mathbb{R}^{l \times d}\), \(K \in \mathbb{R}^{t \times d}\), \(V \in \mathbb{R}^{t \times d_v}\)를 만든다. \(QK^\top\)의 \((i, j)\) 원소는 \(q_i^\top k_j\)이므로, 모든 쿼리-키 점수를 한 번에 담는다. 각 행에 softmax를 적용하면 각 쿼리의 어텐션 가중치가 되고, 여기에 \(V\)를 곱하면 각 쿼리의 가중합이 된다.
\[a(Q, K, V) = \operatorname{softmax}(QK^\top)\, V\]softmax는 행 방향 으로 적용한다. 결과는 \(l \times d_v\) 행렬이고, \(i\)번째 행이 쿼리 \(q_i\)의 어텐션 출력이다.
1.3 스케일드 셀프 어텐션의 근거
문제
실제 Transformer는 내적을 스케일링한 어텐션을 쓴다. \(q, k \in \mathbb{R}^d\)가 서로 독립이고 \(q, k \sim \mathcal{N}(\mu, \sigma^2 I)\) (\(\mu \in \mathbb{R}^d\), \(\sigma > 0\))라 하자.
- \(\mathbb{E}[q^\top k]\)를 \(\mu, \sigma, d\)로 나타낸다.
- \(\operatorname{Var}(q^\top k)\)를 \(\mu, \sigma, d\)로 나타낸다.
- 내적의 스케일링 인자를 \(s\)라 할 때, \(\mathbb{E}[q^\top k / s]\)가 \(d\)에 선형으로 비례하게 하려면 \(s\)는 무엇이어야 하는가?
- \(s = 1\)이면 내적의 분산에 어떤 일이 생기는지 설명한다.
풀이
1. 기댓값. \(q\)와 \(k\)가 독립이므로 \(\mathbb{E}[q_i k_i] = \mathbb{E}[q_i]\mathbb{E}[k_i] = \mu_i^2\)이다.
\[\mathbb{E}[q^\top k] = \sum_{i=1}^{d} \mathbb{E}[q_i k_i] = \sum_{i=1}^{d} \mu_i^2 = \mu^\top \mu\]2. 분산. \(\operatorname{Var}(q^\top k) = \mathbb{E}[(q^\top k)^2] - (\mu^\top\mu)^2\)이다. 첫 항은 trace를 이용해 정리한다.
\[\mathbb{E}[(q^\top k)^2] = \mathbb{E}[q^\top k k^\top q] = \mathbb{E}[\operatorname{Tr}(q q^\top k k^\top)] = \operatorname{Tr}\left(\mathbb{E}[q q^\top]\, \mathbb{E}[k k^\top]\right)\]마지막 등호는 독립성에서 나온다. \(\mathbb{E}[qq^\top] = \mathbb{E}[kk^\top] = \mu\mu^\top + \sigma^2 I\)이므로
\[\operatorname{Tr}\left((\mu\mu^\top + \sigma^2 I)^2\right) = \operatorname{Tr}(\mu\mu^\top\mu\mu^\top) + 2\sigma^2 \operatorname{Tr}(\mu\mu^\top) + \sigma^4 \operatorname{Tr}(I) = (\mu^\top\mu)^2 + 2\sigma^2 \mu^\top\mu + d\sigma^4\]이다. 따라서
\[\operatorname{Var}(q^\top k) = 2\sigma^2 \mu^\top\mu + d\sigma^4\]이다. 공식 해설은 \(2d\sigma^2\mu^\top\mu + d\sigma^4\)로 적었는데, \(\operatorname{Tr}(\mu\mu^\top) = \mu^\top\mu\)이므로 첫 항에 \(d\)가 붙지 않는 것이 맞다. (성분별로 확인해도 \(\operatorname{Var}(q_i k_i) = 2\sigma^2\mu_i^2 + \sigma^4\)이고, 이를 \(d\)개 더하면 같은 결과가 나온다.)
3. 스케일링 인자. 기댓값 \(\mu^\top\mu = \sum_i \mu_i^2\)는 각 성분의 크기가 일정하면 이미 \(d\)에 선형으로 비례한다. 따라서 기댓값을 \(d\)에 선형으로 유지하는 데에는 \(s = 1\)이면 충분하다는 것이 해설의 답이다.
4. \(s = 1\)일 때의 분산. 분산에 \(d\sigma^4\) 항이 있으므로(그리고 \(\mu^\top\mu\)도 \(d\)에 비례하므로) 분산이 \(d\)에 비례해 커진다. 차원이 커질수록 내적 값의 편차가 커져 softmax 입력이 매우 큰 값을 갖게 되고, softmax가 거의 원-핫으로 포화(saturate)된다. 포화된 softmax는 기울기가 매우 작아 학습이 어려워진다.
이것이 Transformer가 \(s = \sqrt{d}\)로 나누는 이유다. 평균이 0인 경우(\(\mu = 0\)) \(\operatorname{Var}(q^\top k) = d\sigma^4\)이므로, \(\sqrt{d}\)로 나누면
\[\operatorname{Var}\left(\frac{q^\top k}{\sqrt{d}}\right) = \sigma^4\]로 차원과 무관하게 일정해진다.
배경: Transformer
Transformer는 Transformer 인코더와 디코더로 이루어진다. 인코더는 원문 \(x_{\text{source}}\)를, 디코더는 목표 문장 \(x_{\text{target}}\)을 입력으로 받는다. 셀프 어텐션에 더해 다음 요소를 추가한다.
- 위치 인코딩: 순서 정보가 없는 문제를 해결한다.
- 멀티헤드 어텐션: 한 층에서 여러 위치를 조회한다.
- 비선형성: 위치별 피드포워드 층.
- 마스크 디코딩: 미래를 조회하지 못하게 한다.
표기는 배치 크기 \(B\), 원문 길이 \(L_s\), 목표 길이 \(L_t\), 은닉 차원 \(D\), 헤드 수 \(H\)다. 입력은 토큰 번호로 된 정수 텐서 \(x_{\text{source}} \in \mathbb{Z}^{B \times L_s}\), \(x_{\text{target}} \in \mathbb{Z}^{B \times L_t}\)다.
인코더
- 입력과 위치 임베딩. 원문을 은닉 차원으로 임베딩해 \(X_s \in \mathbb{R}^{B \times L_s \times D}\)를 만들고, 위치마다 다른 위치 인코딩을 더한다.
- 인코더 셀프 어텐션. \(W_Q, W_K, W_V \in \mathbb{R}^{D \times D}\)로 \(Q = X_s W_Q\), \(K = X_s W_K\), \(V = X_s W_V\)를 만들고 스케일드 내적 어텐션을 계산한다.
softmax는 키 축(마지막 축)에 적용해, 각 쿼리의 가중치 합이 1이 되게 한다.
- 멀티헤드. 텐서를 \(B \times L_s \times D\)에서 \(B \times H \times L_s \times (D/H)\)로 바꾸어(reshape, permute) 헤드마다 따로 어텐션을 계산한다.
- 패딩. 배치의 시퀀스 길이가 달라 \(L_s\)까지 패딩한다. 패딩 위치에 주목하지 않도록 softmax 전에 해당 점수에 \(-\infty\)를 더한다.
- 피드포워드 층. 각 위치에 선형 변환, 비선형 활성화, 두 번째 선형 변환을 차례로 적용한다.
디코더
- 마스크 디코더 셀프 어텐션. 인코더 셀프 어텐션과 같지만 마스크가 다르다. 각 위치는 이전 위치에만 주목해야 하므로, 쿼리 위치 \(i\)와 키 위치 \(j\)에 대해 \(j \le i\)이면 점수 \(q_i^\top k_j / \sqrt{D}\)를, 아니면 \(-\infty\)를 쓴다.
- 인코더-디코더 어텐션. 쿼리는 디코더 쪽에서, 키와 값은 인코더 출력에서 만든다: \(Q = X_t W_Q\), \(K = X_s W_K\), \(V = X_s W_V\). 여기서 \(X_s\)는 인코더의 최종 출력이다.
2. 기계 번역
문제
- 위치 인코딩이 필요한 이유는 무엇이고, 보통 어떻게 구현하는가?
- 멀티헤드 어텐션의 장점은 무엇인가? 멀티헤드 어텐션으로 찾을 수 있는 구조의 예를 든다.
- 입력 길이 \(M\), 출력 길이 \(N\), 은닉 차원 \(k\)일 때 (1) 인코더 셀프 어텐션, (2) 디코더-인코더 어텐션, (3) 디코더 셀프 어텐션의 복잡도는?
- 인코더의 활성값은 디코더 활성값에 의존하는가? 같은 원문을 다른 목표 언어로 번역하는 데 추가로 드는 계산은 \(M, N\)으로 얼마인가?
풀이
1. 위치 인코딩. 어텐션은 아래 층의 모든 입력 벡터에 대칭적으로 적용되므로, 그대로 두면 네트워크는 어떤 위치의 정보가 출력으로 전달되었는지 알 수 없다. 위치 인코딩은 단어의 위치를 알려 준다. 또한 가까운 위치의 인코딩끼리 내적이 크도록 만들면, 네트워크가 단어를 비교하고 근처 단어를 찾는 데 쓸 수 있다. 구현은 보통 sin/cos 기반 인코딩이나 학습된 위치 임베딩을 입력 임베딩에 더하는 방식이다.
2. 멀티헤드 어텐션. 하나의 어텐션 모듈이 입력 시퀀스의 여러 부분에 동시에 주목할 수 있다. softmax 하나는 대개 한 위치에 집중하므로, 출력이 여러 입력에 의존할 때(예: 번역에서 동사의 시제를 정하려면 주어와 시간 부사 등을 함께 봐야 한다) 유용하다. 실제 어텐션 헤드들은 문장과 문단의 시작, 주어-목적어 관계, 대명사가 가리키는 대상 같은 특징을 찾는 것으로 관찰된다.
3. 복잡도. 점수 행렬의 크기는 (쿼리 수) × (키 수)이고, 각 원소는 \(k\)차원 내적이다.
| 어텐션 | 쿼리 × 키 | 복잡도 |
|---|---|---|
| 인코더 셀프 어텐션 | \(M \times M\) | \(O(M^2 k)\) |
| 디코더-인코더 어텐션 | \(N \times M\) | \(O(MNk)\) |
| 디코더 셀프 어텐션 | \(N \times N\) | \(O(N^2 k)\) |
4. 인코더와 디코더의 의존성. 인코더 활성값은 디코더 활성값에 의존하지 않는다. 원문만으로 계산되기 때문이다. 따라서 같은 원문을 새 목표 시퀀스로 디코딩할 때는 인코더 출력을 재사용하고, 디코더 쪽 계산(크로스 어텐션과 디코더 셀프 어텐션)만 새로 하면 된다. 추가 계산은 \(O(MN + N^2)\) (은닉 차원까지 포함하면 \(O((MN + N^2)k)\))다.
Transformer를 쓰는 이유
Transformer는 장거리 연결이 좋고, 병렬화가 쉬우며, RNN보다 훨씬 깊게 만들 수 있다. 반면 어텐션 구현이 복잡하고 계산이 \(O(n^2)\)다. 실제로는 장점이 단점을 크게 앞서며, 많은 경우 RNN과 LSTM보다 잘 작동한다.
정리
- Luong 어텐션은 디코더 상태와 인코더 상태의 정렬 점수를 softmax해 문맥 벡터를 만들고, 이를 디코더 상태와 결합해 출력을 낸다.
- 여러 쿼리에 대한 어텐션은 \(\operatorname{softmax}(QK^\top)V\) (행 방향 softmax)로 한 번에 쓸 수 있다.
- 독립인 \(q, k \sim \mathcal{N}(\mu, \sigma^2 I)\)에 대해 \(\mathbb{E}[q^\top k] = \mu^\top\mu\), \(\operatorname{Var}(q^\top k) = 2\sigma^2\mu^\top\mu + d\sigma^4\)다. 분산이 \(d\)에 비례해 커지므로 \(\sqrt{d}\)로 나누어 softmax 포화를 막는다.
- Transformer 인코더는 스케일드 멀티헤드 셀프 어텐션과 피드포워드 층으로, 디코더는 마스크 셀프 어텐션과 인코더-디코더 어텐션으로 구성된다. 패딩과 미래 위치는 점수에 \(-\infty\)를 더해 가린다.
- 어텐션 비용은 인코더 \(O(M^2k)\), 크로스 \(O(MNk)\), 디코더 \(O(N^2k)\)이며, 인코더 출력은 디코더와 무관하므로 재사용할 수 있다.