- UC Berkeley CS 182 (Spring 2021) Discussion 6 정리
- 관련 강의: Deep Learning 10
이번 Discussion은 순환 신경망(RNN)과 LSTM을 다룬다. 원래 세션에서는 중간고사 대비도 함께 진행했지만, 여기서는 워크시트 내용만 정리한다.
배경: 시퀀스 문제와 Vanilla RNN
시퀀스 모델로 풀고 싶은 문제는 입출력 형태에 따라 나뉜다.
- one-to-one: 입력 하나, 출력 하나. 이미지 분류, 의미 분할(semantic segmentation)이 여기에 속한다.
- one-to-many: 입력 하나, 출력 시퀀스. 이미지 캡션 생성이 대표적이다.
- many-to-many: 입력 시퀀스, 출력 시퀀스. 기계 번역이 대표적이다.
일반 신경망은 앞선 입력에 대한 추론을 다음 입력에 활용하는 장치가 없다. RNN은 이전 단계에서 계산한 상태를 현재 입력과 함께 다시 넣는 순환 연결(recurrent connection) 로 정보를 과거에서 미래로 전달한다. 이를 시간 축으로 펼치면(unroll) 깊이가 시퀀스 길이와 같고 모든 층이 아핀 파라미터를 공유하는 깊은 피드포워드 네트워크가 된다.
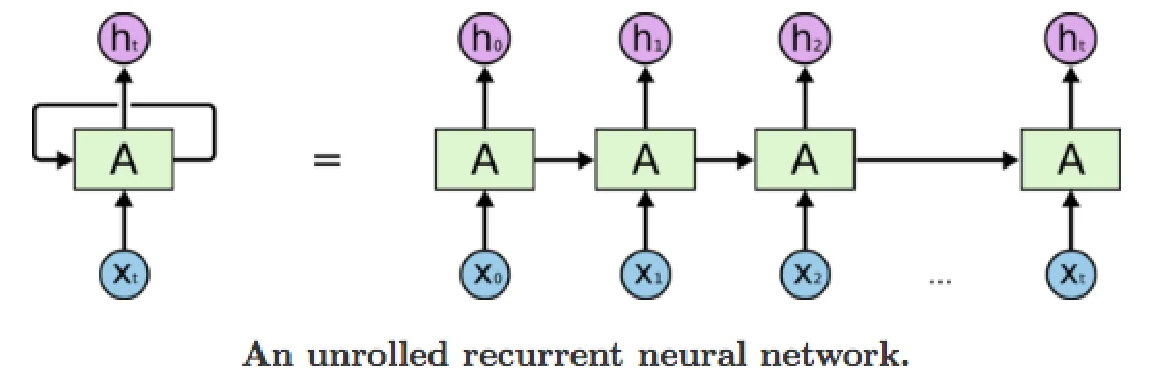 왼쪽은 자기 자신으로 돌아오는 고리가 있는 RNN 셀 A, 오른쪽은 이를 시간 축으로 펼친 모습이다. 펼친 각 칸은 모두 같은 셀 A(같은 가중치)다. 출처: CS 182 Discussion 6.
그림의 등호 양쪽은 같은 계산을 다르게 그린 것이다. 왼쪽에서 셀 A는 입력 \(x_t\)와 고리를 통해 돌아온 이전 상태를 받아 \(h_t\)를 낸다. 오른쪽에서는 이 고리를 시간 순서대로 풀어 \(x_0, x_1, x_2, \dots, x_t\)가 차례로 들어가는 A의 사슬로 그렸다. 가로 화살표가 은닉 상태의 전달이고, 각 칸 위의 \(h_0, h_1, \dots\)이 단계별 출력이다. 펼친 그림으로 보면 RNN은 층마다 입력이 하나씩 추가되고 가중치가 모든 층에서 공유되는 깊은 네트워크이며, 아래 1.1의 기울기 문제도 이 깊이에서 생긴다.
입력을 \(x_t \in \mathbb{R}^k\), 출력을 \(y_t \in \mathbb{R}^m\) (\(t = 1, \dots, T\))라 하면, many-to-many vanilla RNN은 다음과 같다.
\[h_t = \tanh(W_{h,h} h_{t-1} + W_{x,h} x_t + B_h), \qquad y_t = W_{h,y} h_t + B_y\]기울기는 각 시간 단계 출력의 손실을 모두 더한 것에 대해 계산한다.
1.1 Vanilla RNN의 기울기
문제
RNN에서 기울기 소실(vanishing)이나 폭발(exploding)이 왜 문제가 되는지 설명한다.
풀이
펼친 RNN은 깊은 피드포워드 네트워크와 같으므로 같은 문제를 겪는다. 한 단계의 야코비안은
\[\frac{\partial h_t}{\partial h_{t-1}} = \operatorname{diag}\!\left(1 - h_t^2\right) W_{h,h}\]이다. 마지막 단계의 손실을 \(h_1\)까지 역전파하면 이런 야코비안이 \(T-1\)번 곱해진다.
\[\frac{\partial h_T}{\partial h_1} = \prod_{t=2}^{T} \operatorname{diag}\!\left(1 - h_t^2\right) W_{h,h}\]같은 행렬 \(W_{h,h}\)가 매 단계 곱해지므로(역전파에서는 \(W_{h,h}^\top\)가 곱해진다), 기울기의 크기는 대략 \(W_{h,h}\)의 특이값(singular value)의 거듭제곱처럼 움직인다. 특이값이 1보다 크면 기울기가 폭발하고, 1보다 작으면 소실된다. 또 \(\tanh\)의 미분 \(1 - h_t^2 \le 1\)도 매 단계 곱해지므로 기울기 소실을 더 부추긴다. 결과적으로 \(W\)에 대한 손실의 기울기가 매우 커지거나 매우 작아져, 먼 과거의 정보를 학습하기 어렵다.
1.2 RNN 구현
문제
NumPy로 vanilla RNN 클래스의 forward를 완성한다. forward는 한 시간 단계의 입력을 처리하고 은닉 상태를 갱신한 뒤 출력을 반환한다. 모든 차원은 3이다.
풀이
위의 식을 그대로 옮기면 된다. 은닉 상태를 먼저 갱신하고, 갱신된 은닉 상태로 출력을 계산한다.
import numpy as np

class VanillaRNN:
    def __init__(self):
        self.W_hh = np.random.randn(3, 3)
        self.W_xh = np.random.randn(3, 3)
        self.W_hy = np.random.randn(3, 3)
        self.Bh = np.random.randn(3)
        self.By = np.random.randn(3)
        self.hidden_state = np.zeros(3)

    def forward(self, x):
        # h_t = tanh(W_hh h_{t-1} + W_xh x_t + B_h)
        self.hidden_state = np.tanh(self.W_hh @ self.hidden_state
                                    + self.W_xh @ x + self.Bh)
        # y_t = W_hy h_t + B_y
        self.output = self.W_hy @ self.hidden_state + self.By
        return self.output
시퀀스 전체를 처리하려면 forward를 \(x_1, \dots, x_T\)에 대해 차례로 호출한다. 같은 가중치가 매 단계 재사용된다는 점이 핵심이다. (공식 해설 코드에는 self.out과 self.output의 이름이 섞여 있는 등 사소한 오타가 있어, 여기서는 일관되게 고쳐 적었다.)
배경: LSTM
LSTM 셀은 단계 사이에 두 상태, 셀 메모리 \(C_t\)와 은닉 상태 \(h_t\)를 전달한다. 워크시트의 표기(행 벡터 관례)로 갱신식은 다음과 같다.
\[\begin{aligned} f_t &= \sigma(x_t U^f + h_{t-1} W^f) \\ i_t &= \sigma(x_t U^i + h_{t-1} W^i) \\ o_t &= \sigma(x_t U^o + h_{t-1} W^o) \\ \tilde{C}_t &= \tanh(x_t U^g + h_{t-1} W^g) \\ C_t &= f_t \circ C_{t-1} + i_t \circ \tilde{C}_t \\ h_t &= \tanh(C_t) \circ o_t \end{aligned}\]\(\circ\)는 원소별 곱(Hadamard product)이다.
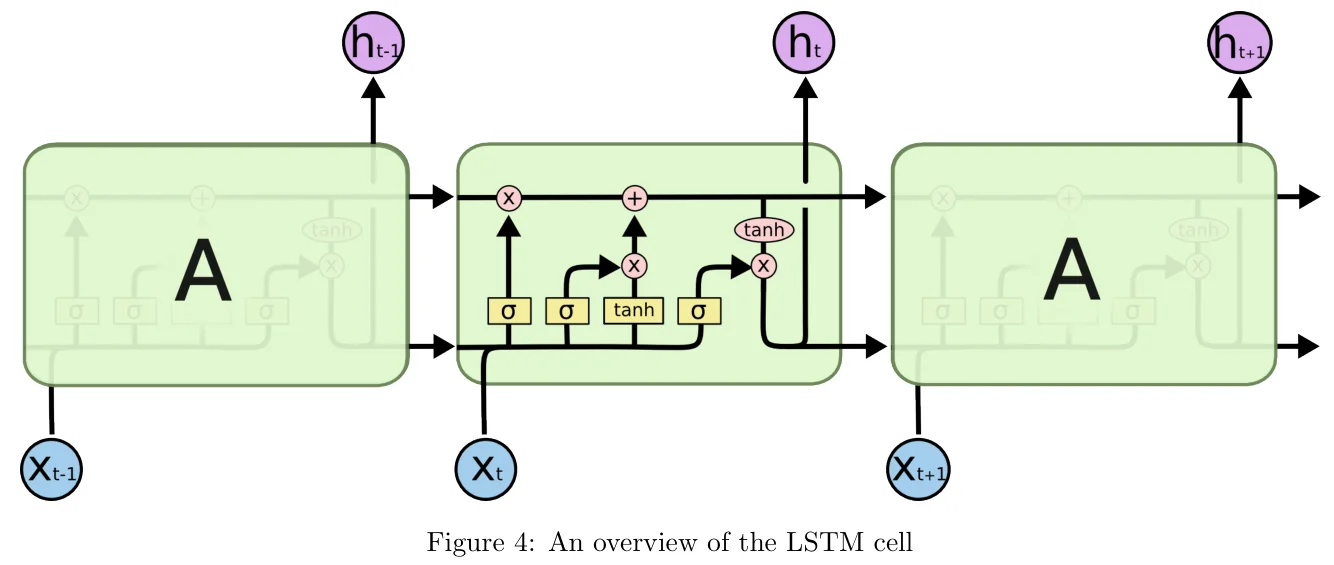 세 시간 단계에 걸친 LSTM. 가운데 셀 안에서 위쪽 가로선이 셀 메모리 \(C\), 아래쪽 가로선이 은닉 상태 \(h\)이며, 노란 상자 넷이 \(f_t, i_t, \tilde{C}_t, o_t\)를 만드는 층이다. 출처: CS 182 Discussion 6.
가운데 셀의 노란 상자를 왼쪽부터 읽으면 위 식의 순서와 같다. 첫 번째 \(\sigma\)가 망각 게이트 \(f_t\)로, 위쪽 선의 \(\times\)에서 \(C_{t-1}\)에 곱해진다. 두 번째 \(\sigma\)(입력 게이트 \(i_t\))와 tanh(후보 \(\tilde{C}_t\))는 가운데 \(\times\)에서 곱해진 뒤 위쪽 선의 \(+\)로 더해진다. 네 번째 \(\sigma\)가 출력 게이트 \(o_t\)로, 새 메모리 \(C_t\)에 tanh를 씌운 값과 오른쪽 \(\times\)에서 곱해져 \(h_t\)가 된다. 위쪽 선이 셀을 가로지르는 동안 거치는 연산이 원소별 곱 하나와 덧셈 하나뿐이라는 점이 아래 2.2에서 기울기 소실이 완화되는 이유와 직접 연결된다.
- 망각 게이트 \(f_t \in (0,1)\): 이전 메모리에 곱해진다. 1에 가까우면 기억하고, 0에 가까우면 잊는다.
- 입력(갱신) 게이트 \(i_t\): 현재 입력에서 만든 후보 \(\tilde{C}_t\)를 메모리에 얼마나 더할지 정한다.
- 출력 게이트 \(o_t\): 다음 셀로 넘길 출력 \(h_t\)를 조절한다.
Vanilla RNN은 \(h_t\) 하나로 출력과 기억을 모두 담당하므로 매 단계 아핀 변환과 \(\tanh\)를 거치고, 그래서 기울기가 쉽게 소실되거나 폭발한다. LSTM은 셀 상태 \(C_t\)를 장기 기억 으로 쓴다. \(C_t\)는 후보 값들의 이동 평균처럼 단순하고 느리게 변하므로 이를 통한 역전파가 훨씬 쉽다. 은닉 상태 \(h_t\)는 빠르게 변하는 단기 기억 역할을 한다.
2.1 LSTM을 통한 역전파
문제
최종 비용을 \(J\)라 할 때, 다음 기울기들을 조합해 \(\partial J / \partial W^g\)를 구한다.
\[\frac{\partial h_t}{\partial h_{t-1}},\ \frac{\partial h_{t-1}}{\partial W^g},\ \frac{\partial J}{\partial h_t},\ \frac{\partial C_t}{\partial W^g},\ \frac{\partial C_{t-1}}{\partial W^g},\ \frac{\partial C_t}{\partial C_{t-1}},\ \frac{\partial h_t}{\partial C_t},\ \frac{\partial h_t}{\partial o_t}\]풀이
\(W^g\)는 모든 시간 단계에서 공유되므로, 각 \(h_t\)를 통해 들어오는 기여를 모두 더한다.
\[\frac{\partial J}{\partial W^g} = \sum_{t=1}^{T} \frac{\partial J}{\partial h_t}\frac{\partial h_t}{\partial W^g}\]\(h_t\)가 \(W^g\)에 의존하는 경로는 두 가지다. 하나는 셀 상태 \(C_t\)를 통한 경로이고, 다른 하나는 이전 은닉 상태 \(h_{t-1}\)을 통한 경로(게이트들이 \(h_{t-1}\)에 의존한다)다. 또 \(C_t\)는 \(\tilde{C}_t\)를 통해 \(W^g\)에 직접 의존하고, \(C_{t-1}\)을 통해 간접적으로도 의존한다. 이를 펼치면 해설의 식을 얻는다.
\[\frac{\partial J}{\partial W^g} = \sum_{t=1}^{T} \frac{\partial J}{\partial h_t}\left( \frac{\partial h_t}{\partial C_t}\left( \frac{\partial C_t}{\partial W^g} + \frac{\partial C_t}{\partial C_{t-1}}\frac{\partial C_{t-1}}{\partial W^g} \right) + \frac{\partial h_t}{\partial h_{t-1}}\frac{\partial h_{t-1}}{\partial W^g} \right)\]여기서 괄호 안의 \(\partial C_t / \partial W^g\)는 \(\tilde{C}_t\)를 통한 직접 의존이고, \(\partial C_{t-1}/\partial W^g\)와 \(\partial h_{t-1}/\partial W^g\)는 다시 같은 방식으로 재귀적으로 펼쳐지는 전체 미분이다. 즉 역전파는 \(C\)의 사슬과 \(h\)의 사슬 두 갈래를 따라 과거로 내려간다.
2.2 LSTM과 기울기 소실
문제
앞에서 구한 기울기에서, LSTM이 기울기 소실을 완화할 수 있게 해 주는 항은 무엇인지 찾는다.
풀이
핵심은 \(\partial C_t / \partial C_{t-1}\)이다. \(C_t = f_t \circ C_{t-1} + i_t \circ \tilde{C}_t\)에서 \(C_{t-1}\)에 대한 직접 편미분은
\[\frac{\partial C_t}{\partial C_{t-1}} = \operatorname{diag}(f_t)\]이다. 망각 게이트가 \(f_t \approx 1\)이면 이 야코비안은 항등 행렬에 가까워, 현재 셀로 들어온 기울기가 줄어들지 않고 이전 셀로 그대로 전달된다. 여러 단계를 거쳐도
\[\frac{\partial C_T}{\partial C_1} = \prod_{t=2}^{T} \operatorname{diag}(f_t)\]로, vanilla RNN처럼 같은 가중치 행렬과 \(\tanh\) 미분이 반복해서 곱해지지 않는다. 기울기의 크기를 게이트가 (학습을 통해) 직접 조절한다. 이는 ResNet의 스킵 연결(skip connection)이 항등 경로로 기울기를 전달하는 것과 부분적으로 비슷하다.
정리
- 펼친 RNN은 가중치를 공유하는 깊은 네트워크라, 같은 \(W_{h,h}\)와 \(\tanh\) 미분이 반복해서 곱해지며 기울기가 폭발하거나 소실된다.
- Vanilla RNN의 순전파는 \(h_t = \tanh(W_{h,h}h_{t-1} + W_{x,h}x_t + B_h)\), \(y_t = W_{h,y}h_t + B_y\)를 매 단계 같은 가중치로 반복하는 것이다.
- LSTM은 망각·입력·출력 게이트와 셀 상태 \(C_t\)로 장기 기억과 단기 기억을 분리한다.
- 공유 가중치에 대한 기울기는 모든 시간 단계의 기여를 더하며, LSTM에서는 셀 상태 경로와 은닉 상태 경로 두 갈래로 역전파된다.
- \(\partial C_t/\partial C_{t-1} = \operatorname{diag}(f_t)\)이므로 \(f_t \approx 1\)일 때 기울기가 거의 그대로 전달되어 기울기 소실이 완화된다.