- UC Berkeley CS 182 (Spring 2021) Discussion 2 정리
- 관련 강의: Deep Learning 2, Deep Learning 3, Deep Learning 4
이번 Discussion은 세 부분이다. 편향-분산 트레이드오프를 유도하고 정규화가 둘을 어떻게 바꾸는지 예제로 보고(문제 1~3), 역전파에 필요한 벡터/행렬 미분 표기를 정리하고(문제 4~7), 강의에서 다룬 최적화 방법을 복습한다.
직관적으로, 분산이 크면 추정값이 과녁 주위에 넓게 흩어지고, 편향이 크면 추정값이 과녁 중심에서 한쪽으로 치우친다. 좋은 추정은 둘 다 작다.
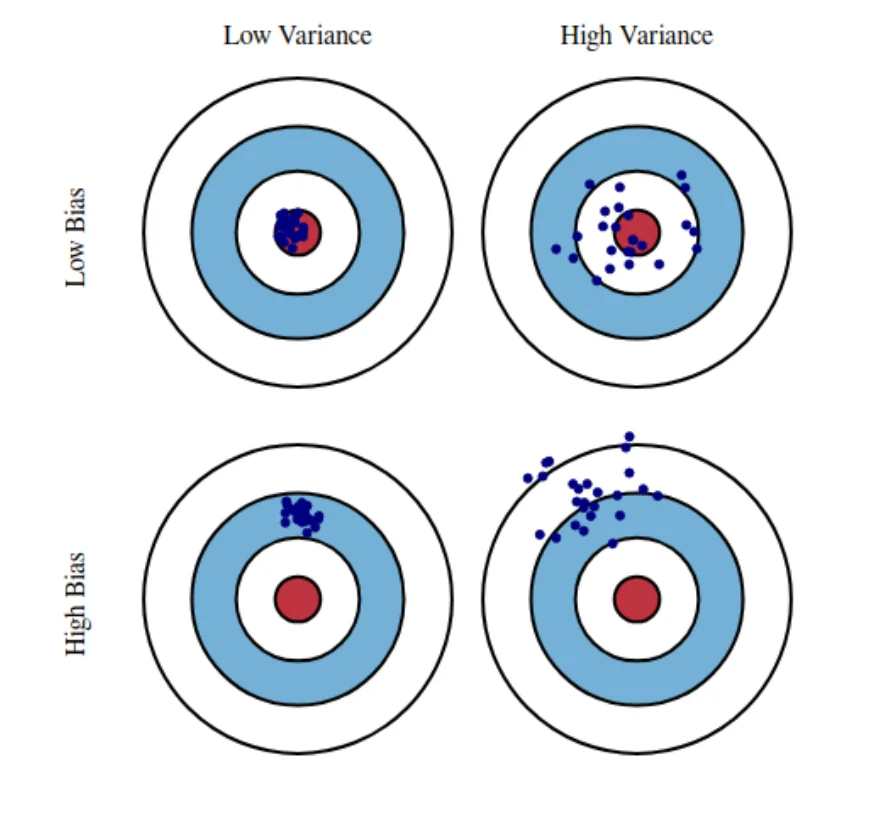 편향과 분산을 과녁 맞히기로 나타낸 그림. 빨간 중심이 참값이고, 파란 점 하나하나가 서로 다른 학습 집합으로 얻은 추정값이다. 열은 분산(낮음/높음), 행은 편향(낮음/높음)을 바꾼다. 출처: CS 182 Discussion 2.
네 칸을 차례로 읽으면 두 개념이 분리된다. 왼쪽 위(낮은 편향, 낮은 분산)는 점들이 중심에 모여 있다. 오른쪽 위(낮은 편향, 높은 분산)는 점들의 평균은 중심에 가깝지만 하나하나는 넓게 흩어져 있다. 왼쪽 아래(높은 편향, 낮은 분산)는 점들이 촘촘히 모여 있지만 모인 위치가 중심에서 벗어나 있어, 학습 집합을 아무리 바꿔도 같은 쪽으로 틀린다. 오른쪽 아래는 둘 다 나쁜 경우다. 아래 문제 1의 분해에서 분산 항은 점들이 자기 평균 주위로 퍼진 정도, 편향 항은 그 평균과 중심 사이의 거리에 해당한다.
1. 편향-분산 트레이드오프 유도
문제
테스트 데이터와 독립으로 뽑은 학습 집합 \(\mathcal{D}\)로 추정량 \(\hat\theta(\mathcal{D})\)를 얻는다(예: 경험적 위험 최소화). 특정 테스트 입력 \(x\)에서의 기대 제곱오차가 분산, 편향의 제곱, 줄일 수 없는 오차로 분해됨을 보여라.
\[\mathbb{E}_{Y \sim p(y \mid x),\, \mathcal{D}}\left[(Y - f_{\hat\theta(\mathcal{D})}(x))^2\right] = \operatorname{Var}(f_{\hat\theta(\mathcal{D})}(x)) + \operatorname{Bias}(f_{\hat\theta(\mathcal{D})}(x))^2 + \sigma^2\]여기서 \(\operatorname{Var}(f) = \mathbb{E}_\mathcal{D}[(f - \mathbb{E}_\mathcal{D}[f])^2]\), \(\operatorname{Bias}(f) = \mathbb{E}_{Y, \mathcal{D}}[f - Y]\)다.
풀이
\(f = f_{\hat\theta(\mathcal{D})}(x)\)로 줄여 쓰고, \(\mathbb{E}\)는 \(Y\)와 \(\mathcal{D}\) 모두에 대한 기댓값이다. 제곱을 전개한다.
\[\mathbb{E}[(Y - f)^2] = \mathbb{E}[f^2] - 2\,\mathbb{E}[Yf] + \mathbb{E}[Y^2]\]\(Y\)(테스트 레이블)와 \(\mathcal{D}\)(학습 집합)는 독립이므로 \(\mathbb{E}[Yf] = \mathbb{E}[Y]\,\mathbb{E}[f]\)다. 또 \(\mathbb{E}[f^2] = \operatorname{Var}(f) + \mathbb{E}[f]^2\), \(\mathbb{E}[Y^2] = \operatorname{Var}(Y \mid x) + \mathbb{E}[Y]^2\)이다. 대입하면 다음과 같다.
\[\begin{aligned} \mathbb{E}[(Y - f)^2] &= \operatorname{Var}(f) + \mathbb{E}[f]^2 - 2\,\mathbb{E}[Y]\,\mathbb{E}[f] + \mathbb{E}[Y]^2 + \operatorname{Var}(Y \mid x) \\ &= \operatorname{Var}(f) + (\mathbb{E}[f] - \mathbb{E}[Y])^2 + \operatorname{Var}(Y \mid x) \\ &= \operatorname{Var}(f) + \operatorname{Bias}(f)^2 + \sigma^2 \end{aligned}\]조건부 분산 \(\sigma^2 = \operatorname{Var}(Y \mid x)\)는 어떤 학습기를 쓰든 남는 줄일 수 없는 오차(irreducible error) 다. 따라서 학습 알고리즘과 하이퍼파라미터는 편향과 분산을 동시에 작게 만들도록 골라야 한다. 3강의 분해는 잡음 항이 없는 버전이다.
2. 선형 회귀 모델의 편향과 분산
문제
\(Y = X\theta + \varepsilon\)이고, 잡음 \(\varepsilon_i\)는 평균 0, 분산 1로 i.i.d.다. \(X \in \mathbb{R}^{n \times d}\)는 고정된 데이터 행렬이다. 최소제곱(OLS) 추정량 \(\hat\theta = (X^TX)^{-1}X^TY\)의 편향과 공분산을 구하고, 이를 이용해 테스트 입력 \(x\)에서 예측의 편향과 분산을 구하라. 필요하면 \(X^TX\)가 대각행렬이라고 가정한다.
풀이
편향. \(Y = X\theta + \varepsilon\)을 대입한다.
\[\mathbb{E}[\hat\theta] = \mathbb{E}\left[(X^TX)^{-1}X^T(X\theta + \varepsilon)\right] = \theta + (X^TX)^{-1}X^T\,\mathbb{E}[\varepsilon] = \theta\]OLS 추정량은 불편추정량이다. 테스트 입력에서의 예측도 \(\mathbb{E}[x^T\hat\theta - x^T\theta] = 0\)이므로 불편이다.
공분산. \(\hat\theta - \theta = (X^TX)^{-1}X^T\varepsilon\)이고 \(\mathbb{E}[\varepsilon\varepsilon^T] = I_n\)이다.
\[\begin{aligned} \mathbb{E}[(\hat\theta - \theta)(\hat\theta - \theta)^T] &= (X^TX)^{-1}X^T\,\mathbb{E}[\varepsilon\varepsilon^T]\,X(X^TX)^{-1} \\ &= (X^TX)^{-1}X^TX(X^TX)^{-1} = (X^TX)^{-1} \end{aligned}\]예측의 분산. 테스트 입력 \(x\)에서 다음과 같다.
\[\operatorname{Var}[x^T(\hat\theta - \theta)] = \mathbb{E}[x^T(\hat\theta - \theta)(\hat\theta - \theta)^Tx] = x^T(X^TX)^{-1}x\]편향과 달리 분산은 \(x\)에 의존한다. \(X^TX\)가 대각이고 대각 성분이 \(\sigma_1^2 \geq \dots \geq \sigma_d^2\)(각 차원의 데이터 분산에 해당)라면 다음과 같다.
\[\operatorname{Var} = \sum_{i=1}^d \frac{x_i^2}{\sigma_i^2}\]데이터의 분산이 거의 없는 방향(\(\sigma_i \to 0\))에서는 추정의 분산, 따라서 위험이 폭발할 수 있다.
3. L2 정규화된 선형 회귀의 편향과 분산 (도전 문제)
문제
L2 정규화 추정량 \(\tilde\theta = (X^TX + \lambda I)^{-1}X^TY\)를 쓰면 편향과 분산은 어떻게 되는가?
풀이
편향.
\[\mathbb{E}[\tilde\theta - \theta] = (X^TX + \lambda I)^{-1}X^TX\theta - \theta = -\lambda (X^TX + \lambda I)^{-1}\theta\]마지막 등호는 \(X^TX = (X^TX + \lambda I) - \lambda I\)에서 나온다. 이제 편향은 0이 아니다.
공분산. 평균을 \(\bar\theta = (X^TX + \lambda I)^{-1}X^TX\theta\)라 하면 \(\tilde\theta - \bar\theta = (X^TX + \lambda I)^{-1}X^T\varepsilon\)이다.
\[\mathbb{E}[(\tilde\theta - \bar\theta)(\tilde\theta - \bar\theta)^T] = (X^TX + \lambda I)^{-1}X^TX(X^TX + \lambda I)^{-1}\]\(X^TX\)가 대각이면 공분산도 대각이며, 성분은 다음과 같다.
\[\frac{\sigma_i^2}{(\sigma_i^2 + \lambda)^2}\]정규화하지 않은 경우 \(\frac{1}{\sigma_i^2}\)은 \(\sigma_i \to 0\)일 때 무한히 커지지만, 이 값은 \(\sigma_i \to 0\)일 때 0으로 가고 전체적으로 \(\frac{1}{4\lambda}\) 이하로 유계다. 대신 편향의 \(i\)번째 성분은 \(-\frac{\lambda\,\theta_i}{\sigma_i^2 + \lambda}\)로, \(\sigma_i\)가 작은 방향일수록 커진다. 즉 L2 정규화는 민감한 방향의 큰 분산을 줄이는 대가로 편향을 도입하며, \(\lambda\)가 이 트레이드오프를 조절한다.
4. 제곱 L2 노름의 그래디언트
문제
벡터 표기 관례부터 정한다. 스칼라 함수 \(f: \mathbb{R}^d \to \mathbb{R}\)의 그래디언트는 입력과 같은 모양의 열벡터로 둔다.
\[\nabla_x f(x) = \begin{bmatrix} \frac{\partial f}{\partial x_1}(x) & \cdots & \frac{\partial f}{\partial x_d}(x) \end{bmatrix}^T\]이 관례는 \(\theta \leftarrow \theta - \alpha\nabla\mathcal{L}(\theta)\)처럼 매개변수와 그래디언트의 모양이 같아야 하는 딥러닝에서 직관적이고, 행렬이나 고차원 배열로 쉽게 확장된다. 수학 문헌에서는 그래디언트를 행벡터로 두는 반대 관례도 흔하다.
\(f(x) = \lVert x \rVert_2^2 = x^Tx\)의 그래디언트 \(\nabla f(x)\)를 구하라.
풀이
\(f(x) = \sum_{i=1}^d x_i^2\)이므로 \(\frac{\partial f}{\partial x_i} = 2x_i\)다. 벡터로 모으면 다음과 같다.
\[\nabla f(x) = 2x\]5. 선형 사상의 야코비안
문제
벡터값 함수 \(f: \mathbb{R}^n \to \mathbb{R}^m\)의 야코비안 \(\frac{\partial f}{\partial x}\)는 각 출력 성분 \(f_j\)의 그래디언트를 열로 쌓은 \(n \times m\) 행렬로 정의한다.
\[\left( \frac{\partial f}{\partial x} \right)_{ij} = \frac{\partial f_j}{\partial x_i}\]\(x \in \mathbb{R}^d\), \(A \in \mathbb{R}^{d \times n}\)일 때 \(f(x) = A^Tx \in \mathbb{R}^n\)의 야코비안을 구하라.
풀이
\(j\)번째 출력은 \(f_j(x) = \sum_{i=1}^d A_{ij}x_i\)이므로 \(\frac{\partial f_j}{\partial x_i} = A_{ij}\)다. 따라서 다음과 같다.
\[\frac{\partial f(x)}{\partial x} = A\]이 관례에서는 \(A^Tx\)의 야코비안이 전치 없이 \(A\)가 된다.
6. 두 계산을 연쇄 법칙으로 합치기
문제
먼저 다변수 연쇄 법칙을 정리한다. \(x \in \mathbb{R}^m\), \(y = g(x) \in \mathbb{R}^n\), \(z = f(y) \in \mathbb{R}\)이면 \(y\)의 각 성분의 기여를 더해 다음을 얻는다.
\[\frac{\partial z}{\partial x_j} = \sum_{i=1}^n \frac{\partial z}{\partial y_i}\frac{\partial y_i}{\partial x_j}, \qquad \underbrace{\frac{\partial z}{\partial x}}_{\mathbb{R}^m} = \underbrace{\frac{\partial y}{\partial x}}_{\mathbb{R}^{m \times n}} \underbrace{\frac{\partial z}{\partial y}}_{\mathbb{R}^n}\]\(g(x) = A^Tx\), \(f(y) = \lVert y \rVert_2^2\)일 때 \(f(g(x))\)의 \(x\)에 대한 그래디언트를 구하라.
풀이
\(y = g(x)\), \(z = f(y)\)라 하자. 문제 4에서 \(\frac{\partial z}{\partial y} = 2y\), 문제 5에서 \(\frac{\partial y}{\partial x} = A\)다. 연쇄 법칙을 적용한다.
\[\frac{\partial z}{\partial x} = \frac{\partial y}{\partial x}\frac{\partial z}{\partial y} = 2Ay = 2AA^Tx\]\(z = x^TAA^Tx\)를 직접 미분해도 \(2AA^Tx\)를 얻으므로 결과가 맞다.
7. 행렬에 대한 미분으로 다시 풀기
문제
행렬 입력 \(X \in \mathbb{R}^{d_1 \times d_2}\)에 대한 스칼라 함수의 그래디언트도 입력과 같은 모양, 즉 \((\nabla_X f)_{ij} = \frac{\partial f}{\partial X_{ij}}\)인 \(d_1 \times d_2\) 행렬로 둔다. 벡터 출력 \(y \in \mathbb{R}^n\)의 행렬에 대한 야코비안은 3차 텐서 \(\left(\frac{\partial y}{\partial X}\right)_{ijk} = \frac{\partial y_k}{\partial X_{ij}}\)이고, 연쇄 법칙은 다음과 같다.
\[\frac{\partial z}{\partial X_{ij}} = \sum_{k=1}^n \frac{\partial y_k}{\partial X_{ij}}\frac{\partial z}{\partial y_k}, \qquad \underbrace{\frac{\partial z}{\partial X}}_{\mathbb{R}^{d_1 \times d_2}} = \underbrace{\frac{\partial y}{\partial X}}_{\mathbb{R}^{d_1 \times d_2 \times n}} \underbrace{\frac{\partial z}{\partial y}}_{\mathbb{R}^n}\]3차 텐서와 벡터의 곱은 행렬-벡터 곱의 일반화로, 결과의 각 성분은 텐서의 한 “행”과 벡터의 내적이다. 이는 \(X\)를 벡터로 펼쳐 벡터 연쇄 법칙을 쓰고 다시 모양을 되돌리는 것과 같다.
문제 6과 같은 \(z = \lVert A^Tx \rVert_2^2\)를 이번에는 \(A\)에 대해 미분하라.
풀이
\(y = A^Tx\), \(z = \lVert y \rVert_2^2\)라 하자. \(\frac{\partial z}{\partial y} = 2y\)다. \(y_k = \sum_{i=1}^d A_{ik}x_i\)이므로 야코비안 성분은 다음과 같다.
\[\left( \frac{\partial y}{\partial A} \right)_{ijk} = \frac{\partial y_k}{\partial A_{ij}} = \begin{cases} x_i & j = k \\ 0 & \text{otherwise} \end{cases}\]연쇄 법칙을 성분별로 쓰면 \(k = j\)인 항만 남는다.
\[\frac{\partial z}{\partial A_{ij}} = \sum_{k=1}^n \left( \frac{\partial y}{\partial A} \right)_{ijk} \frac{\partial z}{\partial y_k} = x_i \cdot 2y_j = 2x_iy_j\]외적으로 쓰면 다음과 같다.
\[\frac{\partial z}{\partial A} = 2xy^T = 2xx^TA\]모양을 확인하면 \(x \in \mathbb{R}^d\), \(y^T \in \mathbb{R}^{1 \times n}\)이므로 \(A\)와 같은 \(d \times n\)이다. 연쇄 법칙에서 최종 출력에 대한 미분이 가장 오른쪽에 오는 것은 이 관례의 결과이며, 다른 관례를 쓰는 교재에서는 순서가 반대다.
참고: 최적화 방법 복습
경사하강법과 SGD
데이터 전체에 대한 (배치) 경사하강법은 다음과 같다.
\[\theta_{t+1} = \theta_t - \frac{\alpha}{\lvert \mathcal{D} \rvert} \sum_{(x_i, y_i) \in \mathcal{D}} \nabla_\theta L(x_i, y_i, \theta_t)\]매 반복마다 전체를 훑어야 하므로 큰 데이터셋에서는 느리다. 미니배치 SGD는 매 반복 무작위 부분집합 \(B_t \subseteq \mathcal{D}\)로 바꾼다.
\[\theta_{t+1} = \theta_t - \frac{\alpha}{\lvert B_t \rvert} \sum_{(x_i, y_i) \in B_t} \nabla_\theta L(x_i, y_i, \theta_t)\]그래디언트 추정은 잡음이 있지만 불편이다. 그래디언트의 분산을 감수하는 대신 데이터셋 크기와 무관한 빠른 반복을 얻으며, 반복 수가 늘어나도 대개 이득이 더 크다.
경사하강법이 잘 안 되는 경우
\(f(x_1, x_2) = a_1x_1^2 + a_2x_2^2\)를 보자. \(a_1\)과 \(a_2\)가 비슷하면(잘 조건화된, well-conditioned 문제) 그래디언트가 최적점 방향과 잘 맞고 큰 학습률로 빠르게 수렴한다. \(a_2 \gg a_1\)인 나쁜 조건(ill-conditioned)에서는 학습률이 크면 세로 방향으로 진동하다 발산하고, 작으면 안정적이지만 가로 방향 진행이 매우 느리다. 그래디언트 방향만 따라가는 한 이 딜레마를 피하기 어렵다.
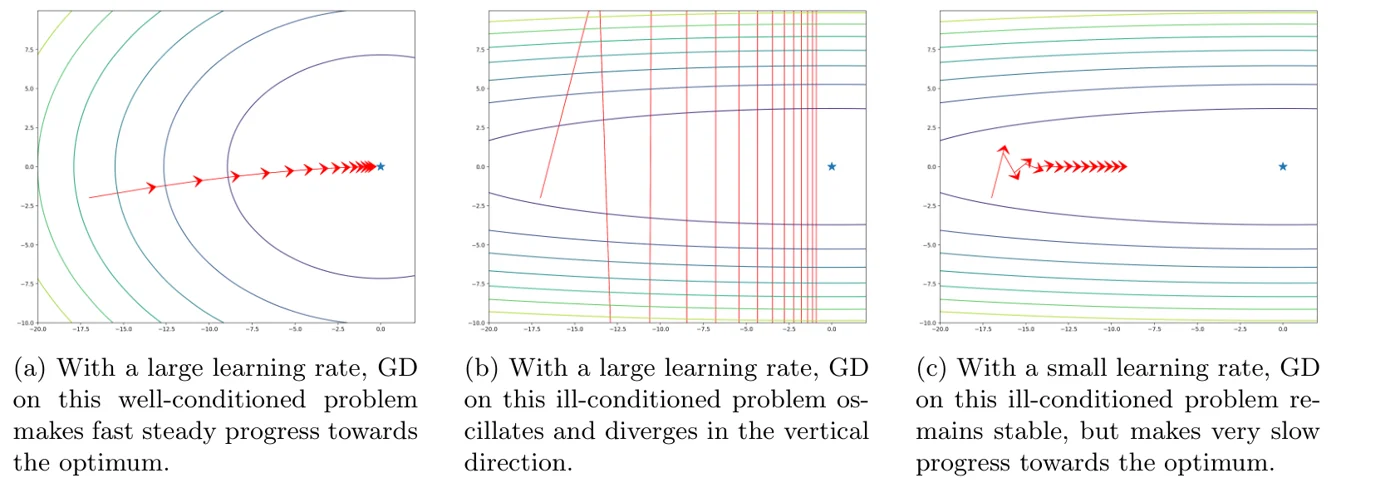 이차함수에서의 경사하강법 경로. (a) 잘 조건화된 문제에서 큰 학습률, (b) 나쁜 조건의 문제에서 큰 학습률, (c) 나쁜 조건의 문제에서 작은 학습률. 별표가 최적점이다. 출처: CS 182 Discussion 2.
(a)에서는 등고선이 원에 가까워 그래디언트가 별표를 거의 그대로 가리키므로, 큰 걸음으로 곧장 다가간다. (b)는 \(a_2 \gg a_1\)이라 등고선이 가로로 길쭉하고 세로 방향이 매우 가파르다. 같은 큰 학습률을 쓰면 세로 방향으로 최적점을 지나쳐 반대편으로 더 멀리 튀고, 이것이 반복되어 경로(빨간 세로선)가 위아래로 발산한다. (c)처럼 학습률을 줄이면 세로 진동은 금방 가라앉지만, 가로 방향 기울기가 작아서 정해진 반복 동안 별표까지 가지 못한다.
모멘텀
과거 그래디언트를 누적하면 일관되게 오른쪽을 가리키는 성분은 쌓이고, 번갈아 부호가 바뀌는 세로 성분은 상쇄된다(heavy-ball 방법). 확률적 환경에서는 표본 잡음도 줄여 준다.
\[v_t = m\,v_{t-1} + \nabla L(\theta_t), \qquad \theta_{t+1} = \theta_t - \alpha v_t\]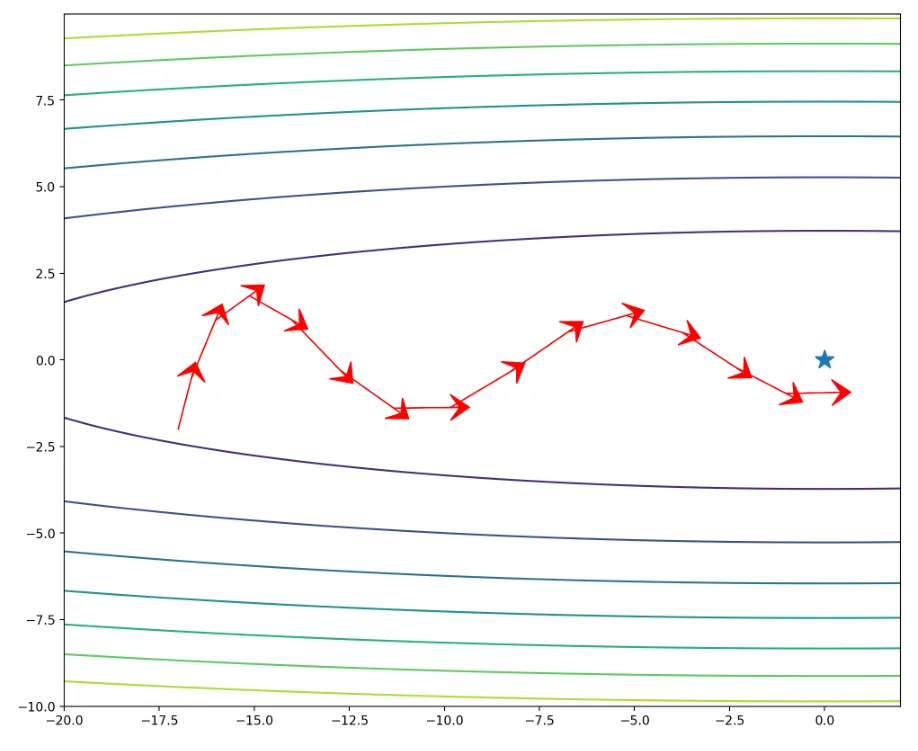 같은 나쁜 조건의 이차함수에서 모멘텀을 쓴 경로. 출처: CS 182 Discussion 2.
앞 그림의 (b), (c)와 비교하면 효과가 드러난다. 경로는 위아래로 출렁이지만 그 폭이 커지지 않고, 가로 방향으로는 걸음이 점점 길어져 별표 근처까지 빠르게 도달한다. 세로 성분은 부호가 번갈아 바뀌므로 \(v_t\)에 누적될 때 서로 상쇄되고, 가로 성분은 매번 같은 부호이므로 계속 쌓이기 때문이다. 큰 학습률과 작은 학습률 사이에서 하나를 골라야 했던 딜레마를 모멘텀이 상당 부분 해소한다.
RMSProp, AdaGrad, Adam
적응적 학습률 방법은 좌표마다 과거 그래디언트 크기 \(s^t\)를 추적해 갱신을 다시 조정한다. 민감한 세로 방향은 줄이고 둔한 가로 방향은 키우는 셈이다.
\[\theta_k^{t+1} = \theta_k^t - \frac{\alpha}{\sqrt{s_k^t + \epsilon}} \nabla_{\theta_k} L(\theta^t)\]RMSProp은 \(s_k^t = \beta s_k^{t-1} + (1 - \beta)(\nabla_{\theta_k} L(\theta^t))^2\)로 이동 평균을, AdaGrad는 \(s_k^t = s_k^{t-1} + (\nabla_{\theta_k} L(\theta^t))^2\)로 누적 합을 쓴다. AdaGrad의 \(s^t\)는 단조 증가하므로 유효 학습률이 단조 감소한다. Adam은 RMSProp의 적응적 학습률과 모멘텀을 결합한 방법이다.
정리
- 테스트 입력에서의 기대 제곱오차는 분산 + 편향의 제곱 + 줄일 수 없는 잡음 \(\sigma^2\)으로 분해된다.
- OLS는 불편이지만 예측 분산 \(x^T(X^TX)^{-1}x\)가 데이터 분산이 작은 방향에서 폭발한다. L2 정규화는 분산을 \(\frac{\sigma_i^2}{(\sigma_i^2 + \lambda)^2}\)로 억누르는 대신 편향 \(-\lambda(X^TX + \lambda I)^{-1}\theta\)를 도입한다.
- 그래디언트는 입력과 같은 모양으로, 야코비안은 \(\left(\frac{\partial f}{\partial x}\right)_{ij} = \frac{\partial f_j}{\partial x_i}\)로 두면 연쇄 법칙은 \(\frac{\partial z}{\partial x} = \frac{\partial y}{\partial x}\frac{\partial z}{\partial y}\)가 된다.
- \(\nabla_x\lVert A^Tx \rVert^2 = 2AA^Tx\), \(\nabla_A\lVert A^Tx \rVert^2 = 2xx^TA\)다. 행렬에 대한 미분은 펼쳐서 벡터처럼 계산한 뒤 모양을 되돌린 것과 같다.
- 나쁜 조건의 문제에서 경사하강법은 진동하거나 느리다. 모멘텀은 진동을 상쇄하고, RMSProp/AdaGrad는 좌표별로 크기를 조정하며, Adam은 둘을 결합한다.