- UC Berkeley CS 182 (Spring 2021) 5강 정리
- 강의: Sergey Levine
- 관련 Discussion: Discussion 3
신경망: 계산 그래프에서 다층 신경망으로
계산 그래프
계산 그래프(computation graph) 는 수식, 즉 프로그램을 노드와 화살표로 그린 것이다. 예를 들어 입력 \(x\)와 매개변수 \(\theta\)의 내적을 구하고, 정답 \(y\)와의 차를 제곱하는 그래프는 선형 회귀 모델의 MSE 손실 \(\frac{1}{2}(x^T\theta - y)^2\)을 계산한다. 곱셈과 덧셈 노드를 하나하나 그리는 대신 “내적” 노드 하나로 간단히 그릴 수도 있다.
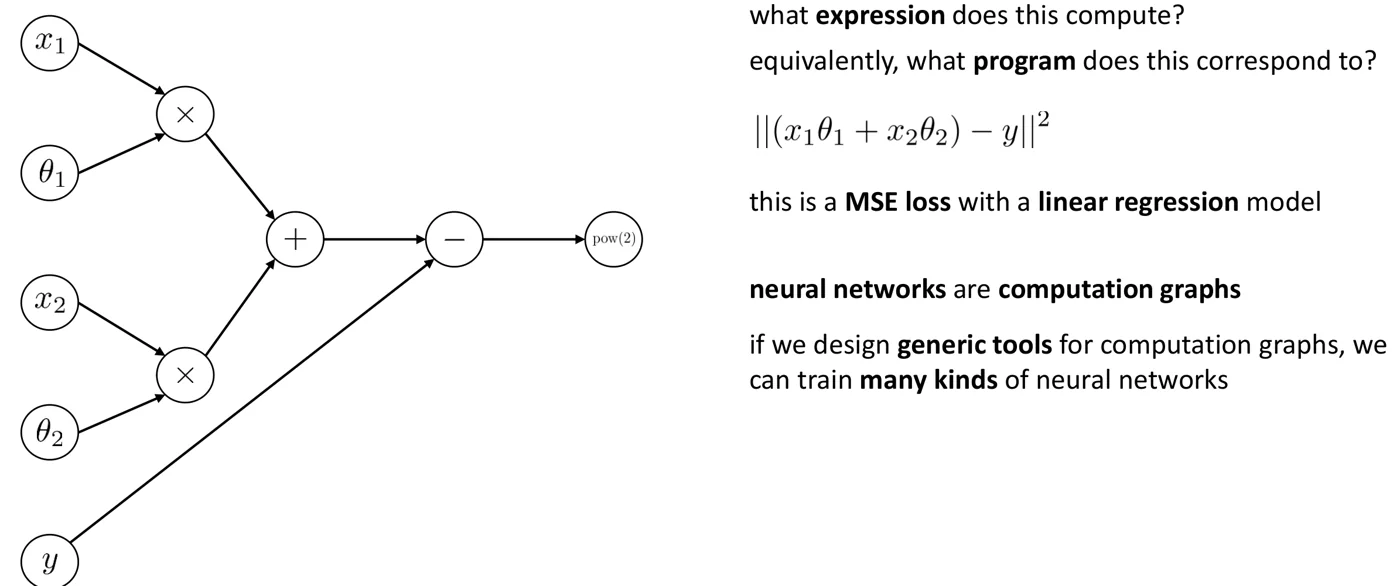 선형 회귀 + MSE 손실의 계산 그래프. 입력 \(x_1, x_2\)와 매개변수 \(\theta_1, \theta_2\)를 곱하고 더한 뒤 \(y\)를 빼고 제곱한다. 출처: CS 182 Lecture 5 slides.
그래프는 왼쪽에서 오른쪽으로 읽는다. 원 하나가 하나의 값 또는 연산이고, 화살표는 값이 어느 연산의 입력으로 들어가는지를 나타낸다. 두 개의 \(\times\) 노드가 \(x_1\theta_1\)과 \(x_2\theta_2\)를 만들고, \(+\) 노드가 이를 더해 예측 \(x^T\theta\)를 만든다. \(-\) 노드는 예측에서 정답 \(y\)를 빼고, 마지막 pow(2) 노드가 제곱해 \(\lVert (x_1\theta_1 + x_2\theta_2) - y \rVert^2\)을 내놓는다. 그래프의 각 노드는 자기 입력만 알면 계산할 수 있으므로, 노드마다 미분 규칙을 하나씩 정해 두면 그래프 전체의 미분도 기계적으로 구할 수 있다. 이것이 이 강의 후반의 역전파로 이어진다.
신경망은 계산 그래프다. 계산 그래프를 다루는 일반적인 도구를 만들면 여러 종류의 신경망을 같은 방식으로 학습할 수 있다.
로지스틱 회귀의 계산 그래프
음의 로그우도 손실을 쓰는 로지스틱 회귀를 그래프로 그리면 다음과 같다. 입력 \(x\)에 각 클래스의 매개변수 벡터를 곱해 점수를 만들고, 소프트맥스로 확률을 만들고, 정답에 해당하는 확률의 음의 로그를 취한다. 정답 \(y\)는 정답 클래스 자리만 1인 원-핫(one-hot) 벡터로 나타내면 편리하다. 그러면 손실은 \(-\sum_j y_j \log p_j\)로 쓸 수 있다.
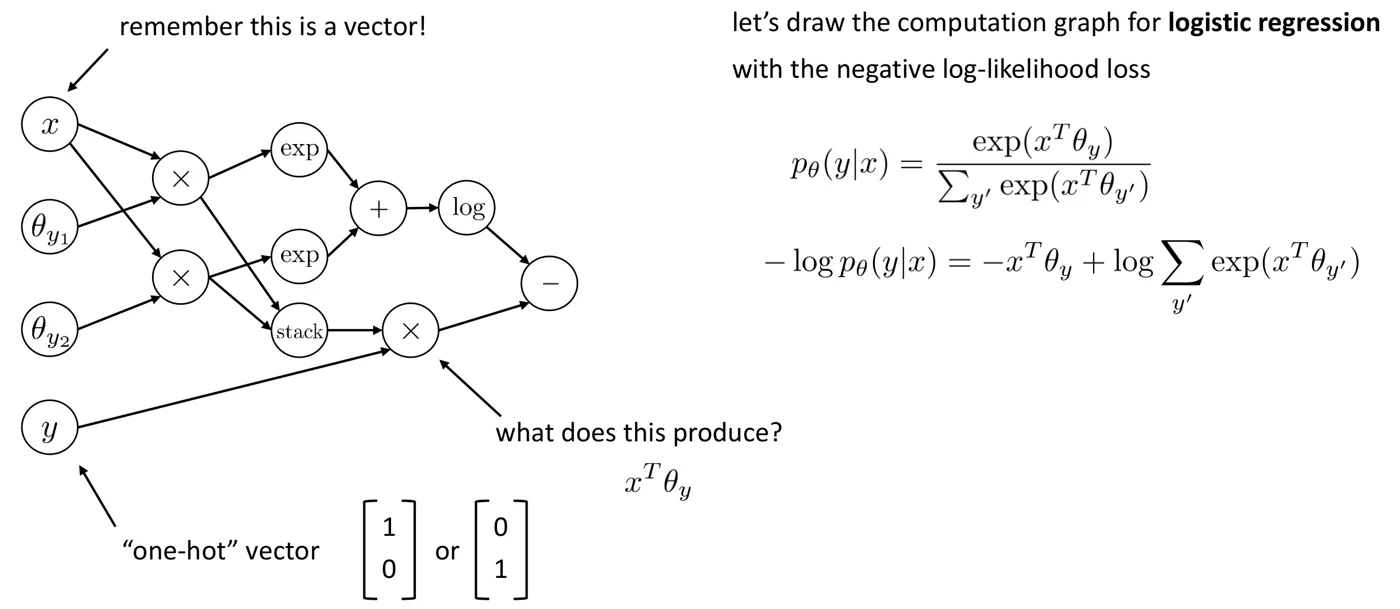 두 클래스 로지스틱 회귀의 음의 로그우도 손실을 계산 그래프로 그린 것. 정답 \(y\)는 원-핫 벡터로 들어간다. 출처: CS 182 Lecture 5 slides.
그래프의 위쪽 경로는 오른쪽 식의 둘째 항 \(\log \sum_{y'} \exp(x^T\theta_{y'})\)를 계산한다. 두 \(\times\) 노드가 클래스별 점수 \(x^T\theta_{y_1}\), \(x^T\theta_{y_2}\)를 만들고, 각각에 exp를 씌워 더한 뒤 log를 취한다. 아래쪽 경로는 첫째 항 \(x^T\theta_y\)를 계산한다. 두 점수를 stack 노드로 쌓아 벡터를 만들고, 원-핫 벡터 \(y\)와 곱하면 정답 클래스의 점수만 골라진다. 예를 들어 \(y = [0, 1]^T\)이면 둘째 점수만 남는다. 마지막 \(-\) 노드가 두 경로의 결과를 빼서 \(-\log p_\theta(y \mid x)\)를 만든다.
클래스별 매개변수 벡터를 행렬 \(W\)로 모으면 점수 계산은 행렬-벡터 곱 \(z = Wx\) 하나로 그려진다.
더 간결한 그림
계산 그래프에는 두 종류의 변수가 있다. 데이터에서 흘러오는 활성값과, 특정 연산 하나에만 관여하는 매개변수다(합성곱 신경망처럼 매개변수를 공유하는 경우도 있다). 매개변수는 해당 연산 안에 넣고 그리지 않아도 된다. 행렬을 곱하는 연산을 선형 층(linear layer) 또는 완전 연결 층(fully connected layer) 이라 한다.
신경망 다이어그램에서는 다음을 자주 생략한다.
- 교차 엔트로피 손실은 항상 소프트맥스 다음에 오므로 따로 그리지 않는다.
- 모든 층에 매개변수가 있으므로 매개변수도 그리지 않는다.
그래서 “2x1 입력 → 선형 층 → 2x1 → 소프트맥스”처럼 벡터 크기와 층 이름만 적는다.
특징을 학습하기
로지스틱 회귀에 특징 \(\phi(x)\)를 쓰면 \(p(y \mid x) = \operatorname{softmax}(W\phi(x))\)가 된다. 1강에서 말했듯 특징을 손으로 설계하는 것은 어렵다. 특징 자체를 학습할 수 없을까?
아이디어는 각 특징을 하나의 (이진) 로지스틱 회귀 출력으로 두는 것이다. 이제부터 매개변수를 \(w\)나 \(W\)로 쓰고, \(\theta\)는 모델의 매개변수 전체를 가리킨다. \(w_1^{(1)}\)은 1층의 1번 특징의 가중치다.
\[\phi_1(x) = \frac{1}{1 + \exp(-x^T w_1^{(1)})}, \qquad \phi(x) = \begin{bmatrix} \sigma(x^T w_1^{(1)}) \\ \sigma(x^T w_2^{(1)}) \\ \sigma(x^T w_3^{(1)}) \end{bmatrix} = \sigma(W^{(1)} x)\]\(w_j^{(1)}\)는 행렬 \(W^{(1)}\)의 행이다. 여기서 \(\sigma\)는 성분별(per-element) 시그모이드이며 소프트맥스와 다르다. 각 특징은 서로 독립이다.
층 쌓기
크기를 붙여 그리면 다음과 같다. 2x1 입력 \(x\)에 3x2 행렬 \(W^{(1)}\)을 곱해 3x1 \(z^{(1)}\)을 만들고, 시그모이드로 3x1 \(a^{(1)}\)을 만든다. 다시 2x3 행렬 \(W^{(2)}\)를 곱해 2x1 \(z^{(2)}\)를 만들고, 소프트맥스와 교차 엔트로피 손실을 적용한다.
\[z^{(1)} = W^{(1)} x, \quad a^{(1)} = \sigma(z^{(1)}), \quad z^{(2)} = W^{(2)} a^{(1)}, \quad \mathcal{L} = -\log \operatorname{softmax}(z^{(2)})_y\]선형 층과 시그모이드를 묶어 “시그모이드 층”이라 부르면 그림이 더 간단해진다. 이를 여러 번 반복하면(3x2, 3x3, 3x3, … 행렬) 깊은 신경망이 된다.
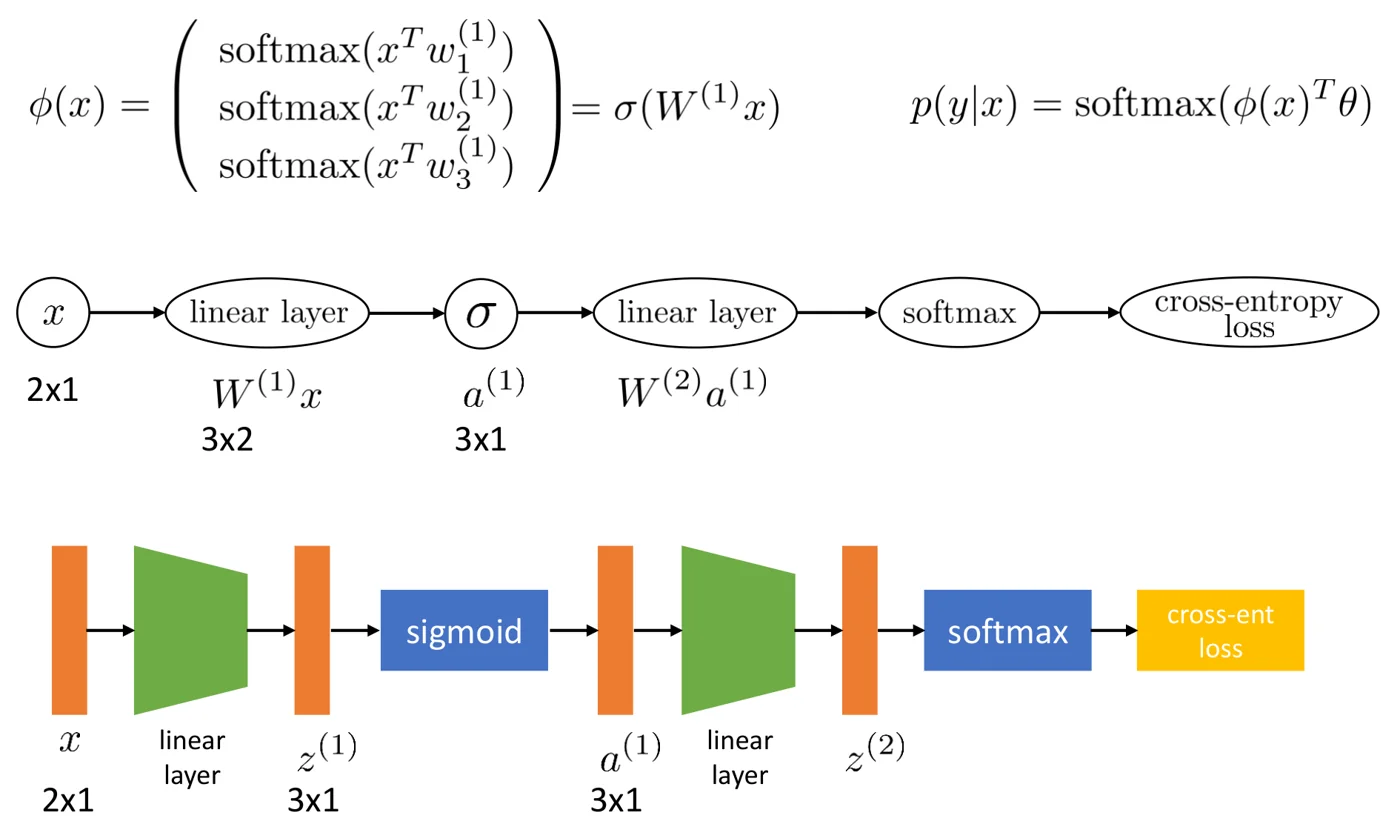 2층 신경망을 세 가지 방식으로 나타낸 것. 위는 수식, 가운데는 계산 그래프, 아래는 벡터(주황 막대)와 층(초록 사다리꼴, 파란 상자)으로 그린 블록 다이어그램이다. 슬라이드 수식의 softmax는 위 본문처럼 성분별 시그모이드 \(\sigma\)로 읽으면 된다. 출처: CS 182 Lecture 5 slides.
아래 블록 다이어그램이 이후 강의에서 계속 쓰이는 표기다. 주황 막대는 활성값 벡터이고 아래에 크기가 적혀 있다. 초록 사다리꼴은 선형 층으로, 입력 막대보다 출력 막대가 크거나 작을 수 있다는 것을 모양으로 나타낸다. 2x1 입력 \(x\)가 3x2 행렬을 거쳐 3x1 \(z^{(1)}\)이 되고, 시그모이드는 크기를 바꾸지 않으므로 \(a^{(1)}\)도 3x1이다. 다시 선형 층을 거쳐 2x1 \(z^{(2)}\)가 되고, 소프트맥스와 교차 엔트로피 손실로 끝난다. 각 층의 매개변수 \(W^{(1)}\), \(W^{(2)}\)는 그림에서 생략되어 있다.
활성화 함수
꼭 시그모이드를 쓸 필요는 없다. 다양한 비선형 함수가 작동하며, 이를 활성화 함수(activation function) 라 한다. 왜 비선형이어야 하는가? 선형 층을 여러 개 쌓아도 하나의 선형 층과 같기 때문이다(\(W^{(2)} W^{(1)} x = (W^{(2)} W^{(1)}) x\)). 비선형이기만 하면 층이 충분할 때 무엇이든 표현할 수 있다. 구체적인 선택은 이후 강의에서 다룬다.
TensorFlow Playground 데모로 층과 유닛 수를 바꾸며 결정 경계가 어떻게 변하는지 볼 수 있다.
무엇이 “신경”인가
인공 뉴런은 상류 유닛의 활성값을 가중합하고, 활성화 함수로 얼마나 발화할지 정하고, 그 활성값을 하류 유닛에 전달한다. 행렬 \(W\)의 한 행이 뉴런 하나의 입력 가중치에 해당한다. 이것이 생물학적 뉴런과의 느슨한 대응이다.
신경망 학습과 역전파
무엇이 필요한가
머신러닝의 일반적 방법을 다시 적으면 다음과 같다.
- 모델 집합: 위의 신경망.
- 손실 함수: 이전과 같은 음의 로그우도.
- 최적화기: 확률적 경사하강법.
- 큰 GPU에서 돌린다.
빠진 것은 하나다. 모든 매개변수에 대한 그래디언트 \(\frac{d\mathcal{L}}{dW^{(i)}}\)를 계산하는 방법이다.
연쇄 법칙과 표기 관례
\(x \xrightarrow{g} y \xrightarrow{f} z\)에서 연쇄 법칙(chain rule)은 다음과 같다.
\[\frac{d}{dx} f(g(x)) = \frac{dz}{dx} = \frac{dy}{dx} \frac{dz}{dy}\]\(x \in \mathbb{R}^n\), \(y \in \mathbb{R}^m\), \(z \in \mathbb{R}\)인 고차원에서는 \(y\)의 모든 차원에 대해 더한다.
\[\frac{dz}{dx_i} = \sum_{j=1}^{m} \frac{dy_j}{dx_i} \frac{dz}{dy_j} = \frac{dy}{dx_i} \frac{dz}{dy}\]이 강의의 관례는 다음과 같다. \(\frac{dz}{dy} \in \mathbb{R}^m\)은 열벡터이고, 야코비안(Jacobian) \(\frac{dy}{dx} \in \mathbb{R}^{n \times m}\)의 성분은 \(\left(\frac{dy}{dx}\right)_{ij} = \frac{dy_j}{dx_i}\)다. 그러면 \(\frac{dz}{dx} = \frac{dy}{dx}\frac{dz}{dy}\)에서 \(n \times m\) 행렬과 \(m \times 1\) 열벡터를 곱하게 된다. 어떤 교재는 반대로 그래디언트를 행벡터로 두고 \(\frac{dz}{dx} = \frac{dz}{dy}\frac{dy}{dx}\)로 쓴다. 두 가지는 그저 다른 관례일 뿐이다.
신경망에 적용하기
신경망은 함수의 합성일 뿐이므로 연쇄 법칙으로 그래디언트를 구할 수 있다. 2층 네트워크에서 1층 가중치의 그래디언트는 다음과 같다.
\[\frac{d\mathcal{L}}{dW^{(1)}} = \frac{dz^{(1)}}{dW^{(1)}} \frac{da^{(1)}}{dz^{(1)}} \frac{dz^{(2)}}{da^{(1)}} \frac{d\mathcal{L}}{dz^{(2)}}\]각 야코비안은 계산할 수 있다. 예를 들어 \(z^{(2)} = W^{(2)} a^{(1)}\)이면 \(\frac{dz^{(2)}}{da^{(1)}} = W^{(2)T}\)다.
순진한 계산이 나쁜 이유
각 \(z^{(i)}\)나 \(a^{(i)}\)가 약 \(n\)차원이면 각 야코비안은 \(n \times n\)이고, 행렬끼리의 곱은 \(O(n^3)\)이다. AlexNet에는 4096 유닛짜리 층이 있으므로 이 비용은 무시할 수 없다.
오른쪽부터 계산하기
핵심 관찰은 손실이 스칼라라는 것이다. 따라서 맨 오른쪽 \(\frac{d\mathcal{L}}{dz^{(2)}}\)은 항상 \(n \times 1\) 벡터다. 왼쪽부터 곱하면 행렬-행렬 곱(\(O(n^3)\))이 생기지만, 오른쪽부터 곱하면 매번 행렬-벡터 곱(\(O(n^2)\)) 만 하면 된다.
- \(\delta = \frac{dz^{(2)}}{da^{(1)}} \frac{d\mathcal{L}}{dz^{(2)}}\)를 먼저 계산한다. 비용은 \(O(n^2)\)다.
- \(\gamma = \frac{da^{(1)}}{dz^{(1)}} \delta\)를 계산한다. 역시 \(O(n^2)\)다.
- \(\frac{d\mathcal{L}}{dW^{(1)}} = \frac{dz^{(1)}}{dW^{(1)}} \gamma\)를 계산한다.
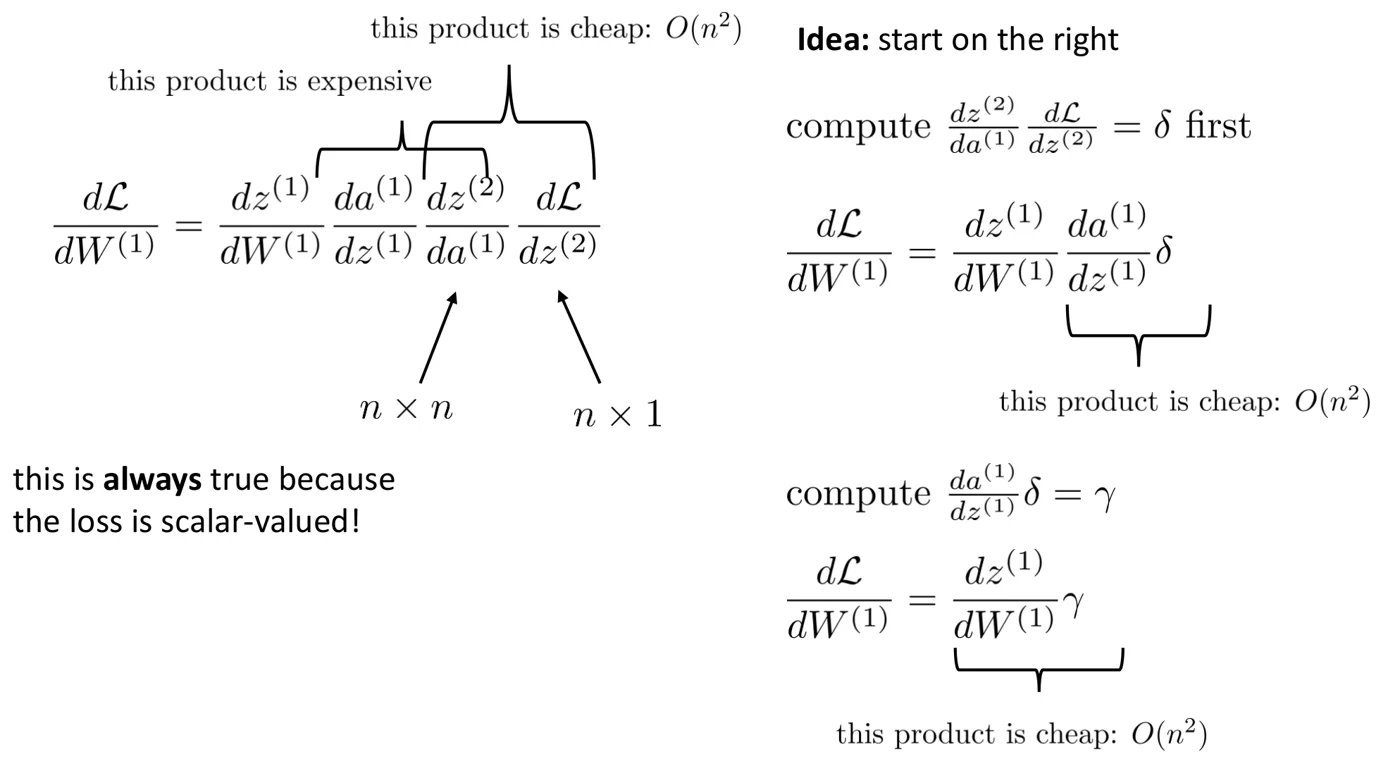 연쇄 법칙의 곱을 어느 쪽부터 계산하느냐에 따른 비용 차이. 왼쪽부터 곱하면 \(n \times n\) 행렬끼리의 곱(비쌈)이 생기고, 오른쪽부터 곱하면 매번 행렬과 벡터의 곱(\(O(n^2)\))만 생긴다. 출처: CS 182 Lecture 5 slides.
왼쪽 식의 위에 그려진 괄호가 두 가지 계산 순서를 나타낸다. 가운데 두 야코비안 \(\frac{da^{(1)}}{dz^{(1)}}\frac{dz^{(2)}}{da^{(1)}}\)을 먼저 곱하면 \(n \times n\) 행렬끼리의 곱이므로 \(O(n^3)\)이다. 반면 맨 오른쪽 \(\frac{d\mathcal{L}}{dz^{(2)}}\)은 손실이 스칼라라서 항상 \(n \times 1\) 벡터이고, 여기에 바로 왼쪽 야코비안을 곱하면 결과도 \(n \times 1\) 벡터 \(\delta\)다. 오른쪽의 계산 순서처럼 이 벡터에 다음 야코비안을 곱해 \(\gamma\)를 얻고, 다시 다음 야코비안을 곱하는 식으로 진행하면, 모든 단계가 \(O(n^2)\) 행렬-벡터 곱이 된다. 층이 \(L\)개면 전체 비용은 \(O(Ln^2)\)이다.
역전파 알고리즘
이 아이디어를 일반화한 것이 역전파(backpropagation) 다. 네트워크를 함수 \(f\)들의 사슬로 보고, 각 함수는 입력 \(x_f\)와 매개변수 \(\theta_f\)를 가진다.
- 순전파(forward pass): 앞에서부터 각 \(a^{(i)}\)와 \(z^{(i)}\)를 계산해 저장한다.
- 역전파(backward pass):
- \(\delta = \frac{d\mathcal{L}}{dz^{(n)}}\)으로 초기화한다.
- 끝에서부터 처음까지 각 함수 \(f\)에 대해 다음을 한다.
첫 줄은 그 층의 매개변수 그래디언트를 얻고, 둘째 줄은 \(\delta\)를 한 층 앞으로 전달한다. 매 단계는 야코비안과 벡터의 곱이다.
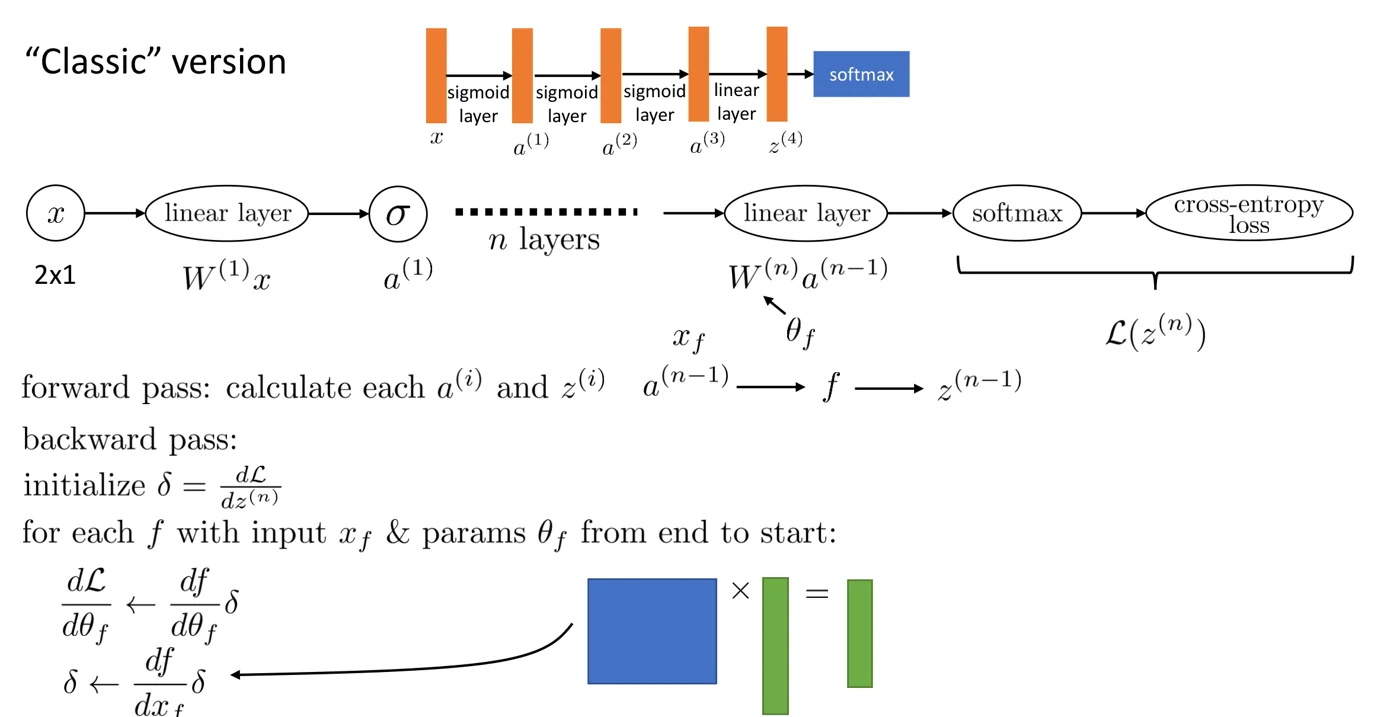 역전파 알고리즘. 위는 여러 층으로 이루어진 “고전적” 신경망, 아래는 순전파와 역전파의 절차다. 오른쪽 아래 그림처럼 매 단계는 야코비안(파란 행렬)과 벡터 \(\delta\)(초록 막대)의 곱이다. 출처: CS 182 Lecture 5 slides.
그림의 가운데 부분은 함수 \(f\) 하나를 확대한 것이다. \(f\)는 앞 층의 활성값 \(a^{(n-1)}\)을 입력 \(x_f\)로, 가중치 \(W^{(n)}\)을 매개변수 \(\theta_f\)로 받아 다음 값을 낸다. 순전파에서는 모든 층의 \(a^{(i)}\)와 \(z^{(i)}\)를 차례로 계산해 저장해 둔다. 역전파는 손실 쪽 끝에서 \(\delta = \frac{d\mathcal{L}}{dz^{(n)}}\)을 만들고, 층을 하나씩 거꾸로 지나가며 두 가지 일을 한다. 매개변수 그래디언트 \(\frac{df}{d\theta_f}\delta\)를 기록하고, \(\delta\)를 \(\frac{df}{dx_f}\delta\)로 바꿔 한 층 앞으로 넘긴다. 순전파에서 저장한 값이 필요한 이유는, 야코비안 \(\frac{df}{d\theta_f}\)와 \(\frac{df}{dx_f}\)가 그 층의 입력값에 의존하기 때문이다.
실제 구현: 층별 역전파 공식
구조 설계
신경망을 실제로 만들려면 층의 개수, 각 층의 크기, 활성화 함수의 종류를 정해야 한다. 이는 이후 강의에서 계속 다룬다.
편향 항
선형 층 \(z^{(i+1)} = W^{(i)} a^{(i)}\)에는 문제가 있다. \(a^{(i)} = \vec{0}\)이면 출력이 항상 0이다. 그래서 편향(bias) 을 더한다.
\[z^{(i+1)} = W^{(i)} a^{(i)} + b^{(i)}\]각 선형 층에 매개변수 \(b^{(i)}\)가 추가된다. 이 “편향”은 편향-분산 트레이드오프의 편향과는 아무 관계가 없다.
각 층에 필요한 것
역전파를 하려면 각 함수에 대해 두 가지만 구하면 된다.
\[\frac{df}{d\theta_f}\delta \qquad \text{and} \qquad \frac{df}{dx_f}\delta\]야코비안 전체를 만들 필요는 없고, 야코비안과 \(\delta\)의 곱만 있으면 된다. 아래에서 자주 쓰는 층의 공식을 정리한다.
선형 층
표기를 단순하게 하려고 \(z = Wa + b\)로 쓰고, \(\delta = \frac{d\mathcal{L}}{dz}\)라 하자. \(z_i = \sum_k W_{ik} a_k + b_i\)이므로 \(\frac{dz_i}{da_k} = W_{ik}\)이고, 관례상 \(\frac{dz}{da} = W^T\)다.
\[\frac{dz}{da}\delta = W^T\delta, \qquad \frac{dz}{dW}\delta = \delta a^T, \qquad \frac{dz}{db}\delta = \delta\]첫째가 \(\frac{df}{dx_f}\delta\), 나머지 둘이 \(\frac{df}{d\theta_f}\delta\)다. \(W\)에 대한 식은 \(\frac{d\mathcal{L}}{dW_{ij}} = \frac{d\mathcal{L}}{dz_i} a_j\)에서 나오며, 외적 형태가 된다.
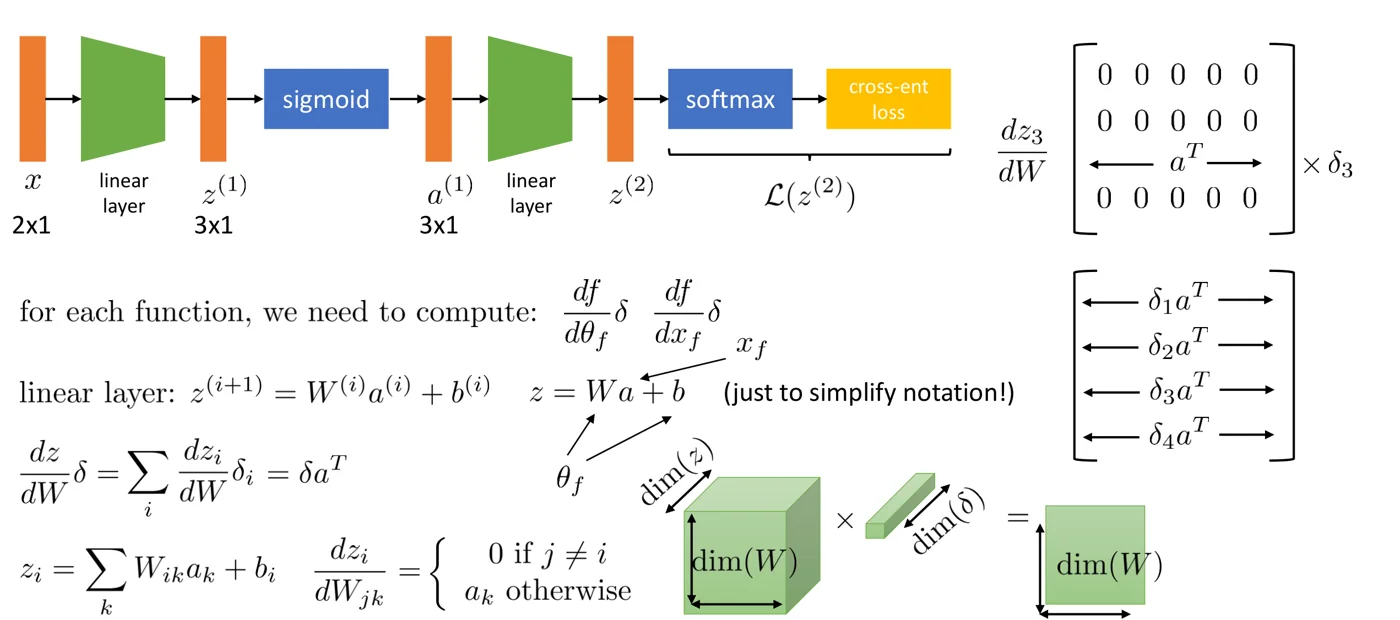 선형 층의 역전파 공식. 오른쪽 위는 \(z_3\)의 \(W\)에 대한 미분이 셋째 행에만 \(a^T\)가 있는 행렬이라는 것을, 오른쪽 아래는 이를 \(\delta_i\)로 가중합한 결과가 행마다 \(\delta_i a^T\)인 행렬, 즉 \(\delta a^T\)라는 것을 보여 준다. 출처: CS 182 Lecture 5 slides.
\(\frac{dz}{dW}\)는 원래 \(z\)의 각 성분을 \(W\)의 각 성분으로 미분한 3차원 배열이다. 아래 녹색 상자 그림처럼 크기가 \(\dim(z) \times \dim(W)\)이고, 여기에 길이 \(\dim(z)\)인 \(\delta\)를 곱해 \(W\)와 같은 크기의 행렬을 얻는다. 이 배열을 실제로 만들 필요는 없다. \(z_i = \sum_k W_{ik} a_k + b_i\)에서 \(z_i\)는 \(W\)의 \(i\)번째 행에만 의존하므로, \(\frac{dz_i}{dW}\)는 \(i\)번째 행이 \(a^T\)이고 나머지는 0인 행렬이다(오른쪽 위, \(i = 3\)인 경우). 이를 \(\delta_i\)로 가중해 모두 더하면 \(i\)번째 행이 \(\delta_i a^T\)인 행렬, 곧 외적 \(\delta a^T\)가 된다.
시그모이드
시그모이드는 성분별 함수이므로 야코비안이 대각행렬이다. 미분은 다음과 같다.
\[\sigma(z_i) = \frac{1}{1 + \exp(-z_i)}, \qquad \frac{d\sigma(z_i)}{dz_i} = \frac{\exp(-z_i)}{1 + \exp(-z_i)} \cdot \frac{1}{1 + \exp(-z_i)} = (1 - \sigma(z_i))\,\sigma(z_i)\]첫 인수가 \(1 - \sigma(z_i)\)인 이유는 \(\frac{\exp(-z_i)}{1 + \exp(-z_i)} = \frac{1 + \exp(-z_i)}{1 + \exp(-z_i)} - \frac{1}{1 + \exp(-z_i)}\)이기 때문이다. 대각 야코비안과 벡터의 곱은 성분별 곱이 된다.
\[\left( \frac{df}{dz}\delta \right)_i = (1 - \sigma(z_i))\,\sigma(z_i)\,\delta_i\]ReLU
ReLU 는 \(f_i(z_i) = \max(0, z_i)\)다. 미분은 지시함수다.
\[\frac{df_i}{dz_i} = \operatorname{Ind}(z_i \geq 0), \qquad \left( \frac{df}{dz}\delta \right)_i = \operatorname{Ind}(z_i \geq 0)\,\delta_i\]양수 쪽에서는 그래디언트를 그대로 통과시키고, 음수 쪽에서는 막는다.
소프트맥스와 교차 엔트로피
역전파의 시작점 \(\delta = \frac{d\mathcal{L}}{dz^{(n)}}\)은 소프트맥스와 교차 엔트로피를 묶어 계산한다. \(p = \operatorname{softmax}(z)\), \(\mathcal{L} = -\log p_y\)이면 \(\log p_y = z_y - \log \sum_j \exp(z_j)\)이므로 다음과 같다.
\[\frac{d\mathcal{L}}{dz_i} = p_i - \operatorname{Ind}(i = y), \qquad \delta = p - e_y\]여기서 \(e_y\)는 정답 원-핫 벡터다. 예측 확률에서 정답을 뺀 간단한 형태다.
요약
순전파로 각 \(a^{(i)}\)와 \(z^{(i)}\)를 계산한 뒤, \(\delta = \frac{d\mathcal{L}}{dz^{(n)}}\)에서 출발해 끝에서부터 각 층의 \(\frac{df}{d\theta_f}\delta\)와 \(\frac{df}{dx_f}\delta\)를 차례로 계산한다. 선형 층, 소프트맥스 + 교차 엔트로피, 시그모이드, ReLU의 공식만 있으면 위의 네트워크 전체를 학습할 수 있다.
정리
- 신경망은 계산 그래프이며, 선형 층과 비선형 활성화 함수를 번갈아 쌓은 것이다. 각 특징을 로지스틱 회귀 출력으로 학습한다고 보면 \(\sigma(W^{(1)}x)\) 형태의 은닉층이 나온다.
- 활성화 함수는 비선형이어야 한다. 선형 층만 쌓으면 하나의 선형 층과 같다.
- 연쇄 법칙으로 그래디언트를 구할 수 있지만, 야코비안을 왼쪽부터 곱하면 \(O(n^3)\)이다. 손실이 스칼라이므로 오른쪽부터 곱하면 행렬-벡터 곱 \(O(n^2)\)로 충분하다. 이것이 역전파다.
- 역전파는 \(\delta = \frac{d\mathcal{L}}{dz^{(n)}}\)에서 시작해 \(\frac{d\mathcal{L}}{d\theta_f} \leftarrow \frac{df}{d\theta_f}\delta\), \(\delta \leftarrow \frac{df}{dx_f}\delta\)를 끝에서부터 반복한다.
- 선형 층 \(z = Wa + b\): \(W^T\delta\), \(\delta a^T\), \(\delta\). 시그모이드: \(\sigma(1-\sigma)\delta\) 성분별. ReLU: \(\operatorname{Ind}(z \geq 0)\delta\) 성분별. 소프트맥스 + 교차 엔트로피: \(p - e_y\).
- 선형 층에는 편향 \(b\)를 더해, 입력이 0이어도 출력이 0으로 고정되지 않게 한다.