- UC Berkeley CS 182 (Spring 2021) Discussion 10 정리
- 관련 강의: Deep Learning 17, Deep Learning 18
이번 Discussion은 자기회귀 모델, 오토인코더, 잠재변수 모델을 다룬다. 생성 모델은 데이터셋의 분포를 표현해 새 샘플을 만드는 것이 목표이며, 레이블 없는 데이터로도 학습할 수 있다.
자기회귀 생성 모델(autoregressive generative model). \(x\)를 차원 \(x_1, \dots, x_n\)으로 나누고 각 값을 \(k\)개로 이산화한 뒤 연쇄 법칙으로 분포를 분해한다. \(n \times n\) 이미지의 픽셀을 어떤 순서로 나열하면 다음과 같다.
\[p_\theta(x_1, \dots, x_{n^2}) = \prod_{i=1}^{n^2} p_\theta(x_i \mid x_1, \dots, x_{i-1})\]각 조건부 분포를 신경망 \(f_\theta\)로 모델링한다. 구현으로는 PixelCNN, PixelRNN, Pixel Transformer가 있다. PixelCNN은 이전 픽셀들의 문맥 영역에 마스크된 합성곱을 적용하고, PixelRNN은 행 단위 LSTM으로 먼 픽셀의 정보를 기억한다. Pixel Transformer는 다중 헤드 주의를 쓴다.
1. PixelCNN과 PixelRNN
문제
PixelCNN과 PixelRNN의 주된 차이를 학습 시간의 실행 속도, 테스트 시간의 실행 속도, 픽셀 생성 방식 측면에서 설명하라.
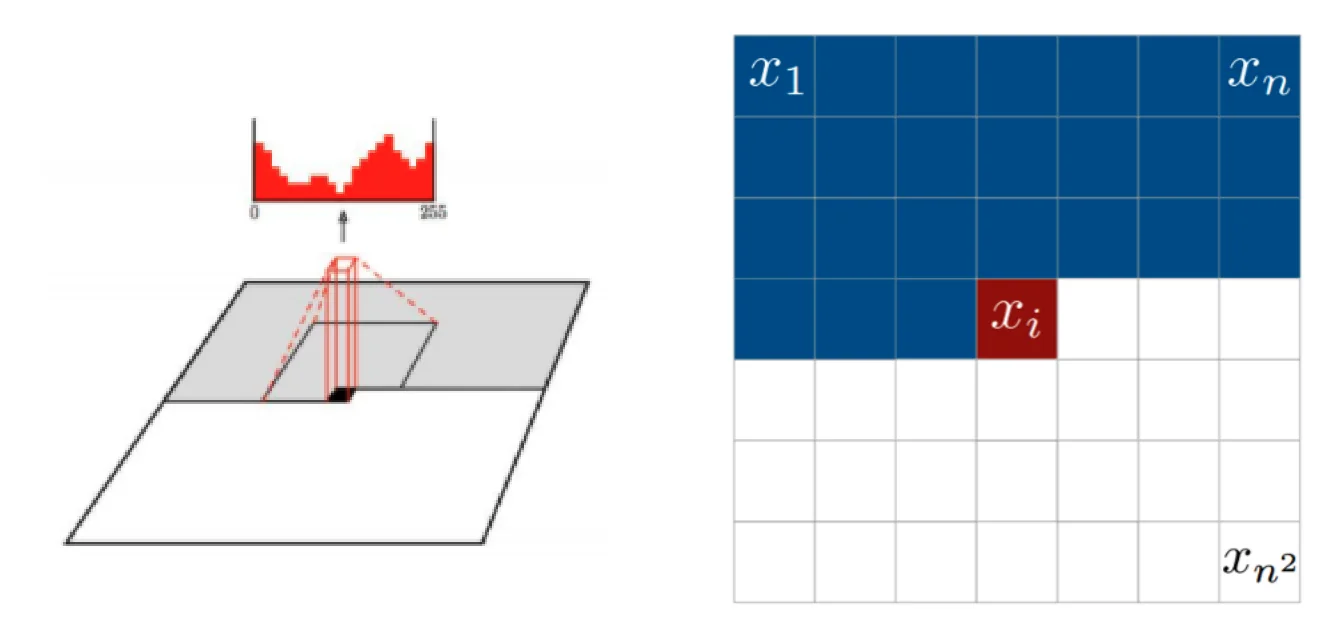 왼쪽은 PixelCNN이 한 픽셀(검은 점)의 값 분포(위의 256개 값 히스토그램)를 그 위쪽과 왼쪽의 제한된 문맥 영역(회색, 빨간 점선)에서 합성곱으로 계산하는 모습이다. 오른쪽은 픽셀 \(x_i\)가 이전의 모든 픽셀(파랑)에 의존하고 이후의 픽셀(흰색)과는 무관한 자기회귀 순서를 보여 준다. 출처: CS 182 Discussion 10.
두 그림은 같은 조건부 분포 \(p(x_i \mid x_{1:i-1})\)를 서로 다른 방식으로 계산한다. 오른쪽 그림의 파란 영역 전체가 조건이 되는 것은 두 모델 모두 같다. PixelRNN은 행 단위 순환 상태가 위쪽 행들의 정보를 계속 전달하므로 파란 영역 전체를 직접 요약할 수 있지만, 순환 상태를 차례로 계산해야 한다. PixelCNN은 왼쪽 그림처럼 국소 문맥 창만 보는 마스크 합성곱을 쓰고, 층을 쌓아 수용 영역을 넓힌다. 학습 때는 모든 픽셀 값이 주어지므로 이 합성곱을 모든 위치에 동시에 적용할 수 있다는 점이 아래 풀이의 속도 차이로 이어진다.
풀이
- 학습 시간: PixelCNN이 더 빠르다. 학습 때는 이미지 전체가 이미 주어져 있으므로, 마스크 합성곱으로 모든 픽셀의 조건부 분포를 한 번의 순전파로 병렬 계산할 수 있다. 마스크는 생성 순서상 같은 위치나 그 뒤의 픽셀을 보지 못하게 막는다. PixelRNN은 순환 상태를 행마다 차례로 계산해야 하므로 느리다.
- 테스트 시간: PixelRNN이 더 빠르다. PixelCNN은 네트워크를 한 번 통과할 때마다 픽셀 하나만 생성하지만, PixelRNN은 한 번에 한 행 전체를 생성한다.
- 픽셀 생성: PixelCNN은 근방 픽셀의 문맥 영역에 마스크 합성곱을 적용해 다음 픽셀을 만든다. PixelRNN은 이전 행의 픽셀을 이용해 Row LSTM으로 한 행씩 순환적으로 생성한다. Diagonal BiLSTM을 쓸 수도 있다.
2. VAE의 흐릿한 이미지
문제
오토인코더(autoencoder) 는 입력을 은닉 상태 \(z\)로 부호화하고 다시 복원하도록 학습한다. 구조적 표현을 강제하는 방법으로는 차원 축소(bottleneck), 희소성(sparsity, 예: \(\sum_j \lvert h_j \rvert\) 벌점), 잡음 제거(denoising), 확률적 모델링이 있다. 확률적 모델링을 쓰는 VAE는 인코더 \(q_\phi(z \mid x)\)가 가우시안의 평균과 공분산 \(\mu_{z \mid x}, \Sigma_{z \mid x}\)를 출력하고, 디코더 \(p_\theta(x \mid z)\)가 데이터 분포의 파라미터를 출력한다. 예를 들어 28x28 흑백 숫자 이미지라면 디코더는 784개 픽셀 각각의 베르누이 파라미터를 출력한다. 학습은 다음 ELBO를 최대화한다.
\[\mathcal{L}_i = E_{z \sim q_\phi(z \mid x_i)}[\log p_\theta(x_i \mid z)] - D_{\mathrm{KL}}(q_\phi(z \mid x_i) \lVert p(z))\]VAE가 대개 흐릿한 이미지를 만드는 이유는 무엇인가?
풀이
VAE는 데이터를 다변량 가우시안에 맞추는 명시적 분포를 학습한다. 디코더는 잠재변수가 주어지면 픽셀들이 서로 조건부 독립이라고 가정하는데, 자연 이미지 같은 현실의 분포에서는 이 가정이 성립하지 않는다. 또 실제 사후분포는 다변량 가우시안과 거리가 먼 경우가 많아, 모델에 많은 분산과 잡음이 더해진다. 최대우도 학습은 데이터를 놓치지 않으려고 확률 질량을 데이터 공간 전체에 넓게 퍼뜨리므로, 디코딩한 결과는 여러 가능성의 평균처럼 흐릿해진다.
3. 잠재변수 모델의 로그우도
문제
이산 잠재변수 모델의 로그우도 목적함수를 써라.
풀이
잠재변수 \(z\)를 주변화하면 된다.
\[\arg\max_\theta \sum_{i=1}^{N} \log p_\theta(x_i) = \arg\max_\theta \sum_{i=1}^{N} \log \left( \sum_z p_Z(z)\, p_\theta(x_i \mid z) \right)\]연속 잠재변수라면 합이 적분 \(\int p_\theta(x_i \mid z) p(z) dz\)로 바뀌며, 일반적으로 계산하기 어렵다.
4. 변분 근사
문제
Jensen 부등식 \(\log E[X] \ge E[\log X]\)를 이용해 다음을 보여라.
\[\sum_{i=1}^{N} \log p_\theta(x_i) \ge \sum_{i=1}^{N} E_{q(z \mid x_i)}[\log p_Z(z) - \log q(z \mid x_i) + \log p_\theta(x_i \mid z)]\]풀이
합 안에 \(q(z \mid x_i) / q(z \mid x_i) = 1\)을 곱해 기댓값 형태로 만든다.
\[\begin{aligned} \sum_{i=1}^{N} \log p_\theta(x_i) &= \sum_{i=1}^{N} \log \left( \sum_z q(z \mid x_i) \frac{p_Z(z)\, p_\theta(x_i \mid z)}{q(z \mid x_i)} \right) \\ &= \sum_{i=1}^{N} \log E_{q(z \mid x_i)}\left[ \frac{p_Z(z)\, p_\theta(x_i \mid z)}{q(z \mid x_i)} \right] \\ &\ge \sum_{i=1}^{N} E_{q(z \mid x_i)}[\log p_Z(z) - \log q(z \mid x_i) + \log p_\theta(x_i \mid z)] \end{aligned}\]마지막 줄에서 Jensen 부등식을 썼다. \(\log\)는 오목 함수이므로 기댓값의 로그는 로그의 기댓값보다 크거나 같다.
5. 변분 하한의 최적화
문제
앞에서 유도한 변분 하한을 최적화할 때, \(z\)는 어느 분포에서 샘플링하는가?
풀이
하한은 \(q(z \mid x_i)\)에 대한 기댓값이므로 \(z \sim q(z \mid x_i)\)로 샘플링한다.
엔트로피 \(\mathcal{H}(p) = -E[\log p(x)]\)와 KL 발산 \(D_{\mathrm{KL}}(q \lVert p) = E_q[\log q(x) - \log p(x)] = -E_q[\log p(x)] - \mathcal{H}(q)\)를 쓰면, 문제 4의 하한은 \(E_{q}[\log p_\theta(x_i \mid z)] + E_q[\log p_Z(z)] + \mathcal{H}(q)\)이고, 뒤의 두 항이 \(-D_{\mathrm{KL}}(q(z \mid x_i) \lVert p(z))\)이므로 ELBO 형태가 된다.
\[\mathcal{L}_i = E_{z \sim q_\phi(z \mid x_i)}[\log p_\theta(x_i \mid z)] - D_{\mathrm{KL}}(q_\phi(z \mid x_i) \lVert p(z))\]6. 재매개변수화 예제
문제
재매개변수화 기법(reparameterization trick) 은 \(q_\phi(z \mid x)\)를 결정적 부분과 확률적 부분으로 나누어 \(z = g_\phi(x, \epsilon) = g_0(x) + \epsilon \cdot g_1(x)\), \(\epsilon \sim p(\epsilon)\)으로 쓴다. 구현이 간단하고 분산이 작다.
\(q_\theta(x) = \mathcal{N}(\theta, 1)\)일 때 \(\min_\theta E_q[x^2]\)를 풀고자 한다. \(x\)를 재매개변수화해 기울기를 유도하라.
풀이
\(q\)의 무작위성을 \(\theta\)와 무관한 잡음으로 옮긴다.
\[x = \theta + \epsilon, \quad \epsilon \sim \mathcal{N}(0, 1)\]그러면 기댓값은 \(\theta\)에 의존하지 않는 분포 \(p = \mathcal{N}(0, 1)\)에 대한 것이 되어, 기울기를 기댓값 안으로 넣을 수 있다.
\[\nabla_\theta E_q[x^2] = \nabla_\theta E_{\epsilon \sim p}[(\theta + \epsilon)^2] = E_{\epsilon \sim p}[2(\theta + \epsilon)]\]\(E[\epsilon] = 0\)이므로 이 값은 \(2\theta\)다. 실제로 \(E_q[x^2] = \theta^2 + 1\)이므로 정확한 기울기와 일치하고, 최솟값은 \(\theta = 0\)에서 얻는다. 실전에서는 \(\epsilon\)을 몇 개 샘플링해 \(2(\theta + \epsilon)\)의 평균으로 추정한다.
7. Flow의 목적함수
문제
Normalizing flow는 쉬운 분포에서 복잡한 분포로 가는 가역 사상 \(f_\theta : \mathbb{R}^n \to \mathbb{R}^n\)을 학습한다. \(x = f_\theta(z)\), \(z = f_\theta^{-1}(x)\)일 때 학습 목적함수를 명시적으로 쓰고, 변수 변환으로 flow의 목적함수를 유도하라. 또 실용적인 flow를 위해 \(f_\theta\)가 만족해야 할 성질을 말하라.
풀이
목적함수는 로그우도 최대화다.
\[\max_\theta \frac{1}{N} \sum_{i=1}^{N} \log p(x_i)\]\(x\)에서 \(z\)로의 변수 변환 공식은 다음과 같다.
\[p(x) = p(z) \left\lvert \det \frac{df(z)}{dz} \right\rvert^{-1}\]\(z_i = f_\theta^{-1}(x_i)\)를 대입하고 로그의 성질로 나누면
\[\max_\theta \frac{1}{N} \sum_{i=1}^{N} \left[ \log p(f_\theta^{-1}(x_i)) - \log \left\lvert \det \frac{df(z_i)}{dz_i} \right\rvert \right]\]를 얻는다. 첫 항은 역사상으로 얻은 \(z_i\)가 사전분포(예: \(\mathcal{N}(0, I)\))에서 그럴듯해야 한다는 뜻이고, 둘째 항은 부피 변화에 대한 보정이다.
따라서 \(f_\theta\)는 (1) 미분 가능하고, (2) 가역이며, (3) 야코비안 행렬식을 쉽게 계산할 수 있어야 한다. 가역 변환은 합성해도 가역이므로 여러 층을 쌓아 복잡한 변환을 만든다.
8. Real-NVP의 야코비안 행렬식
문제
NICE의 덧셈 결합 층(additive coupling layer)은 \(z\)를 \(z_{1:d}\)와 \(z_{d+1:n}\)으로 나누어
\[x_{1:d} = z_{1:d}, \quad x_{d+1:n} = z_{d+1:n} + g_\theta(z_{1:d})\]로 변환한다. 역변환은 \(z_{1:d} = x_{1:d}\), \(z_{d+1:n} = x_{d+1:n} - g_\theta(z_{1:d})\)다. 야코비안은 대각 성분이 모두 1인 하삼각 행렬이라 행렬식이 1이고, 부피를 보존한다. Real-NVP는 스케일을 추가한다.
\[x_{d+1:n} = \exp(h_\theta(z_{1:d})) \odot z_{d+1:n} + g_\theta(z_{1:d})\](워크시트는 스케일 신경망과 이동 신경망을 모두 \(h_\theta\)로 표기하지만, 이동 항이 무엇이든 행렬식에는 영향이 없다.) 순방향 사상의 야코비안 행렬식 \(\lvert \det(df(z)/dz) \rvert\)를 구하라.
풀이
야코비안을 블록으로 나눈다.
\[\frac{df(z)}{dz} = \begin{bmatrix} \frac{dx_{1:d}}{dz_{1:d}} & \frac{dx_{1:d}}{dz_{d+1:n}} \\ \frac{dx_{d+1:n}}{dz_{1:d}} & \frac{dx_{d+1:n}}{dz_{d+1:n}} \end{bmatrix}\]- \(x_{1:d} = z_{1:d}\)이므로 \(dx_{1:d}/dz_{1:d} = I\)다.
- \(x_{1:d}\)는 \(z_{d+1:n}\)에 의존하지 않으므로 \(dx_{1:d}/dz_{d+1:n} = 0\)이다.
- 이동 항 \(g_\theta(z_{1:d})\)는 \(z_{d+1:n}\)과 무관하고, 원소별 곱은 대각행렬 곱으로 쓸 수 있으므로 \(dx_{d+1:n}/dz_{d+1:n} = \mathrm{diag}(\exp(h_\theta(z_{1:d})))\)다.
따라서
\[\frac{df(z)}{dz} = \begin{bmatrix} I & 0 \\ \frac{dx_{d+1:n}}{dz_{1:d}} & \mathrm{diag}(\exp(h_\theta(z_{1:d}))) \end{bmatrix}\]는 블록 하삼각 행렬이고, 행렬식은 대각 성분의 곱이다. 왼쪽 아래 블록은 아무리 복잡해도 행렬식에 영향을 주지 않는다.
\[\left\lvert \det \frac{df(z)}{dz} \right\rvert = \prod_{i=d+1}^{n} \exp(h_\theta(z_{1:d})_i), \quad \log \left\lvert \det \frac{df(z)}{dz} \right\rvert = \sum_{i=d+1}^{n} h_\theta(z_{1:d})_i\]로그 행렬식이 신경망 출력의 단순한 합이므로 계산이 매우 싸다. \(h_\theta\)가 0이 아니면 부피가 변하므로 “non-volume preserving”이라 부른다.
정리
- PixelCNN은 마스크 합성곱으로 학습이 병렬적이어서 빠르지만 생성은 픽셀 단위라 느리다. PixelRNN은 학습은 순차적이지만 생성은 행 단위다.
- VAE는 조건부 독립 가우시안 디코더와 최대우도의 질량 분산 경향 때문에 흐릿한 이미지를 만들기 쉽다.
- ELBO는 \(q(z \mid x_i)/q(z \mid x_i)\)를 곱하고 Jensen 부등식을 적용해 얻으며, 재구성 항과 KL 항의 합으로 정리된다. \(z\)는 \(q(z \mid x_i)\)에서 샘플링한다.
- 재매개변수화는 무작위성을 파라미터와 무관한 잡음으로 옮겨 기울기를 기댓값 안으로 넣는다. \(E_{\mathcal{N}(\theta,1)}[x^2]\)의 기울기는 \(2\theta\)다.
- Flow의 목적함수는 \(\log p(f^{-1}(x)) - \log \lvert \det(df/dz) \rvert\)이며, \(f\)는 미분 가능하고 가역이며 행렬식이 쉬워야 한다. Real-NVP의 로그 행렬식은 \(\sum_i h_\theta(z_{1:d})_i\)다.