- UC Berkeley CS 182 (Spring 2021) Discussion 8 정리
- 관련 강의: Deep Learning 13, Deep Learning 14
이번 Discussion은 두 부분으로 이루어진다. 1절은 NLP의 비지도 사전학습 방법을 개념 위주로 복습하고, 2절은 모방 학습을 다루며 두 개의 문제를 푼다.
1. NLP의 비지도 사전학습
왜 사전학습인가
인터넷, 책, 출판물 등에서 레이블 없는 텍스트는 쉽게 구할 수 있다. 이 텍스트로 언어의 표현을 배워 두면 다운스트림 과제에 도움이 된다. 예를 들어 영어-프랑스어 문장 쌍으로 번역을 학습할 때, 영어를 전혀 모르는 상태에서 시작하는 것보다 영어에 대한 일반적인 이해를 갖고 시작하는 편이 훨씬 쉽다. 그 이해는 비지도 데이터로 얻을 수 있다.
1.1 단어 임베딩
강의에서는 단어를 원-핫 벡터로 추상화했다. 단어 임베딩(word embedding) 의 목표는 단어를 실수 벡터로 보내되, 표현 사이의 거리가 의미를 갖도록 하는 것이다. 즉 “비슷한” 단어는 가까운 벡터로 보낸다. 그러면 다운스트림 학습이 훨씬 쉬워진다.
단순한 Word2Vec. 표현을 주변 단어 예측에 맞춰 최적화한다. 중심 단어 \(c\)로 문장 속 이웃 단어(문맥 단어 \(o\))를 로지스틱 회귀로 예측한다. 각 단어 \(w\)에 두 벡터 \(u_w\)와 \(v_w\)를 연결하고, 모든 중심-문맥 쌍에 대해 평균한 다음 우도를 최대화한다.
\[p(o \mid c) = \frac{\exp(u_o^\top v_c)}{\sum_{w \in V} \exp(u_w^\top v_c)}\]함께 등장하는 단어 쌍은 내적 \(u_o^\top v_c\)가 커진다. 또 단어 \(a\)와 \(b\)가 의미가 비슷해 서로 바꿔 쓸 수 있다면, 비슷한 문맥에 등장하므로 \(u_a \approx u_b\), \(v_a \approx v_b\)가 된다. 두 벡터로 나누는 것은 최적화를 쉽게 하기 위해서이며, 학습 후에는 둘을 평균해 최종 임베딩으로 쓴다.
Word2Vec을 다룰 만하게 만들기. 정규화 항 \(\sum_{w \in V} \exp(u_w^\top v_c)\)는 어휘 전체에 대한 합이므로 매우 느리다. 대안은 이진 분류로 바꾸는 것이다.
\[p(o \text{ is the right word} \mid c) = \sigma(u_o^\top v_c) = \frac{1}{1 + \exp(-u_o^\top v_c)}\]그런데 양성 예(실제 이웃 쌍)만 쓰면 자명한 해가 생긴다. 모든 단어의 \(u\), \(v\)를 같은 아주 큰 벡터로 만들면 분류기가 모든 쌍을 확신을 갖고 “맞다”고 예측한다. 이를 막기 위해 배치마다 사전에서 무작위로 뽑은 음성 샘플(negative sample) 의 우도도 낮춘다.
\[\max \sum_{c, o} \left( \log p(o \text{ is the right word} \mid c) + \sum_{w} \log p(w \text{ is wrong} \mid c) \right)\]여기서 \(p(w \text{ is wrong} \mid c) = 1 - \sigma(u_w^\top v_c) = \sigma(-u_w^\top v_c)\)이다. 이 목적은 실제 쌍의 \(v_c\)와 \(u_o\)는 가깝게, 다른 단어의 \(u_w\)와는 멀게 민다.
1.2 사전학습된 언어 모델
Word2Vec의 약점은 학습이 끝나면 단어의 표현이 문맥에 의존하지 않는다는 것이다. 단어는 문맥에 따라 뜻이 크게 다를 수 있다. 문맥 의존 임베딩을 얻는 간단한 방법은 어떤 과제로 학습한 언어 모델(예: LSTM)에 문장을 통과시키고, 각 단어 위치의 은닉 상태를 임베딩으로 쓰는 것이다. 언어 모델은 과제를 풀기 위해 문맥을 써야 했으므로 그 은닉 상태는 문맥 의존 표현이다.
ELMo. LSTM을 앞으로만 돌리면 각 단어의 임베딩은 앞쪽 단어에만 의존한다. ELMo는 양방향 LSTM을 학습하고(앞 방향은 다음 단어, 뒤 방향은 이전 단어를 예측) 두 방향의 은닉 상태를 이어 붙여 임베딩을 만든다. 주변 단어를 예측해 학습한다는 점에서 Word2Vec과 비슷하지만, 단어 하나가 아니라 문맥 속의 단어를 임베딩한다는 점이 다르다.
BERT. BERT는 Transformer 하나로 임베딩을 만든다. 시퀀스 생성용 Transformer는 미래를 보지 않도록 마스킹된 셀프 어텐션을 썼지만, 여기서는 단어의 전체 문맥을 보아야 하므로 마스크가 없다. 그런데 마스크가 없으면 다음 단어가 입력에 그대로 보이므로 다음 단어 예측이 자명해진다. 해결책은 비지도 과제를 바꾸는 것이다. 입력의 일부 단어를 무작위로 가리고 그 단어를 예측하도록 학습한다(masked language modeling). 그러면 모델은 문맥에 의존하는 단어 수준 표현을 배울 수밖에 없다.
BERT는 문장 수준 표현도 학습한다. 워크시트의 설명에 따르면 문장 쌍을 받아 순서를 무작위로 바꾸고, 원래 어느 문장이 먼저였는지를 예측하는 이진 분류기를 학습한다. (원 논문의 next sentence prediction은 두 번째 문장이 실제로 이어지는 문장인지, 말뭉치에서 무작위로 뽑은 문장인지를 맞히는 이진 분류다.) 다운스트림 과제에서는 문장 수준 표현이나 단어 수준 표현을 쓸 수 있고, 모델 전체를 미세조정하거나 은닉 상태들의 조합을 고정된 표현으로 쓸 수 있다.
2. 모방 학습과 MDP
마르코프 결정 과정
MDP(Markov decision process) 는 상태 공간 \(\mathcal{S}\), 행동 공간 \(\mathcal{A}\), 전이 함수 \(P(s' \mid s, a)\), 보상 함수 \(r(s, a)\)로 정의된다. 핵심은 마르코프 성질이다. 현재 상태와 행동이 주어지면 다음 상태는 과거의 모든 것과 조건부 독립이다.
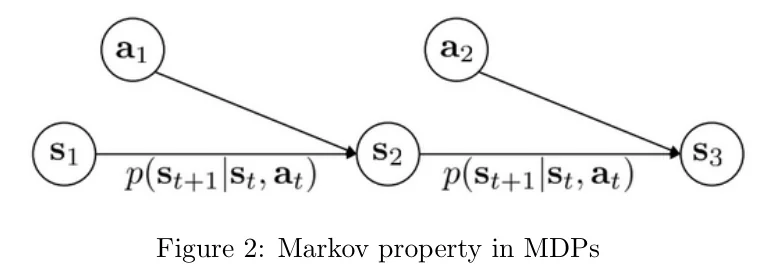 MDP의 마르코프 성질. 다음 상태 \(s_{t+1}\)로 들어오는 화살표는 현재 상태 \(s_t\)와 행동 \(a_t\)에서만 온다. 출처: CS 182 Discussion 8.
그림에서 \(s_2\)로 들어오는 화살표는 \(s_1\)과 \(a_1\) 두 개뿐이고, \(s_3\)으로 들어오는 화살표도 \(s_2\)와 \(a_2\)뿐이다. \(s_1\)이나 \(a_1\)에서 \(s_3\)으로 가는 직접 화살표가 없으므로, \(s_2\)를 알면 \(s_1, a_1\)은 \(s_3\)에 대해 추가 정보를 주지 않는다. 각 화살표 쌍에 붙은 \(p(s_{t+1} \mid s_t, a_t)\)가 전이 함수이며, 아래 문제 1에서 궤적 확률을 분해할 때 마지막 단계가 바로 이 그림의 구조를 쓰는 것이다.
목표는 궤적에 걸친 보상의 합을 최대화하는 것이다. 마르코프 성질 때문에 최적 정책은 현재 상태에만 의존하는 조건부 분포 \(\pi(a \mid s)\)로 쓸 수 있다(마르코프 정책, 정상(stationary) 정책). 모방 학습은 보상을 직접 쓰지 않지만, 성공의 기준은 전문가 데이터에 대한 음의 로그우도가 아니라 학습된 정책이 실제로 과제를 얼마나 잘 수행하느냐라는 점을 기억해야 한다.
문제 1. 마르코프 정책 아래 궤적의 확률
문제
정책 \(\pi_\theta(a \mid s)\)가 주어졌을 때, 마르코프 성질을 써서 궤적 \(\tau = ((s_0, a_0), (s_1, a_1), \dots, (s_T, a_T))\)의 로그 확률을 구하라.
풀이
먼저 확률의 연쇄 법칙으로 분해한다.
\[p(\tau) = p(s_0, a_0) \prod_{t=1}^{T} p(s_t, a_t \mid s_0, a_0, \dots, s_{t-1}, a_{t-1})\]각 인수를 상태 부분과 행동 부분으로 나눈다. 정책은 마르코프 정책이므로 행동은 현재 상태에만 의존한다.
\[p(\tau) = p(s_0)\, \pi(a_0 \mid s_0) \prod_{t=1}^{T} p(s_t \mid s_0, a_0, \dots, s_{t-1}, a_{t-1})\, \pi(a_t \mid s_t)\]전이의 마르코프 성질에 의해 다음 상태는 직전 상태와 행동에만 의존한다.
\[p(\tau) = p(s_0)\, \pi(a_0 \mid s_0) \prod_{t=1}^{T} p(s_t \mid s_{t-1}, a_{t-1})\, \pi(a_t \mid s_t)\]로그를 취하면 곱이 합으로 바뀐다.
\[\log p(\tau) = \log p(s_0) + \log \pi(a_0 \mid s_0) + \sum_{t=1}^{T} \left[ \log p(s_t \mid s_{t-1}, a_{t-1}) + \log \pi(a_t \mid s_t) \right]\]참고: 부분 관측 MDP
실제로는 마르코프 성질을 만족하는 전체 상태 \(s\)를 볼 수 없고 제한된 관측 \(o\)만 볼 때가 많다. 운전할 때 주변의 모든 것을 볼 수는 없지만, 보이지 않는 것도 세상의 움직임에 영향을 준다. 이런 POMDP에서는 최적 정책이 더 이상 정상적이지 않을 수 있고, 과거 관측 전체에 의존해야 할 수 있다(\(\pi(a_t \mid o_1, \dots, o_t)\)). 마르코프 성질은 숨은 상태 \(s\)에 대해서는 여전히 성립하지만 정책은 \(s\)에 직접 의존할 수 없다. 별도 언급이 없으면 완전 관측 MDP를 가정한다.
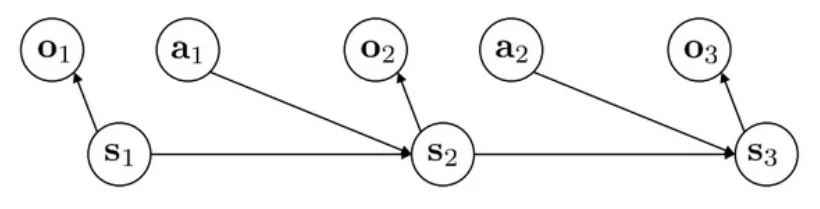 POMDP의 그래프. 상태 사이의 전이는 MDP와 같지만, 각 상태 \(s_t\)에서 관측 \(o_t\)가 생성되고 정책은 \(o_t\)만 볼 수 있다. 출처: CS 182 Discussion 8.
앞의 MDP 그림과 비교하면 아래쪽 상태 사슬 \(s_1 \to s_2 \to s_3\)와 행동에서 오는 화살표는 그대로이고, 각 상태 위에 관측 \(o_t\)가 추가되었다. 화살표는 \(s_t\)에서 \(o_t\)로만 향하므로 관측은 상태의 결과일 뿐이며, \(o_t\)만으로 \(s_t\)를 완전히 복원할 수 있다는 보장이 없다. 그래서 \(o_2\)만 보는 정책은 \(o_1\)이 담고 있던 \(s_1\)의 정보(예: 지금은 가려진 차가 조금 전에 어디 있었는가)를 잃게 되고, 이 때문에 과거 관측 전체에 의존하는 정책이 필요해진다.
행동 복제
행동 복제(behavior cloning) 는 가장 단순한 모방 학습이다. 전문가 궤적 \(N\)개의 모든 상태-행동 쌍을 모아 데이터셋 \(\mathcal{D}\)를 만들고, 상태를 입력, 전문가 행동을 레이블로 하여 지도학습한다. 최대우도로 학습하면 목적 함수는 다음과 같다.
\[\max_\theta \sum_{(s, a) \sim \mathcal{D}} \log \pi_\theta(a \mid s)\]문제 2. 행동 복제는 전문가 궤적의 우도를 최대화한다
문제
문제 1의 분해를 써서, 행동 복제 목적 함수가 (어떤 전문가 \(\beta\)가 생성한) 전문가 궤적의 학습된 정책 아래 확률을 최대화함을 보여라.
\[\max_\theta \; \mathbb{E}_{\tau \sim \beta} \log \pi_\theta(\tau)\]풀이
여기서 \(\pi_\theta(\tau)\)는 학습된 정책을 실행했을 때의 궤적 분포다. 문제 1에서 다음을 얻었다.
\[\log \pi_\theta(\tau) = \log p(s_0) + \sum_{t=1}^{T} \log p(s_t \mid s_{t-1}, a_{t-1}) + \sum_{t=0}^{T} \log \pi_\theta(a_t \mid s_t)\]초기 상태 분포 \(p(s_0)\)와 전이 확률 \(p(s_t \mid s_{t-1}, a_{t-1})\)는 환경이 정하므로 \(\theta\)에 의존하지 않는다. 최적화에서 이 항들은 상수다. 따라서 궤적의 로그우도를 최대화하는 것은 다음을 최대화하는 것과 같다.
\[\max_\theta \; \mathbb{E}_{\tau \sim \beta} \left[ \sum_{t=0}^{T} \log \pi_\theta(a_t \mid s_t) \right]\]모든 궤적과 모든 시간 단계에 대해 평균하면, 이는 데이터셋 \(\mathcal{D}\)의 모든 상태-행동 쌍에 대한 \(\log \pi_\theta(a \mid s)\)의 합, 즉 행동 복제의 지도학습 목적 함수와 같다. 차이는 진짜 전문가 궤적 분포 대신 데이터셋의 경험적 분포를 쓴다는 것뿐이다.
참고: DAgger
전문가 궤적에 높은 우도를 주는 정책이라고 해서 좋은 성능이 보장되지는 않는다. 핵심 문제는 훈련과 테스트 사이의 분포 이동이다. 훈련 중 정책은 전문가가 방문한 상태에서만 학습한다. 테스트 때는 학습된 정책을 실행하므로, 전문가와의 작은 차이가 훈련에서 본 적 없는 상태로 이끈다. 그런 상태에서는 정책이 전문가를 잘 따라 하지 못하므로 실수가 이어진다. 전문가라면 앞의 실수에서 회복할 수 있었더라도 모방 정책은 그러지 못한다.
한 가지 해결책은 전문가를 더 정확하게 맞추는 것이다. 하지만 매우 정확한 모델이 필요하고, 전문가가 비마르코프적이거나(마르코프 정책으로는 정확히 맞출 수 없다) 다봉적일 때(정책 분포가 충분히 표현력이 없다) 어렵다.
다른 해결책은 훈련 데이터 분포를 바꾸어 테스트 때 만날 궤적을 더 잘 덮는 것이다. DAgger(dataset aggregation) 는 현재 정책으로 새 궤적을 모으고, 전문가에게 그 상태들에서의 행동을 레이블로 받아, 데이터셋에 추가하고 다시 학습하는 과정을 반복한다. 데이터의 상태 분포가 계속 현재 정책의 분포를 포함하게 되며, 정책의 분포가 안정되고 성능이 좋아지면 멈춘다. 효과적이지만 학습 중 환경과 상호작용해야 하고, 새 상태마다 전문가에게 질의해야 하므로 둘 다 비용이 클 수 있다.
정리
- 비지도 사전학습은 레이블 없는 대량의 텍스트로 언어 표현을 배워 다운스트림 과제를 돕는다.
- Word2Vec은 중심 단어로 문맥 단어를 예측해 임베딩을 학습한다. softmax 정규화가 비싸므로 이진 분류로 바꾸고, 자명한 해를 막기 위해 네거티브 샘플링을 쓴다.
- ELMo(양방향 LSTM)와 BERT(마스킹된 단어 예측을 쓰는 Transformer)는 문맥에 의존하는 단어 표현을 준다. BERT는 마스크 없는 어텐션을 쓰므로 다음 단어 예측 대신 가려진 단어 예측으로 과제를 바꾼다.
- 마르코프 정책과 마르코프 전이 아래 궤적의 로그 확률은 초기 상태, 전이, 정책 항의 합으로 분해된다.
- 정책 항만 \(\theta\)에 의존하므로, 행동 복제는 전문가 궤적의 로그우도를 최대화하는 것과 같다. 그러나 우도가 높다고 성능이 좋은 것은 아니며, 분포 이동을 줄이려면 DAgger 같은 방법이 필요하다.