- UC Berkeley CS 182 (Spring 2021) Discussion 12 정리
- 관련 강의: Deep Learning 21
이번 Discussion은 메타러닝을 다룬다. 머신러닝 모델은 보통 많은 샘플이 필요하지만 실제로는 샘플이 매우 적은 경우가 많다. 메타러닝은 하나의 과제를 푸는 대신 배우는 법을 배워(learn to learn) 새 과제에 빠르게 적응하는 모델을 만든다. 새 게임을 빨리 익히는 게임 봇, 학습 때 보지 못한 클래스라도 예제 몇 개만 보고 판별하는 분류기가 그 예다.
지도 메타러닝의 형식화. 여러 과제로 학습하며, 각 과제의 레이블된 데이터셋 \(\mathcal{D}\)를 적응용 \(\mathcal{D}^{\text{tr}}\)와 평가용 \(\mathcal{D}^{\text{ts}}\)로 나눈다. 일반 지도학습은 \(\theta^\ast = \arg\min_\theta \mathcal{L}_\theta(\mathcal{D}^{\text{tr}}) = f_{\text{learn}}(\mathcal{D}^{\text{tr}})\)를 구한다. 메타러닝은 다음을 학습한다.
\[\theta^\ast = \arg\min_\theta \sum_{i=1}^{n} \mathcal{L}(\phi_i, \mathcal{D}_i^{\text{ts}}), \quad \phi_i = f_{\text{adapt}}(\theta, \mathcal{D}_i^{\text{tr}})\]\(\phi_i\)는 학습셋으로 적응 절차를 돌려 얻은 과제별 파라미터다. 최적화 루프가 두 개다. 내부 루프(inner loop) 학습기는 학습셋으로 각 과제를 풀고, 메타 학습기(meta-learner) 는 내부 학습기가 테스트셋에 잘 일반화하도록 그 학습 방식을 조절한다.
블랙박스 메타러닝. RNN이나 LSTM 같은 순환 모델이 학습셋을 차례로 읽은 뒤 새 입력을 처리한다. 이미지 분류라면 (이미지, 레이블) 쌍들을 순서대로 넣고 이어서 분류할 새 예제를 넣는다. 메타 학습기는 경사 하강을 쓰고, 학습기는 순환 모델을 펼쳐 실행하는 것이다.
Matching Networks. 테스트 샘플의 레이블 분포를 학습 샘플 레이블에 대한 주의 가중합으로 정의한다.
\[p_\theta(y_j^{\text{ts}} \mid x_j^{\text{ts}}, \mathcal{D}_i^{\text{tr}}) = \sum_{k : y_k^{\text{tr}} = y_j^{\text{ts}}} p_{\text{nearest}}(x_k^{\text{tr}} \mid x_j^{\text{ts}}), \quad p_{\text{nearest}}(x_k^{\text{tr}} \mid x_j^{\text{ts}}) \propto \exp\left( g(x_k^{\text{tr}}, \mathcal{D}_i^{\text{tr}})^T f(x_j^{\text{ts}}, \mathcal{D}_i^{\text{tr}}) \right)\]\(f\)는 테스트 샘플, \(g\)는 학습셋을 임베딩하는 함수다.
Prototypical Networks. 각 클래스의 프로토타입을 그 클래스 학습 샘플 임베딩의 평균으로 정의하고, 프로토타입과의 내적으로 분류한다.
\[c_y = \frac{1}{N_y} \sum_{k : y_k^{\text{tr}} = y} g(x_k^{\text{tr}}), \quad p_\theta(y \mid x_j^{\text{ts}}, \mathcal{D}_i^{\text{tr}}) \propto \exp\left( c_y^T f(x_j^{\text{ts}}) \right)\]MAML. 전이 학습의 큰 성공 사례는 ImageNet으로 사전학습한 네트워크를 새 과제 데이터로 미세조정하는 것이다. MAML(Model-Agnostic Meta-Learning)은 이를 확장해, 몇 번의 기울기 스텝만으로 다양한 과제에 적응할 수 있도록 “사전학습된” 초기값을 명시적으로 최적화한다. 새 과제에서는 기울기 스텝으로 파라미터를 갱신한다.
\[\theta_i' = \theta - \alpha \nabla_\theta \mathcal{L}_i(\theta, \mathcal{D}_i^{\text{tr}})\]여러 과제에 걸쳐 잘 일반화하도록 \(\theta\)를 갱신한다.
\[\theta \leftarrow \theta - \beta \nabla_\theta \sum_i \mathcal{L}\left( \theta - \alpha \nabla_\theta \mathcal{L}(\theta, \mathcal{D}_i^{\text{tr}}), \mathcal{D}_i^{\text{ts}} \right)\]메타 학습 동안 \(\theta\)는 각 과제 방향으로 기울기 한 스텝을 밟았을 때 그 과제의 최적 파라미터 \(\theta_i^\ast\)에 가까워지는 위치로 이동한다.
1. MAML의 기울기 갱신
문제
MAML 바깥 루프의 기울기를 유도하라. \(\mathcal{L}^{(0)}\)과 \(\mathcal{L}^{(1)}\)을 첫째와 둘째 미니배치의 손실이라 하고, 내부 루프에서 이미 \(k\)번의 기울기 스텝을 밟았다고 하자.
\[\theta_0 = \theta_{\text{meta}}, \quad \theta_1 = \theta_0 - \alpha \nabla_\theta \mathcal{L}^{(0)}(\theta_0), \quad \dots, \quad \theta_k = \theta_{k-1} - \alpha \nabla_\theta \mathcal{L}^{(0)}(\theta_{k-1})\]새 데이터 배치를 뽑은 뒤 바깥 루프의 갱신은 \(\theta_{\text{meta}} \leftarrow \theta_{\text{meta}} - \beta g_{\text{MAML}}\)이다. \(g_{\text{MAML}}\)을 구하라.
풀이
\(g_{\text{MAML}}\)은 적응된 파라미터에서의 손실 \(\mathcal{L}^{(1)}(\theta_k)\)를 메타 파라미터 \(\theta_{\text{meta}}\)로 미분한 것이다. \(\theta_k\)는 \(\theta_{k-1}\)의, \(\theta_{k-1}\)은 \(\theta_{k-2}\)의 함수이므로 연쇄 법칙을 반복해 적용한다.
\[\begin{aligned} g_{\text{MAML}} &= \nabla_{\theta_{\text{meta}}} \mathcal{L}^{(1)}(\theta_k) \\ &= \nabla_{\theta_k} \mathcal{L}^{(1)}(\theta_k) \cdot (\nabla_{\theta_{k-1}} \theta_k) \cdots (\nabla_{\theta_0} \theta_1) \cdot (\nabla_{\theta_{\text{meta}}} \theta_0) \\ &= \nabla_{\theta_k} \mathcal{L}^{(1)}(\theta_k) \cdot \left( \prod_{i=1}^{k} \nabla_{\theta_{i-1}} \theta_i \right) \cdot I \end{aligned}\]\(\theta_0 = \theta_{\text{meta}}\)이므로 마지막 야코비안은 단위행렬이다. 각 내부 스텝의 야코비안은 갱신식을 미분해 얻는다.
\[\nabla_{\theta_{i-1}} \theta_i = \nabla_{\theta_{i-1}} \left( \theta_{i-1} - \alpha \nabla_\theta \mathcal{L}^{(0)}(\theta_{i-1}) \right) = I - \alpha \nabla^2_\theta \mathcal{L}^{(0)}(\theta_{i-1})\]여기서 \(\nabla^2_\theta \mathcal{L}^{(0)}\)은 헤시안이다. 따라서
\[g_{\text{MAML}} = \nabla_{\theta_k} \mathcal{L}^{(1)}(\theta_k) \cdot \prod_{i=1}^{k} \left( I - \alpha \nabla^2_\theta \mathcal{L}^{(0)}(\theta_{i-1}) \right)\]이다. 위 식은 기울기를 행벡터로 보고 곱의 순서를 \(i = k\)부터 \(1\)까지로 읽는다. 헤시안이 대칭이므로 열벡터로 쓰면 \(g_{\text{MAML}} = (I - \alpha H_0)(I - \alpha H_1) \cdots (I - \alpha H_{k-1}) \nabla_{\theta_k} \mathcal{L}^{(1)}(\theta_k)\), \(H_i = \nabla^2_\theta \mathcal{L}^{(0)}(\theta_i)\)다.
\(k = 1\)이면 다음과 같다.
\[g_{\text{MAML}} = \nabla_{\theta_1} \mathcal{L}^{(1)}(\theta_1) \cdot \left( I - \alpha \nabla^2_\theta \mathcal{L}^{(0)}(\theta_0) \right)\]이 결과가 MAML이 2차 도함수를 필요로 하는 이유다. 실제로는 헤시안을 직접 만들지 않고, 내부 갱신을 계산 그래프로 두고 역전파하면 자동 미분이 헤시안-벡터 곱을 계산한다. 헤시안 항을 버리고 \(g \approx \nabla_{\theta_k} \mathcal{L}^{(1)}(\theta_k)\)로 쓰는 1차 근사(first-order MAML)도 있다.
MAML의 장점은 다음과 같다. 경사 하강으로 학습된다는 것 외에 모델 형태에 제약이나 가정이 없다. 네트워크에 추가 파라미터를 도입하지 않고, 내부와 바깥 루프 모두 경사 하강만 쓴다. 여러 도메인에 쉽게 적용되며, 소수샷 이미지 분류 벤치마크에서 기존 방법들을 크게 앞섰다.
2. 은닉 상태의 초기화
문제
메타 강화학습(meta-RL) 은 손실 최소화 대신 기대 보상을 최대화한다.
\[\theta^\ast = \arg\max_\theta \sum_{i=1}^{n} E_{\pi_{\phi_i}(\tau)}[R(\tau)], \quad \phi_i = f_\theta(\mathcal{M}_i)\]\(\{\mathcal{M}_i\}_{i=1}^{n}\)은 학습용 MDP들이다. 정책은 현재 MDP에서의 과거 경험을 어떻게든 반영해 적응해야 한다. 지금 어떤 MDP를 풀고 있는지 직접 관측하지 못하고 궤적으로 추론해야 하므로, 부분 관측 MDP(POMDP)를 푸는 것으로 볼 수 있다.
자연스러운 접근은 현재 MDP의 경험 이력을 RNN(또는 LSTM) 정책에 넣는 것이다. 학습은 다음과 같다(RL² 방식).
- 새 MDP \(\mathcal{M}_i\)를 뽑는다.
- 모델의 은닉 상태를 초기화한다.
- 여러 궤적을 모으며 은닉 상태를 계속 갱신하고, 마지막에 정책 경사로 모델 가중치를 갱신한다. 에피소드 사이에는 은닉 상태를 초기화하지 않는다.
- 1단계로 돌아간다.
왜 과제(MDP) 사이에서는 은닉 상태를 초기화하고, 에피소드 사이에서는 초기화하지 않는가?
풀이
- 과제 사이에서 초기화하는 이유: 은닉 상태는 “지금 어떤 MDP인가”에 대한 정보를 담는다. 새 MDP로 넘어갈 때 이를 유지하면 이전 MDP의 정보가 새어 들어와 잘못된 추론을 하게 된다.
- 에피소드 사이에서 유지하는 이유: 같은 MDP 안에서는 앞 에피소드에서 얻은 정보(예: 목표의 위치)가 다음 에피소드에서 그대로 유효하다. 은닉 상태를 유지해야 에피소드를 넘어 기억을 이어 갈 수 있고, 바로 이것이 적응이다. 메타 에피소드 전체의 보상을 최적화하므로 첫 에피소드에서 정보를 모으는 탐색 행동도 학습된다.
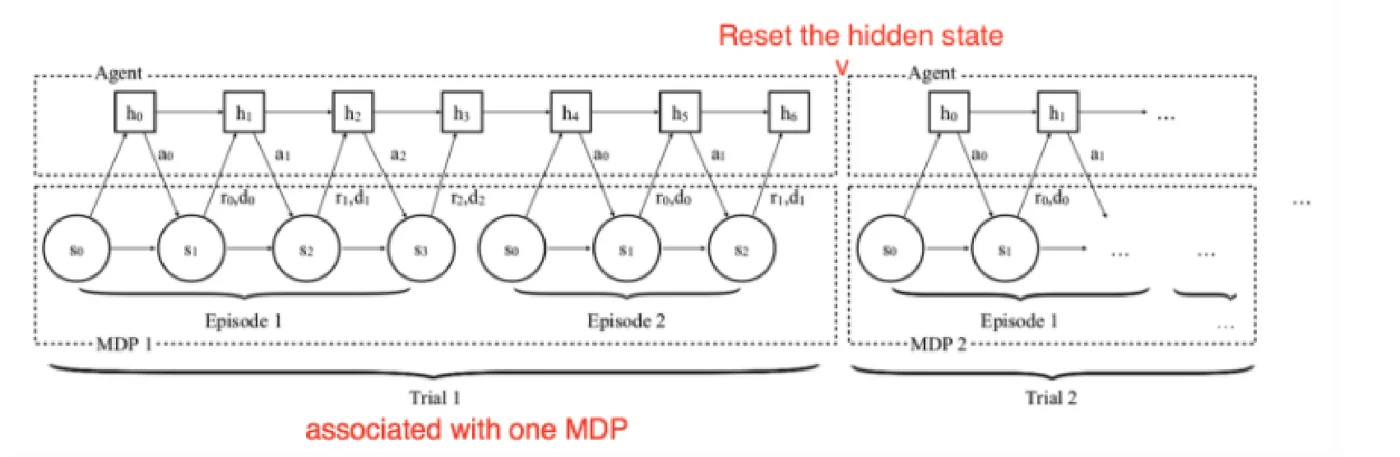 RL² 논문의 학습 절차. 위쪽 상자는 에이전트(RNN)의 은닉 상태 \(h_0, h_1, \dots\), 아래쪽 상자는 환경의 상태 \(s_0, s_1, \dots\)이다. 하나의 MDP에 대한 Trial 1 안에서는 Episode 1에서 Episode 2로 넘어가도 은닉 상태가 \(h_3 \to h_4\)로 이어지고, MDP 2로 넘어가는 Trial 2에서는 은닉 상태가 \(h_0\)으로 초기화된다. 출처: CS 182 Discussion 12.
그림의 화살표를 따라가면 RNN 입력의 구성이 보인다. 각 시점에 에이전트는 환경 상태 \(s_t\)와 함께 직전 행동 \(a\), 보상 \(r\), 에피소드 종료 신호 \(d\)를 입력으로 받는다. Episode 1의 마지막 상태 \(s_3\) 다음에 환경은 Episode 2의 \(s_0\)으로 리셋되지만, 에이전트 쪽은 \(h_3\)에서 \(h_4\)로 그대로 이어진다. 그래서 Episode 2의 첫 행동부터 Episode 1에서 알아낸 정보를 쓸 수 있다. 종료 신호 \(d\)가 입력에 들어가므로 RNN은 에피소드 경계를 알면서도 기억을 유지한다.
오른쪽의 “Reset the hidden state” 표시는 MDP가 바뀌는 지점이다. 위 풀이의 두 이유가 그림의 두 경계에 정확히 대응한다. 에피소드 경계에서는 같은 MDP이므로 정보를 이어 가고, MDP 경계에서는 다른 과제이므로 정보를 지운다.
과거 경험을 요약하는 구조로는 표준 RNN(LSTM), 주의와 시간 합성곱, 병렬적이고 순서 불변인 문맥 인코더 등이 개발되었다.
강화학습을 위한 MAML. 과제 \(\mathcal{T}_i\)를 지평선 \(H\)인 MDP로 두고, 손실을 음의 보상으로 정의한다. 전이 분포를 \(q(x_{t+1} \mid x_t, a_t)\)라 하면 다음과 같다.
\[\mathcal{L}_{\mathcal{T}_i}(f_\phi) = -E_{x_t, a_t \sim f_\phi, q_{\mathcal{T}_i}}\left[ \sum_{t=1}^{H} r_i(x_t, a_t) \right]\]기대 보상은 지도학습 손실처럼 직접 미분할 수 없으므로, 내부 적응과 메타 최적화 모두에서 정책 경사로 기울기를 추정한다. 학습기는 소수샷 학습을 위해 제한된 수의 궤적만 질의할 수 있다.
정리
- 메타러닝은 과제마다 학습셋으로 적응하는 내부 루프와, 적응된 모델이 테스트셋에서 잘 하도록 적응 방식을 학습하는 바깥 루프로 이루어진다.
- 블랙박스 방법은 RNN이 학습셋을 읽고, Matching Networks와 Prototypical Networks는 학습된 임베딩 공간에서 주의 가중합이나 클래스 평균 프로토타입으로 분류한다.
- MAML은 몇 번의 기울기 스텝으로 잘 적응하는 초기값을 학습한다. 메타 기울기는 \(\nabla_{\theta_k} \mathcal{L}^{(1)}(\theta_k) \prod_i (I - \alpha \nabla^2 \mathcal{L}^{(0)}(\theta_{i-1}))\)이며, 헤시안 항 때문에 2차 도함수가 필요하다.
- RNN 기반 메타 강화학습은 MDP 사이에서는 정보 누출을 막기 위해 은닉 상태를 초기화하고, 같은 MDP의 에피소드 사이에서는 기억을 유지해 적응과 탐색을 학습한다.
- MAML은 손실을 음의 보상으로 두고 정책 경사로 기울기를 추정해 강화학습에도 적용할 수 있다.