- UC Berkeley CS 182 (Spring 2021) Discussion 11 정리
- 관련 강의: Deep Learning 19, Deep Learning 20
이번 Discussion은 생성적 적대 신경망(GAN)과 적대적 공격을 다룬다.
GAN 게임. 고정된 잡음 분포에서 \(Z \sim p(Z)\)를 뽑아 결정적 생성기 \(G_\theta\)에 통과시켜 샘플 \(\tilde{X} = G_\theta(Z) \sim p_G(\tilde{X})\)를 얻는다. 이진 분류기인 판별기 \(D_\phi\)는 생성 샘플과 실제 데이터 \(X \sim p(X)\)를 구분하도록 학습한다. 학습은 두 플레이어 게임이다.
\[\min_{G_\theta} \max_{D_\phi} E_{X \sim p(X)}[\log D_\phi(X)] + E_{Z \sim p(Z)}[\log(1 - D_\phi(G_\theta(Z)))]\]생성기를 고정하면 판별기 학습은 일반 이진 분류기 학습과 같고, 판별기를 고정하면 생성기는 판별기가 진짜라고 여기는 샘플을 만들도록 최적화된다. 이 목적함수는 생성 샘플의 우도 \(p_\theta(\tilde{x})\)를 계산할 필요가 없다는 점에서 앞의 잠재변수 모델보다 유연하다. 실제로는 판별기를 끝까지 최적화하지 않고 두 네트워크를 번갈아 기울기 스텝으로 갱신한다.
1. 최적 판별기
문제
판별기가 무한히 표현력이 크고 생성기 갱신마다 수렴할 때까지 최적화된다고 하자. 고정된 생성기 \(G\)에 대해 최적 판별기가 다음과 같음을 보여라.
\[D^\ast(x) = \frac{p(x)}{p(x) + p_G(x)}\]풀이
판별기가 완전히 표현력이 크므로 각 입력 \(x\)에서 값 \(D(x)\)를 독립적으로 고를 수 있다. 기댓값을 적분으로 쓰면, 특정 \(x\)에서 판별기 값에 관련된 부분은 다음과 같다.
\[\max_{D(x)} \; p(x) \log D(x) + p_G(x) \log(1 - D(x))\]\(D(x)\)로 미분해 0으로 둔다.
\[0 = \frac{p(x)}{D(x)} - \frac{p_G(x)}{1 - D(x)} \quad \Rightarrow \quad p_G(x) D(x) = p(x)(1 - D(x)) \quad \Rightarrow \quad D(x) = \frac{p(x)}{p(x) + p_G(x)}\]목적함수는 \(D(x)\)에 대해 오목하므로 이 정류점이 최댓값이다.
이 최적 판별기를 게임에 대입하면 생성기에 대한 단일 최적화가 된다.
\[\min_{G_\theta} E_{X \sim p}\left[ \log \frac{p(X)}{p(X) + p_G(X)} \right] + E_{\tilde{X} \sim p_G}\left[ \log \frac{p_G(\tilde{X})}{p(\tilde{X}) + p_G(\tilde{X})} \right]\]\(q(x) = \frac{p(x) + p_G(x)}{2}\)로 두면 분모를 \(2q(x)\)로 바꿀 수 있고, 각 항에서 \(-\log 2\)가 나온다.
\[\min_{G_\theta} \underbrace{E_{p}[\log p(X) - \log q(X)]}_{D_{\mathrm{KL}}(p \lVert q)} + \underbrace{E_{p_G}[\log p_G(\tilde{X}) - \log q(\tilde{X})]}_{D_{\mathrm{KL}}(p_G \lVert q)} - \log 4\]두 KL 항의 합은 Jensen-Shannon 발산의 두 배 \(2 D_{\mathrm{JS}}(p \lVert p_G)\)다. 상수는 최적화에 영향을 주지 않으므로, 완벽한 판별기가 있는 이상적 상황에서 GAN 학습은 생성기 분포와 데이터 분포 사이의 JS 발산을 최소화한다.
실제 GAN 학습
실제로는 계산과 표현력의 한계 때문에 최적 판별기를 찾지 못하므로 JS 발산을 정확히 최소화하지 않는다. 게다가 완벽한 판별기는 오히려 바람직하지 않다. 1차원 예에서 실제 데이터와 생성 데이터가 떨어져 있으면, 최적 판별기 값은 생성 데이터 위에서 거의 상수여서 생성기 기울기가 극히 작다.
핵심은 판별기 자체의 성능이 아니라 생성기에 유용한 신호를 주느냐다. 흔한 방법은 판별기에 매끄러움 조건을 걸어 표현력을 제한하는 것이다. Lipschitz 연속인 판별기는 생성 샘플에서 실제 데이터 쪽으로 기울어 있어, 생성기가 그 기울기를 따라 이동할 수 있다. WGAN, 기울기 벌점 GAN, 스펙트럼 정규화 GAN이 서로 다른 매끄러움 개념을 강제한다. 실수값 판별기를 쓰는 LSGAN(이상적 조건에서 Pearson \(\chi^2\) 발산 최소화와 같다)과, 입력에 잡음을 더해 두 분포를 매끄럽게 하는 instance noise도 기울기 소실을 줄인다.
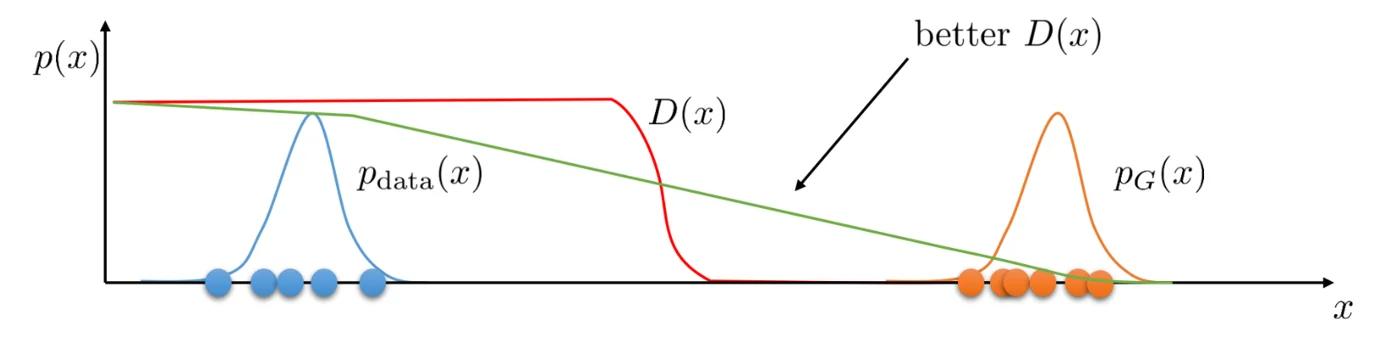 1차원 예에서 실제 데이터(파랑)와 생성 데이터(주황)가 떨어져 있을 때의 두 판별기. 빨간 선은 최적 판별기로 생성 데이터 위에서 평평하고, 초록 선은 Lipschitz 연속으로 제한한 “더 나은” 판별기로 생성 데이터에서 실제 데이터 쪽으로 완만하게 올라간다. 출처: CS 182 Discussion 11.
그림에서 빨간 판별기는 두 분포 사이에서 급격히 떨어지므로, 판별 정확도로만 보면 완벽하다. 하지만 주황 점들이 놓인 곳에서는 수평이므로 생성기가 따라갈 기울기가 없다. 초록 판별기는 기울기의 크기가 제한되어 있어 그렇게 급격히 떨어질 수 없고, 그 결과 실제 데이터에서 생성 데이터까지 긴 경사가 생긴다. 주황 점 위치에서도 경사가 0이 아니므로, 생성기는 판별기 출력을 키우는 방향, 즉 왼쪽(실제 데이터 쪽)으로 샘플을 옮기는 기울기를 받는다. 판별기의 표현력을 일부러 줄이는 것이 오히려 학습을 돕는 이유다.
Wasserstein 거리는 다음과 같다.
\[W(p, p_G) = \sup_{\lVert f \rVert_L \le 1} E_{X \sim p}[f(X)] - E_{\tilde{X} \sim p_G}[f(\tilde{X})]\]\(f\)는 1-Lipschitz 함수로 제한된다. 원래 WGAN은 \(f\)를 신경망 \(f_\phi\)로 근사하고 가중치 각 성분의 크기를 \(\epsilon\) 이하로 잘라 Lipschitz 제약을 건다. 이렇게 하면 어떤 \(K\)에 대해 \(K\)-Lipschitz가 보장되지만 \(K\)는 구조에 따라 달라 계산이 복잡하다. 기울기 벌점은 판별기 손실에 \(\lambda(\lVert \nabla_x f(x) \rVert_2 - 1)^2\)를 더해 기울기 노름이 1에 가깝도록 유도한다. 엄밀한 1-Lipschitz 보장은 아니지만 효과적이다. 스펙트럼 정규화는 1-Lipschitz를 엄밀하게 강제하며, 다음 문제가 그 근거다.
2. Lipschitz 함수의 합성
문제
\(f\)와 \(g\)가 각각 \(L_1\), \(L_2\)-Lipschitz이면 합성 \(f \circ g\)가 \(L_1 L_2\)-Lipschitz임을 증명하라.
풀이
\(y_1 = g(x_1)\), \(y_2 = g(x_2)\)라 하자. \(g\)가 \(L_2\)-Lipschitz이므로
\[\lVert y_1 - y_2 \rVert \le L_2 \lVert x_1 - x_2 \rVert\]이다. \(z_1 = f(y_1)\), \(z_2 = f(y_2)\)라 하면 \(f\)가 \(L_1\)-Lipschitz이므로
\[\lVert z_1 - z_2 \rVert \le L_1 \lVert y_1 - y_2 \rVert \le L_1 L_2 \lVert x_1 - x_2 \rVert\]이다. 따라서 \(f \circ g\)는 \(L_1 L_2\)-Lipschitz다. 귀납적으로 유한 개의 합성에도 확장된다.
스펙트럼 정규화로의 연결
일반적인 신경망은 \(f_n \circ \sigma \circ \cdots \circ \sigma \circ f_1\) 꼴이다. \(\sigma\)는 비선형 활성화, \(f_i\)는 \((W_i, b_i)\)로 정해지는 아핀 층이다. 위 결과에 따라 모든 \(f_i\)와 \(\sigma\)가 1-Lipschitz이면 네트워크 전체가 1-Lipschitz다.
- ReLU는 기울기가 0 또는 1인 조각별 선형 함수이므로 1-Lipschitz다.
- 아핀 층의 Lipschitz 상수는 편향 \(b_i\)와 무관하므로 \(g(x) = W_i x\)만 보면 된다.
선형 함수 \(g\)의 Lipschitz 상수는
\[\sup_{\lVert x \rVert_2 = 1} \lVert W_i x \rVert_2 = \sigma(W_i)\]로 \(W_i\)의 최대 특이값, 즉 스펙트럼 노름이다.
따라서 매 기울기 갱신 후 \(W_i \leftarrow W_i / \sigma(W_i)\)로 재정규화하면 각 선형 층, 나아가 네트워크 전체가 1-Lipschitz가 된다. 스펙트럼 노름은 비교적 간단하고 싸게 계산할 수 있다.
3. FGSM의 최적 섭동
문제
적대적 예제(adversarial example) 는 모델을 속이도록 고르거나 만든 입력이다. 흔한 형식화는 실제 이미지 \(x\)에 섭동 \(\delta\)를 더하되 \(\lVert \delta \rVert \le \epsilon\)으로 크기를 제한하는 것이다. 사람이 알아채지 못하고 “진짜” 레이블이 바뀌지 않게 하려는 의도다.
\[\delta^\ast = \arg\max_\delta \mathcal{L}_\theta(x + \delta, y) \quad \text{s.t.} \quad \lVert \delta \rVert \le \epsilon\]이미지에서는 \(\lVert \delta \rVert_\infty = \max_i \lvert \delta_i \rvert\)나 \(\lVert \delta \rVert_2\)를 주로 쓴다. 다만 실제 공격자는 이런 방식으로 섭동을 제한받지 않는 경우가 많아, 이 정의가 현실의 적대적 예제와 꼭 맞지는 않는다.
모델에 완전히 접근할 수 있는 화이트박스 공격에서는 \(\nabla_x \mathcal{L}_\theta(x, y)\)를 계산해 쌍대 경사 상승 같은 제약 최적화로 \(\delta^\ast\)를 찾을 수 있다. 더 간단한 FGSM(fast gradient sign method) 은 손실을 1차 근사한다.
\[\mathcal{L}'_\theta(x + \delta, y) \approx \mathcal{L}_\theta(x, y) + \nabla_x \mathcal{L}_\theta(x, y)^T \delta\]2-노름 제약에서는 최적해가 \(\delta^\ast = \epsilon\, \nabla_x \mathcal{L}_\theta / \lVert \nabla_x \mathcal{L}_\theta \rVert_2\)다. 선형 손실과 \(\infty\)-노름 제약에서 최적 섭동이 \(\delta^\ast = \epsilon\, \mathrm{sign}(\nabla_x \mathcal{L}_\theta(x, y))\)임을 보여라.
풀이
\(\delta \in \mathbb{R}^d\)에 대해 \(\infty\)-노름 제약은 \(d\)개의 독립된 제약 \(\lvert \delta_i \rvert \le \epsilon\)으로 쓸 수 있다. \(\mathcal{L}_\theta(x, y)\)는 상수이므로 문제는 다음과 같다.
\[\arg\max_\delta \nabla_x \mathcal{L}_\theta(x, y)^T \delta \quad \text{s.t.} \quad \lvert \delta_i \rvert \le \epsilon \;\; \text{for all } i\]기울기의 성분을 \(g_i\)라 하면 목적함수는 \(\sum_{i=1}^{d} g_i \delta_i\)이므로 분리 가능(separable) 하다. 각 좌표를 독립적으로 최적화하면 된다.
각 차원에서 \(g_i \delta_i\)는 구간 \([-\epsilon, \epsilon]\) 위의 선형 함수다. \(g_i > 0\)이면 기울기가 양수이므로 최댓값은 \(\delta_i = \epsilon\), \(g_i < 0\)이면 \(\delta_i = -\epsilon\)에서 얻는다. 따라서 최적 섭동은 모든 좌표의 크기가 \(\epsilon\)이고 부호가 편미분 \(g_i\)의 부호와 같다.
\[\delta^\ast = \epsilon\, \mathrm{sign}(\nabla_x \mathcal{L}_\theta(x, y))\]블랙박스 공격과 방어
FGSM은 매우 빠르고 편리하며 표준 신경망에 잘 통하지만, 간단한 방어로 막힐 수 있다.
모델 내부에 접근할 수 없는 블랙박스 공격에서는 두 방법이 있다. 하나는 유한 차분으로 기울기를 추정하는 것이다. 미분의 정의 \(f'(x) = \lim_{\epsilon \to 0} (f(x + \epsilon) - f(x))/\epsilon\)처럼 입력의 각 차원을 조금씩 바꿔 손실 변화를 질의하면, 적당한 수의 질의로 기울기를 근사할 수 있다. 다른 하나는 자신의 모델을 학습해 화이트박스 공격을 하고, 그 적대적 이미지로 대상 모델을 공격하는 것이다. 두 모델의 입력 기울기가 비슷하면 잘 통한다.
방어의 흔한 방법은 적대적 학습(adversarial training) 으로, 강건 손실을 최소화한다.
\[\theta^\ast = \arg\min_\theta \sum_{(x, y) \in \mathcal{D}} \max_{\lVert \delta \rVert \le \epsilon} \mathcal{L}_\theta(x + \delta, y)\]단점도 있다. 매 스텝마다 공격을 계산해야 해 학습이 느려지고, 깨끗한 데이터에서의 정확도가 떨어지는 경우가 많으며, 특정 섭동 제약에 대한 강건성이 다른 섭동으로 일반화되지 않을 수 있다.
4. 다른 섭동에 대한 강건성
문제
이미지에 정지 표지판이 있는지 분류하는 모델을 낮에 찍은 이미지로만 학습했다. \(\lVert \delta \rVert_\infty \le 0.5\)인 섭동에 대해 적대적 학습을 했고, 이 섭동에 대해 강건하게 잘 일반화함을 확인했다. 다음 중 어느 섭동 집합에도 강건하다고 기대할 수 있는가?
- \[\{\delta : \lVert \delta \rVert_\infty \le 0.1\}\]
- \[\{\delta : \lVert \delta \rVert_\infty \le 1.0\}\]
- \[\{\delta : \lVert \delta \rVert_2 \le 0.5\}\]
- \[\{\delta : \lVert \delta \rVert_2 \le 1.0\}\]
- 조명이 훨씬 어두운 밤에 찍은 정지 표지판 이미지
풀이
답은 1과 3이다. 판단 기준은 새 섭동 집합이 학습한 집합 \(\{\delta : \lVert \delta \rVert_\infty \le 0.5\}\)에 포함되는지다.
- 1: \(\lVert \delta \rVert_\infty \le 0.1\)인 집합은 학습한 집합에 엄격히 포함된다. 더 큰 집합에서 강건하면 그 부분집합에서도 강건하다.
- 2: 학습한 집합보다 크다. 검증한 것보다 심한 섭동이 허용되므로 모델을 속일 수 있다.
- 3: 모든 \(\delta\)에 대해 \(\lVert \delta \rVert_\infty = \max_i \lvert \delta_i \rvert \le \sqrt{\sum_i \delta_i^2} = \lVert \delta \rVert_2\)다. 따라서 \(\lVert \delta \rVert_2 \le 0.5\)이면 \(\lVert \delta \rVert_\infty \le 0.5\)이고, 이 집합은 학습한 집합에 포함된다.
- 4: 예를 들어 한 좌표만 1.0인 \(\delta\)는 \(\lVert \delta \rVert_2 = 1.0\)이지만 \(\lVert \delta \rVert_\infty = 1.0 > 0.5\)다. 학습 때 허용되지 않은 섭동을 포함하므로 보장할 수 없다.
- 5: 밤의 어두운 조명은 \(\infty\)-노름으로 재면 이미지를 크게 바꿀 수 있다. 일반적으로 자연스러운 분포 이동을 노름 제약 같은 정확한 수학적 형식으로 옮기기는 어렵다.
정리
- 최적 판별기는 \(D^\ast(x) = p(x)/(p(x) + p_G(x))\)이고, 이를 대입하면 생성기 목적함수는 \(2 D_{\mathrm{JS}}(p \lVert p_G) - \log 4\)가 된다.
- 완벽한 판별기는 생성 데이터 위에서 평평해 기울기를 주지 못한다. Lipschitz 제약(WGAN, 기울기 벌점, 스펙트럼 정규화), LSGAN, instance noise는 더 유용한 학습 신호를 준다.
- Lipschitz 상수는 합성에서 곱해지므로, ReLU 네트워크의 각 가중치를 스펙트럼 노름으로 나누면 전체가 1-Lipschitz가 된다.
- 선형 손실과 \(\infty\)-노름 제약에서 문제는 좌표별로 분리되어 FGSM 해 \(\epsilon\, \mathrm{sign}(\nabla_x \mathcal{L})\)가 나온다.
- 적대적 학습의 강건성은 학습한 섭동 집합의 부분집합에만 보장된다. \(\lVert \delta \rVert_\infty \le \lVert \delta \rVert_2\)이므로 같은 반지름의 \(\ell_2\) 공은 \(\ell_\infty\) 공 안에 있지만, 자연스러운 분포 이동은 노름 공으로 잘 표현되지 않는다.