- UC Berkeley CS 182 (Spring 2021) 10강 정리
- 강의: Sergey Levine
- 관련 Discussion: Discussion 6
가변 길이 입력과 순환 신경망 (RNN)
가변 길이 입력이라는 문제
지금까지 다룬 네트워크는 고정된 크기의 입력 \(x\)를 받아 출력 \(y\)를 낸다. 그러나 많은 문제에서 입력은 길이가 정해지지 않은 시퀀스(sequence) 다.
- 문장(단어의 시퀀스)의 감정(sentiment)을 분류한다.
- 소리의 시퀀스에서 음소(phoneme)를 인식한다.
- 이미지의 시퀀스인 동영상에서 행동(activity)을 분류한다.
가장 단순한 방법은 가장 긴 시퀀스의 길이에 맞춰 나머지를 0으로 채우는 제로 패딩(zero-padding) 이다. 매우 간단하고 급할 때는 쓸 만하지만, 시퀀스가 아주 길어지면 첫 층이 감당해야 할 입력이 지나치게 커져 확장성이 떨어진다.
층마다 입력을 하나씩
다른 발상은 시퀀스의 원소를 층마다 하나씩 넣는 것이다. 첫 층은 \(x_1\)을, 둘째 층은 이전 층의 활성값과 \(x_2\)를 함께 받는 식이다. 이렇게 하면 짧은 시퀀스에서 “빈” 층을 어떻게 처리하느냐는 질문이 생긴다.
답은 층의 개수 자체를 가변으로 만드는 것이다. 시퀀스가 길이 \(T\)이면 마지막 \(T\)개의 층만 사용하고, 그 앞의 층은 무시한다(첫 활성값을 \(a^{(0)} = 0\)으로 둔다). 이 방식의 장점은 다음과 같다.
- 항상 최대 길이까지 패딩하는 것보다 효율적이다.
- 시퀀스 전체를 한 번에 받는 거대한 첫 층보다 각 층이 훨씬 작다.
- 시퀀스가 짧을수록 계산해야 할 층이 적다.
단점은 층마다 다른 가중치 행렬을 두면 가중치 행렬의 수가 최대 시퀀스 길이에 비례해 늘어난다는 것이다.
가중치 공유: RNN
해결책은 모든 층이 같은 가중치 행렬을 공유 하는 것이다. 각 층은 다음과 같이 계산한다.
\[\bar{a}_{t-1} = \begin{bmatrix} a_{t-1} \\ x_t \end{bmatrix}, \qquad z_t = W \bar{a}_{t-1} + b, \qquad a_t = \sigma(z_t)\]이것이 순환 신경망(recurrent neural network, RNN) 이다. “가변 깊이(variable-depth)” 네트워크라고 불러도 무방하다.
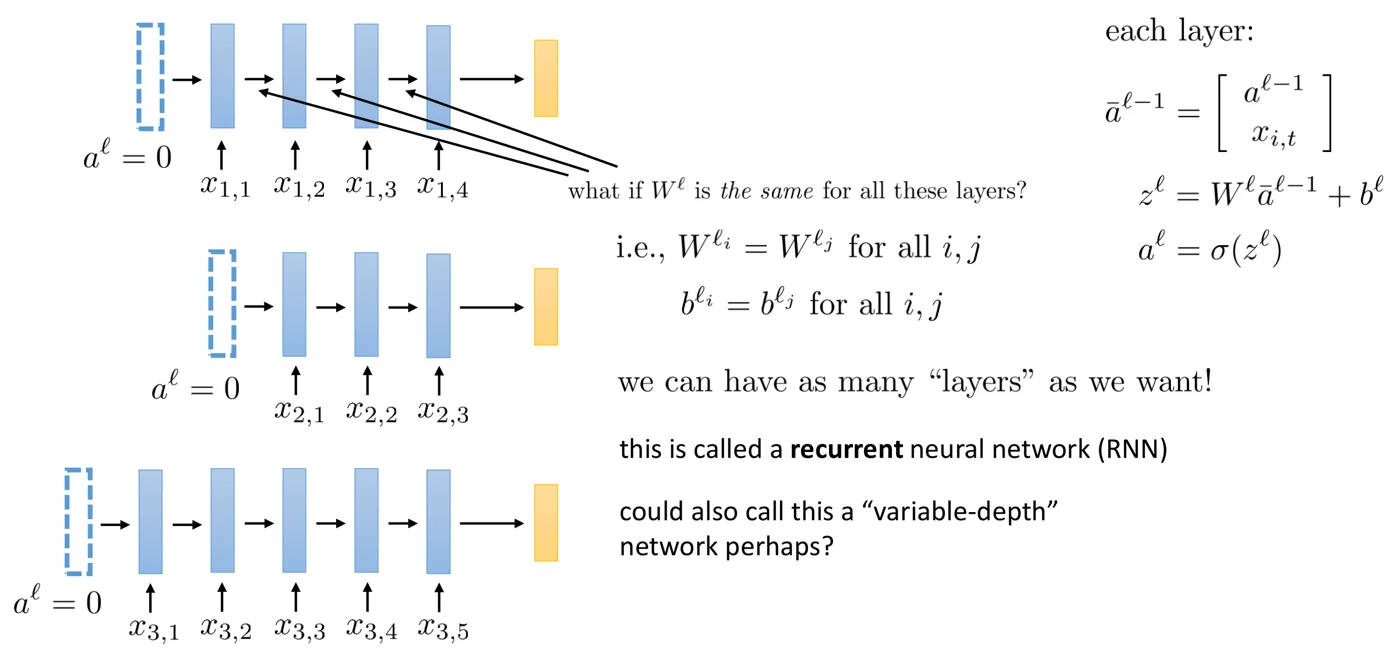 길이가 4, 3, 5인 세 시퀀스를 각각 4, 3, 5개의 층으로 처리하되, 모든 층이 같은 \(W, b\)를 쓴다. 첫 활성값은 \(a = 0\)이다. 출처: CS 182 Lecture 10 slides.
그림의 세 줄은 서로 다른 학습 예 \(x_1, x_2, x_3\)이다. 파란 막대 하나가 층 하나이고, 각 층은 왼쪽 층의 활성값과 아래에서 들어오는 시퀀스 원소 \(x_{i,t}\)를 이어 붙인 \(\bar{a}\)를 받는다(오른쪽 위의 식). 점선 상자는 존재하지 않는 “0번째 층”으로, 그 출력을 0으로 두어 첫 층이 이전 정보 없이 시작하게 한다. 마지막 층의 활성값은 노란 막대(예: 분류기)로 들어간다.
첫 줄의 긴 화살표들이 가리키듯, 네 층의 가중치를 모두 같은 것으로 묶으면 파라미터의 수는 시퀀스 길이와 무관해진다. 그러면 둘째 줄처럼 3층으로 쓰든 셋째 줄처럼 5층으로 쓰든 같은 파라미터로 처리할 수 있고, 원하는 만큼 “층”을 늘릴 수 있다.
교과서에서는 흔히 RNN을 “자기 자신의 이전 값을 입력으로 받는 고리가 달린 층”으로 그리고, “RNN은 신경망을 시간 축으로 확장한 것”이라고 설명한다. 틀린 말은 아니지만 RNN을 실제보다 신비롭게 보이게 한다. 강의의 관점은 더 단순하다. RNN은 여러 층에 걸쳐 가중치를 공유하고, 각 층에서 입력을 하나씩 받으며, 층의 개수가 가변인 신경망일 뿐이다.
RNN의 학습: 기울기 누적
RNN도 역전파(backpropagation)로 학습한다. 순전파에서 모든 \(a^{(i)}\)와 \(z^{(i)}\)를 계산하고, 역전파에서 \(\delta = d\mathcal{L}/dz^{(n)}\)으로 시작해 끝에서 처음 방향으로 각 함수 \(f\)(입력 \(x_f\), 파라미터 \(\theta_f\))를 지나간다.
주의할 점은 파라미터 기울기를 덮어쓰면 안 되고 누적해야 한다 는 것이다. \(W, b\)가 모든 층에서 같으므로, 층 \(\ell-1\)의 기울기가 층 \(\ell\)의 기울기를 덮어쓰면 틀린 결과가 나온다. 따라서 역전파 갱신은 다음과 같다.
\[\frac{d\mathcal{L}}{d\theta_f} \mathrel{+}= \frac{df}{d\theta_f}\delta, \qquad \delta \leftarrow \frac{df}{dx_f}\delta\]이것이 맞다는 것은 연쇄 법칙(chain rule)으로 확인할 수 있다. \(f(x) = g(x, h(x))\)처럼 같은 변수 \(x\)가 두 경로로 들어가면
\[\frac{d}{dx} f(x) = \frac{\partial g}{\partial x} + \frac{dh}{dx}\frac{\partial g}{\partial h}\]이다. 첫 항은 첫째 인자를 통한 미분, 둘째 항은 둘째 인자를 통한 미분이다. RNN의 \(W\)도 여러 층에서 쓰이므로, 각 사용처에서 온 기울기를 모두 더해야 한다.
가변 길이 출력
반대로 출력이 시퀀스인 문제도 있다.
- 이미지에 대한 텍스트 캡션(caption) 생성
- 미래 동영상 프레임의 시퀀스 예측
- 오디오 시퀀스 생성
이번에는 층마다 입력 대신 출력 이 하나씩 있다. 각 층의 활성값에 어떤 판독 함수(readout function), 즉 디코더(decoder) 를 적용해 \(\hat{y}_t\)를 낸다. 선형층 + softmax처럼 단순해도 된다. 각 출력은 자기 손실을 가지며, 전체 손실은 이들의 합이다.
그래프 구조의 역전파
출력이 층마다 있으면 계산 그래프가 더 이상 일렬이 아니다. 하나의 활성값 \(a_t\)가 다음 층 \(a_{t+1}\)과 디코더 출력 \(\hat{y}_t\) 두 곳으로 흘러간다.
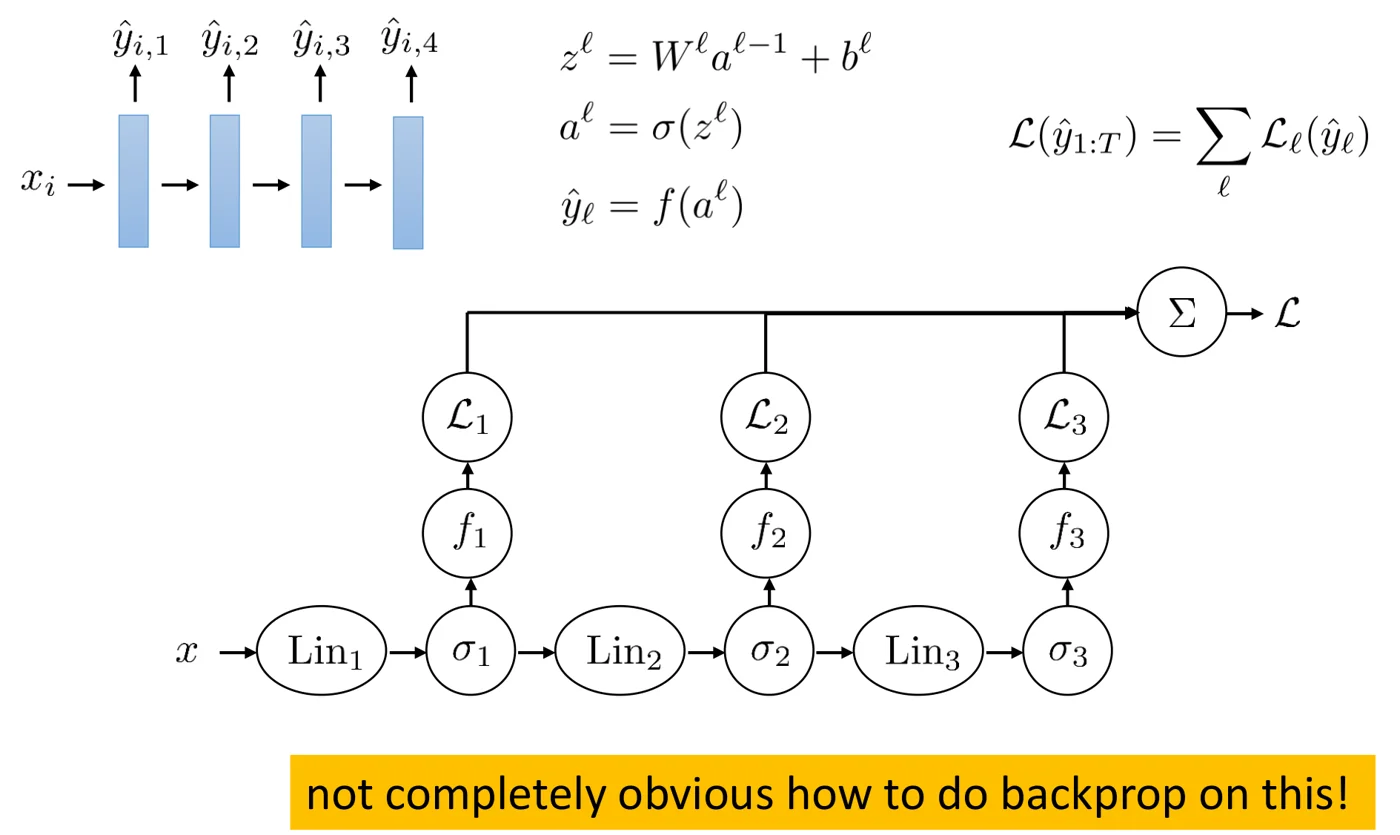 매 단계에 출력이 있는 RNN의 계산 그래프. 각 \(\sigma_t\)의 출력이 다음 선형층과 디코더 \(f_t\)로 갈라지고, 단계별 손실이 \(\Sigma\)에서 합쳐진다. 출처: CS 182 Lecture 10 slides.
그림 아래쪽의 가로줄 \(x \to \mathrm{Lin}_1 \to \sigma_1 \to \mathrm{Lin}_2 \to \cdots\)가 RNN의 본체이고, 각 \(\sigma_t\)에서 위로 올라가는 가지가 디코더 \(f_t\)와 손실 \(\mathcal{L}_t\)다. 전체 손실은 \(\mathcal{L} = \sum_t \mathcal{L}_t\)이다. 일렬 그래프에서는 노드마다 뒤에서 오는 델타가 하나뿐이었지만, 여기서 \(\sigma_1\)은 \(f_1\) 쪽과 \(\mathrm{Lin}_2\) 쪽 두 자손을 가진다. 따라서 \(\sigma_1\)에서의 기울기는 “자기 손실 \(\mathcal{L}_1\)을 통한 기울기”와 “이후 모든 단계의 손실을 통한 기울기”의 합이어야 한다.
역전파는 그래프의 끝에서 시작한다. \(\sigma_3\)은 자손이 \(f_3\) 하나이므로 그대로 계산되고, \(\mathrm{Lin}_3\)을 거쳐 \(\sigma_2\)로 온 델타는 \(f_2\) 쪽에서 온 델타와 더해진 뒤 다시 앞으로 전달된다. 이렇게 단계마다 두 갈래의 델타를 합치며 처음까지 거슬러 올라간다. 이런 그래프에서 역전파하는 규칙은 단순하다.
계산 그래프에서 자손(descendant)이 여럿인 노드는, 모든 자손에서 돌아오는 델타 벡터를 더한다.
이것을 역방향 자동 미분(reverse-mode automatic differentiation) 이라고도 한다. 앞의 기울기 누적과 같은 원리다.
매 단계의 입력과 출력
입력과 출력이 모두 매 단계에 있는 구조도 가능하다. 이미지 캡션 생성이나 번역이 그 예다. 캡션처럼 입력이 하나뿐인 문제에서도 매 단계 입력을 넣는 이유는 Part 3에서 다룬다(자기회귀 모델). 번역에는 이보다 훨씬 좋은 구조가 있으며, 다음 강의에서 다룬다.
RNN 학습의 어려움과 LSTM
RNN은 매우 깊은 네트워크다
시퀀스 길이가 1000이 넘으면, 역전파는 1000개가 넘는 층을 거치는 것과 같다. 역전파는 야코비안(Jacobian)을 계속 곱하는 과정이다. 많은 수를 곱하면 다음과 같은 일이 생긴다.
- 대부분의 수가 1보다 작으면 결과는 0으로 간다: 기울기 소실(vanishing gradients)
- 대부분의 수가 1보다 크면 결과는 무한대로 간다: 기울기 폭발(exploding gradients)
- 모든 수가 1에 가까울 때만 적절한 값이 나온다.
기울기 폭발은 기울기 클리핑(gradient clipping) 으로 어느 정도 막을 수 있다. 더 큰 문제는 기울기 소실이다. 직관적으로, 나중 단계의 기울기 신호가 앞 단계에 도달하지 못하므로 RNN이 시퀀스 앞부분의 정보를 “기억”하도록 학습할 수 없다.
더 나은 기울기 흐름
목표는 (앞서 초기화와 ResNet에서 본 것처럼) 기울기를 1 근처로 유지하는 것이다. 각 층을 다음과 같이 하나의 함수로 묶어 보자.
\[a_t = q(a_{t-1}, x_t)\]이를 “RNN 동역학(dynamics)”이라 하고, \(dq/da_{t-1}\)를 동역학 야코비안이라 한다. 기울기 흐름이 가장 좋은 경우는 다음과 같다.
\[\frac{dq}{da_{t-1}} \approx \mathbf{I}\]그러나 이것이 항상 좋은 것은 아니다. 무언가를 기억 하고 싶을 때만 좋고, 때로는 잊어야 한다. 그래서 각 유닛마다 “기억할지 덮어쓸지”를 결정하는 작은 신경 회로를 둔다.
- 기억할 때: 이전 활성값을 그대로 복사한다.
- 잊을 때: 현재 입력에 기반한 새 값으로 덮어쓴다.
이렇게 그대로 전달되는 값을 셀 상태(cell state), 기억과 망각을 조절하는 값을 망각 게이트(forget gate) 라 한다.
LSTM 셀
LSTM(long short-term memory) 셀은 이 아이디어를 구체화한 것이다. 셀 상태 \(a_t\)와 출력 \(h_t\) 두 가지를 다음 단계로 넘긴다. 먼저 이전 출력과 현재 입력에 하나의 선형 변환을 적용한다.
\[W \begin{bmatrix} h_{t-1} \\ x_t \end{bmatrix} + b = \begin{bmatrix} \bar{f}_t \\ \bar{i}_t \\ \bar{g}_t \\ \bar{o}_t \end{bmatrix}\]네 블록은 각각 \(h_{t-1}\)과 같은 차원의 벡터이므로, 이 출력은 단순 RNN 셀보다 4배 크다. 각 블록에 비선형성을 적용한다.
\[f_t = \sigma(\bar{f}_t) \in [0,1], \quad i_t = \sigma(\bar{i}_t) \in [0,1], \quad g_t = \tanh(\bar{g}_t) \in [-1,1], \quad o_t = \sigma(\bar{o}_t) \in [0,1]\]그다음 셀 상태와 출력을 갱신한다.
\[a_t = f_t \odot a_{t-1} + i_t \odot g_t, \qquad h_t = o_t \odot \tanh(a_t)\]여기서 \(\odot\)는 원소별 곱이다. \(f_t\)는 망각 게이트, \(i_t\)는 입력 게이트, \(g_t\)는 새로 쓸 후보 값, \(o_t\)는 출력 게이트다. 예측은 \(\hat{y}_t = \text{decoder}(h_t)\)로 낸다.
이 구조가 다소 임의적이라는 지적은 타당하다. 그러나 실제로는 잘 작동하며, 단순 RNN보다 훨씬 낫다.
LSTM이 더 잘 학습되는 이유
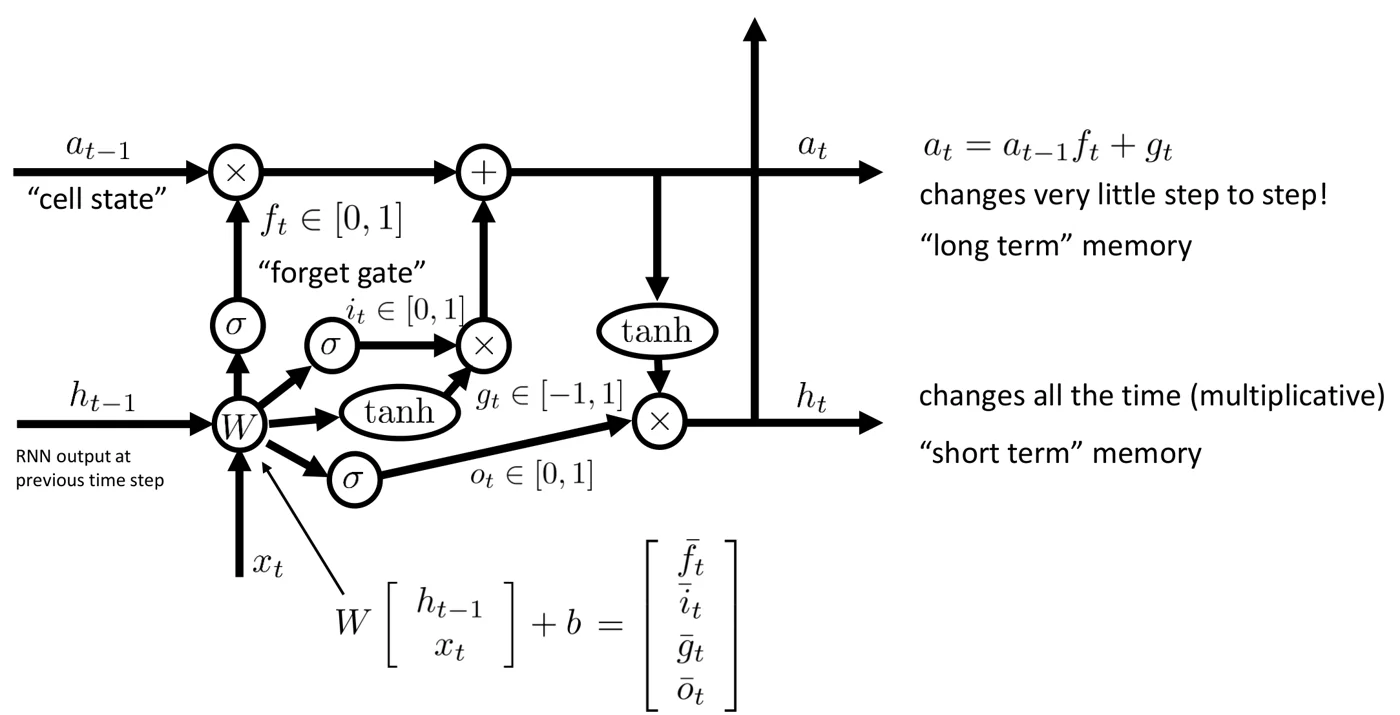 LSTM 셀의 회로. 위쪽 가로선이 셀 상태 \(a_t\)(장기 기억), 아래쪽 가로선이 출력 \(h_t\)(단기 기억)이며, \(W\)에서 나온 네 갈래가 게이트와 후보 값이 된다. 출처: CS 182 Lecture 10 slides.
그림을 아래쪽 \(W\) 노드부터 읽는다. \(h_{t-1}\)과 \(x_t\)가 \(W\)로 들어가 네 블록 \(\bar{f}_t, \bar{i}_t, \bar{g}_t, \bar{o}_t\)가 되고, 각각 \(\sigma\) 또는 tanh를 지난다. 위쪽 가로선에서는 \(a_{t-1}\)이 먼저 망각 게이트 \(f_t\)와 곱해지고(왼쪽 \(\times\)), 입력 게이트 \(i_t\)로 걸러진 후보 값 \(g_t\)가 더해진다(가운데 \(+\)). 슬라이드 오른쪽의 \(a_t = a_{t-1} f_t + g_t\)는 이 입력 게이트를 \(g_t\) 안에 포함시켜 줄여 쓴 것이다. 새 셀 상태는 tanh를 지나 출력 게이트 \(o_t\)와 곱해져(오른쪽 \(\times\)) \(h_t\)가 되고, \(h_t\)는 디코더와 다음 단계로 함께 나간다.
중요한 것은 위쪽 가로선 위에 곱셈 하나와 덧셈 하나만 있다는 점이다. 셀 상태가 한 단계를 지날 때 거치는 연산이 “게이트 값 곱하기”와 “더하기”뿐이므로, \(f_t\)가 1에 가까우면 값과 기울기가 거의 그대로 전달된다. 반면 아래쪽 경로의 \(h_t\)는 매 단계 행렬 곱과 비선형성을 다시 거친다.
셀 상태 \(a_t\)는 단계마다 아주 조금씩만 변한다. 갱신이 덧셈 위주이고, \(f_t \approx 1\)이면 \(\partial a_t / \partial a_{t-1} \approx \mathbf{I}\)이 되어 기울기가 잘 흐른다. 그래서 셀 상태는 장기(long-term) 기억 역할을 한다. 반면 \(h_t\)는 곱셈적으로 매 단계 크게 변하며 단기(short-term) 기억 역할을 한다. 이름 “long short-term memory”는 여기서 나온다.
실용적인 참고 사항
- 실제로는 RNN이 거의 항상 매 단계에 입력과 출력을 모두 가진다(이유는 Part 3).
- Part 1의 단순 RNN은 실제로는 거의 작동하지 않는다.
- LSTM은 많은 경우에 괜찮게 작동하며 단순 RNN보다 크게 낫다. 다만 완전연결망이나 합성곱 신경망보다 하이퍼파라미터 튜닝이 훨씬 많이 필요하다.
- 시퀀스에는 시간 축 합성곱(temporal convolution)이나 Transformer(시간 축 어텐션)처럼 더 나은 대안이 있으며, 뒤에서 다룬다.
- LSTM 셀은 구현이 번거롭지만, 한 번 구현하면 다른 층과 똑같이 쓸 수 있다.
- 더 단순하면서 비슷하게 잘 작동하는 변형으로 GRU(gated recurrent unit) 가 있다.
RNN의 활용
자기회귀 모델과 구조적 예측
실제로 쓰이는 RNN은 대부분 이전 단계의 출력을 다음 단계의 입력 으로 넣는다. 여러 출력을 내야 하는 문제는 대개 출력 사이에 강한 의존성이 있기 때문이다. 이런 문제를 구조적 예측(structured prediction) 이라 한다.
텍스트 생성 예를 보자. 학습 데이터가 다음 세 문장이라고 하자.
- I think therefore I am
- I like machine learning
- I am not just a neural network
첫 단어 “I” 다음에는 think, like, am이 각각 0.3, 0.3, 0.4 확률로 나온다. 둘째 단계에서도 각 단어가 비슷하게 퍼진 확률을 갖는다. 출력이 이전 출력에 의존하지 않는 모델이면, 각 단계에서 독립적으로 샘플링하므로 “I think machine just…” 같은 무의미한 문장이 나온다. 네트워크가 단계별 확률을 정확히 맞혔는데도 그렇다.
핵심 아이디어는 과거의 출력이 미래의 출력에 영향을 주어야 한다 는 것이다. “think”를 이미 샘플링했다면 다음 단계에서는 “therefore”의 확률이 0.8로 높아져야 한다. 그래서 샘플링한 출력을 다음 단계의 입력으로 넣는다. 이것이 자기회귀(autoregressive) 모델이다.
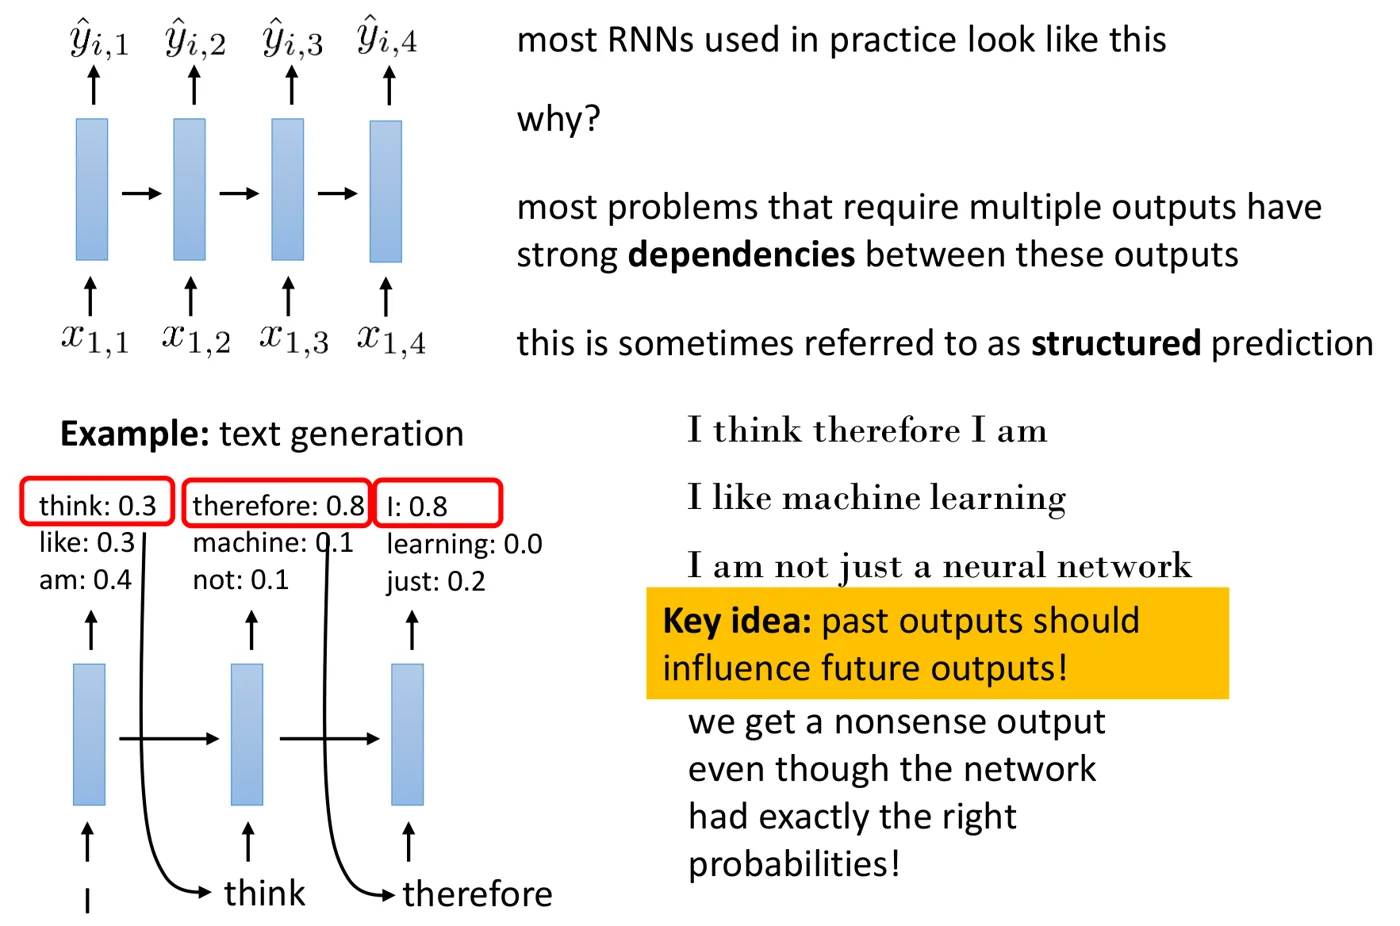 자기회귀 텍스트 생성. “I”를 넣어 think를 샘플링하고, think를 다음 입력으로 넣으면 therefore의 확률이 0.8로 높아진다. 출처: CS 182 Lecture 10 slides.
그림 아래쪽 예를 단계별로 따라가 보자. 첫 단계의 입력은 “I”이고, 출력 분포는 think 0.3, like 0.3, am 0.4다. 여기서 think를 샘플링했다고 하자(빨간 상자). 이 단어가 곡선 화살표를 따라 둘째 단계의 입력이 되므로, 네트워크는 “I think” 다음 단어의 분포를 계산하고, 학습 데이터에서 그 뒤에는 늘 therefore가 왔으므로 therefore에 0.8을 준다. 다시 therefore를 넣으면 셋째 단계에서 “I”가 0.8이 된다. 이렇게 앞에서 고른 단어가 뒤의 분포를 바꾸기 때문에 학습 데이터에 있던 문장이 일관되게 재현된다.
같은 네트워크라도 출력이 입력으로 되돌아가지 않으면, 각 단계는 학습 문장 세 개를 섞은 주변 분포만 알 수 있다. 그러면 각 단계에서 확률을 정확히 맞혔더라도 서로 다른 문장의 단어가 섞인 결과가 나온다. 그림 오른쪽의 “확률은 정확했는데도 무의미한 출력이 나온다”는 말이 이것이다.
학습의 기본 방법은 간단하다. 입력으로 학습 시퀀스 전체를 넣고, 정답 출력으로 같은 시퀀스를 한 단계 밀어서(offset by one) 쓴다. 그러면 네트워크는 “I think therefore I”를 보고 “am”을 내도록 학습된다.
분포 이동
이 방식에는 학습과 테스트 사이의 불일치가 있다. 학습 때 네트워크는 항상 진짜 시퀀스를 입력으로 보지만, 테스트 때는 자기 자신의 (틀릴 수도 있는) 예측 을 입력으로 받는다.
예를 들어 “I” 다음에 think 0.6, like 0.3, drive 0.1이라 하자. 운이 나빠 확률은 낮지만 가능한 “drive”를 샘플링하면, 모델은 학습 중 “I drive”를 본 적이 없으므로 완전히 혼란에 빠진다. 다음 단어로 hippo, paintbrush 같은 엉뚱한 단어가 나온다. 단 한 번의 무작위 실수가 이후 출력 전체를 망칠 수 있다.
입력 분포가 학습 때의 진짜 문자열에서 테스트 때의 합성 문자열로 바뀌므로, 이를 분포 이동(distributional shift) 이라 한다.
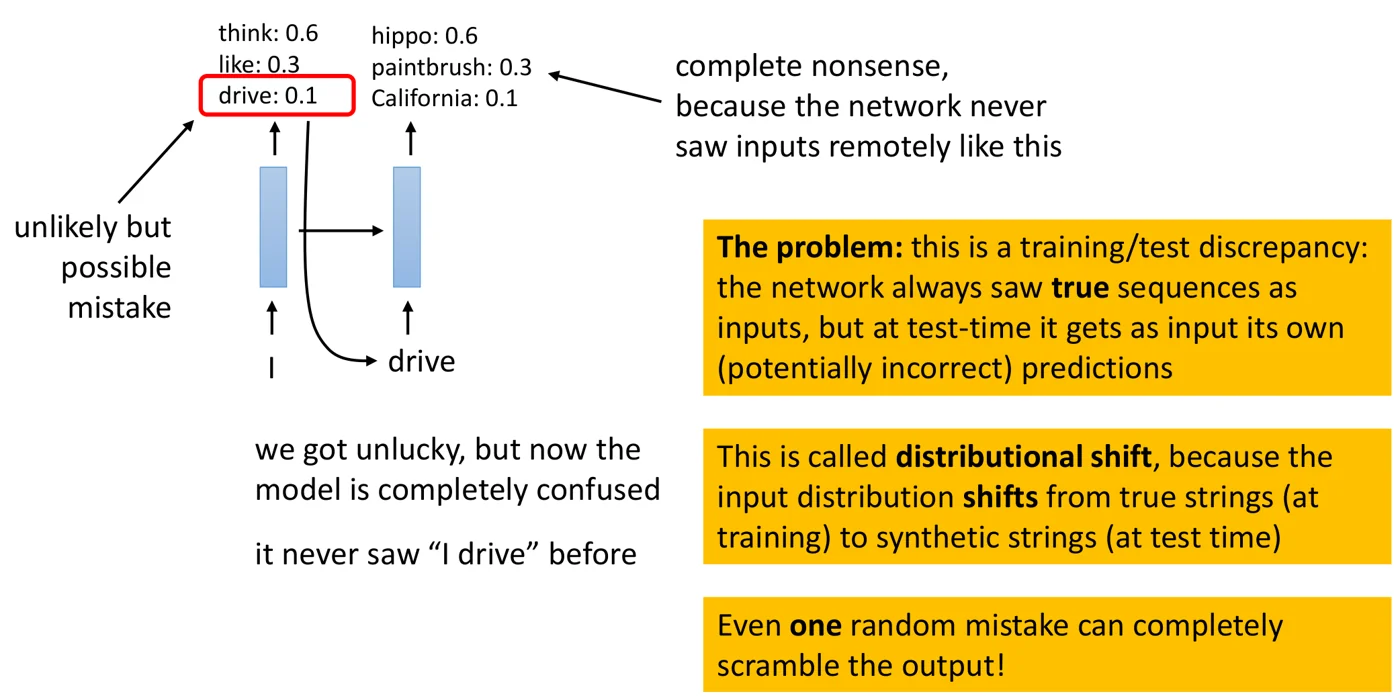 확률 0.1짜리 “drive”를 한 번 샘플링하면, 네트워크는 학습 중 본 적 없는 “I drive”를 입력으로 받아 hippo, paintbrush 같은 엉뚱한 분포를 낸다. 출처: CS 182 Lecture 10 slides.
그림 왼쪽의 첫 단계 분포 자체는 합리적이다. think가 0.6으로 가장 높고 drive는 0.1에 불과하다. 하지만 샘플링을 하는 한 열 번에 한 번은 drive가 뽑힌다. 이 단어가 다음 입력으로 들어가는 순간, 네트워크는 학습 분포 밖의 입력을 받는다. 학습 중에는 항상 정답 문장의 앞부분만 입력으로 보았으므로 “I drive” 다음에 무엇이 와야 하는지 배운 적이 없고, 둘째 단계의 출력은 아무 의미 없는 단어들에 확률을 준다. 그 단어가 다시 입력이 되면 상황은 더 나빠진다.
이 현상의 본질은 오류가 누적된다는 점이다. 각 단계의 실수 확률이 작아도, 한 번 실수하면 이후 입력이 모두 학습 분포에서 벗어나므로 실수가 연쇄적으로 일어난다. 같은 구조의 문제가 14강의 모방 학습에서도 다시 등장한다.
스케줄드 샘플링
스케줄드 샘플링(scheduled sampling) (Bengio et al., 2015)은 강화학습의 오래된 기법을 RNN 학습에 적용한 것이다. 학습 중 각 단계에서 정답 토큰을 입력으로 줄지, 모델 자신의 이전 예측을 줄지 무작위로 정한다.
- 학습 초반에는 모델 예측이 대부분 엉터리이므로, 주로 정답 토큰을 넣는다.
- 학습 후반에는 주로 모델 자신의 예측을 넣어 분포 이동을 완화한다.
정답 토큰을 쓸 확률을 학습 진행에 따라 줄이는 스케줄(선형, 지수, 시그모이드 감소 등)을 사용한다.
RNN을 쓰는 여러 방식
입력과 출력의 형태에 따라 RNN의 쓰임이 나뉜다.
| 형태 | 예 |
|---|---|
| one-to-many | 이미지 캡션 생성 |
| many-to-one | 행동 인식 |
| many-to-many (입력 후 출력) | 기계 번역 |
| many-to-many (단계별 대응) | 프레임 단위 동영상 주석 |
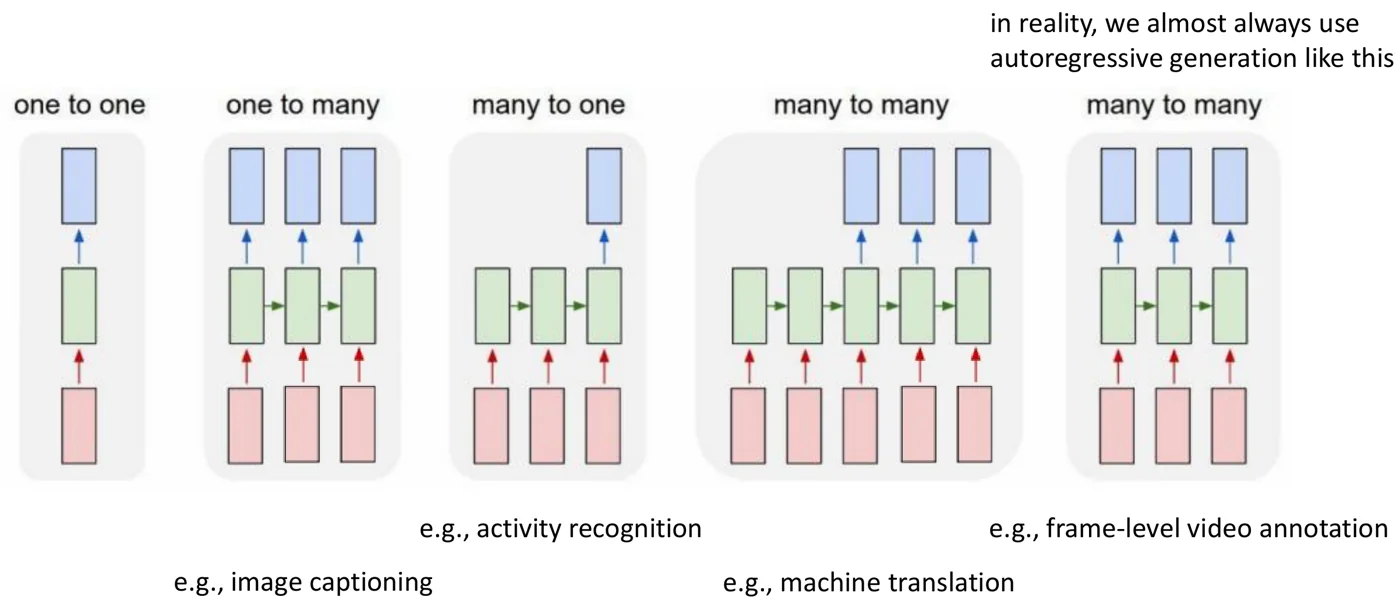 RNN의 입출력 형태. 빨강이 입력, 초록이 RNN 상태, 파랑이 출력이며, 초록 사이의 가로 화살표가 순환 연결이다. 출처: CS 182 Lecture 10 slides.
그림의 다섯 칸은 왼쪽부터 순환이 없는 일반 신경망(one to one), 하나의 입력에서 출력 시퀀스를 내는 경우(one to many, 이미지 캡션), 입력 시퀀스를 읽고 마지막에 하나만 내는 경우(many to one, 행동 인식), 입력을 모두 읽은 뒤 출력 시퀀스를 내는 경우(many to many, 기계 번역), 입력과 출력이 단계마다 대응하는 경우(many to many, 프레임 단위 주석)다. 넷째 칸에서 출력이 입력이 끝난 뒤에야 시작하는 것은, 번역에서는 문장을 끝까지 읽어야 첫 단어를 제대로 고를 수 있기 때문이다. 이 구조는 다음 강의의 seq2seq로 이어진다.
실제로는 거의 언제나 앞서 본 자기회귀 생성 방식을 함께 쓴다.
인코더, 디코더, 다층 RNN
- 입력을 RNN에 넣기 전에 (순환하지 않는) 인코더 로 처리할 수 있다. 이미지 입력에서 매우 흔하다(예: CNN으로 특징을 뽑아 RNN에 넣는다).
- 출력도 (순환하지 않는) 디코더 로 처리한 뒤 내보낼 수 있다. RNN 층을 더 쌓아도 되므로 상대적으로 덜 흔하다.
- RNN 층은 원하는 만큼 쌓을 수 있다.
- 합성곱 층도 순환하게 만들 수 있다. 선형 변환을 합성곱으로 바꾸면 각 “필터”가 작은 LSTM 셀이 된다(convolutional LSTM).
양방향 모델
음성 인식에서는 특정 시점의 단어를 나머지 발화를 듣지 않고 맞히기 어렵다. 예를 들어 끝까지 들어야 단어가 끝났는지 알 수 있다. 이럴 때는 정방향 RNN과 역방향 RNN을 함께 써서 각 시점이 과거와 미래를 모두 보게 하는 양방향(bidirectional) 모델을 쓴다. 기계 번역에서는 이 문제가 더 크지만, 그쪽에서는 조금 다른 모델(다음 강의의 seq2seq)을 쓴다.
예시
슬라이드는 Andrej Karpathy의 문자 단위 RNN 예시(셰익스피어 풍 텍스트, 위키피디아 마크업, LaTeX, 리눅스 소스 코드 생성 등)와 GPT-2의 생성 예를 보여 준다. GPT-2는 같은 자기회귀 원리를 쓰지만, 모델은 뒤에서 배울 Transformer다.
정리
- RNN은 여러 층에 걸쳐 가중치를 공유하고, 층마다 입력(과 출력)을 하나씩 가지며, 층의 개수가 가변인 신경망이다. “깊이 = 시간”으로 볼 수 있다.
- 가중치가 공유되므로 역전파에서 파라미터 기울기를 덮어쓰지 않고 누적한다. 자손이 여럿인 노드는 델타를 모두 더한다.
- 긴 시퀀스의 RNN은 매우 깊은 네트워크라 기울기 소실과 폭발이 심하다. 폭발은 클리핑으로, 소실은 구조로 해결한다.
- LSTM은 덧셈으로 갱신되는 셀 상태와 망각 게이트로 \(\partial a_t / \partial a_{t-1} \approx \mathbf{I}\)를 가능하게 해 장기 기억을 유지한다. GRU는 더 단순한 변형이다.
- 실제 RNN은 거의 항상 매 단계에 입력과 출력을 모두 가지는 자기회귀 모델이다. 출력 사이의 의존성(구조적 예측)을 표현하기 위해서다.
- 학습은 정답 시퀀스를 입력으로, 테스트는 자기 예측을 입력으로 하므로 분포 이동이 생긴다. 스케줄드 샘플링으로 완화한다.
- 인코더·디코더 결합, 다층 RNN, 합성곱 LSTM, 양방향 RNN 등 다양한 변형이 있다.