- UC Berkeley CS 182 (Spring 2021) 12강 정리
- 강의: Sergey Levine
- 관련 Discussion: Discussion 7
어텐션만으로 충분한가: 셀프 어텐션 (Self-Attention)
순환 연결이 꼭 필요한가
지난 강의의 어텐션은 디코더의 각 단계가 인코더의 모든 시간 단계에 접근하게 해 주었다. 그렇다면 순환 연결이 아직도 필요할까? 어텐션은 모든 시간 단계에 접근할 수 있으므로, 원리상 순환 연결이 하는 일을 모두 할 수 있고 그 이상도 할 수 있다. RNN을 순수하게 어텐션 기반 모델로 바꿀 수 있는지가 이번 강의의 질문이다.
몇 가지 문제를 해결해야 하는데, 가장 먼저 지난 강의의 어텐션은 여전히 순환하는 인코더와 디코더 위에서 작동한다는 점을 고쳐야 한다.
셀프 어텐션
각 입력 \(x_t\)를 먼저 공유된 가중치로 변환한다.
\[h_t = \sigma(W x_t + b)\](또는 다른 어떤 비선형 함수도 된다.) 그다음 각 위치에서 키, 쿼리, 값(value) 을 만든다.
\[k_t = k(h_t), \quad q_t = q(h_t), \quad v_t = v(h_t), \qquad \text{예: } k_t = W_k h_t,\; q_t = W_q h_t,\; v_t = W_v h_t\]이전 강의에서는 \(v(h_t) = h_t\)였지만, 이제는 값도 학습되는 변환을 거친다. 각 위치 \(l\)의 출력은 모든 위치에 대한 어텐션이다.
\[e_{l,t} = q_l \cdot k_t, \qquad \alpha_{l,t} = \frac{\exp(e_{l,t})}{\sum_{t'} \exp(e_{l,t'})}, \qquad a_l = \sum_t \alpha_{l,t}\, v_t\]이것은 순환 모델이 아니다. 그러나 모든 시간 단계에서 가중치(\(W, W_k, W_q, W_v\))를 공유한다는 점은 RNN과 같다. 가중치 공유가 왜 중요한지는 곧 보게 된다(가변 길이 입력을 처리할 수 있다).
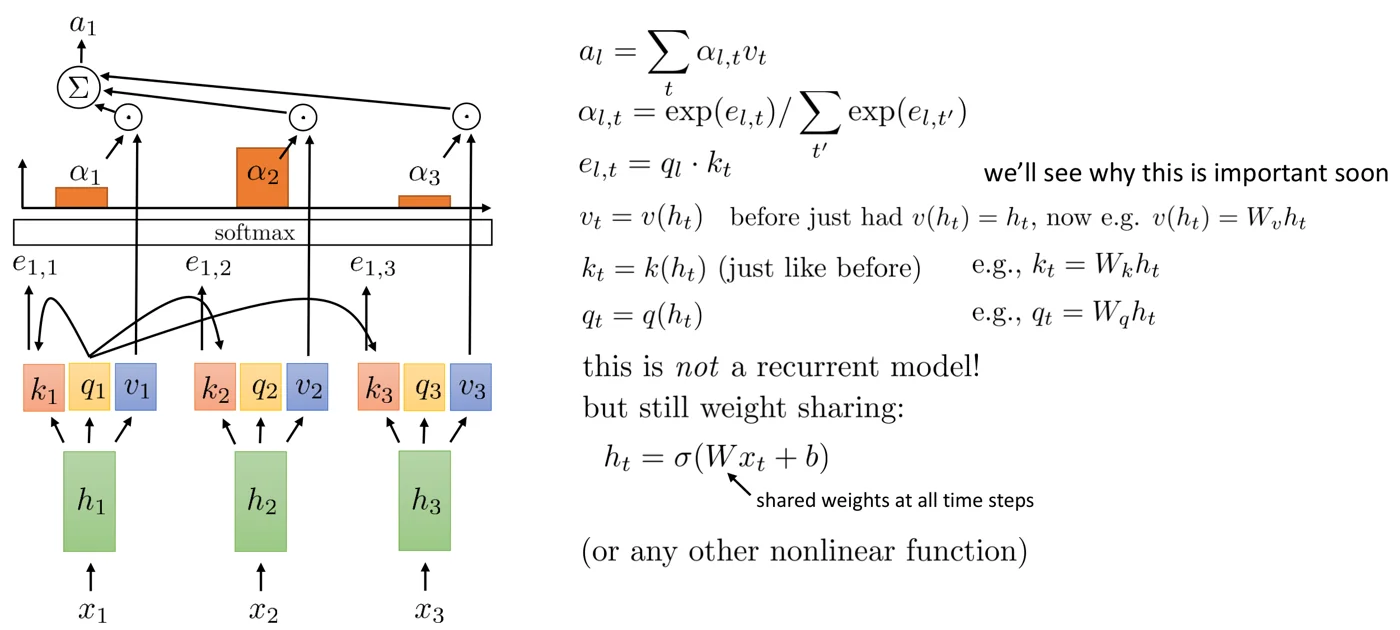 셀프 어텐션. 각 위치의 \(h_t\)에서 키·쿼리·값을 만들고, 위치 1의 쿼리 \(q_1\)을 모든 키와 비교해 얻은 가중치 \(\alpha\)로 값들을 더해 \(a_1\)을 만든다. 출처: CS 182 Lecture 12 slides.
그림은 출력 \(a_1\) 하나를 계산하는 과정을 보여 준다. 아래에서 각 입력 \(x_t\)가 같은 가중치로 \(h_t\)가 되고, 각 \(h_t\)에서 세 벡터 \(k_t\)(주황), \(q_t\)(노랑), \(v_t\)(파랑)가 나온다. 위치 1의 쿼리 \(q_1\)에서 뻗은 곡선이 \(k_1, k_2, k_3\) 각각과의 내적 \(e_{1,1}, e_{1,2}, e_{1,3}\)이다. softmax를 거친 막대그래프 \(\alpha_1, \alpha_2, \alpha_3\)이 각 값 \(v_t\)에 곱해지고(동그라미 안의 점), \(\Sigma\)에서 더해져 \(a_1\)이 된다.
지난 강의의 어텐션과 다른 점은 두 가지다. 첫째, 쿼리를 내는 쪽과 키·값을 내는 쪽이 같은 시퀀스이므로 “셀프” 어텐션이다. 둘째, 더하는 대상이 \(h_t\) 자체가 아니라 별도로 학습되는 값 \(v_t\)다. \(a_2, a_3\)도 \(q_2, q_3\)로 같은 계산을 하면 되며, 세 출력은 서로 의존하지 않으므로 동시에 계산할 수 있다.
셀프 어텐션 층 쌓기
출력 \(a_1, \dots, a_T\)를 다시 다음 셀프 어텐션 “층”의 입력으로 넣을 수 있다. 충분히 처리될 때까지 이를 반복하고, 마지막에 어떻게든 답으로 디코딩한다(뒤에서 다룬다).
Transformer로 가기 위해 필요한 것
셀프 어텐션의 기본 개념으로 Transformer 라는 매우 강력한 시퀀스 모델을 만들 수 있다. 그러나 실제로 작동하려면 근본적인 한계 네 가지를 해결하는 요소가 필요하다.
| 요소 | 해결하는 문제 |
|---|---|
| 1. 위치 인코딩(positional encoding) | 시퀀스 순서 정보가 없다 |
| 2. 멀티헤드 어텐션(multi-headed attention) | 한 층에서 여러 위치를 조회할 수 있게 한다 |
| 3. 비선형성 추가 | 지금은 각 층이 이전 층에 대해 선형이다 |
| 4. 마스크 디코딩(masked decoding) | 어텐션이 미래를 보지 못하게 한다 |
셀프 어텐션 기반 시퀀스 모델
1. 위치 인코딩
사람이 보는 문장은 “he hit me with a pie”다. 그러나 순수한 셀프 어텐션은 모든 위치를 대칭적으로 다루므로 단어의 집합 만 본다. “a pie hit me with he”, “he pie me with a hit”도 똑같이 보인다. 대부분의 재배열은 무의미하지만, 어떤 것은 뜻을 바꾼다. 일반적으로 문장에서 단어의 위치는 정보를 담고 있다.
그래서 처음에 각 표현에 시퀀스 내 위치를 알려 주는 정보를 더한다.
단순한 방법. 입력에 \(t\)를 그대로 덧붙인다: \(\bar{x}_t = [x_t;\, t]\). 좋은 방법이 아니다. 절대(absolute) 위치보다 상대(relative) 위치가 더 중요하기 때문이다. “I walk my dog every day”와 “every single day I walk my dog”에서 중요한 것은 “my dog”이 “I walk” 바로 뒤에 온다는 사실이지, 절대 위치가 아니다. 상대 위치가 비슷한 토큰들이 비슷한 위치 인코딩을 갖도록 해야 한다.
sin/cos 인코딩. 주파수 기반 표현을 쓴다. 위치 인코딩의 차원을 \(d\)라 하면
\[p_t = \begin{bmatrix} \sin(t / 10000^{2 \cdot 1/d}) \\ \cos(t / 10000^{2 \cdot 1/d}) \\ \sin(t / 10000^{2 \cdot 2/d}) \\ \cos(t / 10000^{2 \cdot 2/d}) \\ \vdots \\ \sin(t / 10000^{2 \cdot (d/2)/d}) \\ \cos(t / 10000^{2 \cdot (d/2)/d}) \end{bmatrix}\]이다. 위쪽 차원은 빠르게 진동해 “짝수/홀수 위치”를 가르는 지표처럼 작동하고, 아래쪽 차원은 느리게 변해 “앞쪽 절반/뒤쪽 절반”을 가르는 지표처럼 작동한다. 이진수의 각 자리와 비슷한 다중 해상도 표현이다.
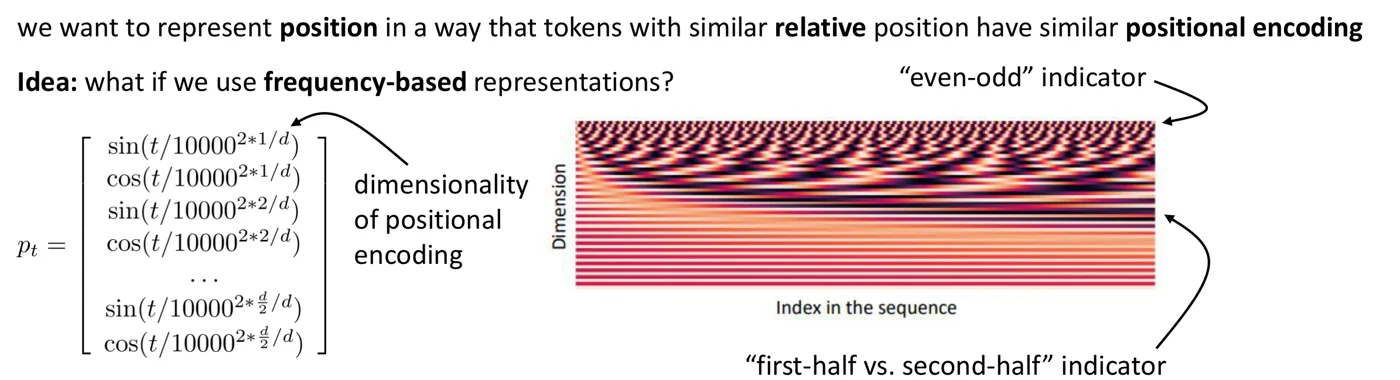 sin/cos 위치 인코딩을 그림으로 그린 것. 가로축은 시퀀스 안의 위치, 세로축은 인코딩의 차원이며, 위쪽 차원은 빠르게, 아래쪽 차원은 느리게 진동한다. 출처: CS 182 Lecture 12 slides.
오른쪽 그림의 한 세로줄이 한 위치 \(t\)의 위치 인코딩 벡터 \(p_t\)다. 위쪽 행들은 주파수가 높아 위치가 하나만 달라도 색이 바뀌므로, 오른쪽 위 화살표처럼 “짝수 위치인가 홀수 위치인가”에 가까운 정보를 준다. 아래로 내려갈수록 주파수가 낮아져, 맨 아래쪽 행들은 시퀀스 전체에 걸쳐 거의 한 번 변할 정도로 느리다. 이런 행은 “앞쪽 절반인가 뒤쪽 절반인가” 같은 거친 위치 정보를 준다.
이 표현에서는 가까운 위치일수록 대부분의 행에서 색이 비슷하므로, 인코딩 벡터도 서로 비슷하다. 또 sin과 cos의 덧셈 정리 때문에 \(p_{t+k}\)는 \(p_t\)의 선형 변환(각 주파수 쌍을 \(k\)에 비례하는 각도만큼 회전)으로 쓸 수 있어, 모델이 “몇 칸 떨어져 있는가”라는 상대 위치를 쉽게 표현할 수 있다.
학습된 위치 인코딩. 위치 인코딩 자체를 학습할 수도 있다. 입력 시퀀스마다 다른 것이 아니라, 모든 시퀀스에 같은 값을 쓰되 시간 단계마다 다른 값을 둔다. 학습할 값은 \(d \times T_{\max}\)개(차원 × 최대 시퀀스 길이)다.
- 장점: sin/cos보다 유연하고 더 최적일 수 있다.
- 단점: 조금 더 복잡하고, 최대 시퀀스 길이를 정해야 하며 그 이상으로 일반화하지 못한다.
위치 인코딩을 넣는 방법. 단순하게는 \(\bar{x}_t = [x_t;\, p_t]\)로 이어 붙인다. 더 흔하게는 입력을 임베딩한 뒤 더한다: \(h_t = \text{emb}(x_t) + p_t\). 여기서 \(\text{emb}\)는 학습되는 함수(예: 선형층과 비선형성으로 된 완전연결층)다.
2. 멀티헤드 어텐션
이제 전적으로 어텐션에 의존하므로, 한 번에 둘 이상의 시간 단계를 참조하고 싶을 수 있다. 그런데 softmax 때문에 어텐션은 대개 한 값이 지배한다. 예를 들어 문장의 주어와 목적어처럼 서로 다른 두 가지를 동시에 원한다고 지정하기 어렵다.
아이디어는 각 시간 단계마다 키, 쿼리, 값을 여러 개 두는 것이다. 헤드 \(i\)마다 가중치를 독립적으로 계산한다.
\[e_{l,t,i} = q_{l,i} \cdot k_{t,i}, \qquad \alpha_{l,t,i} = \frac{\exp(e_{l,t,i})}{\sum_{t'} \exp(e_{l,t',i})}, \qquad a_{l,i} = \sum_t \alpha_{l,t,i}\, v_{t,i}\]최종 어텐션 벡터는 헤드 출력을 이어 붙인 것이다: \(a_l = [a_{l,1};\, a_{l,2};\, \dots]\). 큰 모델에서는 헤드 8개 정도가 잘 작동하는 것으로 보인다.
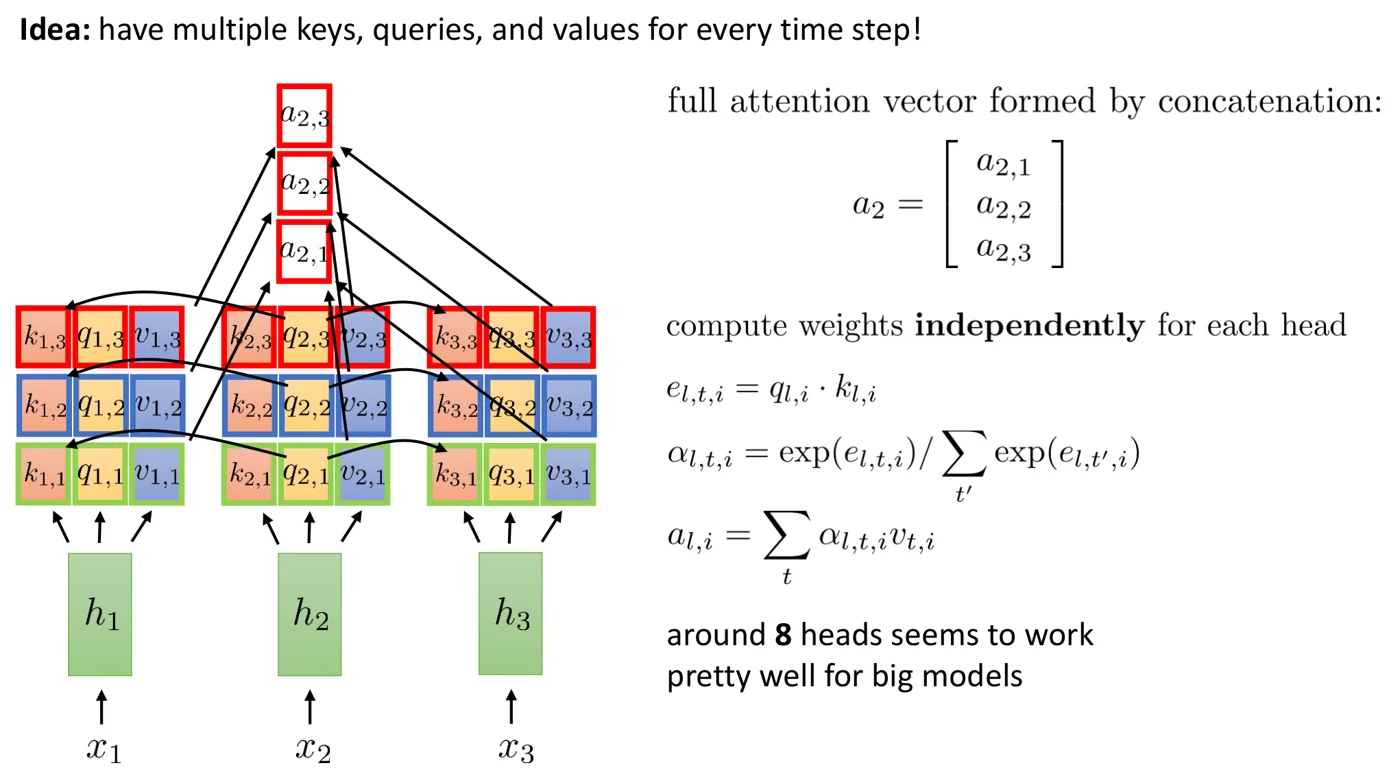 헤드가 3개인 멀티헤드 어텐션. 각 \(h_t\)에서 헤드마다 따로 \(k_{t,i}, q_{t,i}, v_{t,i}\)를 만들고(초록·파랑·빨강 테두리), 헤드별 어텐션 출력 \(a_{2,1}, a_{2,2}, a_{2,3}\)을 이어 붙여 \(a_2\)를 만든다. 출처: CS 182 Lecture 12 slides.
그림의 세 줄은 세 헤드다. 맨 아래 초록 테두리 줄이 헤드 1, 가운데 파란 테두리 줄이 헤드 2, 맨 위 빨간 테두리 줄이 헤드 3이다. 위치 2의 출력을 계산할 때, 헤드 1에서는 \(q_{2,1}\)이 같은 줄의 키 \(k_{1,1}, k_{2,1}, k_{3,1}\)과만 비교되고 같은 줄의 값으로만 가중합이 만들어져 \(a_{2,1}\)이 된다. 헤드 2와 3도 각자의 줄 안에서 같은 계산을 한다. 헤드마다 softmax가 따로 계산되므로, 헤드 1은 주어 쪽에, 헤드 2는 목적어 쪽에 집중하는 식으로 서로 다른 위치를 동시에 볼 수 있다.
맨 위의 빨간 상자 세 개가 헤드별 출력이고, 이를 세로로 이어 붙인 것이 오른쪽의 \(a_2\)다. 실제 구현에서는 헤드 수를 늘리는 만큼 헤드당 차원을 줄여(예: 512차원을 8개 헤드 × 64차원으로) 전체 계산량이 단일 헤드와 비슷하게 유지되도록 한다.
3. 비선형성 추가
\(k_t = W_k h_t\), \(q_t = W_q h_t\), \(v_t = W_v h_t\)인 셀프 어텐션의 출력을 다시 쓰면
\[a_l = \sum_t \alpha_{l,t} v_t = \sum_t \alpha_{l,t} W_v h_t = W_v \sum_t \alpha_{l,t} h_t\]이다. 즉 각 셀프 어텐션 “층”은 이전 층에 대한 선형 변환 이다(가중치 \(\alpha_{l,t}\) 자체는 비선형으로 정해지지만). 이것만 쌓으면 표현력이 부족하다.
해결책은 셀프 어텐션 층마다 각 위치에 같은 신경망을 따로 적용 하는 것이다.
\[h_l^{\text{next}} = \sigma(W a_l + b)\]이를 위치별 피드포워드 네트워크(position-wise feedforward network) 라고 부른다. 셀프 어텐션과 위치별 비선형 네트워크를 번갈아 쌓는다.
4. 마스크 디코딩
셀프 어텐션으로 거친 언어 모델을 만든다고 하자. 입력 \(y_1, y_2, y_3\)에서 다음 토큰 \(\hat{y}_2, \hat{y}_3, \hat{y}_4\)를 예측한다. 큰 문제가 있다. 단계 1의 셀프 어텐션은 단계 2, 3의 값을 볼 수 있는데, 그 값은 단계 2, 3의 입력에 기반한다. 테스트 때(디코딩할 때) 단계 2, 3의 입력은 단계 1의 출력으로 정해지므로, 단계 1의 출력을 내려면 단계 2, 3의 입력을 알아야 하는 모순이 생긴다. 셀프 어텐션은 과거는 볼 수 있어야 하지만 미래는 보면 안 된다.
해결책은 간단하다. 점수를 다음과 같이 바꾼다.
\[e_{l,t} = \begin{cases} q_l \cdot k_t & \text{if } l \geq t \\ -\infty & \text{otherwise} \end{cases}\]실제 구현에서는 softmax 안에서 \(l < t\)인 항의 \(\exp(e_{l,t})\)를 0으로 바꾸면 된다. 이것이 마스크 어텐션(masked attention) 이다.
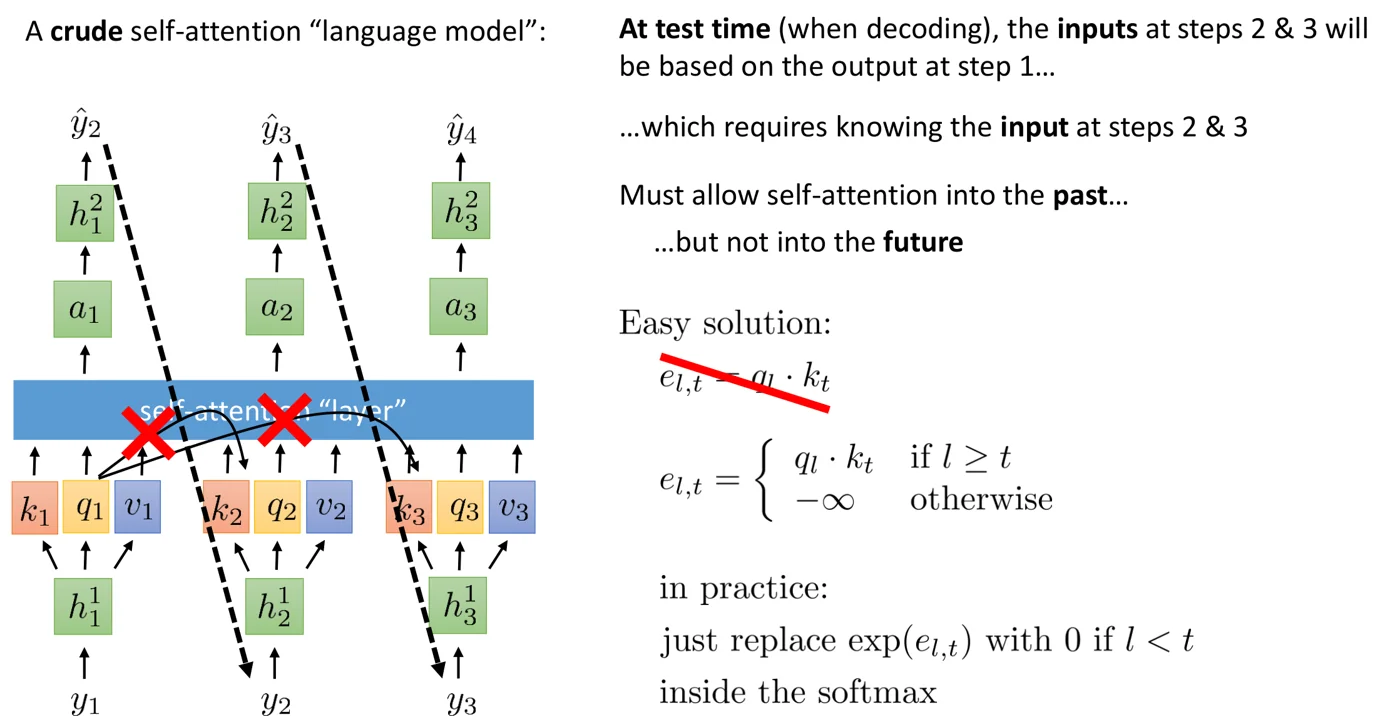 셀프 어텐션 언어 모델에서 위치 1의 쿼리 \(q_1\)이 미래 위치의 키 \(k_2, k_3\)를 보는 연결(빨간 X)을 막는다. 점선은 테스트 때 \(\hat{y}_2\)가 \(y_2\)로, \(\hat{y}_3\)이 \(y_3\)으로 되먹여지는 경로다. 출처: CS 182 Lecture 12 slides.
그림의 굵은 점선이 문제의 원인을 보여 준다. 테스트 때 \(\hat{y}_2\)(위치 1의 출력)는 샘플링되어 위치 2의 입력 \(y_2\)가 되고, \(\hat{y}_3\)은 위치 3의 입력 \(y_3\)이 된다. 그런데 마스크가 없으면 위치 1의 쿼리 \(q_1\)이 \(k_2, k_3\)와 그 값들을 참조하므로, \(\hat{y}_2\)를 계산하려면 아직 만들어지지 않은 \(y_2, y_3\)가 필요하다. 학습 때는 정답 시퀀스가 통째로 주어져 이 모순이 드러나지 않지만, 모델은 “다음 단어를 그냥 베끼는” 법을 배우게 되어 테스트 때 쓸모가 없어진다.
빨간 X처럼 \(l < t\)인 연결의 점수를 \(-\infty\)로 두면 softmax 후 가중치가 정확히 0이 되어 그 위치의 값이 전혀 섞이지 않는다. 위치 \(l\)의 출력은 위치 \(1, \dots, l\)의 입력에만 의존하게 되므로, 학습 때는 모든 위치를 한 번에 병렬로 계산하면서도 테스트 때의 순차 생성과 정확히 같은 계산을 하게 된다.
구현 요약
셀프 어텐션만으로 실용적인 시퀀스 모델을 만들 수 있다.
- 셀프 어텐션 층과 비선형 위치별 피드포워드 네트워크를 번갈아 쌓아 비선형 변환을 얻는다.
- 입력(또는 입력 임베딩)에 위치 인코딩을 넣어 토큰의 상대 위치를 알게 한다.
- 멀티헤드 어텐션을 쓴다.
- 디코딩에 쓸 모델이라면 마스크 어텐션을 쓴다.
Transformer
셀프 어텐션 기반 seq2seq
셀프 어텐션과 위치별 비선형 층을 연속으로 써서 시퀀스를 처리하는 모델 설계는 여러 가지가 있다. 각 층이 한 시퀀스를 다른 시퀀스로 “변환(transform)”하므로 이들을 통틀어 Transformer 라 부른다. “고전적인” Transformer(Vaswani et al., Attention Is All You Need, 2017)는 seq2seq 모델이며, BERT, GPT 같은 후속 연구는 Transformer를 언어 모델로 쓴다.
고전적인 Transformer의 구조
seq2seq RNN과 비교하면 다음과 같다.
인코더 (N번 반복):
- 위치별 인코더(입력 임베딩 + 위치 인코딩)
- 셀프 어텐션
- 위치별 비선형 네트워크
디코더 (N번 반복):
- 위치별 인코더(출력 토큰 임베딩 + 위치 인코딩)
- 마스크 셀프 어텐션
- 위치별 비선형 네트워크
- 크로스 어텐션(cross attention)
- 위치별 비선형 네트워크
마지막에 위치별 softmax로 각 위치의 다음 토큰 분포를 낸다.
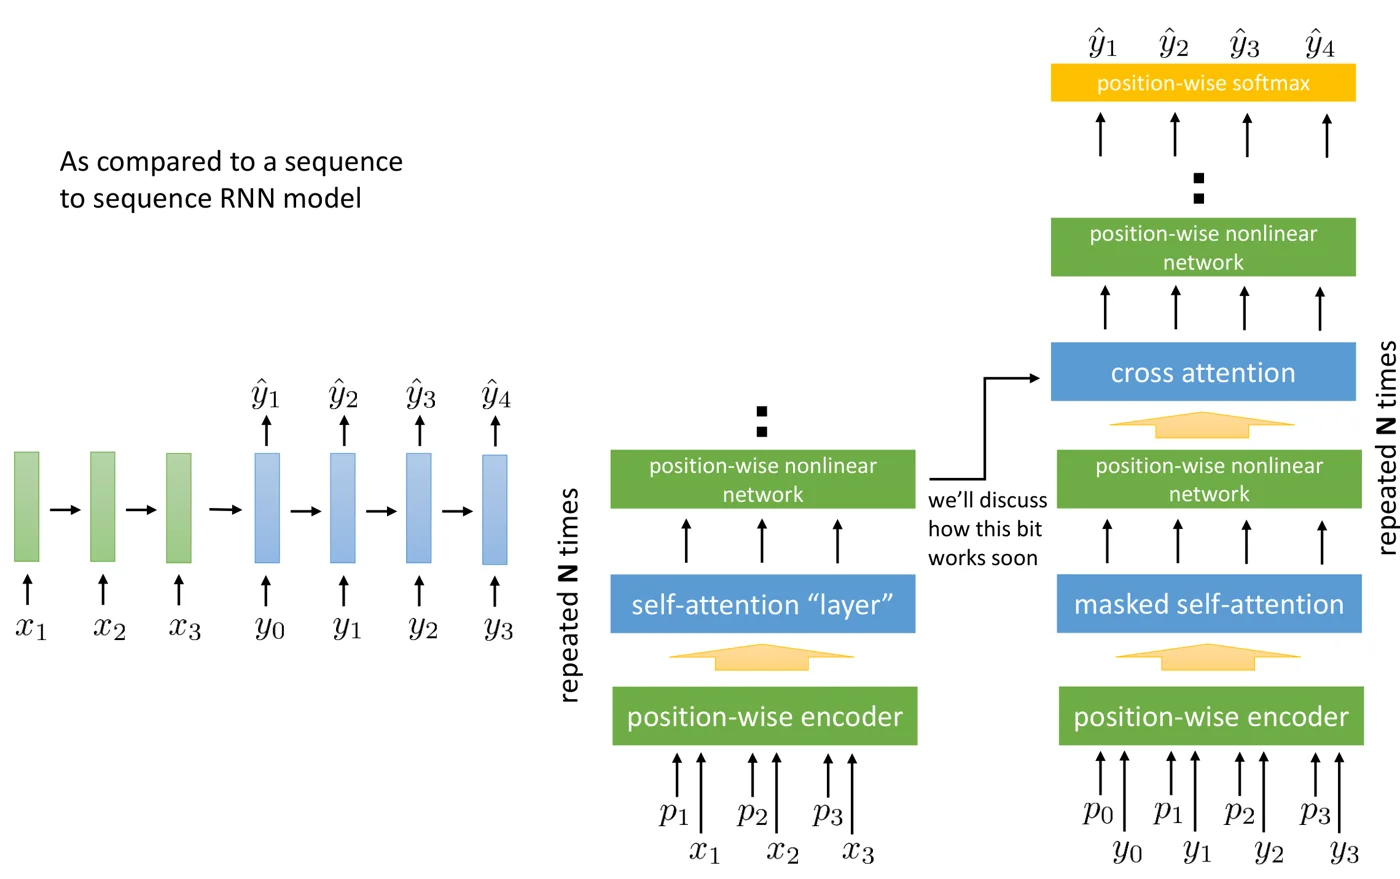 왼쪽은 seq2seq RNN, 가운데는 Transformer 인코더, 오른쪽은 디코더다. 각 블록은 N번 반복되며, 인코더의 출력이 디코더의 크로스 어텐션으로 들어간다. 출처: CS 182 Lecture 12 slides.
그림 왼쪽의 RNN은 인코더(초록)가 \(x_1, x_2, x_3\)를 읽고 디코더(파랑)가 \(y_0, y_1, \dots\)를 받아 \(\hat{y}_1, \hat{y}_2, \dots\)를 낸다. Transformer는 같은 입출력을 갖지만 순환 화살표가 없다. 가운데 인코더는 각 입력 \(x_t\)에 위치 인코딩 \(p_t\)를 더해 임베딩한 뒤(position-wise encoder), 셀프 어텐션과 위치별 비선형 네트워크를 번갈아 N번 거친다.
오른쪽 디코더는 오른쪽으로 한 칸 밀린 출력 \(y_0, y_1, y_2, y_3\)(\(y_0\)는 <START>)에 위치 인코딩을 더해 시작하고, 미래를 보지 않도록 마스크 셀프 어텐션을 쓴다. 그 위의 크로스 어텐션에서 인코더 쪽 화살표가 들어와 원문 정보를 가져오며, 다시 위치별 비선형 네트워크를 지난다. 이 묶음이 N번 반복된 뒤 위치별 softmax가 각 위치의 다음 토큰 \(\hat{y}_1, \dots, \hat{y}_4\)를 예측한다.
크로스 어텐션
인코더와 디코더의 값을 결합하는 부분이 크로스 어텐션 이다. 지난 강의의 표준 어텐션과 훨씬 비슷하다. 디코더 위치 \(l\)의 활성값으로 쿼리 \(q_l\)을 만들고, 인코더 최종 층의 활성값 \(h_t\)로 키 \(k_t\)와 값 \(v_t\)를 만든다.
\[e_{l,t} = q_l \cdot k_t, \qquad \alpha_{l,t} = \frac{\exp(e_{l,t})}{\sum_{t'} \exp(e_{l,t'})}, \qquad c_l = \sum_t \alpha_{l,t}\, v_t\]실제로는 크로스 어텐션도 멀티헤드다.
층 정규화
배치 정규화(batch normalization)는 매우 유용하지만 시퀀스 모델에서는 쓰기 어렵다.
- 시퀀스 길이가 서로 달라 배치 전체에 걸쳐 정규화하기 어렵다.
- 시퀀스가 매우 길 수 있어 배치가 작아지기도 한다.
간단한 해결책은 층 정규화(layer normalization) 다. 배치 정규화와 같지만 배치 축이 아니라 한 샘플의 차원 축으로 정규화한다. 배치 정규화는 \(d\)차원 벡터 \(a_1, \dots, a_B\)에 대해
\[\mu = \frac{1}{B}\sum_{i=1}^{B} a_i, \quad \sigma = \sqrt{\frac{1}{B}\sum_{i=1}^{B}(a_i - \mu)^2}, \quad \bar{a}_i = \frac{a_i - \mu}{\sigma}\gamma + \beta\]로 \(d\)차원 \(\mu, \sigma\)를 구한다. 층 정규화는 벡터 하나 \(a\)의 서로 다른 차원 \(a_j\)에 대해
\[\mu = \frac{1}{d}\sum_{j=1}^{d} a_j, \quad \sigma = \sqrt{\frac{1}{d}\sum_{j=1}^{d}(a_j - \mu)^2}, \quad \bar{a} = \frac{a - \mu}{\sigma}\gamma + \beta\]로 스칼라(1차원) \(\mu, \sigma\)를 구한다. 배치 크기나 시퀀스 길이와 무관하게 계산된다.
모두 합치기
Vaswani et al.의 Transformer는 다음과 같이 구성된다.
- 멀티헤드 어텐션은 모든 헤드의 어텐션 출력을 이어 붙인다.
- 각 하위 층(sub-layer) 뒤에 잔차 연결(residual connection)과 층 정규화를 둔다: \(\text{LN}(x + \text{Sublayer}(x))\).
- 위치별 피드포워드 네트워크는 각 위치에 적용하는 2층 신경망이다.
- 인코더와 디코더 모두 6층, 은닉 차원 \(d = 512\)다.
- 디코더는 인코더와 같지만 셀프 어텐션이 마스크되어 있고, 멀티헤드 크로스 어텐션이 추가된다. 디코딩은 마스크 어텐션을 써서 한 번에 한 위치씩 한다.
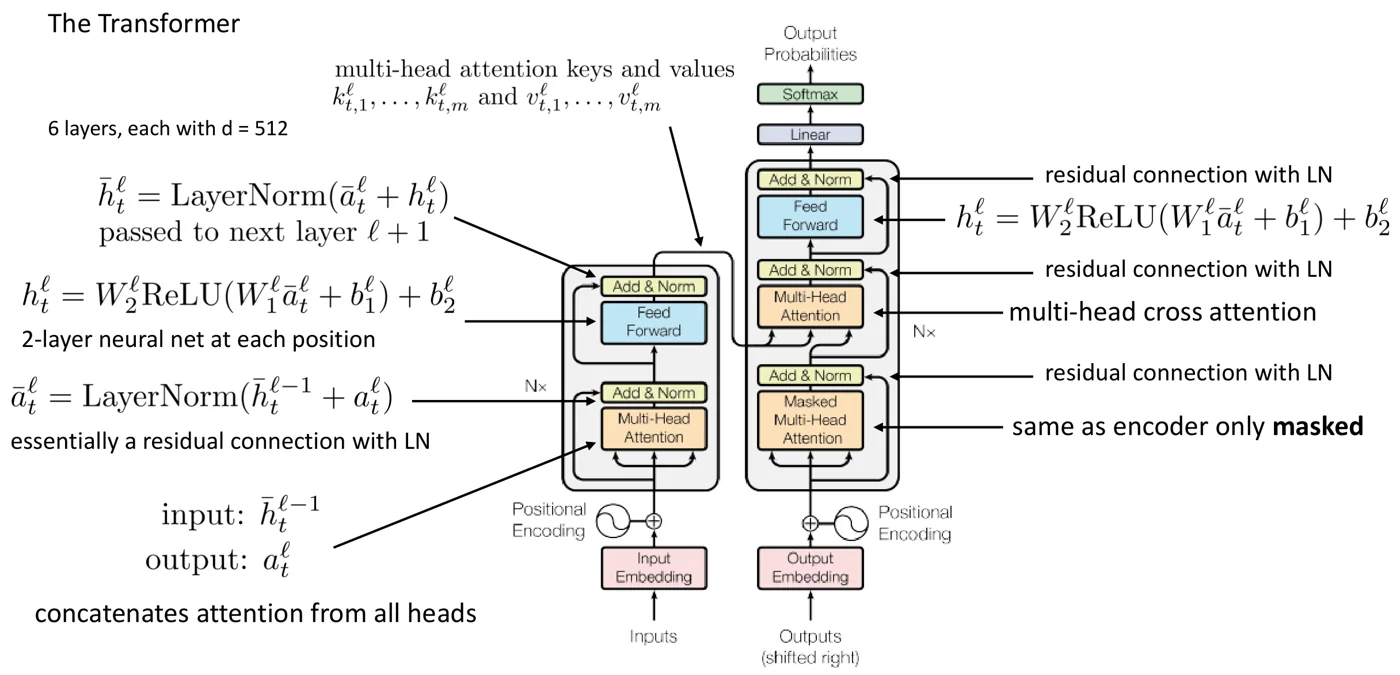 Vaswani et al.(2017)의 Transformer 구조도에 각 하위 층의 식을 붙인 것. 왼쪽 회색 상자가 인코더 층, 오른쪽이 디코더 층이며 각각 N번 쌓는다. 출처: CS 182 Lecture 12 slides.
인코더 층(왼쪽 회색 상자) 하나를 아래에서 위로 따라가면 식이 그대로 대응한다. 이전 층의 출력 \(\bar{h}^{\ell-1}_t\)가 Multi-Head Attention에 들어가 \(a^{\ell}_t\)가 나오고(모든 헤드를 이어 붙인 것), “Add & Norm”에서 입력과 더한 뒤 층 정규화해 \(\bar{a}^{\ell}_t = \mathrm{LayerNorm}(\bar{h}^{\ell-1}_t + a^{\ell}_t)\)를 만든다. 다음 Feed Forward가 위치별 2층 신경망 \(h^{\ell}_t = W^{\ell}_2 \mathrm{ReLU}(W^{\ell}_1 \bar{a}^{\ell}_t + b^{\ell}_1) + b^{\ell}_2\)이고, 다시 Add & Norm으로 \(\bar{h}^{\ell}_t = \mathrm{LayerNorm}(\bar{a}^{\ell}_t + h^{\ell}_t)\)가 되어 다음 층으로 넘어간다. 상자 옆으로 돌아가는 화살표들이 잔차 연결이다.
디코더 층(오른쪽)은 하위 층이 세 개다. 맨 아래 Masked Multi-Head Attention은 인코더의 셀프 어텐션과 같되 마스크가 있고, 가운데 Multi-Head Attention이 크로스 어텐션이다. 인코더 최종 출력에서 오는 화살표가 이 하위 층으로 들어가 키와 값이 되고, 쿼리는 디코더 쪽에서 나온다. 맨 위 Feed Forward는 인코더와 같다. 세 하위 층 모두 잔차 연결과 층 정규화로 감싸여 있으며, 마지막에 Linear와 Softmax가 다음 토큰의 확률을 낸다.
왜 Transformer인가
단점:
- 어텐션 계산이 엄밀히는 시퀀스 길이에 대해 \(O(n^2)\)다.
- 위치 인코딩 등 구현이 다소 복잡하다.
장점:
- 장거리 연결이 훨씬 좋다.
- 병렬화가 훨씬 쉽다(RNN처럼 시간 순서대로 계산할 필요가 없다).
- 실제로 RNN보다 훨씬 깊게(층을 많이) 만들 수 있다.
장점이 단점을 압도하며, 많은 경우 Transformer는 RNN과 LSTM보다 훨씬 잘 작동한다. 지난 10년간 가장 중요한 시퀀스 모델링 개선 중 하나라 할 만하다. 학습이 훨씬 빠르므로 같은 비용으로 더 큰 모델을 쓸 수 있고, 더 큰 모델은 더 좋은 성능으로 이어진다. 슬라이드는 번역(Vaswani et al., 2017)과 위키피디아 요약(Liu et al., 2018)에서 이전 최고 seq2seq 모델보다 좋은 결과를 보여 준다. 언어 모델로서 Transformer의 힘은 다음 강의에서 다룬다.
정리
- 셀프 어텐션은 각 위치에서 키, 쿼리, 값을 만들고 모든 위치에 어텐션한다. 순환 연결은 없지만 모든 시간 단계에서 가중치를 공유한다.
- 셀프 어텐션은 순서를 모르므로 위치 인코딩(sin/cos 또는 학습된 값)을 입력 임베딩에 더한다. 상대 위치가 비슷하면 인코딩도 비슷해야 한다.
- softmax는 한 위치에 집중하므로, 키·쿼리·값을 여러 개 두는 멀티헤드 어텐션으로 여러 위치를 동시에 참조한다.
- 셀프 어텐션 층은 값에 대해 선형이므로, 위치별 피드포워드 네트워크를 번갈아 넣어 비선형성을 더한다.
- 디코딩에 쓰려면 미래 위치의 점수를 \(-\infty\)로 두는 마스크 어텐션이 필요하다.
- Transformer는 인코더(셀프 어텐션 + FFN)와 디코더(마스크 셀프 어텐션 + 크로스 어텐션 + FFN)를 잔차 연결과 층 정규화로 묶은 seq2seq 모델이다.
- \(O(n^2)\) 비용에도 불구하고 장거리 의존성, 병렬화, 깊이에서 RNN보다 유리해 시퀀스 모델의 표준이 되었다.