- UC Berkeley CS 182 (Spring 2021) 18강 정리
- 강의: Sergey Levine
- 관련 Discussion: Discussion 10
잠재변수 모델과 변분 근사 (Variational Approximation)
잠재변수 모델의 일반형
잠재변수 모델(latent variable model)은 관측되지 않는 변수 \(z\)를 도입해 복잡한 분포 \(p(x)\)를 쉬운 분포들의 조합으로 표현한다.
\[p(x) = \int p(x \mid z)\, p(z)\, dz\]여기서 \(p(z)\)는 표준 가우시안 같은 “쉬운” 분포이고, \(p(x \mid z)\)도 “쉬운” 조건부 분포다. 예를 들어 신경망이 평균과 표준편차를 출력하는 조건부 가우시안 \(p(x \mid z) = \mathcal{N}(\mu_{\text{nn}}(z), \sigma_{\text{nn}}(z))\)를 쓴다. 두 쉬운 분포를 적분으로 묶으면 다봉(multimodal) 분포처럼 매우 복잡한 \(p(x)\)도 나타낼 수 있다.
로그우도 추정의 어려움
학습 목표는 데이터의 로그우도 \(\frac{1}{N}\sum_i \log p_\theta(x_i)\)를 최대화하는 것이다. 그러나 \(\log \int p_\theta(x_i \mid z) p(z) dz\)는 적분 때문에 직접 계산하기 어렵다.
한 가지 직관은 각 \(x_i\)에 대해 가장 그럴듯한 \(z\)를 “추측”하고, 그것이 정답인 것처럼 학습하는 것이다. 가능한 \(z\)가 여러 개이므로 분포 \(p(z \mid x_i)\) 전체를 사용하면 기대 로그우도(expected log-likelihood) 를 얻는다.
\[\theta \leftarrow \arg\max_\theta \frac{1}{N} \sum_i E_{z \sim p(z \mid x_i)}[\log p_\theta(x_i, z)]\]문제는 사후분포 \(p(z \mid x_i)\)를 어떻게 계산하느냐다. 이 계산을 확률적 추론(probabilistic inference) 이라 한다.
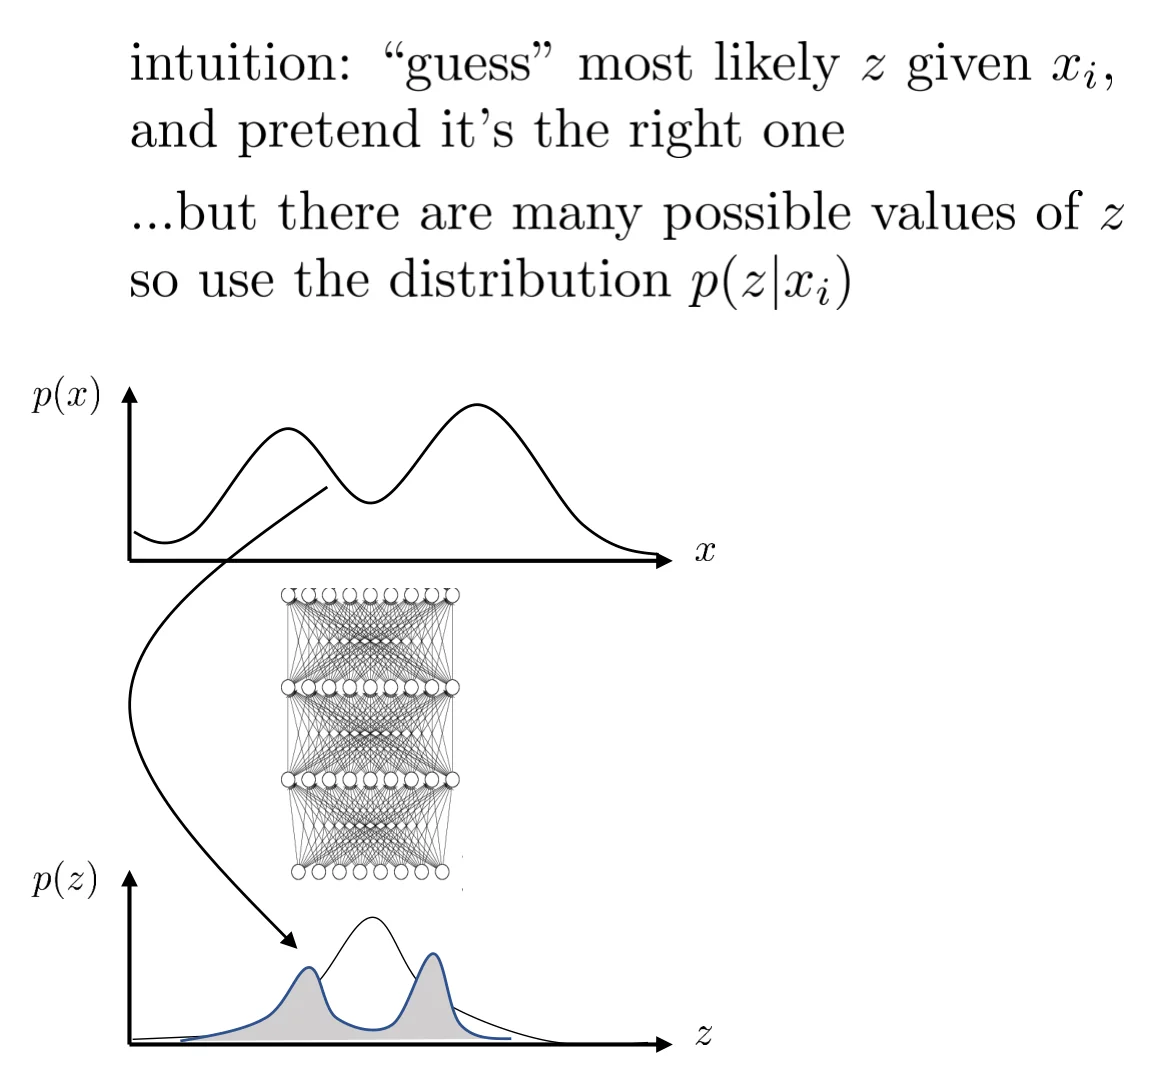 관측된 점 하나 \(x_i\)에서 출발해 그 점을 만들었을 법한 \(z\)의 분포 \(p(z \mid x_i)\)를 거꾸로 찾는 모습. 아래 그래프의 얇은 곡선은 사전분포 \(p(z)\), 회색으로 칠한 두 봉우리 곡선은 사후분포다. 출처: CS 182 Lecture 18 slides.
그림에서 위쪽 \(p(x)\) 곡선 위의 한 점이 데이터 \(x_i\)다. 생성 방향은 아래(\(z\))에서 위(\(x\))로 신경망을 통과하지만, 학습에 필요한 것은 반대 방향, 즉 “이 \(x_i\)는 어떤 \(z\)에서 나왔을까”라는 질문의 답이다. 휘어진 화살표가 이 역방향 질문을 나타낸다. 답은 하나의 값이 아니라 분포이며, 그림처럼 사전분포와 모양이 전혀 다를 수 있다. 여기서는 \(z\) 축의 두 구간이 모두 \(x_i\) 근처로 보내지므로 사후분포의 봉우리가 둘이다.
기대 로그우도는 이 회색 분포에서 \(z\)를 여러 개 뽑아 각 \((x_i, z)\) 쌍을 “완성된 데이터”처럼 취급하고 \(\log p_\theta(x_i, z)\)를 키우는 것이다. 신경망 디코더가 비선형이므로 이 사후분포는 베이즈 정리로 닫힌 형태로 구할 수 없고, 이것이 다음 절에서 근사 분포 \(q_i(z)\)를 도입하는 이유다.
Jensen 부등식으로 하한 만들기
\(p(z \mid x_i)\)를 정확히 구하는 대신, 임의의 근사 분포 \(q_i(z)\)를 도입해 \(\log p(x_i)\)의 하한을 만든다. 핵심 도구는 Jensen 부등식 \(\log E[y] \ge E[\log y]\)다.
\[\begin{aligned} \log p(x_i) &= \log \int p(x_i \mid z) p(z) \frac{q_i(z)}{q_i(z)} dz = \log E_{z \sim q_i(z)}\left[ \frac{p(x_i \mid z) p(z)}{q_i(z)} \right] \\ &\ge E_{z \sim q_i(z)}\left[ \log \frac{p(x_i \mid z) p(z)}{q_i(z)} \right] = E_{z \sim q_i(z)}[\log p(x_i \mid z) + \log p(z)] + \mathcal{H}(q_i) \end{aligned}\]이 하한을 \(\mathcal{L}_i(p, q_i)\)라 쓰고 변분 하한(variational lower bound) 또는 ELBO(evidence lower bound)라 부른다. 하한을 최대화하면 \(\log p(x_i)\)도 함께 밀어 올리게 된다.
엔트로피와 KL 발산
엔트로피(entropy) 는 다음과 같다.
\[\mathcal{H}(p) = -E_{x \sim p(x)}[\log p(x)] = -\int p(x) \log p(x)\, dx\]직관은 두 가지다. 확률변수가 얼마나 무작위적인가, 그리고 분포가 자기 자신 아래에서 기대 로그확률이 얼마나 큰가(작을수록 엔트로피가 크다). ELBO에서 첫째 항 \(E_{q_i}[\log p(x_i \mid z) + \log p(z)]\)는 \(q_i\)를 \(p(x_i, z)\)가 큰 곳에 모으려 하고, 엔트로피 항은 \(q_i\)를 가능한 넓게 퍼뜨리려 한다.
KL 발산(KL-divergence) 은 다음과 같다.
\[D_{\mathrm{KL}}(q \lVert p) = E_{x \sim q(x)}\left[ \log \frac{q(x)}{p(x)} \right] = -E_{x \sim q(x)}[\log p(x)] - \mathcal{H}(q)\]두 분포가 얼마나 다른지를 재며, \(q\) 아래에서 \(p\)의 기대 로그확률이 얼마나 작은지에서 \(q\)의 엔트로피를 뺀 값으로도 볼 수 있다. 엔트로피 항이 없으면 \(q\)가 \(p\)의 최빈값 한 점으로 붕괴해도 최소가 되므로, 엔트로피가 \(q\)를 \(p\)만큼 넓게 유지한다.
하한과 사후분포의 관계
\(q_i(z)\)와 진짜 사후분포 사이의 KL 발산을 전개하면 다음을 얻는다.
\[\begin{aligned} D_{\mathrm{KL}}(q_i(z) \lVert p(z \mid x_i)) &= E_{z \sim q_i(z)}\left[ \log \frac{q_i(z) p(x_i)}{p(x_i, z)} \right] \\ &= -E_{z \sim q_i(z)}[\log p(x_i \mid z) + \log p(z)] - \mathcal{H}(q_i) + \log p(x_i) \\ &= -\mathcal{L}_i(p, q_i) + \log p(x_i) \end{aligned}\]따라서
\[\log p(x_i) = D_{\mathrm{KL}}(q_i(z) \lVert p(z \mid x_i)) + \mathcal{L}_i(p, q_i)\]이다. KL 발산은 항상 0 이상이므로 \(\log p(x_i) \ge \mathcal{L}_i(p, q_i)\)가 다시 확인된다. 또 \(\log p(x_i)\)는 \(q_i\)와 무관하므로, \(q_i\)에 대해 \(\mathcal{L}_i\)를 최대화하는 것은 곧 \(q_i\)와 진짜 사후분포 사이의 KL 발산을 최소화하는 것이다. 하한이 빡빡해질수록(KL이 0에 가까울수록) 하한 최대화가 우도 최대화에 가까워진다.
학습 절차와 문제점
\(\log p_\theta(x_i)\) 대신 \(\mathcal{L}_i(p, q_i)\)를 최대화한다. 각 \(x_i\)(또는 미니배치)마다 다음을 반복한다.
- \(z \sim q_i(z)\)를 샘플링한다.
- \(\nabla_\theta \mathcal{L}_i(p, q_i) \approx \nabla_\theta \log p_\theta(x_i \mid z)\)로 근사한다.
- \(\theta \leftarrow \theta + \alpha \nabla_\theta \mathcal{L}_i(p, q_i)\)로 갱신한다.
- \(q_i\)를 갱신해 \(\mathcal{L}_i(p, q_i)\)를 최대화한다. 예를 들어 \(q_i(z) = \mathcal{N}(\mu_i, \sigma_i)\)로 두고 \(\mu_i, \sigma_i\)에 대해 경사 상승을 한다.
문제는 파라미터 수다. 데이터 포인트마다 별도의 \(\mu_i, \sigma_i\)가 필요하므로 전체 파라미터 수는 \(\lvert\theta\rvert + (\lvert\mu_i\rvert + \lvert\sigma_i\rvert) \times N\)이 되어 데이터셋 크기에 비례해 커진다.
상각 변분 추론과 재매개변수화 기법 (Amortized VI, Reparameterization Trick)
상각 변분 추론
\(q_i(z)\)는 결국 \(p(z \mid x_i)\)를 근사해야 한다. 그렇다면 데이터마다 따로 분포를 두지 말고, \(x\)를 입력받아 분포를 출력하는 네트워크 하나를 학습하면 된다.
\[q_\phi(z \mid x) = \mathcal{N}(\mu_\phi(x), \sigma_\phi(x)) \approx p(z \mid x)\]이것이 상각 변분 추론(amortized variational inference) 이다. 추론 비용을 하나의 네트워크에 “상각”해 파라미터 수가 \(N\)과 무관해진다. 이제 모델은 두 개의 네트워크, 즉 생성 모델 \(p_\theta(x \mid z)\)와 추론 네트워크 \(q_\phi(z \mid x)\)로 이루어진다. 하한은 다음과 같다.
\[\mathcal{L}(p_\theta(x_i \mid z), q_\phi(z \mid x_i)) = E_{z \sim q_\phi(z \mid x_i)}[\log p_\theta(x_i \mid z) + \log p(z)] + \mathcal{H}(q_\phi(z \mid x_i))\]학습은 각 \(x_i\)마다 \(z \sim q_\phi(z \mid x_i)\)를 샘플링해 \(\nabla_\theta \mathcal{L} \approx \nabla_\theta \log p_\theta(x_i \mid z)\)로 \(\theta\)를 갱신하고, \(\phi \leftarrow \phi + \alpha \nabla_\phi \mathcal{L}\)로 \(\phi\)를 갱신한다. 남은 질문은 \(\nabla_\phi \mathcal{L}\)을 어떻게 계산하느냐다.
정책 경사로 계산하기
엔트로피 항은 가우시안 엔트로피의 닫힌 형태 공식을 쓰면 바로 미분된다. 어려운 부분은 기댓값 항이다.
\[J(\phi) = E_{z \sim q_\phi(z \mid x_i)}[r(x_i, z)], \quad r(x_i, z) = \log p_\theta(x_i \mid z) + \log p(z)\]샘플링 분포가 \(\phi\)에 의존하므로 강화학습의 정책 경사(policy gradient)와 같은 형태다. 따라서 likelihood-ratio 추정량을 그대로 쓸 수 있다.
\[\nabla_\phi J(\phi) \approx \frac{1}{M} \sum_j \nabla_\phi \log q_\phi(z_j \mid x_i)\, r(x_i, z_j)\]이 추정량은 맞지만 분산이 크다. 여러 샘플과 작은 학습률이 필요하다.
재매개변수화 기법
더 좋은 방법이 있다. 가우시안 샘플은 표준 정규 잡음의 결정적 변환으로 쓸 수 있다.
\[z = \mu_\phi(x) + \epsilon\, \sigma_\phi(x), \quad \epsilon \sim \mathcal{N}(0, 1)\]\(\epsilon\)의 분포는 \(\phi\)와 무관하므로 기댓값을 \(\epsilon\)에 대한 것으로 바꿀 수 있다.
\[J(\phi) = E_{\epsilon \sim \mathcal{N}(0,1)}[r(x_i, \mu_\phi(x_i) + \epsilon \sigma_\phi(x_i))]\]이제 기댓값 안의 함수를 \(\phi\)로 직접 미분하면 된다. \(\epsilon_1, \dots, \epsilon_M\)을 뽑아
\[\nabla_\phi J(\phi) \approx \frac{1}{M} \sum_j \nabla_\phi r(x_i, \mu_\phi(x_i) + \epsilon_j \sigma_\phi(x_i))\]로 추정한다. 실제로는 샘플 하나로도 잘 동작하고, 기울기는 자동 미분이 계산해 준다. 이것이 재매개변수화 기법(reparameterization trick) 이다.
다른 관점: 재구성 항과 KL 항
하한을 다시 정리하면 더 익숙한 형태가 나온다.
\[\begin{aligned} \mathcal{L}_i &= E_{z \sim q_\phi(z \mid x_i)}[\log p_\theta(x_i \mid z)] + \underbrace{E_{z \sim q_\phi(z \mid x_i)}[\log p(z)] + \mathcal{H}(q_\phi(z \mid x_i))}_{-D_{\mathrm{KL}}(q_\phi(z \mid x_i) \lVert p(z))} \\ &= E_{\epsilon \sim \mathcal{N}(0,1)}[\log p_\theta(x_i \mid \mu_\phi(x_i) + \epsilon \sigma_\phi(x_i))] - D_{\mathrm{KL}}(q_\phi(z \mid x_i) \lVert p(z)) \\ &\approx \log p_\theta(x_i \mid \mu_\phi(x_i) + \epsilon \sigma_\phi(x_i)) - D_{\mathrm{KL}}(q_\phi(z \mid x_i) \lVert p(z)) \end{aligned}\]두 가우시안 사이의 KL 발산은 닫힌 형태로 계산되므로 편리하다. 예를 들어 \(p(z) = \mathcal{N}(0, I)\)이고 \(q\)가 대각 가우시안이면 다음과 같다.
\[D_{\mathrm{KL}}(q_\phi(z \mid x) \lVert \mathcal{N}(0, I)) = \frac{1}{2} \sum_k \left( \mu_k^2 + \sigma_k^2 - \log \sigma_k^2 - 1 \right)\]계산 그래프로 보면 \(x_i\)가 인코더 \(\phi\)를 거쳐 \(\mu_\phi(x_i), \sigma_\phi(x_i)\)가 되고, 잡음 \(\epsilon\)을 더해 \(z\)를 만든 뒤, 디코더 \(\theta\)가 \(p_\theta(x_i \mid z)\)를 출력한다. 전체가 미분 가능하다.
정책 경사 대 재매개변수화
- 정책 경사: 이산·연속 잠재변수 모두 다룰 수 있다. 분산이 커서 여러 샘플과 작은 학습률이 필요하다.
- 재매개변수화: 연속 잠재변수에만 쓸 수 있다. 구현이 매우 간단하고 분산이 작다.
변분 오토인코더 (Variational Autoencoder)
구조와 목적함수
지금까지의 내용을 합치면 변분 오토인코더(VAE) 가 된다. 인코더 \(q_\phi(z \mid x) = \mathcal{N}(\mu_\phi(x), \sigma_\phi(x))\)와 디코더 \(p_\theta(x \mid z) = \mathcal{N}(\mu_\theta(z), \sigma_\theta(z))\)를 함께 학습하며, 목적함수는 다음과 같다.
\[\max_{\theta, \phi} \frac{1}{N} \sum_i \log p_\theta(x_i \mid \mu_\phi(x_i) + \epsilon \sigma_\phi(x_i)) - D_{\mathrm{KL}}(q_\phi(z \mid x_i) \lVert p(z))\]첫 항은 재구성(reconstruction) 항으로 일반 오토인코더와 비슷하고, 둘째 항은 인코딩 분포를 사전분포 쪽으로 끌어당기는 정규화 항이다.
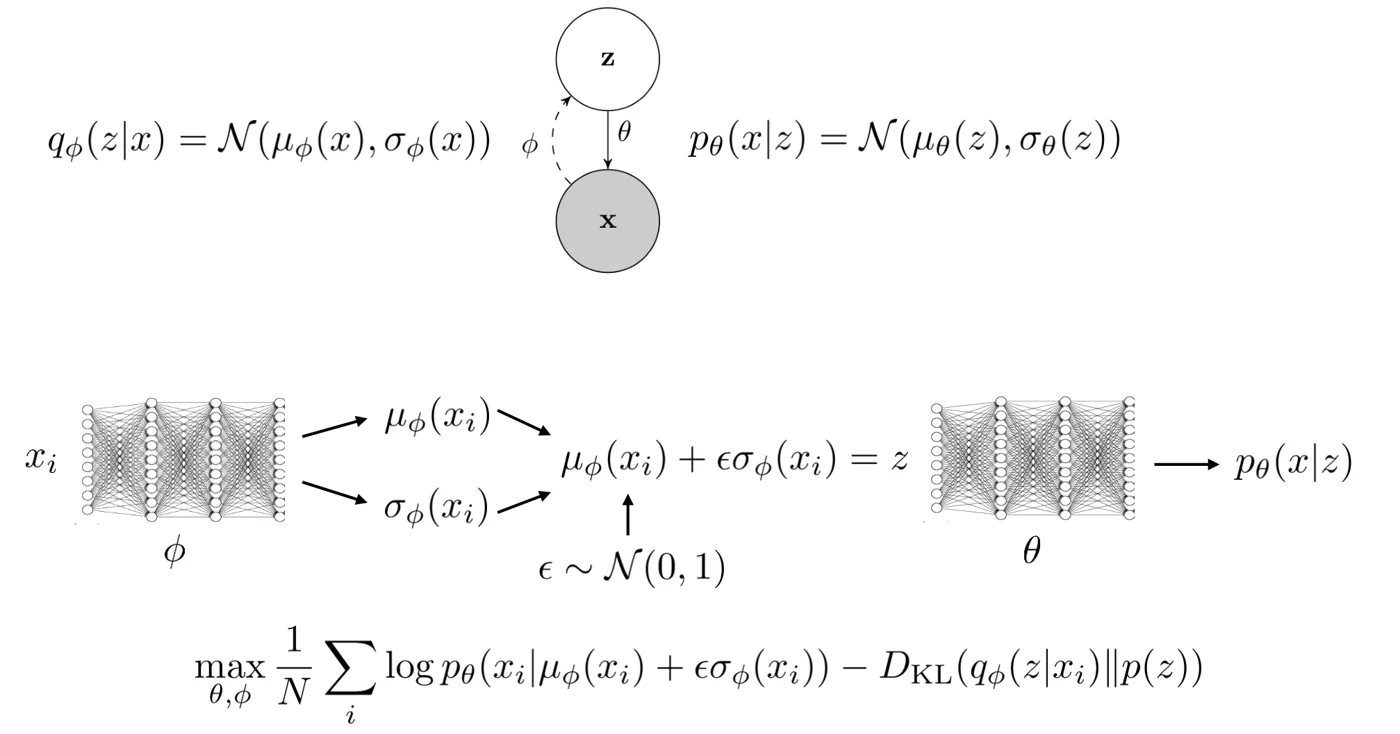 VAE의 그래프 모형(위)과 계산 그래프(아래). 위의 실선 화살표 \(\theta\)는 생성 모델 \(p_\theta(x \mid z)\), 점선 화살표 \(\phi\)는 추론 모델 \(q_\phi(z \mid x)\)다. 아래에서 인코더 \(\phi\)가 \(\mu_\phi(x_i), \sigma_\phi(x_i)\)를 내고, 잡음 \(\epsilon\)으로 \(z\)를 만든 뒤 디코더 \(\theta\)가 \(p_\theta(x \mid z)\)를 낸다. 출처: CS 182 Lecture 18 slides.
그래프 모형에서 \(x\)를 회색으로 칠한 것은 관측된 변수라는 뜻이고, \(z\)는 흰색이므로 관측되지 않는 잠재 변수다. 두 화살표의 방향이 반대라는 점이 핵심이다. 디코더는 \(z \to x\) 방향의 생성 과정을, 인코더는 \(x \to z\) 방향의 근사 추론을 맡는다.
아래 계산 그래프를 왼쪽에서 오른쪽으로 따라가 보자. \(x_i\)가 인코더 네트워크를 지나 평균 \(\mu_\phi(x_i)\)와 표준편차 \(\sigma_\phi(x_i)\) 두 벡터로 갈라진다. 아래쪽에서 들어오는 \(\epsilon \sim \mathcal{N}(0, 1)\)은 파라미터와 무관한 외부 잡음이며, \(z = \mu_\phi(x_i) + \epsilon \sigma_\phi(x_i)\)가 재매개변수화 기법 그 자체다. 이렇게 만든 \(z\)를 디코더에 넣어 \(x_i\)의 로그우도를 계산하면, 무작위성이 \(\epsilon\)에만 있으므로 손실의 기울기가 디코더에서 \(z\)를 거쳐 인코더의 \(\mu_\phi, \sigma_\phi\)까지 일반 역전파로 흐른다. 맨 아래 목적함수의 KL 항은 가우시안 두 개 사이의 KL이므로 \(\mu_\phi, \sigma_\phi\)의 닫힌 식으로 계산된다.
VAE로 샘플링하기
학습이 끝나면 인코더는 버리고 다음과 같이 샘플링한다.
\[z \sim p(z), \quad x \sim p(x \mid z)\]이것이 동작하는 이유는 KL 항 때문이다. KL 항이 각 \(q_\phi(z \mid x_i)\)를 \(p(z)\)에 가깝게 만들므로, 사전분포에서 뽑은 \(z\)가 디코더가 학습 중에 본 \(z\)들과 비슷한 영역에 놓인다. 따라서 디코더가 그럴듯한 이미지를 만든다.
조건부 모델
입력 \(x_i\)가 주어졌을 때 출력 \(y_i\)를 생성하는 조건부 VAE(conditional VAE)도 같은 방식으로 만든다. 모든 분포를 \(x_i\)에 조건부로 두면 된다.
\[\mathcal{L}_i = E_{z \sim q_\phi(z \mid x_i, y_i)}[\log p_\theta(y_i \mid x_i, z) + \log p(z \mid x_i)] + \mathcal{H}(q_\phi(z \mid x_i, y_i))\]사전분포는 \(x\)에 의존할 수도 있고, 단순히 \(\mathcal{N}(0, I)\)로 둘 수도 있다. 테스트 때는 \(z \sim p(z \mid x_i)\), \(y \sim p(y \mid x_i, z)\)로 샘플링한다. 슬라이드의 예는 운전 영상 \(x\)를 보고 다양한 행동 \(y\)를 생성하는 것이다. 같은 입력에 여러 정답이 가능한 다봉 출력을 표현할 수 있다.
합성곱 VAE
이미지에는 합성곱 인코더와 전치 합성곱(transpose convolution) 디코더를 쓴다. 예를 들어 64x64x3 입력을 stride 2 합성곱 세 층으로 줄인 뒤 완전연결층을 거쳐 \(\mu, \sigma\)를 만들고, 디코더는 이를 다시 키워 픽셀마다 독립적인 평균과 분산을 출력한다. 완전 합성곱 VAE도 만들 수 있지만, 잠재 코드의 설계(어느 위치에 어떤 크기로 둘지)에 주의해야 한다.
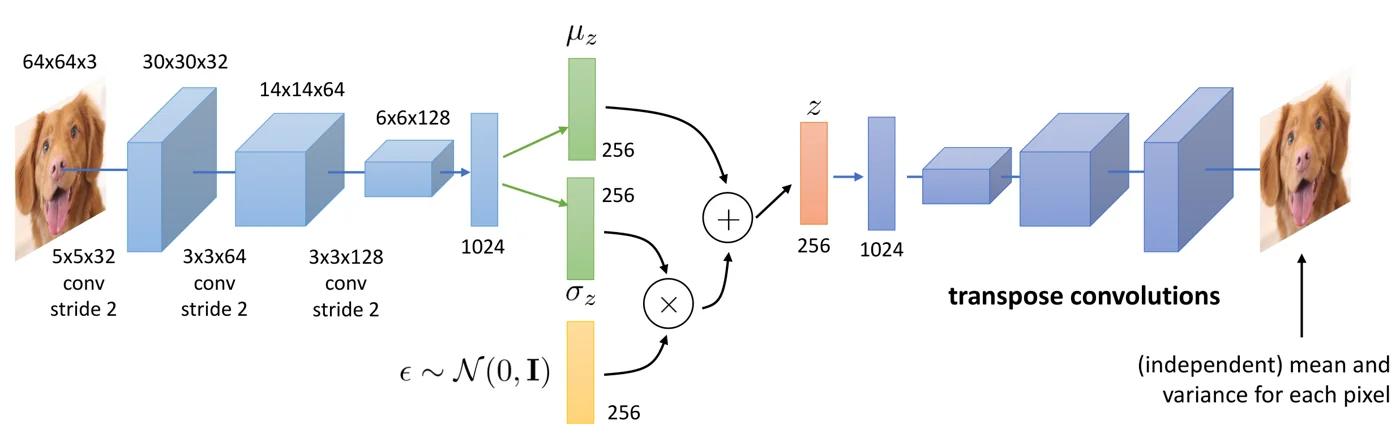 합성곱 VAE의 구조 예. 64×64×3 이미지가 stride 2 합성곱 세 층과 1024차원 완전연결층을 거쳐 256차원 \(\mu_z\)와 \(\sigma_z\)가 되고, \(\epsilon \sim \mathcal{N}(0, I)\)과 결합해 \(z\)를 만든 뒤 전치 합성곱으로 다시 이미지 크기로 키운다. 출처: CS 182 Lecture 18 slides.
그림의 숫자를 따라가면 공간 크기는 \(64 \to 30 \to 14 \to 6\)으로 줄고 채널 수는 \(3 \to 32 \to 64 \to 128\)로 늘어난다. \(6 \times 6 \times 128 = 4608\)개의 값을 1024차원 벡터로 펼친 뒤, 초록색 두 막대(각 256차원)로 평균과 표준편차를 낸다. 노란 막대 \(\epsilon\)과 \(\sigma_z\)를 곱하고(\(\times\)) \(\mu_z\)를 더하면(\(+\)) 주황색 \(z\)가 된다. 이 부분이 재매개변수화다. 디코더는 인코더를 거울처럼 뒤집은 구조로, 전치 합성곱이 공간 크기를 다시 키운다. 출력은 픽셀마다 독립적인 가우시안의 평균과 분산이며, 재구성 항 \(\log p_\theta(x \mid z)\)는 픽셀별 가우시안 로그우도의 합이 된다.
\(z\)가 256차원 벡터 하나라는 점에 주목할 만하다. 사전분포 \(p(z) = \mathcal{N}(0, I)\)은 모든 차원이 독립이라고 가정한다. 완전 합성곱 VAE처럼 \(z\)를 공간 격자 모양으로 두면 이웃한 위치의 잠재 코드가 실제로는 강하게 상관되어 있는데도 사전분포는 독립을 가정하게 되므로, 사전분포에서 뽑은 샘플이 부자연스러워질 수 있다.
실전의 문제: 잠재 코드의 정보량
VAE, 특히 조건부 VAE는 잠재 코드를 무시하거나 나쁜 샘플을 만들기 쉽다. 두 가지 실패가 대칭적이다.
- 문제 1: 잠재 코드가 무시된다. \(D_{\mathrm{KL}}(q_\phi(z \mid x) \lVert p(z))\)가 너무 낮아 \(z\)에 정보가 없다. 디코더가 모든 것을 혼자 모델링하므로 흐릿한 “평균” 이미지가 나온다.
- 문제 2: 잠재 코드가 압축되지 않는다. KL 항이 너무 높아 \(z\)에 정보가 지나치게 많다. 재구성은 잘 되지만 \(q_\phi(z \mid x)\)가 사전분포와 동떨어져 있어, \(p(z)\)에서 샘플링하면 쓰레기 이미지가 나온다.
해결책은 KL 항에 가중치 \(\beta\)를 곱해 정규화 강도를 조절하는 것이다.
\[\max_{\theta, \phi} \frac{1}{N} \sum_i \log p_\theta(x_i \mid \mu_\phi(x_i) + \epsilon \sigma_\phi(x_i)) - \beta D_{\mathrm{KL}}(q_\phi(z \mid x_i) \lVert p(z))\]\(\beta\)를 손으로 조정해 재구성과 샘플 품질의 균형을 맞추거나, 일정에 따라 바꾼다. 처음에는 낮게 두어 VAE가 \(z\)를 재구성에 쓰도록 하고, 나중에는 높여 샘플이 좋아지도록 한다.
가역 모델과 Normalizing Flow
결정적 가역 사상
더 단순한 모델을 생각해 보자. 확률적 디코더 \(p(x \mid z)\) 대신 결정적(deterministic) 함수 \(x = f(z)\)를 쓰고, \(f\)가 가역이라고 하자. 그러면 변수 변환 공식(change of variables formula)으로 밀도를 정확히 계산할 수 있다.
\[p(x) = p(z) \left\lvert \det \left( \frac{df(z)}{dz} \right) \right\rvert^{-1}, \quad z = f^{-1}(x)\]야코비안 행렬식 항은 \(f\)에 의한 국소 부피 변화를 보정한다. 핵심 아이디어는 행렬식을 쉽게 계산할 수 있는 가역 사상 \(z \to x\)를 학습하는 것이다. 그러면 더 이상 하한이 필요 없고, 정확한 확률과 우도를 얻는다. 로그우도는 다음과 같다.
\[\log p(x) = \log p(f^{-1}(x)) - \log \left\lvert \det \frac{df(z)}{dz} \right\rvert\]층을 쌓는 normalizing flow
Normalizing flow 모델은 가역 변환 여러 층의 합성 \(x = f_L \circ \cdots \circ f_1(z)\)이다. 각 층이 가역이면 전체도 가역이고, 전체 모델의 로그 행렬식은 각 층의 로그 행렬식의 합이다.
\[\log \left\lvert \det \frac{dx}{dz} \right\rvert = \sum_{l=1}^{L} \log \left\lvert \det \frac{dh_l}{dh_{l-1}} \right\rvert\]따라서 목표는 가역이면서 행렬식이 편리한 층 하나를 설계하고, 그것을 여러 개 쌓아 완전히 가역인 신경망을 만드는 것이다.
NICE: 덧셈 결합 층
일반적인 층 \(x = \mathrm{ReLU}(Wz + b)\)는 가역이 아니다. NICE(Nonlinear Independent Components Estimation)의 아이디어는 층의 일부가 정보를 그대로 보존하게 만들어, 비선형 변환으로 바뀐 부분을 복원할 수 있게 하는 것이다. \(z\)를 두 부분으로 나눈다.
\[x_{1:d} = z_{1:d}, \quad x_{d+1:n} = z_{d+1:n} + g_\theta(z_{1:d})\]여기서 \(g_\theta\)는 임의의 신경망이다(예: \(g_\theta(a) = \mathrm{ReLU}(Wa + b)\)). \(x\)가 주어지면 \(z_{1:d} = x_{1:d}\)를 먼저 복원하고, 이것으로 \(g_\theta(z_{1:d})\)를 계산해 \(z_{d+1:n} = x_{d+1:n} - g_\theta(z_{1:d})\)를 얻는다. 따라서 가역이다. 실제로는 이런 층을 여러 개 쌓고, 층마다 보존하는 부분을 바꾼다.
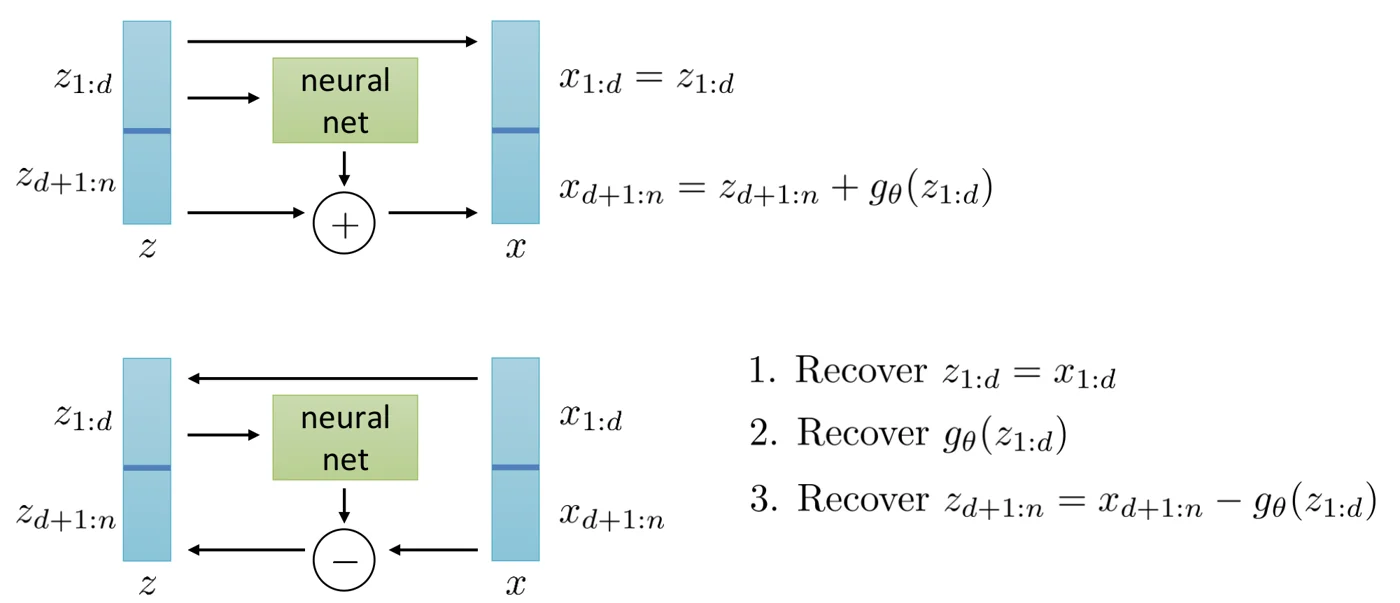 NICE의 덧셈 결합 층. 위는 순방향 \(z \to x\), 아래는 역방향 \(x \to z\)이며, 같은 신경망 \(g_\theta\)를 쓰되 덧셈(\(+\))이 뺄셈(\(-\))으로 바뀐다. 출처: CS 182 Lecture 18 slides.
그림의 파란 막대는 벡터이고 가운데 가로줄이 \(d\)번째 원소에서 벡터를 둘로 나눈 경계다. 위쪽 절반 \(z_{1:d}\)는 맨 위 화살표를 따라 그대로 \(x_{1:d}\)로 복사되고, 동시에 초록 신경망의 입력이 된다. 신경망의 출력은 아래쪽 절반 \(z_{d+1:n}\)에 더해진다.
역방향 그림에서는 화살표 방향이 모두 바뀐다. \(x_{1:d}\)를 그대로 복사해 \(z_{1:d}\)를 얻고, 이것을 같은 신경망에 넣어 \(g_\theta(z_{1:d})\)를 다시 계산한 뒤 \(x_{d+1:n}\)에서 빼면 된다. 신경망 자체를 역으로 계산할 필요가 전혀 없다는 점이 핵심이다. 신경망은 항상 순방향으로만 쓰이므로 아무리 복잡해도(가역이 아니어도) 상관없다. 대신 한 층에서는 절반이 변하지 않으므로, 다음 층에서는 역할을 바꿔 다른 절반을 변환해야 모든 차원이 섞인다.
야코비안은 블록 하삼각 행렬이다.
\[\frac{df(z)}{dz} = \begin{bmatrix} I & 0 \\ \frac{dg_\theta}{dz_{1:d}} & I \end{bmatrix}, \quad \left\lvert \det \frac{df(z)}{dz} \right\rvert = 1\]매우 간단하고 편리하지만, 부피를 보존하는 변환이라 표현력이 다소 제한된다. 그래도 MNIST 숫자나 얼굴 데이터에서 그럴듯한 샘플을 생성한다.
Real-NVP: 부피를 바꾸는 결합 층
Real-NVP(Real-valued Non-Volume Preserving)는 신경망 두 개로 원소별 스케일을 추가한다.
\[x_{1:d} = z_{1:d}, \quad x_{d+1:n} = z_{d+1:n} \odot \exp(h_\theta(z_{1:d})) + g_\theta(z_{1:d})\]역변환도 같은 방식으로 구한다. \(z_{1:d} = x_{1:d}\)를 복원하고, \(g_\theta(z_{1:d})\)와 \(h_\theta(z_{1:d})\)를 계산한 뒤
\[z_{d+1:n} = (x_{d+1:n} - g_\theta(z_{1:d})) / \exp(h_\theta(z_{1:d}))\]로 나머지를 복원한다. 야코비안은 여전히 블록 하삼각이고 대각 블록이 \(\mathrm{diag}(\exp(h_\theta(z_{1:d})))\)이므로 행렬식은 대각 성분의 곱이다.
\[\left\lvert \det \frac{df(z)}{dz} \right\rvert = \prod_{i=d+1}^{n} \exp(h_\theta(z_{1:d})_i)\]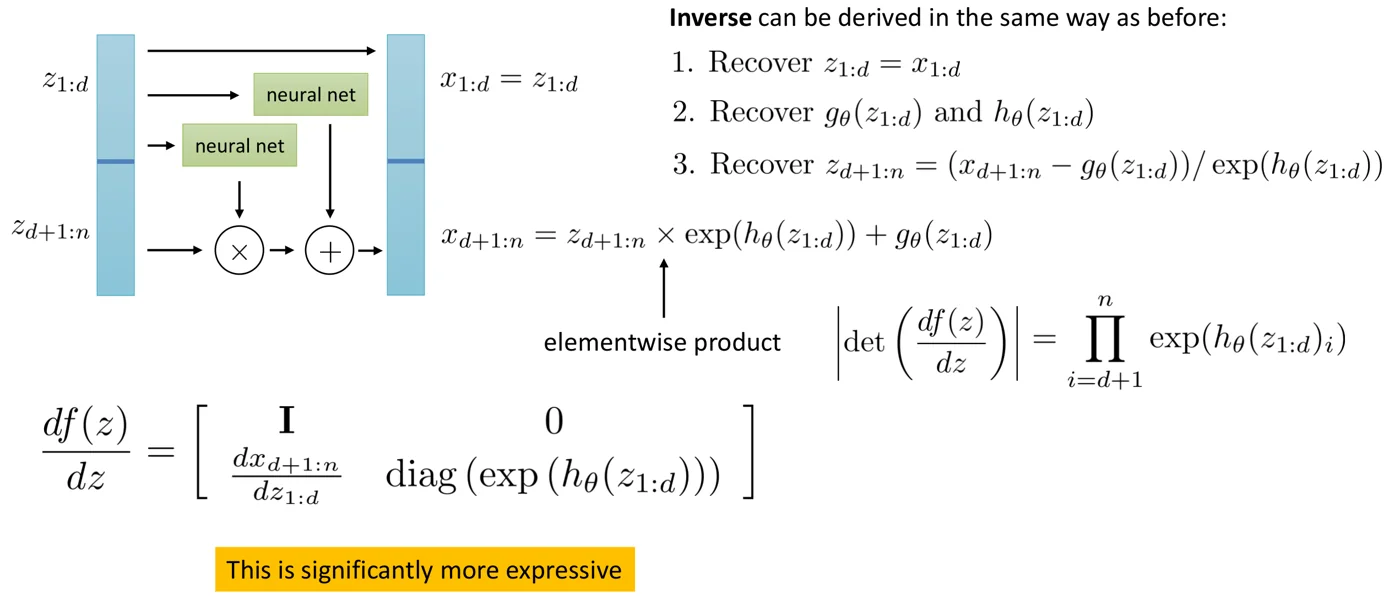 Real-NVP의 아핀 결합 층. NICE 구조에 두 번째 신경망 \(h_\theta\)가 추가되어 \(z_{d+1:n}\)에 \(\exp(h_\theta(z_{1:d}))\)를 원소별로 곱한 뒤 \(g_\theta(z_{1:d})\)를 더한다. 아래는 블록 하삼각 야코비안과 그 행렬식이다. 출처: CS 182 Lecture 18 slides.
그림의 왼쪽 구조를 NICE 그림과 비교하면 차이는 곱셈 노드(\(\times\)) 하나다. 곱하는 값을 \(\exp(\cdot)\)로 감쌌기 때문에 항상 양수이며, 따라서 0으로 나눌 일 없이 역변환에서 나눗셈으로 되돌릴 수 있다. 오른쪽 위의 역변환 세 단계가 이것을 보여 준다.
아래 야코비안에서 왼쪽 위 블록이 \(I\)인 것은 \(x_{1:d} = z_{1:d}\)이기 때문이고, 오른쪽 위 블록이 0인 것은 \(x_{1:d}\)가 \(z_{d+1:n}\)에 의존하지 않기 때문이다. 왼쪽 아래 블록 \(dx_{d+1:n}/dz_{1:d}\)는 신경망을 미분한 복잡한 행렬이지만, 삼각 행렬의 행렬식은 대각 블록에만 의존하므로 계산할 필요가 없다. 오른쪽 아래가 대각 행렬이므로 행렬식은 그 대각 성분의 곱이 되고, 로그를 취하면 \(\sum_i h_\theta(z_{1:d})_i\)라는 단순한 합이 된다. NICE에서는 이 값이 항상 0(행렬식 1)이어서 부피를 바꿀 수 없었지만, Real-NVP는 부피를 늘리거나 줄일 수 있어 훨씬 표현력이 크다.
NICE보다 훨씬 표현력이 크며, 고해상도 자연 이미지에서도 좋은 샘플을 낸다.
장단점
- 장점: 정확한 확률과 우도를 얻는다. 하한이 필요 없다. 개념적으로 (아마도) 더 단순하다.
- 단점: 특수한 구조가 필요하다. \(z\)의 차원이 \(x\)의 차원과 같아야 한다.
정리
- 잠재변수 모델은 \(p(x) = \int p(x \mid z) p(z) dz\)로 쉬운 분포들을 묶어 복잡한 분포를 표현하지만, 적분과 사후분포 \(p(z \mid x)\) 계산이 어렵다.
- Jensen 부등식으로 ELBO \(\mathcal{L}_i = E_{q}[\log p(x_i \mid z) + \log p(z)] + \mathcal{H}(q)\)를 얻는다. \(\log p(x_i) = D_{\mathrm{KL}}(q \lVert p(z \mid x_i)) + \mathcal{L}_i\)이므로 \(q\)에 대한 하한 최대화는 사후분포 근사와 같다.
- 상각 변분 추론은 데이터마다 \(q_i\)를 두는 대신 추론 네트워크 \(q_\phi(z \mid x)\)를 학습해 파라미터 수를 \(N\)과 무관하게 만든다.
- 재매개변수화 \(z = \mu_\phi(x) + \epsilon \sigma_\phi(x)\)는 정책 경사보다 분산이 훨씬 작은 기울기를 주지만 연속 잠재변수에만 쓸 수 있다.
- VAE의 목적함수는 재구성 항과 KL 정규화 항의 합이다. KL 항의 크기를 \(\beta\)로 조절해 잠재 코드 무시(흐릿한 이미지)와 비압축(나쁜 샘플) 사이의 균형을 맞춘다.
- Normalizing flow는 가역 사상과 변수 변환 공식으로 정확한 우도를 계산한다. NICE의 덧셈 결합 층은 행렬식이 1이고, Real-NVP는 원소별 스케일을 더해 표현력을 높인다.