- UC Berkeley CS 182 (Spring 2021) 21강 정리
- 강의: Sergey Levine
- 관련 Discussion: Discussion 12
메타러닝이란 (What Is Meta-Learning)
배우는 법을 배운다
이미 100개의 과제를 배웠다면, 새 과제를 더 효율적으로 배우는 법을 알아낼 수 있을까? 이 경우 여러 과제가 있다는 것이 큰 이점이 된다. 메타러닝(meta-learning) 은 “배우는 법을 배우는 것(learning to learn)”이다. 실제로는 다중 과제 학습(multi-task learning)과 매우 밀접하다. 형식화 방법은 여러 가지다.
- 최적화기(optimizer)를 학습한다.
- 경험을 읽어 들이는 RNN을 학습한다.
- 표현(representation)을 학습한다.
왜 좋은 아이디어인가
딥러닝은 매우 잘 동작하지만 큰 데이터셋이 필요하다. 많은 경우 특정 과제(예: 어떤 특수한 비전 과제)에는 데이터가 적지만, 비슷한 종류의 다른 과제(예: 다른 물체 분류 과제)에는 데이터가 많다. 메타러너는 다음과 같이 돕는다.
- 풍부한 이전 과제들로 모델을 메타 학습(meta-train)해, 적은 예제만으로 새 과제를 빠르게 배우게 한다.
- 새 과제에 대해 레이블된 데이터를 조금 모은다.
- 이 작은 데이터셋으로 넓게 일반화하는 모델을 학습한다.
지도학습에서의 메타러닝
대표적인 예는 소수샷 분류(few-shot classification)다(Ravi & Larochelle, 2017). 메타 학습 단계에서는 여러 과제가 주어지고, 각 과제는 몇 개 클래스의 작은 학습셋과 테스트셋으로 이루어진다. 메타 테스트 단계에서는 처음 보는 클래스로 이루어진 새 과제가 주어진다.
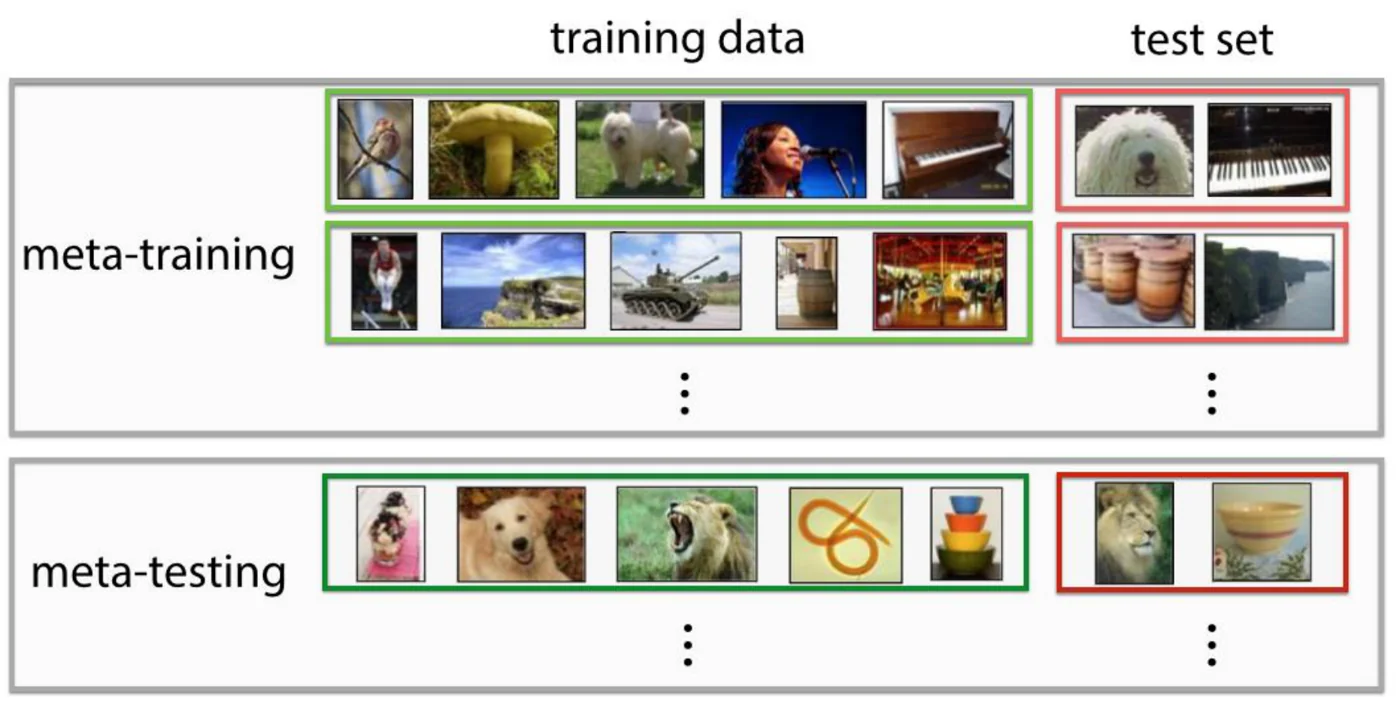 소수샷 분류의 데이터 구성. 한 행이 하나의 과제이며, 초록 상자는 그 과제의 학습 데이터(클래스마다 한 장씩 다섯 클래스), 빨간 상자는 같은 클래스에서 뽑은 테스트 이미지다. 위쪽 회색 상자는 메타 학습용 과제들, 아래쪽은 메타 테스트용 과제다. 출처: CS 182 Lecture 21 slides.
그림의 첫 행을 보면 학습 데이터는 새, 버섯, 개, 가수, 피아노의 다섯 장이고, 테스트 이미지는 개와 피아노다. 이 과제를 풀려면 다섯 장만 보고 테스트 이미지가 그중 어느 클래스인지 맞혀야 한다. 둘째 행은 전혀 다른 다섯 클래스로 이루어진 또 다른 과제다. 메타 학습은 이런 과제를 수없이 풀어 보며 “적은 예제로 새 클래스를 구별하는 법”을 익힌다.
아래쪽 메타 테스트 과제의 클래스(아이스크림, 개, 사자, 매듭, 그릇)는 메타 학습 중에 한 번도 나오지 않은 클래스다. 따라서 평가하는 것은 특정 클래스를 외웠는지가 아니라 처음 보는 클래스를 다섯 장만으로 배우는 능력이다. 일반 지도학습에서 데이터 포인트 하나가 하던 역할을 여기서는 과제 하나가 맡는다고 보면 된다.
지도 메타러닝은 학습셋과 테스트 입력을 함께 받아 레이블을 내는 함수를 학습하는 것으로 볼 수 있다.
\[f(\mathcal{D}^{\text{tr}}, x) \to y\]\((x_1, y_1), (x_2, y_2), (x_3, y_3)\) 같은 소수샷 학습셋을 차례로 읽은 뒤 \(x_{\text{test}}\)를 받아 \(y_{\text{test}}\)를 출력한다. 학습셋을 어떻게 읽어 들이느냐에는 여러 선택지가 있으며 RNN도 동작한다.
무엇이 “학습”되는가
일반적인 학습은 다음과 같다.
\[\theta^\star = \arg\min_\theta \mathcal{L}(\theta, \mathcal{D}^{\text{tr}}) = f_{\text{learn}}(\mathcal{D}^{\text{tr}})\]메타러닝은 다음과 같다.
\[\theta^\star = \arg\min_\theta \sum_{i=1}^{n} \mathcal{L}(\phi_i, \mathcal{D}_i^{\text{ts}}), \quad \phi_i = f_\theta(\mathcal{D}_i^{\text{tr}})\]일반 학습에서 학습 알고리즘 \(f_{\text{learn}}\)은 고정되어 있다. 메타러닝에서는 학습 알고리즘 \(f_\theta\) 자체를 파라미터 \(\theta\)로 학습하며, 과제 \(i\)의 학습셋으로 적응한 파라미터 \(\phi_i\)가 그 과제의 테스트셋에서 잘 동작하도록 만든다.
RNN 메타러너에서는 \(\theta^\star\)가 RNN의 가중치다. RNN이 학습셋을 읽고 만든 은닉 상태 \(h_i\)가 과제별 정보를 담고, 출력부의 메타 학습된 가중치 \(\theta_p\)와 함께 분류기 \(p_{\phi_i}(y \mid x)\)를 정의한다. 즉 \(\phi_i = [h_i, \theta_p]\)다.
메타러닝 방법의 세 갈래
- 블랙박스 메타러닝(black-box meta-learning): 소수샷 학습셋 전체를 읽어 들이는 어떤 네트워크. 예: 메모리 증강 신경망(Santoro et al., 2016), SNAIL(Mishra et al., 2018).
- 비모수적 메타러닝(non-parametric meta-learning): Matching Networks(Vinyals et al.), Prototypical Networks(Snell et al.).
- 기울기 기반 메타러닝(gradient-based meta-learning): MAML(Finn et al.).
비모수적 메타러닝과 기울기 기반 메타러닝 (Non-Parametric & Gradient-Based)
기본 아이디어: 학습된 최근접 이웃
테스트 이미지를 특징 공간 \(\phi(x)\)에서 학습 이미지들과 비교하고, 가장 가까운 이웃의 레이블을 쓴다. 왜 최근접 이웃이 올바른 클래스를 가질까? 그렇게 되도록 특징을 메타 학습하기 때문이다.
미분 가능하게 만들기 위해 소프트 최근접 이웃을 쓴다.
\[p_{\text{nearest}}(x_k^{\text{tr}} \mid x_j^{\text{ts}}) \propto \exp\left( \phi(x_k^{\text{tr}})^T \phi(x_j^{\text{ts}}) \right)\] \[p_\theta(y_j^{\text{ts}} \mid x_j^{\text{ts}}, \mathcal{D}_i^{\text{tr}}) = \sum_{k : y_k^{\text{tr}} = y_j^{\text{ts}}} p_{\text{nearest}}(x_k^{\text{tr}} \mid x_j^{\text{ts}})\]해당 레이블을 가진 모든 학습점의 확률을 더한다. 메타 학습 목적함수는 이 학습된 (소프트) 최근접 이웃 분류기의 테스트셋 음의 로그우도다.
\[\theta^\star = \arg\min_\theta \sum_{i=1}^{n} \mathcal{L}(f_\theta(\mathcal{D}_i^{\text{tr}}), \mathcal{D}_i^{\text{ts}}) = -\sum_{i=1}^{n} \sum_{j=1}^{m} \log p_\theta(y_j^{\text{ts}} \mid x_j^{\text{ts}}, \mathcal{D}_i^{\text{tr}})\]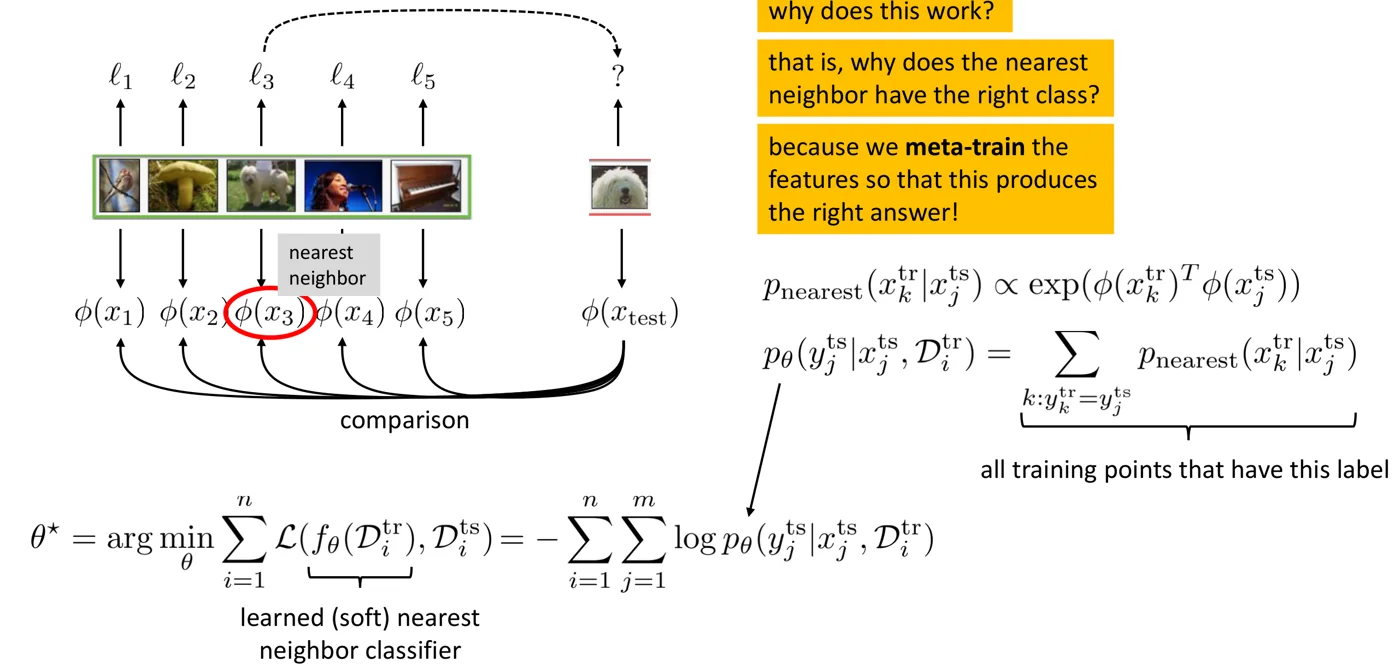 학습된 최근접 이웃의 그림. 학습 이미지 다섯 장과 테스트 이미지를 모두 특징 \(\phi(\cdot)\)로 바꾼 뒤 테스트 특징을 각 학습 특징과 비교하고, 가장 가까운 \(\phi(x_3)\)의 레이블 \(\ell_3\)을 테스트 이미지의 레이블로 쓴다(점선 화살표). 출처: CS 182 Lecture 21 slides.
그림을 위에서 아래로 읽으면 다음과 같다. 초록 상자의 학습 이미지들은 각자 레이블 \(\ell_1, \dots, \ell_5\)를 가지고 있고, 오른쪽의 테스트 이미지는 레이블이 “?”이다. 모든 이미지를 같은 신경망 \(\phi\)에 통과시켜 특징 벡터를 얻고, 아래의 “comparison” 곡선들처럼 테스트 특징과 각 학습 특징의 내적을 계산한다. 하드 최근접 이웃이라면 내적이 가장 큰 하나(빨간 원)를 고르겠지만, 미분이 가능하도록 내적에 softmax를 씌운 \(p_{\text{nearest}}\)를 쓴다.
같은 레이블을 가진 학습점이 여러 개이면 그 확률을 모두 더해 클래스 확률을 만든다(오른쪽 식의 중괄호). 이 클래스 확률의 음의 로그우도를 수많은 과제에 대해 최소화하면, 기울기는 \(\phi\)의 파라미터로 흘러 들어가 “같은 클래스의 이미지는 내적이 크고 다른 클래스는 작도록” 특징 공간을 다듬는다. 오른쪽 노란 상자의 질문, 즉 왜 최근접 이웃이 올바른 클래스를 갖는가에 대한 답이 바로 이 메타 학습이다.
Matching Networks
Matching Networks(Vinyals et al., 2016)는 학습 샘플과 테스트 샘플에 서로 다른 임베딩 \(g\)와 \(f\)를 쓰고, 두 임베딩 모두 학습셋 전체 \(\mathcal{D}_i^{\text{tr}}\)에 조건부로 만든다.
\[p_{\text{nearest}}(x_k^{\text{tr}} \mid x_j^{\text{ts}}) \propto \exp\left( g(x_k^{\text{tr}}, \mathcal{D}_i^{\text{tr}})^T f(x_j^{\text{ts}}, \mathcal{D}_i^{\text{tr}}) \right)\]\(g\)는 학습 샘플들을 양방향 LSTM으로 임베딩하고, \(f\)는 학습 샘플 임베딩에 주의(attention)를 주는 attentional LSTM으로 테스트 샘플을 임베딩한다.
Prototypical Networks
Prototypical Networks(Snell et al., 2017)는 Matching Networks에 비해 두 가지를 단순화한다.
첫째, “소프트 최근접 이웃” 대신 각 클래스의 프로토타입(prototype) 을 만든다. 프로토타입은 그 클래스 학습 샘플 임베딩의 평균이다.
\[c_y = \frac{1}{N_y} \sum_{k : y_k^{\text{tr}} = y} g(x_k^{\text{tr}}), \quad p_\theta(y \mid x_j^{\text{ts}}, \mathcal{D}_i^{\text{tr}}) \propto \exp\left( c_y^T f(x_j^{\text{ts}}) \right)\]둘째, 양방향 LSTM 임베딩과 attentional LSTM 임베딩 같은 복잡한 장치를 모두 없앤다.
특징 공간은 프로토타입들을 중심으로 영역이 나뉘고, 테스트 점은 가장 가까운 프로토타입의 클래스로 분류된다.
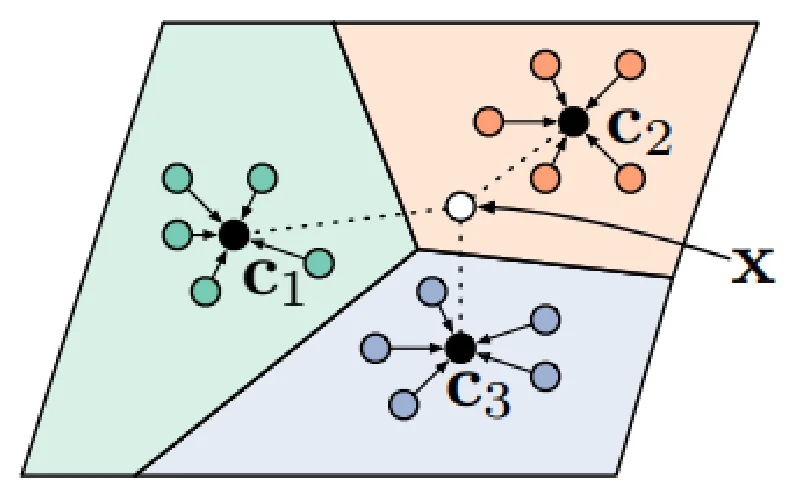 임베딩 공간에서의 Prototypical Networks. 같은 색 점들은 한 클래스의 학습 샘플 임베딩이고, 검은 점 \(c_1, c_2, c_3\)는 그 평균인 프로토타입이다. 흰 점 \(x\)는 테스트 샘플이며, 세 색의 영역은 각 프로토타입이 가장 가까운 구역이다. 출처: CS 182 Lecture 21 slides.
그림의 짧은 화살표는 학습 샘플들이 평균을 내어 프로토타입 하나로 모이는 과정이다. 테스트 점 \(x\)에서 각 프로토타입까지 그은 점선이 비교에 해당하며, 클래스 확률은 이 거리(또는 내적)에 대한 softmax다. 영역의 경계가 직선인 것은 프로토타입이 클래스마다 하나뿐이어서 분류기가 사실상 선형 분류기가 되기 때문이다. 그림의 \(x\)는 세 영역의 경계 근처에 있어 세 클래스 확률이 비슷하게 나올 것이다. 학습 샘플마다 따로 비교하던 Matching Networks에 비해 계산이 단순하고, 샘플 하나의 잡음에 덜 민감하다.
다시 표현으로
ImageNet으로 사전학습한 특징을 가져와 새 과제(예: 새 탐지)에 미세조정하는 것도 생각해 보자. 사전학습도 일종의 메타러닝일까? 더 좋은 특징은 곧 새 과제를 더 빨리 배우는 것을 뜻한다.
최적화 문제로서의 메타러닝: MAML
메타러닝 목적함수를 다시 보자.
\[\theta^\star = \arg\min_\theta \sum_{i=1}^{n} \mathcal{L}(\phi_i, \mathcal{D}_i^{\text{ts}}), \quad \phi_i = f_\theta(\mathcal{D}_i^{\text{tr}})\]\(f_\theta(\mathcal{D}_i^{\text{tr}})\)가 그냥 미세조정(finetuning) 알고리즘이라면 어떨까?
\[f_\theta(\mathcal{D}_i^{\text{tr}}) = \theta - \alpha \nabla_\theta \mathcal{L}(\theta, \mathcal{D}_i^{\text{tr}})\]일반적으로는 기울기 스텝을 몇 번 밟을 수도 있다. 그러면 메타 목적함수는
\[\min_\theta \sum_i \mathcal{L}\left( \theta - \alpha \nabla_\theta \mathcal{L}(\theta, \mathcal{D}_i^{\text{tr}}), \mathcal{D}_i^{\text{ts}} \right)\]이 된다. 이것이 MAML(Model-Agnostic Meta-Learning) 이다(Finn, Abbeel, Levine). 경사 하강을 계산 그래프로 구현한 뒤 경사 하강을 관통해 역전파하면, 다른 신경망과 똑같이 학습할 수 있다.
그림으로 보면, 메타 학습은 \(\theta\)를 각 과제의 최적점 \(\theta_1^\star, \theta_2^\star, \theta_3^\star\)로 기울기 한 스텝(\(\nabla \mathcal{L}_1, \nabla \mathcal{L}_2, \nabla \mathcal{L}_3\)) 만에 다가갈 수 있는 위치로 옮긴다. 메타 기울기에는 안쪽 기울기 스텝을 미분하는 항이 들어가므로 2차 도함수(헤시안-벡터 곱)가 필요하다.
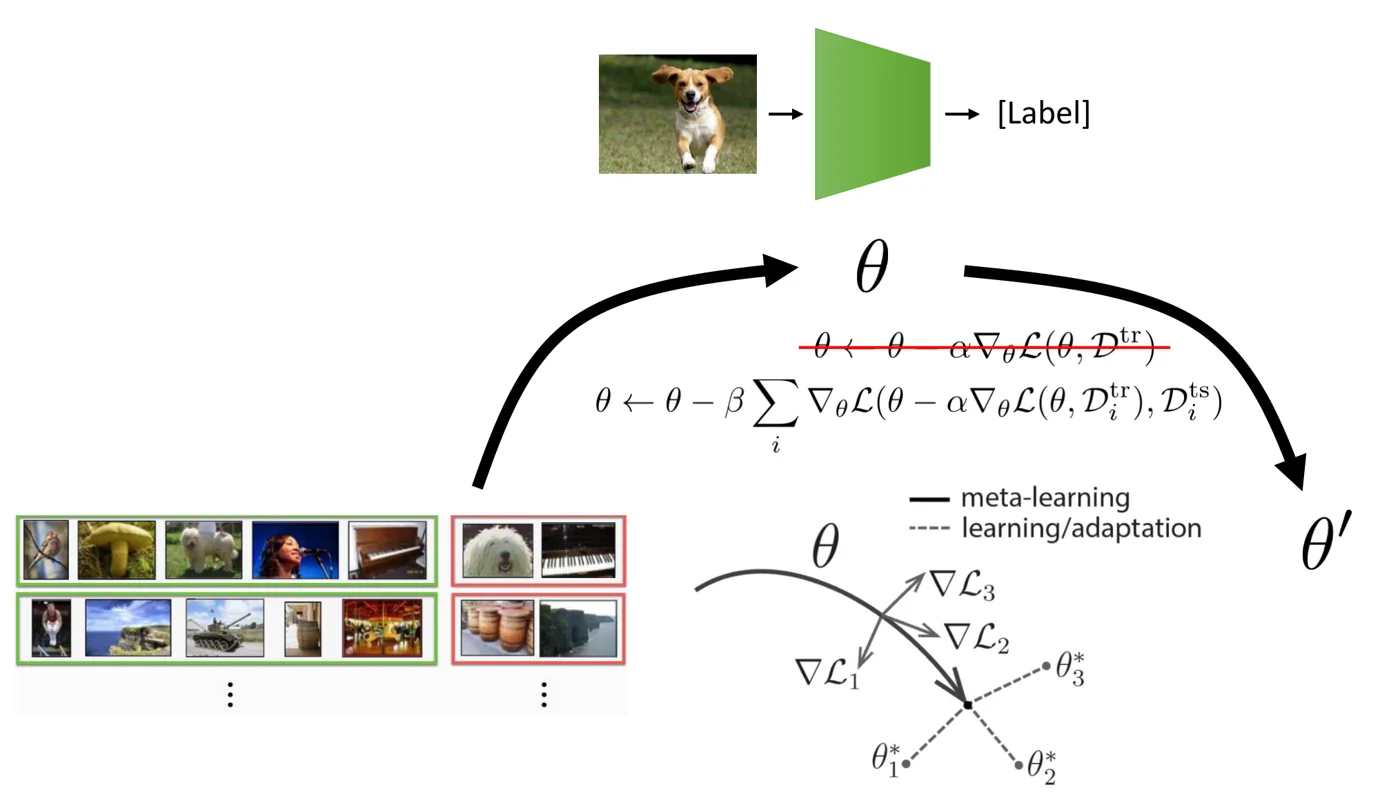 MAML의 그림. 위는 파라미터 \(\theta\)를 가진 일반 분류기이고, 가운데 식은 단순 미세조정(빨간 줄로 지운 식) 대신 쓰는 MAML의 메타 갱신이다. 오른쪽 아래 그림에서 굵은 실선은 메타 학습 중 \(\theta\)의 이동, 점선은 각 과제에서의 적응 경로다. 출처: CS 182 Lecture 21 slides.
가운데 식을 바깥에서 안쪽으로 읽으면 구조가 보인다. 가장 안쪽 \(\theta - \alpha \nabla_\theta \mathcal{L}(\theta, \mathcal{D}_i^{\text{tr}})\)는 과제 \(i\)의 학습 데이터(왼쪽 아래 초록 상자)로 한 스텝 미세조정한 파라미터다. 그것을 과제 \(i\)의 테스트 데이터(빨간 상자)로 평가한 손실이 \(\mathcal{L}(\cdot, \mathcal{D}_i^{\text{ts}})\)이고, 이 손실을 모든 과제에 대해 더해 원래 \(\theta\)로 미분한 뒤 \(\beta\)만큼 이동하는 것이 바깥 갱신이다. 빨간 줄로 지운 식은 모든 데이터로 그냥 학습하는 일반 사전학습인데, MAML은 “적응 후의 성능”을 직접 최적화한다는 점이 다르다.
오른쪽 아래 그림에서 \(\theta\)에서 출발한 굵은 곡선은 메타 학습이 \(\theta\)를 옮겨 가는 경로다. 도착점에서 세 과제의 기울기 \(\nabla \mathcal{L}_1, \nabla \mathcal{L}_2, \nabla \mathcal{L}_3\) 방향으로 각각 한 스텝씩 가면(점선) 세 과제의 최적점 \(\theta_1^\star, \theta_2^\star, \theta_3^\star\)에 가까워진다. 즉 MAML이 찾는 것은 어느 한 과제의 최적점이 아니라, 모든 과제의 최적점으로 빨리 갈 수 있는 “갈림길”이다.
무엇을 한 것인가
MAML은 그저 또 하나의 계산 그래프이며, TensorFlow 같은 어떤 자동 미분 패키지로도 구현할 수 있다. 그러나 유리한 귀납적 편향(inductive bias)을 가진다.
블랙박스 메타러닝에서는 RNN 자체가 “학습된 학습 알고리즘”을 구현한다.
- 수렴하는가? 어느 정도는.
- 무엇으로 수렴하는가? 아무도 모른다.
- 충분히 좋지 않으면 어떻게 하는가? 할 수 있는 것이 없다.
MAML은 다르다.
- 수렴하는가? 그렇다(경사 하강이니까).
- 무엇으로 수렴하는가? 국소 최적점으로(경사 하강이니까).
- 충분히 좋지 않으면? 기울기 스텝을 더 밟으면 된다(경사 하강이니까).
보편성
이렇게 구조를 제한하면 잃는 것이 있을까? 보편성(universality) 은 메타러닝이 어떤 “알고리즘”이든 학습할 수 있다는 성질이다. 더 정확히는 임의의 함수 \(f(\mathcal{D}_{\text{train}}, x)\)를 표현할 수 있다는 뜻이다. RNN 메타러너는 보편적이며, Finn & Levine(“Meta-Learning and Universality”)은 충분히 깊은 네트워크에서 MAML도 보편적임을 보였다. 즉 귀납적 편향을 얻으면서 표현력은 잃지 않는다.
세 방법의 비교
- 블랙박스 메타러닝
- 장점: 개념적으로 매우 단순하다. Transformer 같은 시퀀스 모델의 발전을 그대로 누린다.
- 단점: 귀납적 편향이 거의 없어 모든 것을 메타 학습해야 한다. 시퀀스가 길어지므로 “중간 규모 샷”으로 확장하기 어렵다.
- 비모수적 메타러닝
- 장점: 약간의 귀납적 편향과 쉬운 종단간 최적화를 결합해 매우 잘 동작할 수 있다.
- 단점: 분류에 한정되어 회귀나 강화학습으로 확장하기 어렵다. 다소 특수한 구조가 필요하다.
- 기울기 기반 메타러닝
- 장점: 어떤 구조나 손실함수(강화학습, 회귀 포함)에도 쉽게 적용된다. 도메인 밖 과제로의 일반화가 좋다.
- 단점: 메타 학습 최적화 문제가 더 어렵고 튜닝이 더 필요하다. 2차 도함수가 필요하다.
메타 강화학습 (Meta-Reinforcement Learning)
메타 강화학습 문제
지도학습의 경우와 나란히 쓰면, 강화학습은 다음과 같다.
\[\theta^\star = \arg\max_\theta E_{\pi_\theta(\tau)}[R(\tau)] = f_{\text{RL}}(\mathcal{M}), \quad \mathcal{M} = \{\mathcal{S}, \mathcal{A}, \mathcal{P}, r\}\]메타 강화학습은 다음과 같다.
\[\theta^\star = \arg\max_\theta \sum_{i=1}^{n} E_{\pi_{\phi_i}(\tau)}[R(\tau)], \quad \phi_i = f_\theta(\mathcal{M}_i)\]여기서 \(\mathcal{M}\)은 MDP이고 \(\mathcal{M}_i\)는 과제 \(i\)의 MDP다. 슬라이드의 예는 시뮬레이션 로봇이 과제마다 다른 목표 속도(0.5 m/s, 0.7 m/s, -0.2 m/s, -0.7 m/s 등)로 달리는 것이다. 메타 학습된 정책은 새 목표 속도에 빠르게 적응해야 한다.
순환 정책을 이용한 메타 강화학습
그렇다면 RNN 정책을 학습하면 될까? 그렇다. 정책은 지금까지의 전이 \((s_1, a_1, s_2, r_1), (s_2, a_2, s_3, r_2), \dots\)를 읽어 은닉 상태 \(h_i\)를 만들고, 현재 상태 \(s\)와 함께 \(\pi_{\phi_i}(a \mid s)\)를 출력한다. 지도학습의 경우처럼 \(\phi_i\)는 은닉 상태와 메타 학습된 가중치로 이루어진다.
결정적으로, RNN 은닉 상태는 에피소드 사이에 초기화되지 않는다. 미로 속 쥐가 치즈를 찾는 예를 보자. 첫 에피소드에서 여러 방향을 시도하며 보상 0을 받다가 치즈를 찾으면 +1을 받는다. 은닉 상태가 유지되므로 다음 에피소드에서는 곧바로 치즈로 간다.
왜 순환 정책은 탐색을 배우는가
메타 강화학습은 두 가지를 해야 한다.
- 과제 \(\mathcal{M}_i\)에서 얻은 경험 \(\{(s_1, a_1, s_2, r_1), \dots, (s_T, a_T, s_{T+1}, r_T)\}\)로 정책을 개선한다.
- (강화학습에서 새로운 점) 어떻게 상호작용할지, 즉 \(a_t\)를 고른다. 메타 강화학습은 어떻게 탐색할지도 골라야 한다.
여러 에피소드를 묶은 메타 에피소드(meta-episode) 전체의 총보상을 RNN 정책으로 최적화하면, 정책은 자동으로 탐색하는 법을 배운다.
\[\theta^\star = \arg\max_\theta E_{\pi_\theta}\left[ \sum_{t=0}^{T} r(s_t, a_t) \right]\]첫 에피소드에서 정보를 모으는 행동이 이후 에피소드의 보상을 높이기 때문이다. 관련 연구로 Wang et al.(Learning to Reinforcement Learn, 2016), Duan et al.(RL², 2016), Heess et al.(2015)이 있다.
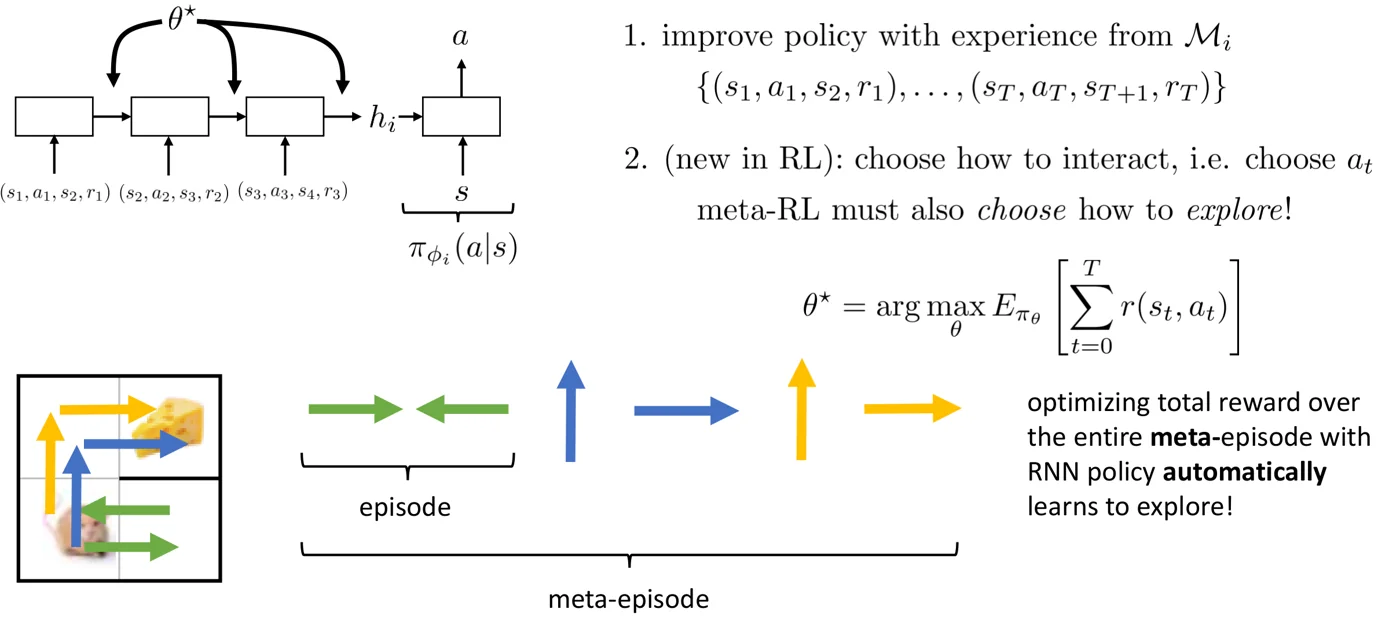 순환 정책이 탐색을 배우는 이유. 위 왼쪽은 경험을 읽어 은닉 상태 \(h_i\)를 만드는 RNN 정책이고, 아래는 쥐가 치즈를 찾는 미로에서 여러 에피소드(색이 다른 화살표 묶음)를 이어 붙인 메타 에피소드다. 출처: CS 182 Lecture 21 slides.
아래 그림에서 화살표의 색은 에피소드를 구분한다. 초록 에피소드에서 쥐는 오른쪽으로 갔다가 되돌아오며 치즈가 없음을 확인하고, 파란 에피소드에서는 위로 올라간 뒤 오른쪽으로 가서 치즈를 찾는다. 은닉 상태가 에피소드 사이에 유지되므로 노란 에피소드에서는 처음부터 위로 올라가 오른쪽으로 곧장 간다. 첫 두 에피소드의 보상은 낮지만, 그때 모은 정보가 이후 에피소드의 보상을 높인다.
목적함수가 메타 에피소드 전체의 보상 합이므로, 이런 정보 수집 행동은 별도의 탐색 보너스 없이도 보상으로 이어진다. 메타 학습 과정에서 여러 미로(과제)를 겪으며 RNN의 가중치 \(\theta^\star\)는 “처음에는 넓게 둘러보고, 찾으면 그 기억을 이용하라”는 전략을 인코딩하게 된다. 그림 위 오른쪽의 두 번째 항목, 즉 메타 강화학습이 탐색 방법까지 골라야 한다는 점이 이렇게 해결된다.
메타 강화학습을 위한 구조
경험을 요약하는 구조는 여러 가지다.
- 표준 RNN(LSTM) 구조 (RL², Duan et al.)
- 주의와 시간 합성곱(attention + temporal convolution) (SNAIL, Mishra et al.)
- 병렬적이고 순서 불변(permutation-invariant)인 문맥 인코더 (PEARL, Rakelly et al.)
강화학습을 위한 MAML
MAML도 강화학습에 그대로 쓸 수 있다. 일반 정책 경사 갱신 \(\theta \leftarrow \theta + \alpha \nabla_\theta J(\theta)\) 대신 다음 메타 갱신을 쓴다.
\[\theta \leftarrow \theta + \beta \sum_i \nabla_\theta J_i\left[ \theta + \alpha \nabla_\theta J_i(\theta) \right]\]\(J_i\)는 과제 \(i\)의 기대 보상이고, 안쪽과 바깥쪽 기울기 모두 정책 경사로 추정한다. 시뮬레이션 보행 로봇 예에서 MAML로 학습한 정책은 처음에는 제자리에서 움직이지만, 앞으로 가라는 보상으로 기울기 한 스텝을 밟으면 앞으로 달리고, 뒤로 가라는 보상으로 한 스텝을 밟으면 뒤로 달린다.
정리
- 메타러닝은 많은 이전 과제를 이용해, 새 과제를 적은 데이터로 빠르게 배우는 학습 알고리즘 \(\phi_i = f_\theta(\mathcal{D}_i^{\text{tr}})\) 자체를 학습한다.
- 블랙박스 메타러닝은 RNN 같은 시퀀스 모델이 학습셋을 읽어 예측한다. 단순하고 보편적이지만 귀납적 편향이 거의 없다.
- 비모수적 메타러닝은 메타 학습된 임베딩 공간에서 소프트 최근접 이웃(Matching Networks)이나 클래스 프로토타입(Prototypical Networks)으로 분류한다.
- MAML은 적응 과정을 경사 하강 \(\theta - \alpha \nabla_\theta \mathcal{L}(\theta, \mathcal{D}_i^{\text{tr}})\)으로 두고 이를 관통해 역전파한다. 어떤 모델에도 적용되고 도메인 밖 일반화가 좋지만 2차 도함수와 튜닝이 필요하다.
- 메타 강화학습에서는 에피소드 사이에 은닉 상태를 유지하는 RNN 정책이 메타 에피소드 전체의 보상을 최적화하면서 탐색까지 학습한다. MAML도 정책 경사와 결합해 쓸 수 있다.