- UC Berkeley CS 182 (Spring 2021) 14강 정리
- 강의: Sergey Levine
- 관련 Discussion: Discussion 8
예측에서 제어로 (From Prediction to Control)
지금까지 다룬 문제는 모두 예측(prediction) 이었다. 이미지를 보고 레이블을 맞히거나, 문장을 보고 다음 단어를 맞혔다. 이번 강의부터는 학습된 모델이 직접 행동(action) 을 고르고, 그 행동이 세상에 영향을 주는 제어(control) 문제로 넘어간다.
무엇이 달라지는가
지도학습에서는 다음과 같은 가정이 성립한다.
- 데이터는 i.i.d.이다. 각 데이터 포인트는 서로 독립이다.
- 정답 레이블(ground truth)이 주어진다.
- 목표는 올바른 레이블을 예측하는 것이다.
i.i.d. 가정은 매우 중요하다. 이 가정 덕분에 전체 데이터셋에 대한 평균 정확도만 높이면 된다. 어떤 입력 하나에서 틀리더라도 그 실수는 다른 입력에 영향을 주지 않는다.
제어에서는 이 가정들이 모두 깨진다.
- 각 결정이 미래의 입력을 바꾼다. 데이터가 독립이 아니다.
- 감독 신호가 고수준일 수 있다. “식료품점까지 운전하라”는 목표는 주어지지만, 지금 핸들을 몇 도 꺾어야 하는지는 주어지지 않는다.
- 목표는 레이블 맞히기가 아니라 과제를 달성하는 것이다.
또한 실수의 비용이 상황마다 크게 다르다. 넓은 도로 한가운데서 조금 잘못 꺾는 것은 괜찮지만, 절벽 옆에서 잘못 꺾는 것은 재앙이다. 평균 정확도만으로는 이런 차이를 반영할 수 없다.
이런 피드백 문제는 로봇 제어에만 있는 것이 아니다. 실제로 배포된 머신러닝 시스템도 비슷한 문제를 겪는다. 예를 들어 교통 예측 시스템이 추천한 경로를 사람들이 따르면 교통 흐름 자체가 바뀌고, 그러면 예측의 입력 분포도 바뀐다. 강의는 이 문제들을 한 번에 해결하는 강화학습(reinforcement learning) 시스템을 향해 한 단계씩 쌓아 간다. 이번 강의는 그 첫 단계인 모방 학습(imitation learning)이다.
용어: 상태, 관측, 행동, 정책
호랑이를 마주친 상황을 생각하자. 할 수 있는 행동은 1) 도망가기, 2) 무시하기, 3) 쓰다듬기다.
- \(o_t\): 관측(observation). 시각 \(t\)에 받는 입력이다. 예를 들어 카메라 이미지다.
- \(a_t\): 행동(action). 시각 \(t\)에 고르는 출력이다. 이산적(위 세 가지 중 하나)일 수도, 연속적(핸들 각도)일 수도 있다.
- \(\pi_\theta(a_t \mid o_t)\): 정책(policy). 관측이 주어졌을 때 행동에 대한 분포이며, 파라미터 \(\theta\)를 가진 신경망으로 표현한다.
- \(s_t\): 상태(state). 세계의 실제 상태를 요약한 것이다. 상태를 직접 받는 정책은 \(\pi_\theta(a_t \mid s_t)\)로 쓰며, 이를 완전 관측(fully observed) 정책이라 한다.
상태와 관측의 차이는 다음과 같다. 이미지(관측)에는 호랑이가 자동차에 가려 보이지 않을 수 있지만, 호랑이의 위치와 속도(상태)는 여전히 존재한다. 관측은 상태로부터 만들어지지만 상태의 일부 정보만 담고 있을 수 있다.
상태는 마르코프 성질(Markov property) 을 만족한다. 현재 상태 \(s_t\)가 주어지면 미래 \(s_{t+1}\)은 과거 \(s_{t-1}\)과 독립이다. 즉 현재 상태만 알면 과거는 미래 예측에 도움이 되지 않는다. 관측은 일반적으로 이 성질을 만족하지 않는다. 슬라이드는 이 구분이 나중에는 매우 중요해지지만 이번 강의에서는 크게 중요하지 않다고 언급한다.
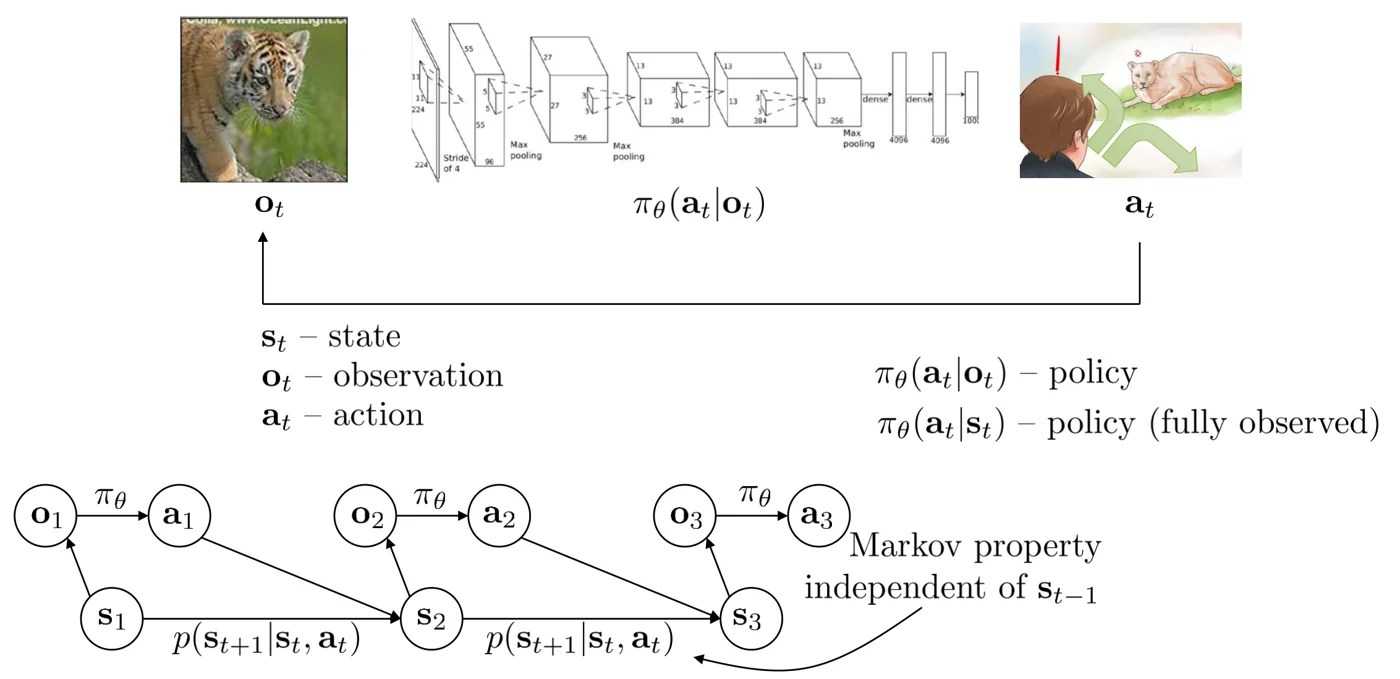 위: 관측 \(o_t\)(호랑이 이미지)를 받아 정책 \(\pi_\theta(a_t \mid o_t)\)(CNN)가 행동 \(a_t\)를 낸다. 아래: 상태, 관측, 행동 사이의 의존 관계를 나타낸 그래프. 출처: CS 182 Lecture 14 slides.
그림 위쪽은 지금까지의 분류 문제와 거의 같은 모양이다. 이미지를 CNN에 넣어 출력을 얻는다. 다른 점은 출력이 레이블이 아니라 행동이고, 오른쪽에서 왼쪽으로 돌아가는 화살표가 보여 주듯 그 행동이 다음 관측을 바꾼다는 것이다. 도망가면 다음 이미지에서 호랑이가 멀어지고, 쓰다듬으면 전혀 다른 장면이 펼쳐진다.
아래쪽 그래프를 왼쪽부터 읽으면 시간의 흐름이 보인다. 각 시각의 상태 \(s_t\)에서 관측 \(o_t\)가 생성되고(위로 향한 화살표), 정책 \(\pi_\theta\)가 \(o_t\)를 보고 \(a_t\)를 고른다. 그다음 상태 \(s_{t+1}\)은 전이 확률 \(p(s_{t+1} \mid s_t, a_t)\)에 따라 현재 상태와 행동으로부터 정해진다. \(s_3\)으로 들어오는 화살표가 \(s_2\)와 \(a_2\)에서만 오고 \(s_1\)에서는 오지 않는다는 것이 오른쪽 주석의 마르코프 성질이다. 반면 관측 \(o_t\)는 상태 \(s_t\)의 일부만 반영하므로, 관측의 열에서는 현재 관측 외에 과거 관측도 미래 예측에 도움이 될 수 있다.
표기법에 대해
강화학습 문헌에서는 상태를 \(s_t\), 행동을 \(a_t\)로 쓴다. 이는 동적 계획법(dynamic programming)을 만든 리처드 벨만(Richard Bellman)의 전통이다. 최적 제어(optimal control) 문헌에서는 상태를 \(x_t\), 행동을 \(u_t\)로 쓰는데, 이는 레프 폰트랴긴(Lev Pontryagin)의 전통이며 \(u\)는 러시아어 “управление”(제어)에서 왔다. 두 표기는 같은 대상을 가리킨다.
행동 복제
가장 단순한 아이디어는 전문가를 그대로 따라 하는 것이다. 사람이 운전하면서 카메라 이미지 \(o_t\)와 핸들 조작 \(a_t\)를 기록하고, 이 쌍들을 훈련 데이터로 삼아 지도학습으로 \(\pi_\theta(a_t \mid o_t)\)를 학습한다. 이를 행동 복제(behavioral cloning) 라 한다. 이산 행동이면 분류 문제, 연속 행동이면 회귀 문제와 같다.
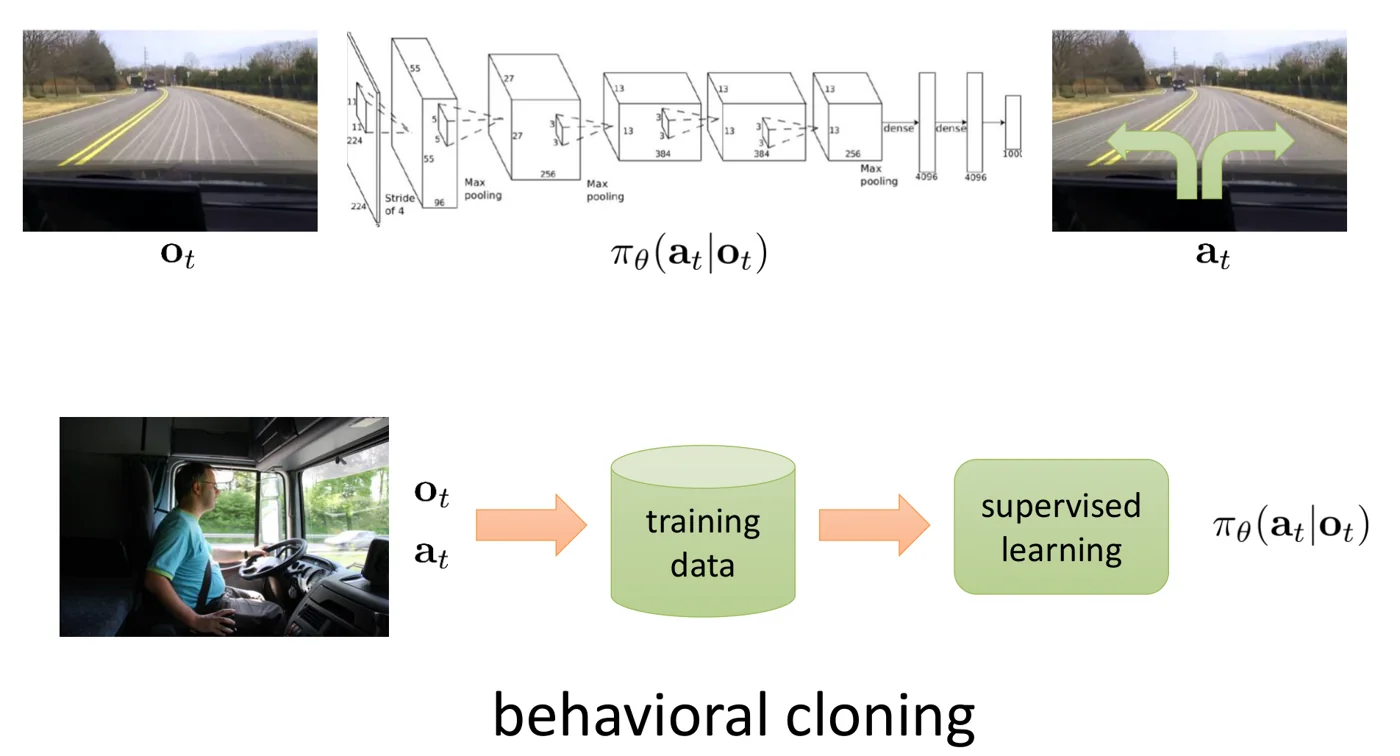 행동 복제. 위: 도로 이미지 \(o_t\)에서 조향 행동 \(a_t\)를 내는 정책. 아래: 사람이 운전하며 \((o_t, a_t)\)를 기록하고, 이를 훈련 데이터로 지도학습해 \(\pi_\theta(a_t \mid o_t)\)를 얻는다. 출처: CS 182 Lecture 14 slides.
그림 아래쪽 파이프라인이 행동 복제의 전부다. 운전자가 평소처럼 운전하는 동안 앞 유리의 카메라 이미지와 그 순간의 핸들 각도를 함께 기록한다. 이렇게 모인 쌍은 이미지 분류 데이터셋과 형식이 같다. “이 이미지에서는 이 행동”이라는 입력-레이블 쌍이므로, 지금까지 배운 지도학습을 그대로 적용할 수 있다. 위쪽 그림의 정책 네트워크는 이미지 분류에 쓰던 CNN 구조와 같고, 출력만 클래스 대신 왼쪽/직진/오른쪽 같은 행동이다.
\[\theta^\star = \arg\max_\theta \sum_{(o_t, a_t) \in \mathcal{D}} \log \pi_\theta(a_t \mid o_t)\]이것이 잘 작동할까? 슬라이드의 답은 두 가지다. 원리적으로는 “아니다”. 그런데 실제로는 NVIDIA의 자율주행 실험(Bojarski et al. 2016)처럼 “잘 된다”는 사례도 있다. 다음 파트에서 왜 원리적으로 안 되는지, 그리고 왜 가끔은 되는지를 살펴본다.
행동 복제가 작동하게 만들기 (Getting Behavioral Cloning to Work)
문제: 분포 이동
학습된 정책은 전문가와 완전히 같을 수 없으므로 작은 실수를 한다. 실수를 하면 전문가 데이터에서 본 적 없는 약간 다른 관측에 도달한다. 처음 보는 관측에서는 정책이 더 크게 틀리고, 그러면 더 낯선 관측에 도달한다. 이렇게 오차가 누적되어 궤적이 훈련 궤적에서 점점 멀어진다.
이를 식으로 쓰면 다음과 같다. 정책은 전문가의 관측 분포 \(p_{\text{data}}(o_t)\)에서 훈련되지만, 테스트할 때는 자기 자신이 만든 관측 분포 \(p_{\pi_\theta}(o_t)\)에서 실행된다.
\[p_{\text{data}}(o_t) \neq p_{\pi_\theta}(o_t)\]이것이 분포 이동(distributional shift) 이다.
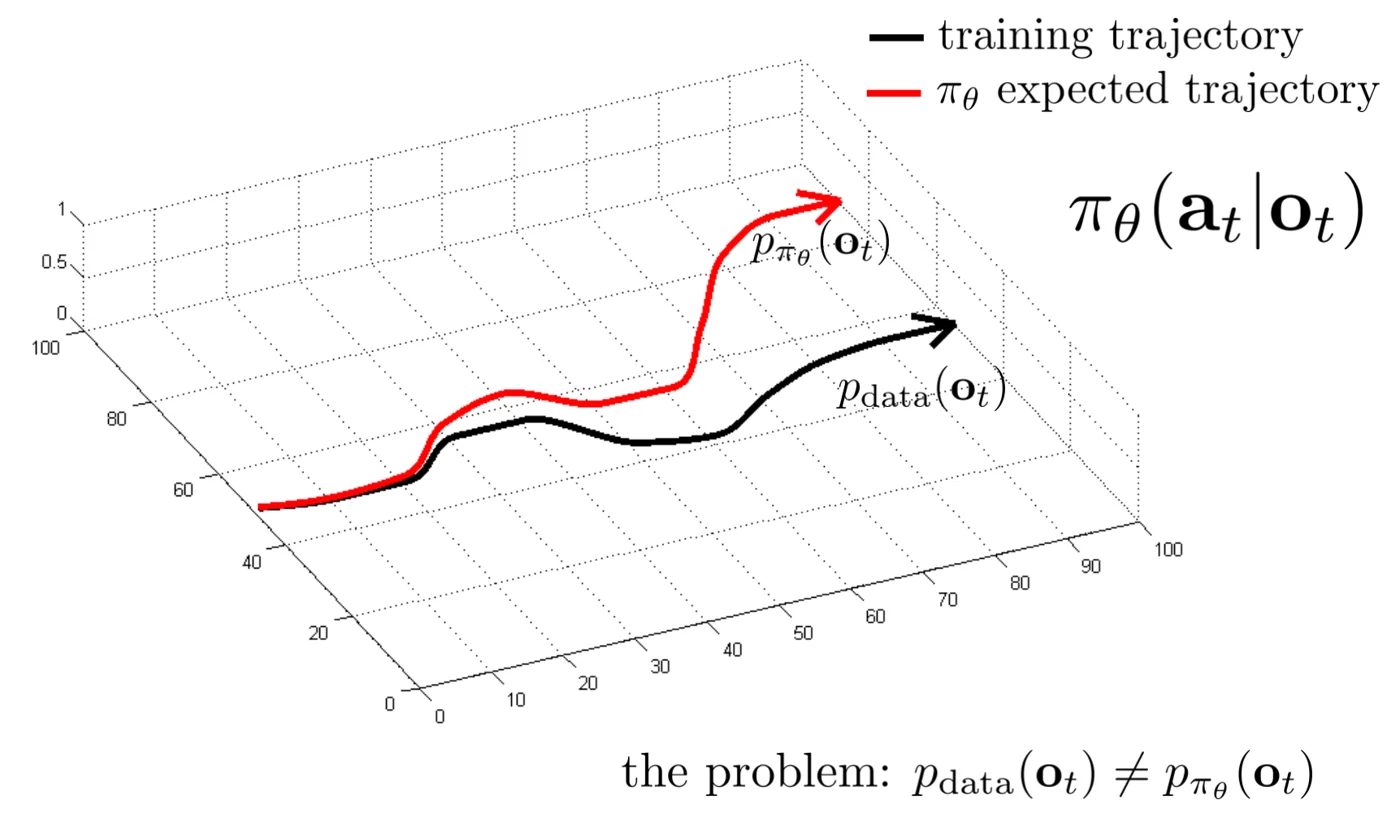 검은 선은 전문가의 훈련 궤적(\(p_{\text{data}}(o_t)\)), 빨간 선은 학습된 정책을 실행했을 때의 궤적(\(p_{\pi_\theta}(o_t)\))이다. 처음에는 겹치지만 작은 차이가 쌓여 점점 벌어진다. 출처: CS 182 Lecture 14 slides.
그림에서 두 궤적은 왼쪽 시작점에서 거의 겹친다. 정책이 훈련 데이터에 잘 맞춰져 있으므로 처음 몇 단계는 전문가와 비슷하게 움직인다. 그러나 첫 번째 굴곡에서 빨간 선이 아주 조금 위로 벗어난다. 이제 정책은 훈련 궤적 위가 아니라 그 약간 옆의 관측을 보게 되는데, 이 관측은 훈련 데이터에 드물게 있거나 없으므로 정책의 예측이 덜 정확하다. 그래서 다음 굴곡에서는 더 크게 벗어나고, 결국 오른쪽 끝에서는 두 궤적이 완전히 다른 곳에 도달한다.
지도학습의 i.i.d. 가정 아래에서는 한 입력에서의 실수가 다른 입력에 영향을 주지 않았다. 여기서는 한 시점의 실수가 다음 시점의 입력을 바꾸므로 오차가 누적된다. 단계당 실수 확률이 \(\epsilon\)으로 작더라도, 한번 벗어나면 돌아오지 못하는 최악의 경우 궤적 길이 \(T\)에 대해 전체 오차가 \(O(\epsilon T^2)\)까지 커질 수 있다는 분석이 알려져 있다(Ross et al., 2011).
앞에서 본 문제와 같다
이 문제는 시퀀스 모델에서 이미 본 적이 있다. 언어 모델을 “I”로 시작해 샘플링한다고 하자. 다음 단어 분포가 think 0.6, like 0.3, drive 0.1일 때 운 나쁘게 확률이 낮은 “drive”를 뽑을 수 있다. 모델은 훈련 중 “I drive”라는 입력을 본 적이 없으므로 그다음에 hippo, paintbrush 같은 엉뚱한 단어를 내놓는다.
훈련 때 네트워크는 항상 진짜 시퀀스를 입력으로 받았지만, 테스트 때는 자기 자신의(틀릴 수 있는) 예측을 입력으로 받는다. 입력 분포가 진짜 문자열에서 합성 문자열로 이동하므로 이것도 분포 이동이다. 제어에서의 문제와 본질적으로 같다.
같은 해법을 쓸 수 없는 이유
시퀀스 모델에서는 예정된 샘플링(scheduled sampling) 으로 이 문제를 완화했다. 훈련 중에 일부 시점에서 정답 대신 모델 자신의 예측을 입력으로 넣는 방법이다. 제어에서는 이것이 간단하지 않다. 정책의 행동이 다음 관측을 결정하므로, 정책 자신의 행동으로 얻는 관측을 만들려면 실제 환경에서 정책을 실행해야 한다. 또 그렇게 도달한 새 관측에서 올바른 행동이 무엇인지에 대한 레이블도 없다. 이 문제는 마지막 파트의 DAgger에서 다룬다.
전문가를 잘 맞추지 못하는 이유
분포 이동을 줄이는 한 가지 방법은 전문가를 아주 정확하게 따라 하여 실수 자체를 줄이는 것이다. 그런데 전문가를 맞추는 데 실패하는 대표적인 이유가 두 가지 있다.
1. 비마르코프적 행동(non-Markovian behavior). \(\pi_\theta(a_t \mid o_t)\)는 현재 관측에만 의존한다. 같은 관측을 두 번 보면 이전에 무슨 일이 있었든 같은 행동을 한다. 사람 시연자에게 이는 매우 부자연스럽다. 사람의 행동은 과거 관측 전체에 의존한다. 즉 실제 전문가는 \(\pi(a_t \mid o_1, \dots, o_t)\)에 가깝다.
과거 전체를 쓰는 단순한 방법은 여러 프레임을 이어 붙여 입력으로 넣는 것이다. 그러나 프레임 수가 가변적이고, 가중치가 너무 많아진다. 더 나은 방법은 RNN이다. 각 시점의 이미지를 공유된 가중치의 CNN으로 인코딩하고, 그 특징을 RNN 상태로 누적하여 행동을 출력한다. 슬라이드는 이런 구조에서 보통 LSTM 셀이 더 잘 작동한다고 적는다.
2. 다봉 행동(multimodal behavior). 나무를 피할 때 전문가는 왼쪽으로 돌 수도 있고 오른쪽으로 돌 수도 있다. 연속 행동을 하나의 가우시안으로 출력하면 두 모드의 평균, 즉 나무 정면으로 직진하는 행동이 나온다. 이산 행동에서는 softmax가 임의의 분포를 표현할 수 있으므로 문제가 덜하지만, 연속 행동에서는 표현력 있는 분포가 필요하다.
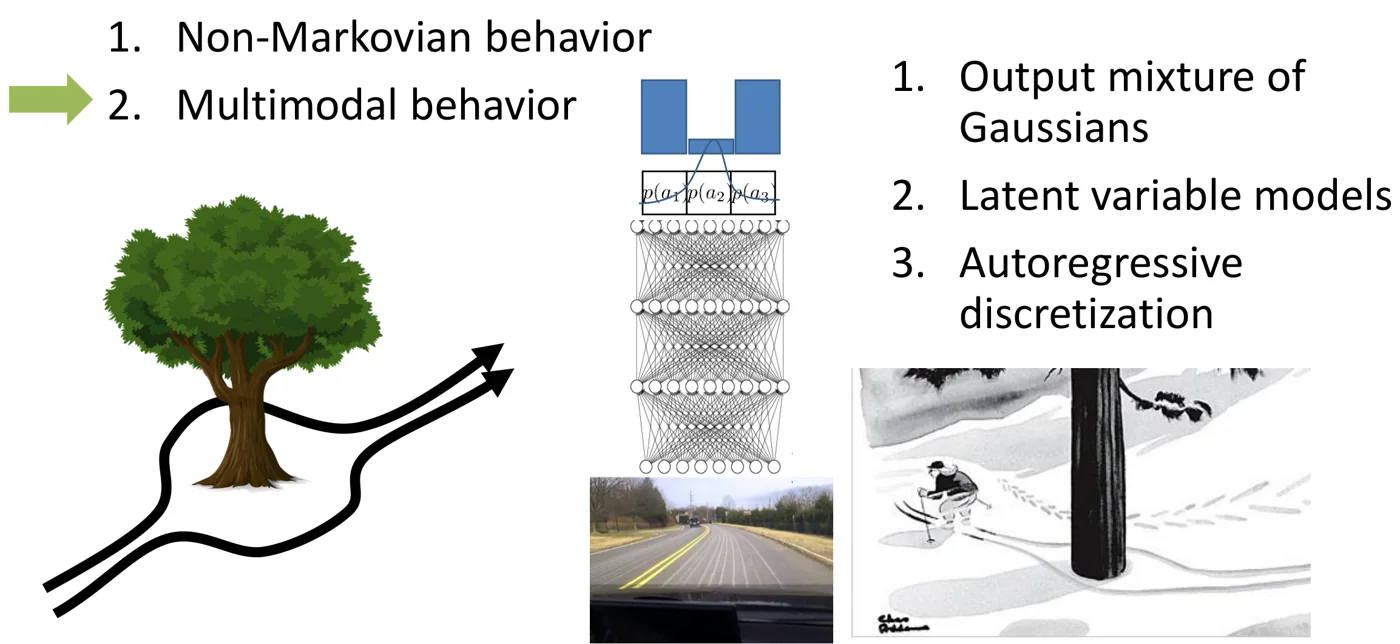 나무를 피하는 두 경로(왼쪽)와, 이산 행동 분포(가운데 위의 막대)와 단일 가우시안(곡선)의 비교. 오른쪽 만화는 두 모드의 평균을 따르면 생기는 일을 보여 준다. 출처: CS 182 Lecture 14 slides.
그림 가운데 위의 막대그래프가 이산 행동의 경우다. 행동이 왼쪽(\(a_1\)), 직진(\(a_2\)), 오른쪽(\(a_3\)) 세 가지이면 softmax 출력은 왼쪽과 오른쪽에 높은 확률을, 직진에 낮은 확률을 주는 두 봉우리 분포를 그대로 표현할 수 있다. 같은 그림에 겹쳐 그린 종 모양 곡선은 연속 행동을 하나의 가우시안으로 표현한 경우로, 평균이 두 봉우리 사이, 즉 직진에 놓인다. 오른쪽 만화의 스키어처럼, 왼쪽으로도 오른쪽으로도 가지 않고 나무 정면으로 가는 행동이 가장 확률이 높은 행동이 되어 버린다.
슬라이드는 연속 행동에서 이 문제를 피하는 세 가지 방법을 든다.
- 가우시안 혼합 출력(mixture of Gaussians). 네트워크가 혼합 가중치 \(w_i\), 평균 \(\mu_i\), 분산 \(\Sigma_i\)를 출력하여 \(\pi(a \mid o) = \sum_{i} w_i \, \mathcal{N}(a; \mu_i, \Sigma_i)\)로 표현한다. 단순하지만 모드의 개수를 미리 정해야 한다.
- 잠재 변수 모델(latent variable models). 네트워크에 이미지와 함께 무작위 잡음 \(z\)를 입력으로 넣어, 잡음에 따라 서로 다른 모드의 행동이 나오게 한다. 학습이 더 어렵지만 표현력이 크다. 슬라이드는 조건부 변분 오토인코더(conditional VAE), normalizing flow/realNVP, Stein variational gradient descent를 찾아볼 것을 권한다.
- 자기회귀 이산화(autoregressive discretization). 행동의 각 차원을 이산화한다. 먼저 1번 차원에 대한 (이산화된) 분포를 softmax로 출력하고 샘플링한다. 그 값을 입력으로 다시 넣어 2번 차원의 분포를 출력하고 샘플링한다. 이렇게 차원마다 순서대로 진행하면 차원 간 결합 분포를 표현할 수 있다. 언어 모델이 단어를 하나씩 생성하는 것과 같은 원리다.
다봉 분포를 모델링하는 더 나은 방법은 나중에 생성 모델을 다룰 때 배운다.
왜 NVIDIA 자율주행은 작동했나
Bojarski et al.(2016)의 시스템은 차량에 왼쪽, 가운데, 오른쪽 세 대의 카메라를 달았다. 가운데 카메라 이미지에는 운전자의 실제 핸들 각도를 레이블로 붙인다. 왼쪽 카메라 이미지는 차가 왼쪽으로 치우쳤을 때 보이는 장면과 비슷하므로, 오른쪽으로 꺾는 보정 레이블을 붙인다. 오른쪽 카메라는 반대로 왼쪽으로 꺾는 레이블을 붙인다. 이미지에 무작위 이동과 회전도 가한다.
이 트릭은 전문가 궤적에서 약간 벗어난 관측과, 거기서 원래 궤적으로 돌아오는 행동을 데이터에 추가한다. 즉 분포 이동으로 도달할 상태에서의 교정 행동을 미리 가르쳐 준다.
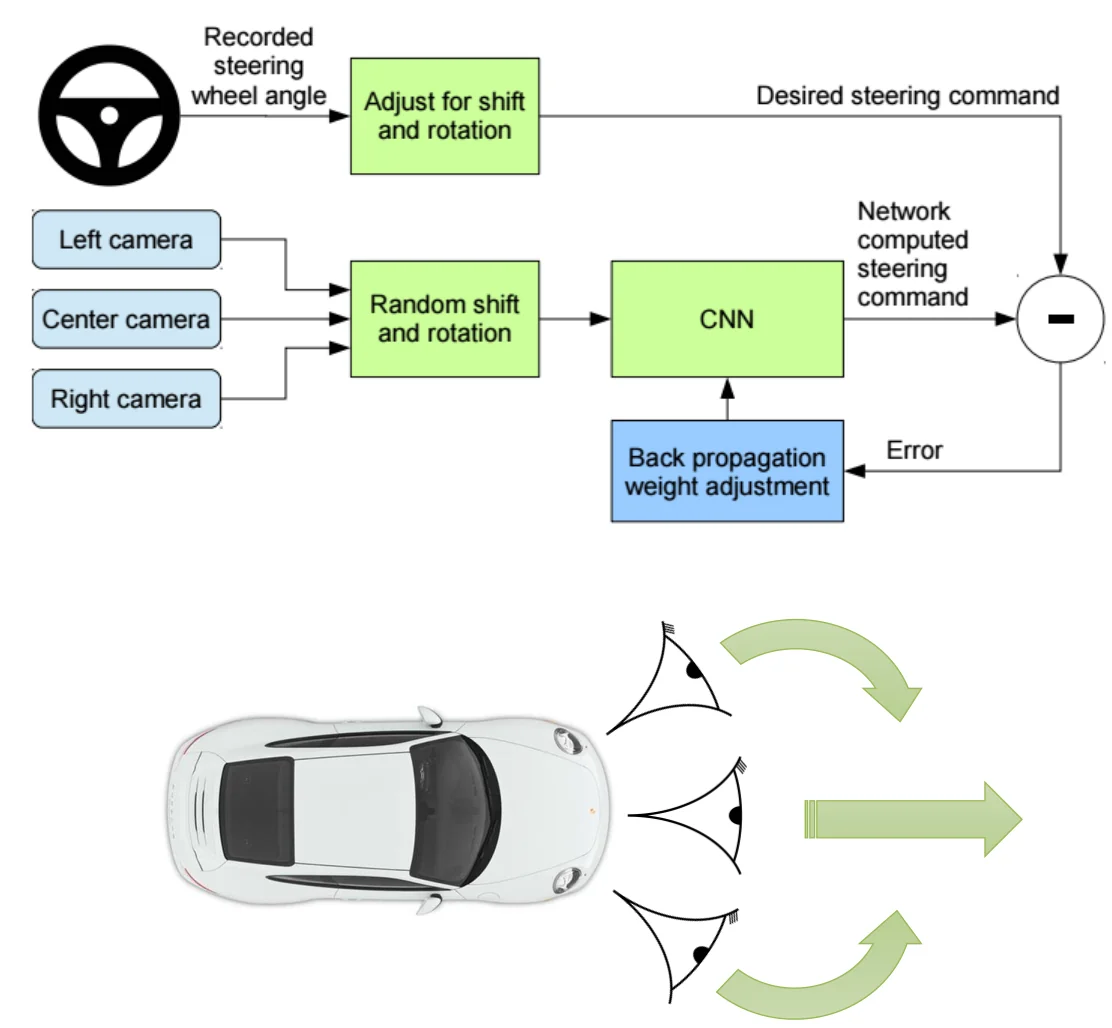 NVIDIA 자율주행의 학습 구조. 세 카메라 이미지에 무작위 이동·회전을 가해 CNN에 넣고, 기록된 핸들 각도를 같은 이동·회전에 맞게 보정한 값과의 오차로 학습한다. 아래 그림은 옆 카메라에 되돌아오는 방향의 행동을 붙이는 아이디어다. 출처: CS 182 Lecture 14 slides.
그림 위쪽 블록도를 보면 학습 신호가 두 경로로 만들어진다. 아래 경로에서는 왼쪽·가운데·오른쪽 카메라 이미지가 “Random shift and rotation”을 거쳐 CNN에 들어가 핸들 명령을 낸다. 위 경로에서는 운전자가 실제로 조작한 핸들 각도가 “Adjust for shift and rotation”을 거친다. 이미지를 옆으로 옮기거나 돌렸다면 차가 그만큼 비뚤어진 것과 같으므로, 그 상황에서 차선 중앙으로 돌아오려면 핸들을 얼마나 더 꺾어야 하는지를 반영해 레이블을 고친다. 두 값의 차이가 오차가 되어 역전파된다.
아래 그림은 이 아이디어를 직관적으로 보여 준다. 가운데 카메라에는 직진 화살표가, 왼쪽을 향한 카메라에는 오른쪽으로 돌아오는 화살표가, 오른쪽을 향한 카메라에는 왼쪽으로 돌아오는 화살표가 붙는다. 결과적으로 훈련 데이터에 “궤적에서 약간 벗어난 관측”과 “거기서 돌아오는 행동”이 함께 들어가므로, 앞의 분포 이동 그림에서 빨간 선이 벗어나기 시작할 때 다시 검은 선으로 끌어당기는 정책이 학습된다.
요약
- 원리적으로 행동 복제는 분포 이동 때문에 작동하지 않아야 한다.
- 그러나 가끔은 잘 작동한다. 다음과 같은 노력이 필요하다.
- 문제에 맞춘 트릭(예: 왼쪽/오른쪽 카메라 이미지)
- 기억을 가진 모델(RNN)
- 더 나은 분포 모델링(다봉 분포)
- 전반적으로 높은 정확도를 얻도록 신경 쓰기
DAgger: 데이터셋 집계 (Dataset Aggregation)
관점 바꾸기
문제는 \(p_{\text{data}}(o_t) \neq p_{\pi_\theta}(o_t)\)였다. 앞 파트는 정책을 더 정확하게 만들어 \(p_{\pi_\theta}(o_t)\)를 \(p_{\text{data}}(o_t)\)에 가깝게 하려 했다. 반대로 접근할 수도 있다. \(p_{\pi_\theta}\)에 대해 영리해지는 대신 \(p_{\text{data}}\)에 대해 영리해지는 것이다. 즉 훈련 데이터를 \(p_{\text{data}}(o_t)\)가 아니라 \(p_{\pi_\theta}(o_t)\)에서 모은다.
방법은 간단하다. 그냥 \(\pi_\theta(a_t \mid o_t)\)를 실행하면 된다. 다만 그렇게 얻은 관측에 대한 행동 레이블 \(a_t\)가 필요하다.
알고리즘
DAgger(Dataset Aggregation, Ross et al. 2011)는 다음을 반복한다.
- 사람 데이터 \(\mathcal{D} = \{o_1, a_1, \dots, o_N, a_N\}\)로 \(\pi_\theta(a_t \mid o_t)\)를 훈련한다.
- \(\pi_\theta(a_t \mid o_t)\)를 실행하여 관측 데이터 \(\mathcal{D}_\pi = \{o_1, \dots, o_M\}\)을 얻는다.
- 사람에게 \(\mathcal{D}_\pi\)의 각 관측에 대해 올바른 행동 \(a_t\)를 레이블로 달게 한다.
- 집계한다: \(\mathcal{D} \leftarrow \mathcal{D} \cup \mathcal{D}_\pi\).
반복할수록 데이터셋에는 정책이 실제로 방문하는 관측이 점점 더 많이 들어간다. 결국 훈련 분포와 테스트 분포가 일치하게 되며, 이것이 분포 이동을 해결하는 원리다. 슬라이드는 예시로 DAgger로 학습한 드론이 숲속에서 나무를 피하며 비행하는 영상을 보여 준다.
무엇이 문제인가
DAgger의 약점은 3단계다. 정책이 방문한 관측마다 사람이 올바른 행동을 달아야 한다. 이는 비용이 크고, 부자연스럽기도 하다. 사람은 직접 운전하면서 시연하는 것은 잘하지만, 이미지 한 장만 보고 “여기서는 핸들을 몇 도 꺾어야 한다”고 답하는 것은 어렵다. 또한 정책을 실제 환경에서 실행해야 하므로 데이터 수집 비용도 든다.
요약과 권장
- 원리적으로 행동 복제는 작동하지 않아야 한다. 분포 불일치 문제 때문이다.
- DAgger는 이 문제를 해결할 수 있지만 비싼 데이터 수집과 레이블링이 필요하다.
- 행동 복제는 가끔 잘 작동하지만, 약간의 (휴리스틱) 트릭과 아주 정확한 모델이 필요하다.
- 슬라이드의 권장은 “행동 복제를 먼저 시도하되, 실망할 준비를 하라”이다.
다음 강의부터는 앞에서 든 제어의 세 가지 어려움(독립이 아닌 데이터, 고수준 감독, 과제 달성이라는 목표)을 강화학습으로 다룬다.
정리
- 제어 문제에서는 i.i.d. 가정이 깨진다. 행동이 미래 입력을 바꾸고, 감독은 고수준 목표일 수 있으며, 목표는 과제 달성이다.
- 관측 \(o_t\), 상태 \(s_t\), 행동 \(a_t\), 정책 \(\pi_\theta(a_t \mid o_t)\)를 구분한다. 상태는 마르코프 성질을 만족하고 관측은 일반적으로 그렇지 않다.
- 행동 복제는 전문가의 관측-행동 쌍으로 정책을 지도학습하는 방법이다.
- 행동 복제의 근본 문제는 분포 이동 \(p_{\text{data}}(o_t) \neq p_{\pi_\theta}(o_t)\)로, 작은 실수가 누적되어 낯선 상태로 이어진다. 시퀀스 모델의 훈련/테스트 불일치와 같은 문제다.
- 전문가를 정확히 맞추려면 비마르코프적 행동(RNN으로 과거 활용)과 다봉 행동(가우시안 혼합, 잠재 변수, 자기회귀 이산화)을 다뤄야 한다. 왼쪽/오른쪽 카메라 같은 보정 데이터도 도움이 된다.
- DAgger는 정책을 실행해 얻은 관측에 전문가 레이블을 받아 데이터셋에 집계함으로써 \(p_{\text{data}}\)를 \(p_{\pi_\theta}\)에 맞춘다. 대신 레이블링 비용이 크다.