- UC Berkeley CS 182 (Spring 2021) 13강 정리
- 강의: Sergey Levine
- 관련 Discussion: Discussion 8
단어 임베딩 (Word Embeddings)
핵심 아이디어: 비지도 사전학습
딥러닝은 데이터가 많을수록 잘 작동한다. 좋은 소식은 텍스트 데이터가 넘쳐 난다는 것이고, 나쁜 소식은 대부분 레이블이 없다는 것이다. 책, 뉴스, 웹의 올바른 영어 텍스트처럼 레이블 없는 데이터가 영어-프랑스어 번역 쌍 같은 레이블/짝 데이터보다 수천 배 많다. 큰 과제는 자유롭게 구할 수 있는 레이블 없는 텍스트를 NLP 딥러닝에 어떻게 활용하느냐 다.
레이블 없는 데이터로 언어의 표현을 학습한 뒤, 이를 번역 등 하류(downstream) 작업에 쓰는 것이 목표다. 표현에는 두 가지 층위가 있다.
| 표현 | 예 |
|---|---|
| 지역적이고 문맥에 무관한(non-contextual) 표현 | 단어 임베딩 |
| 전역적이고 문맥에 의존하는(context-dependent) 표현 | 사전학습 언어 모델, 문장 임베딩 |
단어를 어떻게 표현할까
원-핫 벡터는 차원이 어휘 크기이고 해당 단어 인덱스만 1이다. 이미지의 픽셀은 그 자체로 무언가를 의미한다(좋은 거리 공간은 아니어도). 반면 원-핫 벡터는 그 자체로 거의 아무 의미도 없다. 모든 단어 쌍이 똑같이 떨어져 있다.
단어 표현이 더 의미 있다면 하류 작업의 학습이 훨씬 쉬울 것이다. 여기서 “의미 있다”는 것은 비슷한 단어에 해당하는 벡터가 서로 가깝다 는 뜻이다.
임베딩을 학습하는 원리
기본 아이디어는 단어의 의미는 그 근처에 어떤 단어가 나타나는지로 결정된다 는 것이다. 바꿔 말하면, 서로 바꿔 써도 되는 단어일수록 더 비슷하다. “Seattle hotel”과 “Seattle motel”이 그 예다. 따라서 각 단어의 표현을, 그 단어의 이웃이 그 표현 아래에서 “가깝도록” 고른다.
이웃 예측으로 정식화하기
단어의 임베딩으로부터 이웃 단어를 예측할 수 있을까? 텍스트에서 위치 \(t\)의 중심 단어(center word) \(c\)와, 크기 2(또는 5 등)의 창(window) 안에 있는 문맥 단어(context word) \(o\)를 생각한다. 각 단어 \(w\)마다 학습되는 벡터 \(u_w, v_w\)를 두고
\[p(o \mid c) = \frac{\exp(u_o^\top v_c)}{\sum_{w \in V} \exp(u_w^\top v_c)}\]로 정의한다. \(V\)는 전체 어휘다.
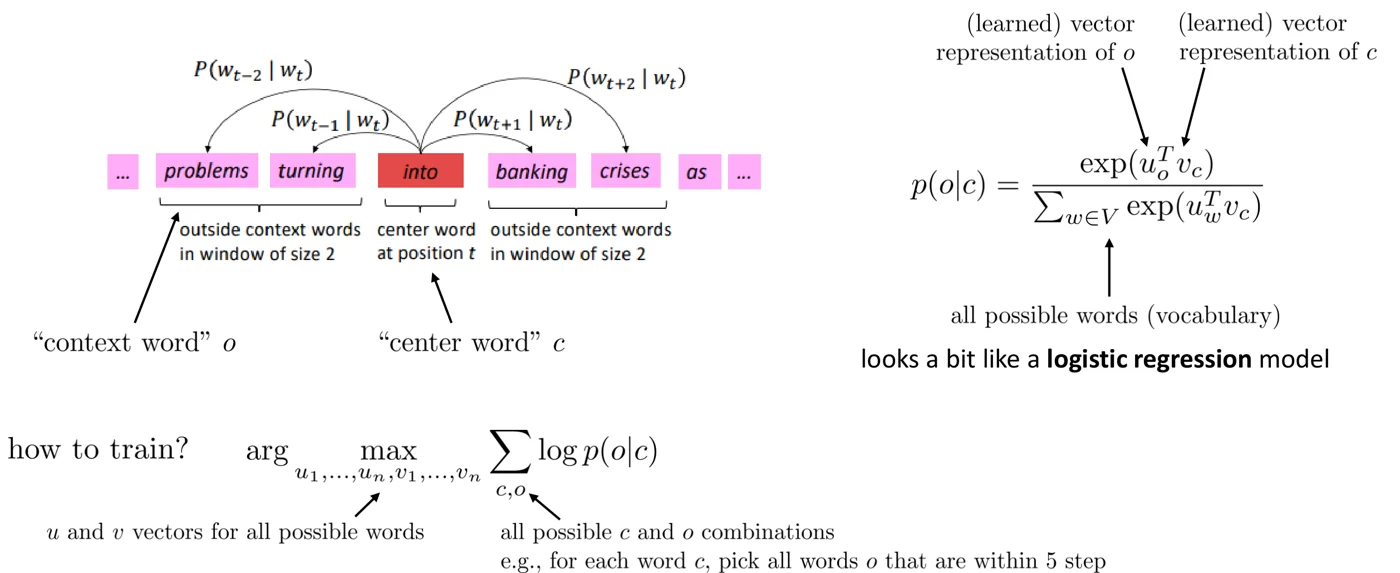 “… problems turning into banking crises as …“에서 중심 단어 into와 크기 2 창 안의 문맥 단어 넷. 화살표는 중심 단어로 각 문맥 단어를 예측하는 확률 \(P(w_{t+j} \mid w_t)\)다. 출처: CS 182 Lecture 13 slides.
그림 왼쪽의 문장에서 빨간 칸 “into”가 위치 \(t\)의 중심 단어 \(c\)이고, 양옆 두 단어씩(problems, turning, banking, crises)이 문맥 단어 \(o\)다. 위쪽의 곡선 네 개가 학습 신호로, 각각 \(P(w_{t-2} \mid w_t)\), \(P(w_{t-1} \mid w_t)\), \(P(w_{t+1} \mid w_t)\), \(P(w_{t+2} \mid w_t)\)를 크게 만들도록 학습한다. 이 창을 문장 전체에 한 칸씩 밀며 모든 (중심, 문맥) 쌍을 모으면, 그림 아래의 \(\sum_{c,o} \log p(o \mid c)\)가 된다.
오른쪽 식에서 \(u_o\)는 단어가 문맥 단어로 쓰일 때의 벡터, \(v_c\)는 중심 단어로 쓰일 때의 벡터다. 두 벡터의 내적이 크면 함께 나타날 확률이 높다. 같은 문맥(예: “turning into”, “into crises”)에 자주 나타나는 두 단어는 같은 \(u\)들과 내적이 커지도록 학습되므로, 결국 두 단어의 \(v\)도 서로 가까워진다. 이것이 “이웃이 비슷하면 의미가 비슷하다”는 원리를 학습으로 구현하는 방식이다.
로지스틱 회귀(정확히는 softmax 회귀)와 비슷한 모양이다. 학습은 가능한 모든 \((c, o)\) 조합(예: 각 \(c\)에 대해 5단어 이내의 모든 \(o\))의 로그 우도를 최대화한다.
\[\arg\max_{u_1, \dots, u_n, v_1, \dots, v_n} \sum_{c,o} \log p(o \mid c)\]word2vec
이것이 word2vec (Mikolov et al., 2013)이다. 파라미터 \(\theta\)는 모든 단어의 \(v\)와 \(u\)를 쌓은 벡터다.
- 왜 벡터를 두 개 두는가? 최적화가 쉬워진다.
- 학습이 끝나면? 두 벡터를 평균한다.
- 이렇게 단어의 표현을 얻는다.
word2vec을 계산 가능하게 만들기
문제는 어휘가 거대할 수 있다는 것이다. softmax의 분모 \(\sum_{w \in V} \exp(u_w^\top v_c)\)는 모든 단어에 대한 합이라 계산 비용이 매우 크다.
다른 발상은 “이것이 맞는 단어인가 아닌가”라는 이진 분류 문제로 바꾸는 것이다.
\[p(o \text{ is the right word} \mid c) = \sigma(u_o^\top v_c) = \frac{1}{1 + \exp(-u_o^\top v_c)}\]그러나 이것만으로는 부족하다. 맞는 쌍만 보고 확률을 높이면, 모든 벡터를 같은 방향의 아주 큰 벡터로 만들어 모든 \(\sigma\)를 1로 만드는 자명한 해가 생긴다. 따라서 틀린 단어에 대한 확률도 함께 학습해야 한다.
\[p(o \text{ is the wrong word} \mid c) = \sigma(-u_o^\top v_c) = \frac{1}{1 + \exp(u_o^\top v_c)}\]틀린 단어 \(w\)는 무작위로 뽑은 음성 샘플(negatives) 이다. 목적 함수는 다음과 같다.
\[\arg\max_{u_1, \dots, u_n, v_1, \dots, v_n} \sum_{c,o} \left( \log \sigma(u_o^\top v_c) + \sum_{w} \log \sigma(-u_w^\top v_c) \right)\]이것이 네거티브 샘플링(negative sampling) 이다. 직관적으로, \(v_c\)를 실제 문맥 단어의 \(u_o\) 쪽으로 당기고, 다른 단어 벡터 \(u_w\)에서는 밀어낸다.
word2vec 예시
학습된 임베딩에서는 의미 관계가 벡터의 차로 나타나는 대수적 관계가 관찰된다.
\[\text{vec}(\text{woman}) - \text{vec}(\text{man}) \approx \text{vec}(\text{aunt}) - \text{vec}(\text{uncle}) \approx \text{vec}(\text{queen}) - \text{vec}(\text{king})\]성별뿐 아니라 단수와 복수(king → kings, queen → queens), 국가와 수도(France - Paris, Italy - Rome), 형용사와 비교급(big - bigger), 원소와 기호(copper - Cu), 회사와 제품(Microsoft - Windows, Apple - iPhone) 같은 관계도 비슷한 방향의 벡터 차로 나타난다. 다만 이런 그림은 다소 이상화된 것이고, 대부분의 관계는 이렇게 깔끔하지 않다.
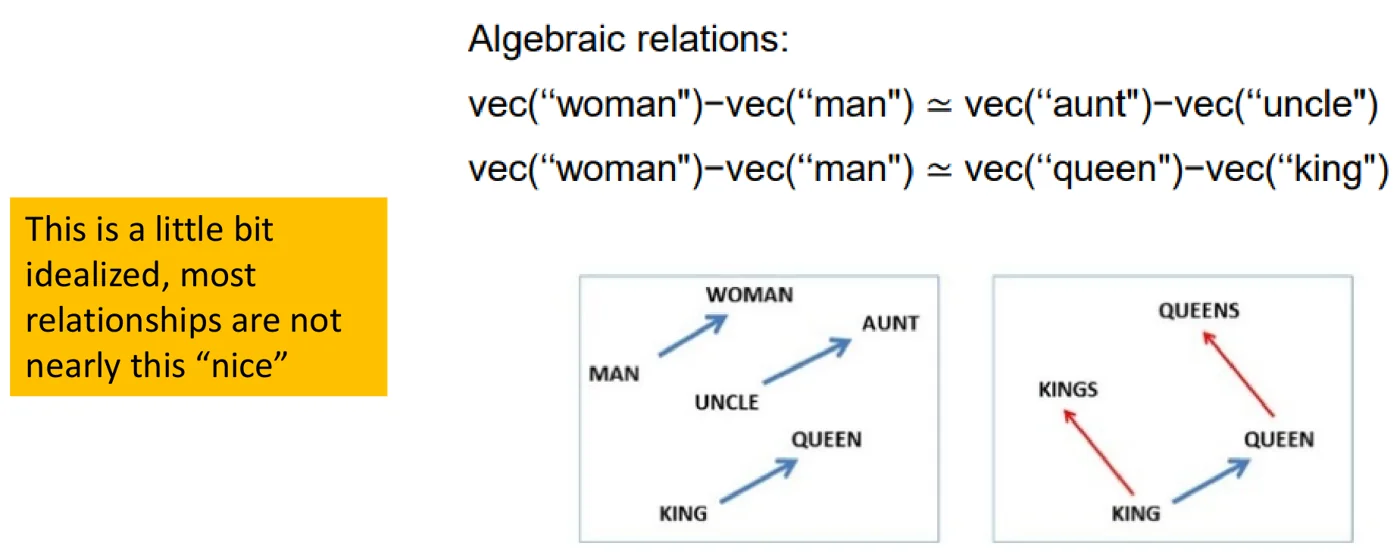 word2vec 공간의 대수적 관계. 왼쪽은 man→woman, uncle→aunt, king→queen이 같은 방향의 벡터 차를 갖는 모습, 오른쪽은 단수→복수 관계가 또 다른 공통 방향을 갖는 모습이다. 출처: CS 182 Lecture 13 slides.
왼쪽 그림의 파란 화살표 세 개는 거의 평행하고 길이도 비슷하다. 즉 “남성형에서 여성형으로”라는 관계가 임베딩 공간에서 하나의 방향으로 표현된다. 이 덕분에 \(\text{vec}(\text{king}) - \text{vec}(\text{man}) + \text{vec}(\text{woman})\)을 계산하고 가장 가까운 단어를 찾으면 queen이 나오는 식의 유추가 가능하다. 오른쪽 그림에서 빨간 화살표(king→kings, queen→queens)는 파란 화살표와 다른 방향을 가리키며, 단수→복수라는 별개의 관계를 나타낸다. 한 단어(king)에서 서로 다른 관계 방향으로 이동하면 서로 다른 관련 단어(queen, kings)에 도달하는 것이다.
이런 구조는 학습 목표에 직접 들어 있지 않다. 주변 단어 예측만으로 학습했는데 관계가 선형 구조로 나타난다는 점이 word2vec이 주목받은 이유다. 다만 왼쪽 노란 상자의 지적처럼, 실제 임베딩에서 대부분의 관계는 이렇게 깨끗한 평행선을 이루지 않는다.
word2vec 요약
- 원-핫 벡터 대신 단어 표현으로 쓴다. 하류 응용에 훨씬 의미 있는 표현이다.
- 거대한 레이블 없는 말뭉치로 단어 임베딩을 학습한 뒤, 훨씬 작은 말뭉치로 학습하는 지도 학습 모델의 입력으로 쓸 수 있다.
- 단순한 형태의 비지도 사전학습이라 볼 수 있다.
사전학습 언어 모델과 ELMo
문맥에 따른 표현
단어 임베딩은 단어마다 벡터 하나를 대응시킨다. 원-핫 벡터보다 훨씬 좋지만, 단어가 다른 뜻으로 쓰여도 벡터가 바뀌지 않는다. “Let’s play baseball”의 play(놀이하다)와 “I saw a play yesterday”의 play(연극)는 뜻이 다른데도 word2vec 표현은 같다.
문맥에 의존하는 표현을 배울 수 있을까? 고수준 아이디어는 다음과 같다.
- 언어 모델을 학습한다.
- 문장에 대해 실행한다.
- 그 은닉 상태를 하류 작업의 표현으로 쓴다.
여기서 두 질문이 생긴다. 이 목적에 가장 좋은 언어 모델을 어떻게 학습할 것인가? 그리고 이 언어 모델을 하류 작업에 어떻게 쓸 것인가? 대표적인 답이 (세서미 스트리트 캐릭터 이름을 딴) ELMo와 BERT다.
- ELMo: 문맥 의존 임베딩을 위한 양방향 LSTM 모델
- BERT: 문맥 의존 임베딩을 위한 Transformer 언어 모델
ELMo
ELMo는 두 개의 언어 모델을 학습한다.
- 정방향(forward) LM: 다음 단어를 예측하는 다층 LSTM
- 역방향(backward) LM: 이전 단어를 예측하는 다층 LSTM
두 모델 모두 언어 모델로 학습된다. 예를 들어 “A cute puppy”에서 “cute” 위치에 있는 정방향과 역방향의 모든 은닉 상태가 모여 “cute”라는 단어의 (문맥 속) 표현을 이룬다.
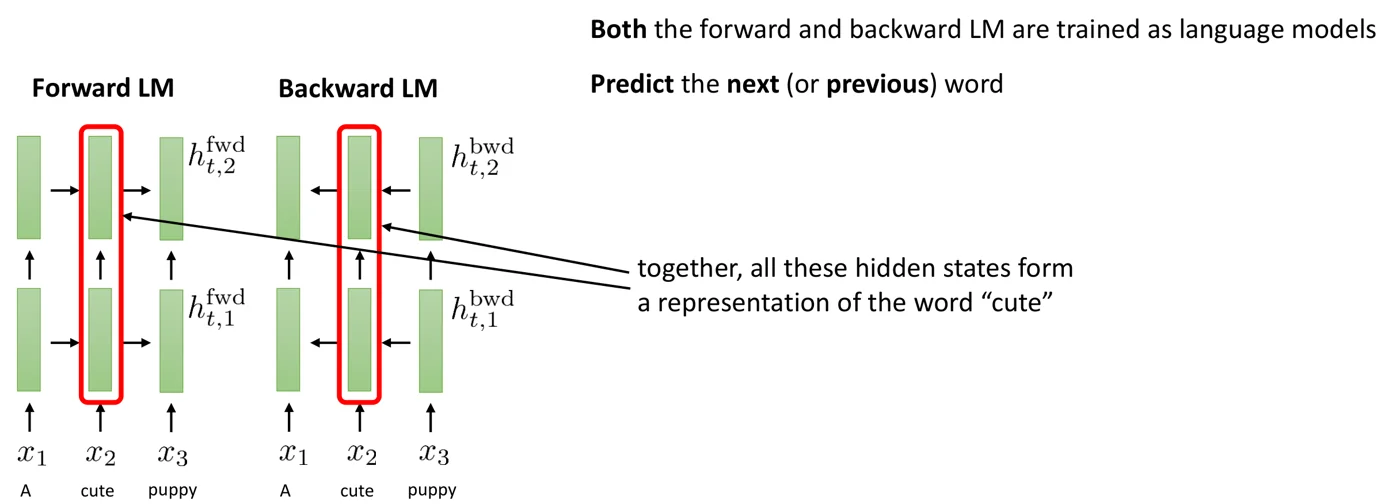 ELMo의 정방향 LM(왼쪽)과 역방향 LM(오른쪽). 빨간 상자로 묶은 “cute” 위치의 은닉 상태 네 개가 함께 “cute”의 표현이 된다. 출처: CS 182 Lecture 13 slides.
그림 왼쪽의 정방향 LM은 2층 LSTM이 A → cute → puppy 순서로 읽으며 오른쪽 화살표로 상태를 전달하고, 각 위치에서 다음 단어를 예측하도록 학습된다. 오른쪽의 역방향 LM은 같은 문장을 puppy → cute → A 순서로 읽으며(왼쪽 화살표) 이전 단어를 예측한다. 따라서 “cute” 위치의 정방향 상태 \(h^{\text{fwd}}_{t,1}, h^{\text{fwd}}_{t,2}\)는 “A”라는 왼쪽 문맥을, 역방향 상태 \(h^{\text{bwd}}_{t,1}, h^{\text{bwd}}_{t,2}\)는 “puppy”라는 오른쪽 문맥을 요약한다.
두 빨간 상자를 합치면 단어 양쪽의 문맥을 모두 반영한 표현이 된다. 같은 단어 “play”라도 앞뒤 단어가 다르면 이 은닉 상태들이 달라지므로, word2vec과 달리 문맥마다 다른 벡터가 나온다. 정방향과 역방향은 따로 학습되므로, 한 모델이 자기 예측 대상을 미리 보는 문제는 생기지 않는다.
ELMo 사용하기
위치 \(t\)에서 층 \(i\)의 정방향, 역방향 은닉 상태를 \(h_{t,i}^{\text{fwd}}, h_{t,i}^{\text{bwd}}\)라 하자(2층이라 하자).
단순한 버전은 최상위 층의 은닉 상태를 이어 붙인다.
\[\text{ELMO}_t = [h_{t,2}^{\text{fwd}};\, h_{t,2}^{\text{bwd}}]\]복잡한 버전은 모든 층의 가중합을 쓴다.
\[\text{ELMO}_t = \gamma \sum_{i=1}^{L} w_i\, [h_{t,i}^{\text{fwd}};\, h_{t,i}^{\text{bwd}}]\]\(\gamma\)와 \(w_i\)는 작업별로 학습되는 가중치이며, 하류 작업의 일부로 학습된다.
이 표현을 하류 모델의 입력에 이어 붙인다. 예를 들어 번역 seq2seq 모델의 인코더 입력에 ELMo 표현을 덧붙일 수 있다. (실제 ELMo 논문은 번역이 아니라 질의응답, 텍스트 함의(textual entailment), 의미역 결정(semantic role labeling), 상호참조 해결(coreference resolution), 개체명 인식, 감정 분석에서 실험했고, 모든 작업에서 성능이 향상되었다.)
ELMo 요약
- 대규모 레이블 없는 텍스트로 정방향과 역방향 언어 모델을 학습한다.
- 정방향과 역방향 LSTM 상태를 이어 붙여 문맥 속 단어를 표현한다.
- 이 ELMo 표현을 단어 임베딩(또는 원-핫 벡터)에 이어 붙여 하류 작업용 시퀀스 모델의 입력으로 쓴다.
- 각 토큰에 대해 문맥에 특화되고 의미적으로 의미 있는 표현을 제공한다.
BERT와 그 친구들
LSTM 대신 Transformer를 쓸 수 있을까
Transformer 디코더(마스크 셀프 어텐션 + 위치별 비선형 네트워크를 N번 반복, 위치별 softmax)는 그 자체로 언어 모델이다. [START] A cute를 넣으면 A cute puppy를 예측한다. 올바른 언어 모델이 되려면 마스킹이 필요하다.
그런데 이 모델에는 방향 이 있다(셀프 어텐션의 마스킹에 따라 정방향). ELMo는 양방향인데 이것은 아니다. Transformer 두 개를 학습해 “Transformer ELMo”를 만들 수도 있지만, 더 좋은 방법은 없을까? 셀프 어텐션의 마스크를 그냥 없애고 Transformer 하나만 쓰면 어떨까?
마스크를 없애면 생기는 문제
마스크를 없애면 정답을 맞히기가 너무 쉬워진다. 시간 \(t\)의 출력이 맞혀야 할 “정답”은 시간 \(t+1\)의 입력인데, 셀프 어텐션이 그 입력에 바로 접근할 수 있기 때문이다. 모델은 아무것도 배우지 않고 다음 입력을 복사하면 된다.
BERT: 마스크 언어 모델
해결책은 입력 토큰 일부를 무작위로 가리는 것이다. 가린다는 것은 토큰을 [MASK]로 바꾼다는 뜻이다.
- 입력: I
[MASK]therefore I[MASK] - 출력: I think therefore I am
이제 입출력을 한 칸 밀 필요가 없다(마스크 어텐션이 필요 없다). 빠진 단어를 예측해야 하므로 모델이 좋은 표현을 배우도록 “열심히 일하게” 된다. 그러면서도 마스크 셀프 어텐션이 필요 없으므로 모델이 양방향 이 된다.
BERT 는 본질적으로 Transformer의 “인코더” 부분이며, 입력의 15%를 [MASK]로 바꿔 학습한다.
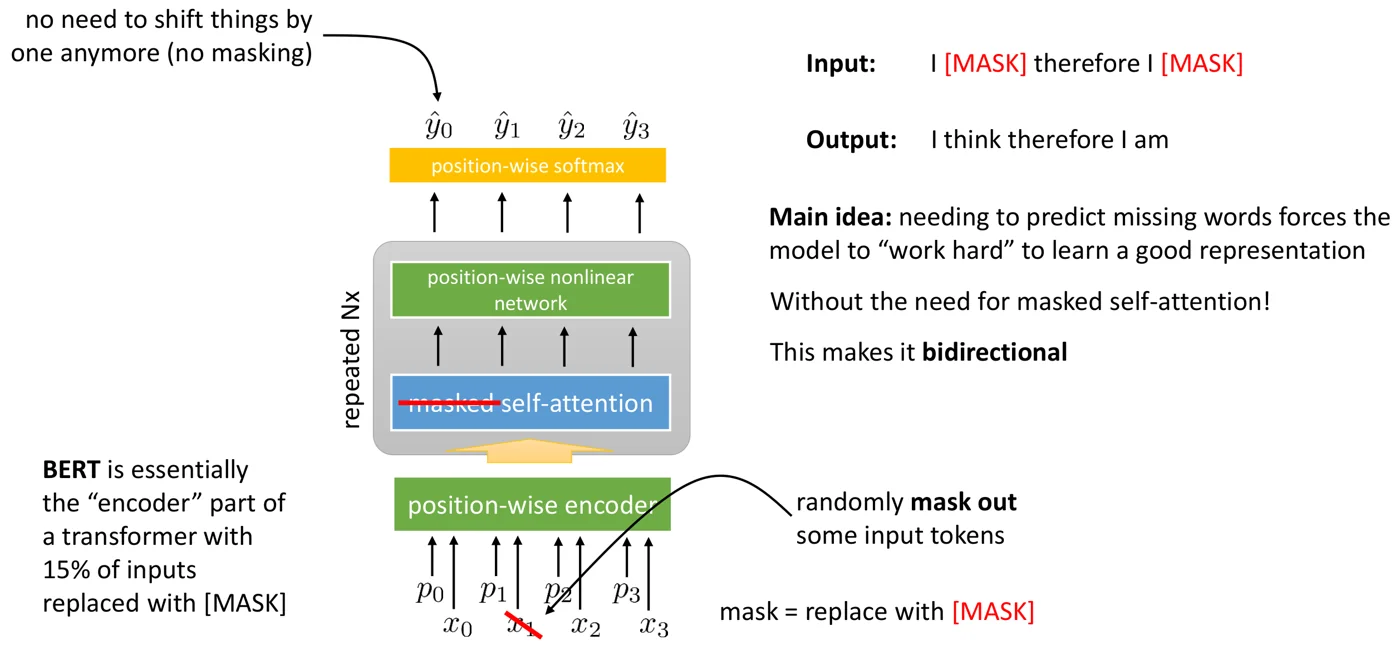 셀프 어텐션의 마스크를 없애고(줄 그은 “masked”) 대신 입력 토큰 일부를
[MASK]로 가린다. 출력은 한 칸 밀리지 않은 \(\hat{y}_0, \dots, \hat{y}_3\)이다. 출처: CS 182 Lecture 13 slides.
그림을 12강의 Transformer 디코더와 비교하면 바뀐 곳이 세 군데다. 첫째, 가운데 블록의 “masked self-attention”에서 “masked”에 줄이 그어져 있다. 모든 위치가 모든 위치를 볼 수 있으므로 양방향이다. 둘째, 맨 아래 입력 \(x_1\)에 빨간 줄이 그어져 있다. 이 토큰이 [MASK]로 바뀌어 모델은 그 자리의 원래 단어를 볼 수 없다. 셋째, 맨 위 출력이 \(\hat{y}_0, \hat{y}_1, \dots\)로 입력과 같은 위치를 가리킨다. 다음 단어가 아니라 그 자리의 단어를 맞히므로 한 칸 밀 필요가 없다.
오른쪽 예에서 입력 “I [MASK] therefore I [MASK]“를 받은 모델은 둘째 자리에 think, 다섯째 자리에 am을 내야 한다. think를 맞히려면 앞의 “I”와 뒤의 “therefore”를 모두 봐야 하므로, 양방향 문맥을 쓰는 표현이 학습된다. 가리지 않은 자리는 입력을 그대로 베끼면 되므로 실제 학습 신호는 주로 가린 자리에서 나온다.
BERT 학습
입력은 두 문장으로 이루어진다. 질의응답이나 자연어 추론(natural language inference)처럼 많은 하류 작업이 두 문장을 함께 처리해야 하기 때문이다. 데이터의 문장 쌍을 두 가지 방식으로 변형한다.
- 토큰의 15%를 무작위로
[MASK]로 바꾼다. - 50% 확률로 두 문장의 순서를 무작위로 바꾼다.
출력은 두 가지다.
- 모든 위치의 토큰을 재구성 한다(
[MASK]자리의 실제 토큰을 예측해야 한다). 이는 문맥 의존적인 단어 수준 표현을 배우게 한다. - 첫 출력 위치에서 이진 분류 를 한다: 첫 문장이 둘째 문장 뒤에 오는가, 앞에 오는가? 이는 문장 수준 표현을 배우게 한다.
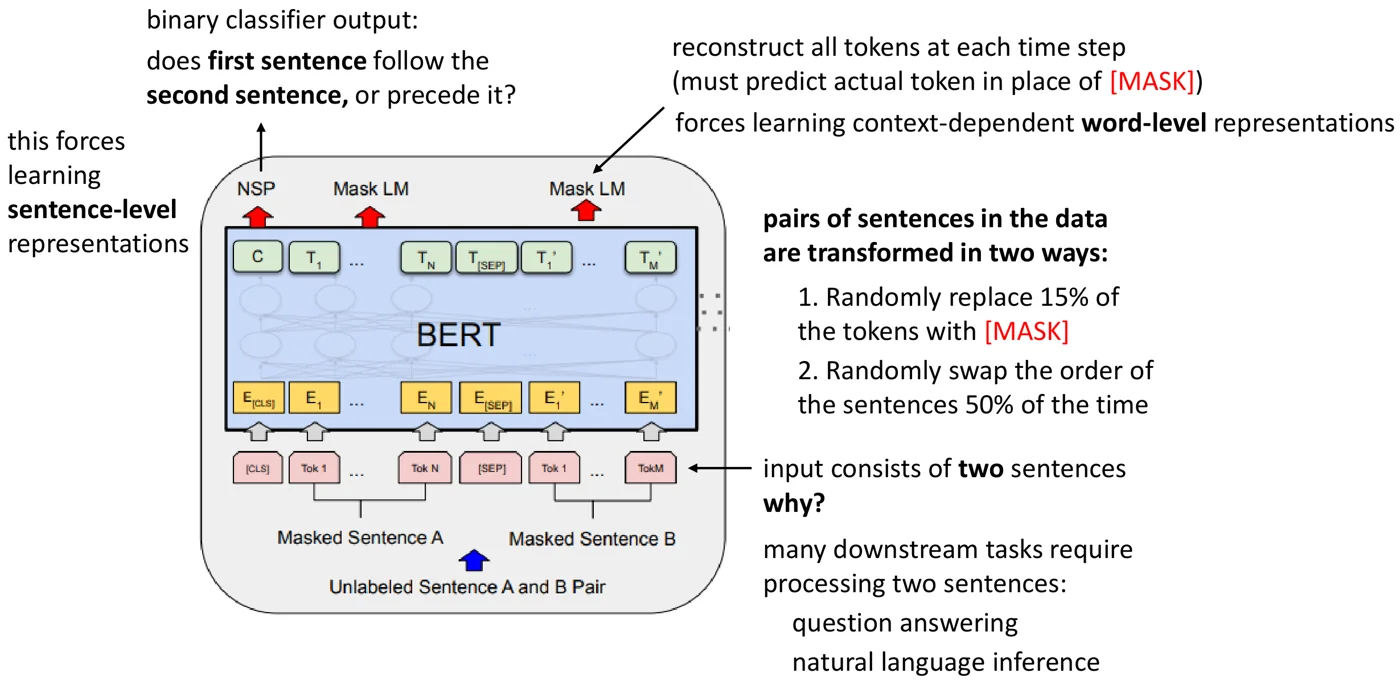 BERT 사전학습. 입력은
[CLS], 문장 A의 토큰, [SEP], 문장 B의 토큰이고, 첫 출력 C에서 문장 순서(NSP)를, 나머지 출력 \(T_i\)에서 가린 토큰(Mask LM)을 예측한다. 출처: CS 182 Lecture 13 slides.
그림 아래쪽부터 보면, 레이블 없는 문장 쌍(A, B)을 가져와 각 문장의 일부 토큰을 가린 뒤, 맨 앞에 특수 토큰 [CLS]를 붙이고 두 문장 사이에 [SEP]를 넣어 한 시퀀스로 만든다. 각 토큰은 임베딩 \(E\)(노랑)가 되어 BERT 본체(여러 층의 양방향 Transformer)를 지나고, 같은 위치의 출력 \(C, T_1, \dots, T_N, T_{[SEP]}, T'_1, \dots, T'_M\)(초록)이 나온다.
출력 위의 빨간 화살표가 두 학습 목표다. [CLS] 위치의 출력 \(C\)에는 NSP(문장 순서) 이진 분류기가 붙는다. 이 자리에는 원래 단어가 없으므로, \(C\)가 두 문장 전체를 요약하는 벡터로 학습된다. 나머지 위치의 출력에는 Mask LM 분류기가 붙어 원래 토큰을 예측한다. 하류 작업에서 문장 분류를 할 때 \(C\)에 새 분류기를 다는 것은, 이 자리가 사전학습 동안 이미 문장 수준 정보를 모으도록 학습되었기 때문이다.
BERT 사용하기
분류 작업(텍스트 함의 분류, Quora 질문 쌍 같은 의미 동등성 판별, 감정 분류 등)에서는 다음과 같이 한다.
- 첫 출력에만 교차 엔트로피 손실을 둔다(문장 순서 분류기를 대체한다).
- 새 작업에 대해 모델 전체를 끝에서 끝까지 미세조정(finetune) 한다.
다른 형태의 작업도 가능하다.
- 위치마다 개체명 레이블(사람 이름, 장소, 기타 범주)을 미세조정해 개체명 인식을 한다.
- 질의응답에서는 문단의 어느 구간(span)이 답을 담고 있는지 표시한다.
또한 ELMo처럼 BERT에서 특징(features)을 추출 해 다른 모델의 입력으로 쓸 수도 있다(예: 여러 층의 은닉 상태를 이어 붙이거나 더한다).
BERT의 성능
BERT는 다양한 자연어 이해 작업 모음인 GLUE 벤치마크에서 매우 좋은 결과를 냈다(12층 BERT-Base, 24층 BERT-Large). 이후 상상할 수 있는 거의 모든 NLP 작업에 적용되었고, 성능을 크게 높이는 경우가 많다.
GPT
한 방향(정방향) Transformer 모델은 BERT에 비해 큰 장점이 하나 있다. 텍스트를 생성할 수 있다 는 것이다. BERT로는 생성이 사실상 불가능하지만, 정방향 마스크 어텐션 모델은 자기회귀로 생성할 수 있다. GPT(GPT-2, GPT-3 등)가 대표적인 예다. 구조는 위치별 인코더(입력 + 위치 인코딩), 마스크 셀프 어텐션과 위치별 비선형 네트워크를 N번 반복, 위치별 softmax로 다음 토큰을 예측하는 Transformer 디코더다. 슬라이드는 안데스 산맥의 유니콘 이야기를 이어 쓰는 GPT-2의 생성 예를 보여 준다.
사전학습 언어 모델 요약
| 모델 | 구조 | 특징 |
|---|---|---|
| ELMo | 양방향 LSTM | 괜찮은 표현 (대부분 BERT로 대체됨) |
| BERT | 양방향 Transformer | 훌륭한 표현, 텍스트 생성 불가 |
| GPT | 한 방향 Transformer | 텍스트 생성 가능, 괜찮은 표현 |
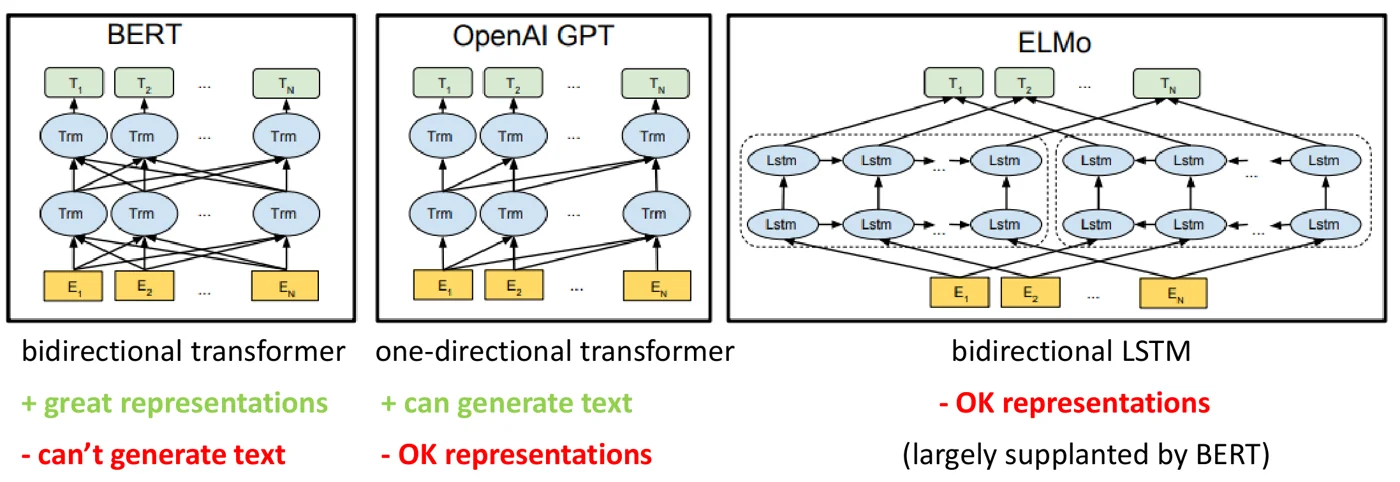 BERT, GPT, ELMo의 연결 구조 비교. 화살표는 각 층의 한 위치가 아래층의 어느 위치에서 정보를 받는지를 나타낸다. 출처: CS 182 Lecture 13 slides.
세 그림 모두 아래가 입력 임베딩 \(E_1, \dots, E_N\), 위가 출력 \(T_1, \dots, T_N\)이다. 차이는 화살표의 방향에 있다. BERT(왼쪽)에서는 각 Trm 노드가 아래층의 모든 위치에서 화살표를 받는다. 마스크 없는 셀프 어텐션이므로 모든 층에서 왼쪽과 오른쪽 문맥이 섞인다. GPT(가운데)에서는 화살표가 왼쪽 아래에서 오른쪽 위로만 향한다. 각 위치는 자기와 그 왼쪽만 보므로 다음 단어 생성이 가능하지만, 표현에는 오른쪽 문맥이 없다.
ELMo(오른쪽)는 왼쪽에서 오른쪽으로 가는 LSTM 묶음과 오른쪽에서 왼쪽으로 가는 LSTM 묶음이 점선 상자로 따로 있고, 마지막에만 두 쪽의 상태가 합쳐진다. 양방향이긴 하지만 두 방향이 깊은 층에서 서로 섞이지 않는 “얕은” 결합이라는 점이 BERT와 다르다. 이 차이가 BERT의 표현이 더 좋은 이유 중 하나로 꼽힌다.
- 언어 모델은 위키피디아 같은 매우 큰 레이블 없는 텍스트(수억에서 수십억 문장)로 학습할 수 있다.
- 내부에서 학습된 표현은 문맥에 의존한다. 단어의 의미가 문장 전체를 반영한다.
- 문장 전체의 표현도 얻을 수 있다(예: BERT의 첫 출력 토큰).
- 표현을 추출해 일반 단어 임베딩을 대체할 수도 있고, 하류 작업에 직접 미세조정할 수도 있다. 미세조정은 사전학습 모델의 은닉 상태만 쓰는 것이 아니라 언어 모델 전체의 가중치를 수정한다는 뜻이다.
- 이 방식이 매우 잘 작동하므로 현대 NLP에서 매우 중요하다.
정리
- 텍스트는 레이블 없는 데이터가 압도적으로 많으므로, 비지도 사전학습으로 언어 표현을 배운 뒤 하류 작업에 쓰는 것이 핵심 전략이다.
- word2vec은 중심 단어로 주변 단어를 예측하도록 단어 벡터를 학습한다. 거대한 softmax 대신 네거티브 샘플링으로 이진 분류 문제를 풀어 계산을 가능하게 한다.
- 단어 임베딩은 문맥과 무관하므로, 언어 모델의 은닉 상태를 써서 문맥 의존 표현을 얻는다.
- ELMo는 정방향과 역방향 LSTM 언어 모델의 은닉 상태를 (학습된 가중치로) 결합해 하류 모델의 입력에 덧붙인다.
- BERT는 마스크 언어 모델과 문장 순서 분류로 학습한 양방향 Transformer 인코더이며, 첫 출력에 분류기를 달아 전체를 미세조정한다.
- GPT 같은 한 방향 Transformer는 표현의 질은 BERT보다 못할 수 있지만 텍스트를 생성할 수 있다.