- UC Berkeley CS 182 (Spring 2021) 20강 정리
- 강의: Sergey Levine
- 관련 Discussion: Discussion 11
딥넷은 일반화하는가 (Generalization, Distribution Shift, Calibration)
이상한 질문
딥넷이 일반화하느냐는 이상한 질문처럼 보인다. ImageNet 분류에서 사람의 오류율은 약 5%이고, 최신 모델은 이를 넘어선다. 테스트셋에서 잘 동작한다는 것은 일반화한다는 뜻이다. 그런데 틀린 경우는 어떤 실수인가? 많은 경우 실수조차 그럴듯하다. 비슷하게 생긴 다른 물체로 착각하는 식이다.
그러나 항상 그렇지는 않다. “Why Should I Trust You?”(Ribeiro et al., 2016)의 예에서 허스키와 늑대를 구분하는 분류기는 동물이 아니라 배경의 눈을 보고 판단했다. 학습 데이터에서 늑대 사진에 눈이 많았기 때문이다.
Clever Hans
계산을 할 줄 안다고 알려진 말 Clever Hans는 실제로는 질문자의 미묘한 몸짓을 읽어 답을 맞혔다. 학습/테스트 패러다임이 잘못될 때의 비유다. 모든 것이 “의도대로” 동작하더라도 원하는 것을 얻지 못할 수 있다. 모델은 데이터에서 답을 맞히는 가장 쉬운 단서를 배울 뿐이다.
분포 이동
문제의 한 원천은 테스트 입력이 학습 입력과 다른 분포에서 올 수 있다는 점, 즉 분포 이동(distribution shift) 이다. 학습 데이터에 허위 상관(spurious correlation)이 있으면 특히 문제가 된다. 깔끔하게 잘린 교통 표지판 데이터셋으로 학습한 모델이 실제 도로의 표지판을 볼 때가 그 예다. 더 현실적인 예는 다음과 같다.
- 의료 영상: 병원마다 촬영 기계가 다르다. 더 나쁘게는 병원마다 양성 비율이 달라(중증 환자가 많은 병원 등) 기계와 레이블 사이에 상관이 생긴다.
- 선택 편향: 중앙 크롭, 정형화된 자세 등 데이터 수집 방식의 편향.
- 피드백: ML 시스템의 사용이 사용자 행동을 바꾸어 입력 분포 자체가 바뀐다. 스팸 분류가 고전적인 예다.
보정
보정(calibration) 은 예측 확률이 예측한 사건의 실제 빈도를 반영하는 성질이다. 어떤 이미지에 대해 “늑대 0.7, 허스키 0.3”이라 예측했다면, 사람 10명 중 7명이 늑대라고 말하는 상황이어야 한다. 분포 밖(out-of-distribution, OOD) 입력에서는 “늑대 0.5, 허스키 0.5”처럼 “모르겠다”고 말하는 것이 이상적이다.
실제로는 어떤가?
- OOD 입력: 대개 그렇지 않다. 모델은 OOD 입력에 확신에 찬 오답을 내는 경우가 많다(항상은 아니다).
- 분포 내 예측: 역시 대개 잘 보정되어 있지 않지만, 보정을 개선하는 방법이 많이 있다.
적대적 예제 (Adversarial Examples)
현상
적대적 예제(adversarial example) 는 학습된 모델이 어떻게 일반화하고 또 하지 못하는지를 생생하게 보여 준다. 판다 이미지에 사람 눈에는 거의 보이지 않는 패턴을 더하면 모델이 긴팔원숭이(gibbon)로 확신한다. 이 패턴은 무작위 잡음이 아니라 모델을 “속이도록” 특별히 설계된 것이다.
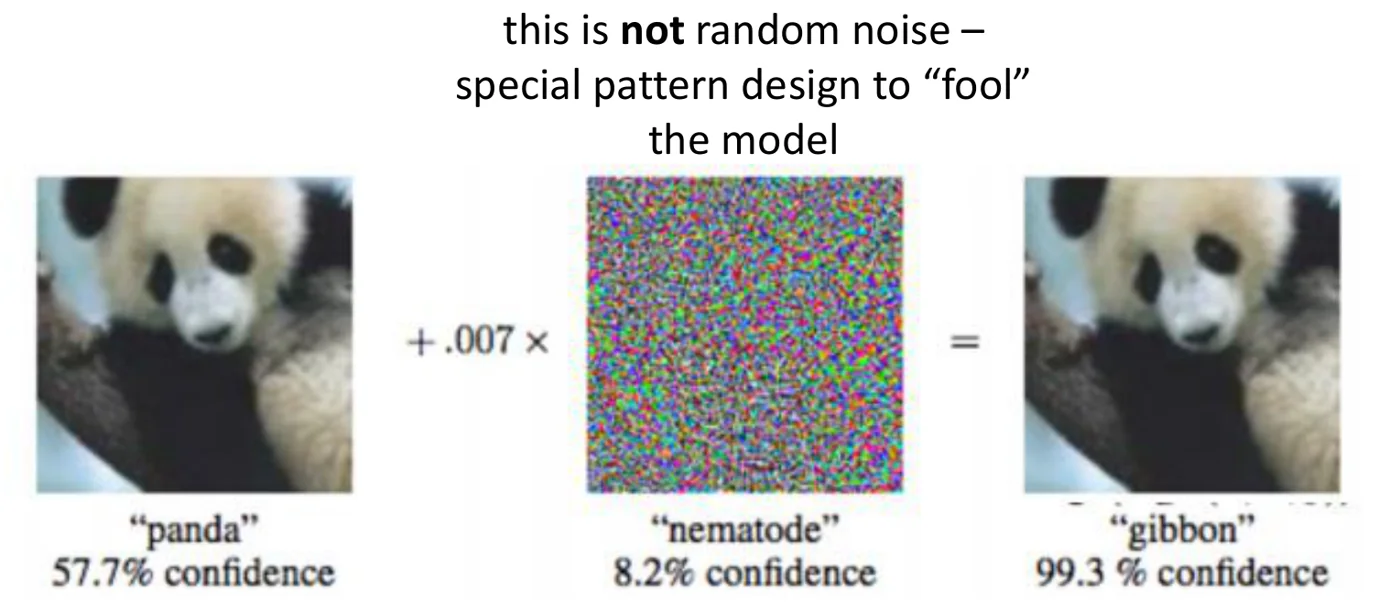 가장 유명한 적대적 예제. 57.7% 확신도로 “판다”로 분류되던 이미지에 특별히 설계한 패턴을 0.007배 더하면, 사람 눈에는 똑같아 보이는 이미지가 99.3% 확신도로 “긴팔원숭이”로 분류된다. 출처: CS 182 Lecture 20 slides.
그림은 덧셈식으로 읽는다. 가운데 패턴은 그 자체로 분류하면 “선충(nematode)”으로 8.2% 확신도가 나오는, 아무 의미 없어 보이는 색 잡음이다. 그러나 무작위로 뽑은 잡음이 아니라 모델의 기울기를 이용해 “긴팔원숭이 쪽으로 가장 효율적으로 미는 방향”을 계산한 것이다(뒤의 FGSM). 계수 0.007은 픽셀 값 범위에 비해 매우 작아서 각 픽셀은 거의 바뀌지 않는다. 그런데도 결과의 확신도는 원래보다 오히려 훨씬 높다. 작은 변화가 출력을 크게 바꿀 뿐 아니라 모델이 그 잘못된 답을 매우 확신한다는 점이 이 현상의 핵심이다.
왜 신경 써야 하는가? 직접적으로는 학습된 분류기를 “공격”하는 방법이 된다. 더 큰 문제는 이것이 일반화에 대해 이상한 사실을 암시한다는 점이다.
적대적 예제에 관한 사실들
- 긴팔원숭이만의 문제가 아니다. 충분히 노력하면 거의 무엇이든 다른 무엇으로 바꿀 수 있다.
- 방어가 쉽지 않다. 명백한 수정은 도움이 되지만, 알려진 한 완벽한 방어는 없다.
- 서로 다른 네트워크 사이에 전이(transfer) 된다. 같은 적대적 예제가 AlexNet과 ResNet을 모두 속일 수 있다.
- 정밀한 픽셀 패턴뿐 아니라 실제 세계에서도 동작한다. 사진은 그대로 두고 표지판에 스티커를 붙이면 정지 표지판이 “제한속도 45”로 분류된다.
- 인공 신경망에만 해당하지 않는다. 사실상 모든 학습된 모델이 취약하며, 학습된 모델의 일종인 사람의 뇌도 예외가 아닐 수 있다.
딥넷만의 문제인가
로지스틱 회귀 같은 선형 모델로도 MNIST의 숫자 9 이미지를 조금 바꿔 “0”(90%)이나 “1”(90%)로 분류되게 만들 수 있다(Goodfellow, 2016). 적대적 예제는 대부분의 학습된 모델에 나타나는 일반적인 현상이며, 알려진 모든 고용량 모델이 겪는다.
과적합 때문인가
과적합 가설: 신경망은 파라미터가 매우 많아 과적합하고, 그래서 미친 출력을 내는 입력을 찾기 쉽다. 이 가설대로라면 해결책은 신경망을 그만 쓰는 것이다. 심상(mental model)은 결정 경계가 학습점 주변에서 불규칙하게 구불거리고, 적대적 예제가 그 사이 틈에 놓인다는 것이다.
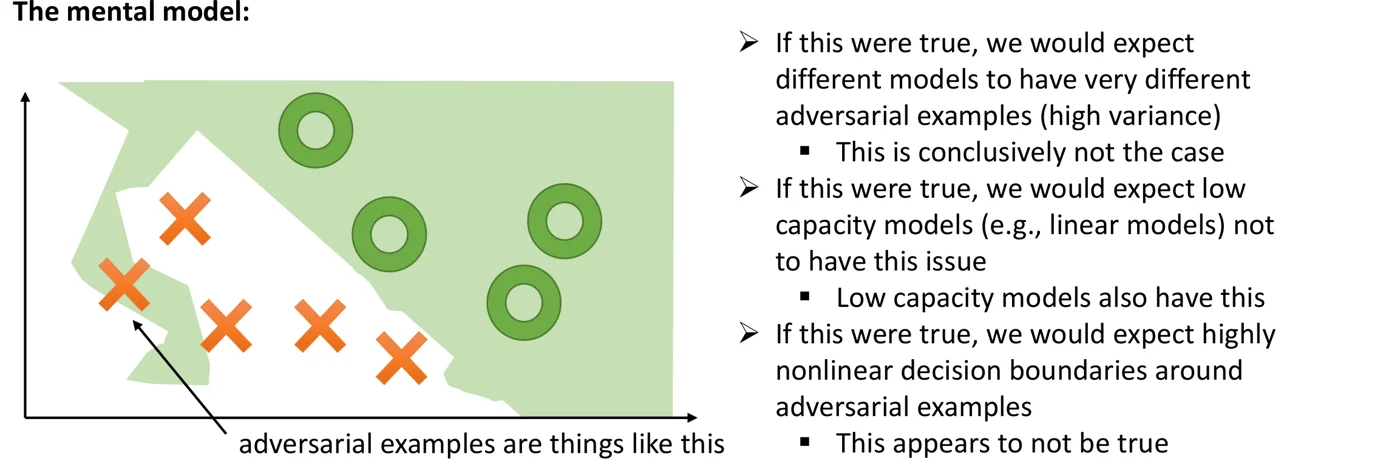 과적합 가설의 심상. 초록 영역은 모델이 “O 클래스”로 판정하는 영역이고, 결정 경계가 학습점(O와 X) 사이에서 불규칙하게 파고든다. 화살표가 가리키는 X는 초록 영역의 작은 돌출부에 놓여 잘못 분류된다. 오른쪽은 이 가설이 맞다면 기대되는 결과와 실제 관찰을 대조한 것이다. 출처: CS 182 Lecture 20 slides.
이 그림이 옳다면 적대적 예제는 학습 과정의 우연이 만든 결정 경계의 작은 주름 속에 있어야 한다. 그런데 주름의 모양은 초기화와 데이터 순서에 따라 모델마다 다를 것이므로, 한 모델의 적대적 예제가 다른 모델에서는 통하지 않아야 한다. 또 결정 경계가 직선뿐인 선형 모델에는 이런 주름이 생길 수 없다. 오른쪽 목록의 세 예측이 모두 실제와 어긋나므로 이 심상은 버려야 하며, 아래의 선형 모델 가설이 대안으로 제시된다.
대부분의 증거는 이 가설이 틀렸음을 보여 준다.
- 가설이 맞다면 모델마다 적대적 예제가 매우 달라야 한다(높은 분산). 결정적으로 그렇지 않다. 적대적 예제는 모델 사이에 전이된다.
- 가설이 맞다면 선형 모델 같은 저용량 모델에는 이 문제가 없어야 한다. 저용량 모델도 문제가 있다.
- 가설이 맞다면 적대적 예제 주변의 결정 경계가 매우 비선형이어야 한다. 그렇지 않은 것으로 보인다.
선형 모델 가설
선형 모델 가설: 신경망(과 다른 많은 모델)은 국소적으로 선형인 경향이 있어서, 데이터에서 멀어질수록 직관에 어긋나는 방식으로 외삽(extrapolate)한다. 고차원에서는 이것이 특히 반직관적인 의미를 가진다. 각 차원을 아주 조금씩만 바꿔도, 선형 함수의 출력은 차원 수에 비례해 크게 변하기 때문이다. “사실적인 이미지” 다양체(manifold)에서 약간 벗어난 방향으로 선형 경계를 넘으면 적대적 예제가 된다.
왜 이렇게 선형적인가? ReLU는 조각별 선형이고, 시그모이드도 학습이 잘 되도록 주로 선형 구간에서 동작하게 조정된다. 이 가설은 적대적 예제의 전이성과 일치하고, “과적합”을 줄여도 문제가 해결되지 않는 이유를 설명한다.
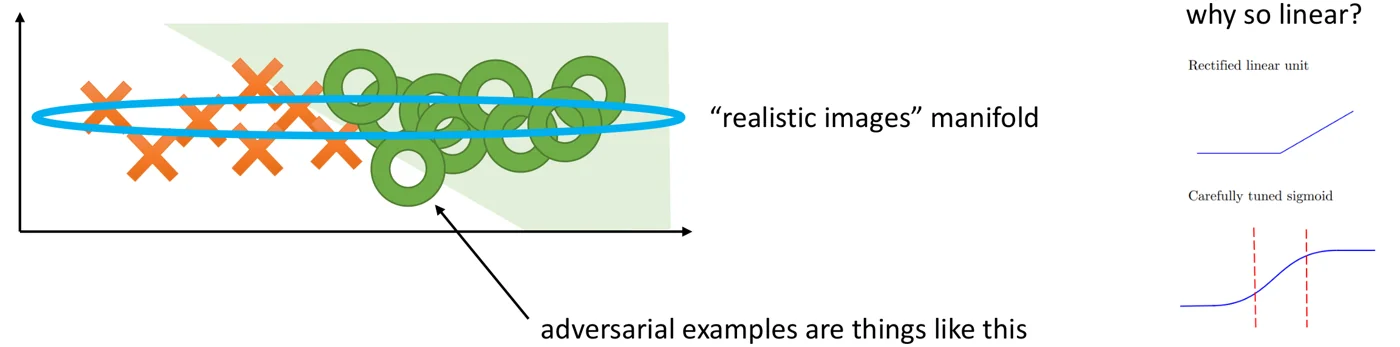 선형 모델 가설의 심상. 파란 타원은 “사실적인 이미지”가 놓이는 얇은 다양체이고, 초록 영역은 O 클래스로 판정되는 반평면이다. 다양체에서 조금 벗어난 O(화살표)는 선형 경계 덕분에 초록 영역 안에 있다. 오른쪽은 ReLU와 잘 조정된 시그모이드가 사실상 선형으로 동작한다는 그림이다. 출처: CS 182 Lecture 20 slides.
과적합 가설의 그림과 비교하면 결정 경계가 매끄러운 직선이라는 점이 다르다. 학습 데이터는 모두 파란 다양체 위에 있으므로, 모델은 다양체 위에서 O와 X를 가르는 일만 배운다. 다양체 밖에서 결정 경계가 어떻게 놓이는지는 학습 데이터가 전혀 제약하지 않으며, 선형 모델은 이를 단순히 직선으로 연장한다. 그래서 다양체에 수직인 방향으로 조금만 움직여도 경계를 넘을 수 있고, 그 경계는 데이터가 같다면 어느 모델이 배워도 비슷한 위치에 놓이므로 적대적 예제가 모델 사이에 전이된다.
두 실험이 이를 뒷받침한다(Goodfellow et al.).
- 실험 1: 자동차 이미지를 한 벡터 방향으로 \(\epsilon\)만큼 움직이며 각 클래스의 로짓을 그리면, 로짓이 \(\epsilon\)에 대해 거의 선형으로 변한다.
- 실험 2: 적대적 방향과 무작위 방향의 2차원 평면에서 예측을 그리면, 적대적 방향 한쪽에서 깔끔한 “이동”이 일어나고 직교 방향으로는 변화가 거의 없다. 결정 경계가 대체로 선형이라는 뜻이다.
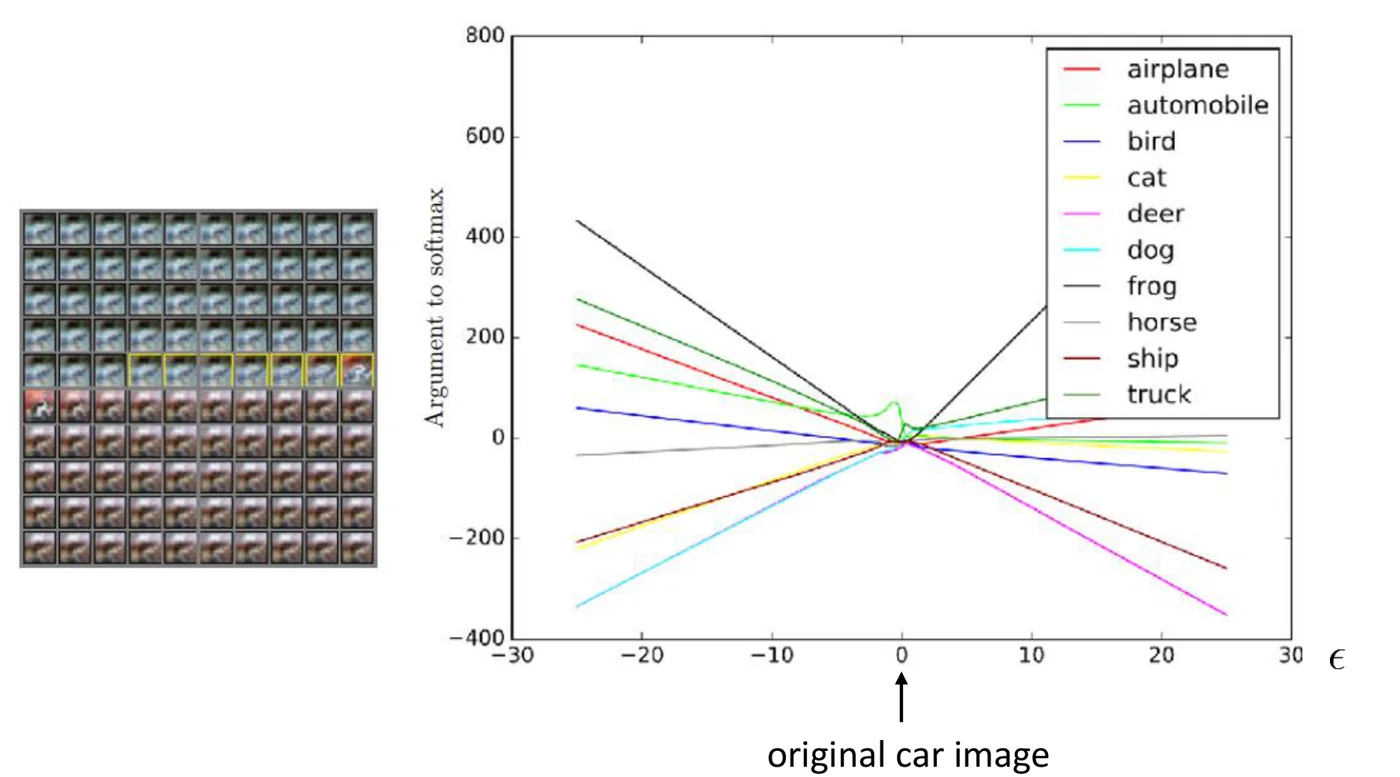 실험 1의 결과. 가로축은 자동차 이미지를 한 방향으로 움직인 크기 \(\epsilon\), 세로축은 각 클래스의 softmax 입력(로짓)이다. 왼쪽 격자는 \(\epsilon\)을 바꿔 가며 만든 이미지들이며, 노란 테두리는 올바르게 “자동차”로 분류된 이미지다. 출처: CS 182 Lecture 20 slides.
그래프에서 원래 이미지(\(\epsilon = 0\), 화살표) 근처의 좁은 구간을 제외하면 모든 클래스의 로짓이 \(\epsilon\)에 대해 거의 직선이다. 예를 들어 검은 선(frog)은 \(\epsilon\)이 음수 쪽으로 갈수록 직선으로 커져 \(\epsilon = -25\)에서 400을 넘는다. 원래 이미지 근처에서만 초록 선(automobile)이 약간 솟아 있어 올바른 클래스가 이기지만, 조금만 벗어나면 다른 클래스의 직선이 그것을 압도한다. 왼쪽 격자에서 노란 테두리가 가운데 몇 칸에만 있는 것도 같은 현상이다. 국소적으로 비선형인 주름이 아니라 거의 선형인 외삽이 오분류를 일으킨다는 직접적인 증거다.
실제 세계의 적대적 예제
정지 표지판에 특정 스티커를 붙이면 여러 각도와 거리에서 모두 “제한속도 45”로 분류된다(Eykholt et al., 2018). 3D 프린팅한 거북이가 여러 시점에서 소총으로 분류되기도 한다(Athalye et al., 2017).
사람에 대한 적대적 예제?
Elsayed et al.(2018)은 여러 컴퓨터 비전 모델을 속이도록 만든 적대적 예제가, 짧은 시간만 보고 판단하는 사람도 속일 수 있음을 보였다. 예컨대 고양이 이미지를 바꿔 사람이 개로 보게 만든다.
일반화와의 관계
선형 가설은 적대적 예제뿐 아니라 신경망이 어떻게 일반화하는지(그리고 하지 않는지)를 이해하는 데에도 중요하다. 고양이와 개를 분류하도록 학습한 모델은 고양이와 개가 어떻게 생겼는지를 배우는 것이 아니라 데이터셋 속의 패턴을 배운다. 그 다음에는 잠재적으로 이상한 방식으로 외삽한다.
다르게 말하면 적대적 예제는 버그가 아니라 학습 알고리즘의 특징(feature)이다. 이것은 말 그대로 “Adversarial Examples Are Not Bugs, They Are Features”(Ilyas et al., 2019)의 주장이다. 신경망이 “적대적 방향”에 주목하는 이유는 그것이 학습 데이터에서 정답을 맞히는 데 도움이 되기 때문이다.
요약
- 신경망은 학습셋과 같은 분포의 테스트셋에서 매우 잘 일반화한다. 때로는 그것을 영리한 말(Clever Hans)처럼 해낸다. 이는 신경망의 잘못이 아니라 잘못된 질문을 한 사람의 잘못이다.
- 신경망은 특히 OOD 입력에서 잘 보정되어 있지 않은 경우가 많다.
- 관련되지만 다른 문제로, 정상 이미지를 조금 바꿔 신경망을 속이는 적대적 예제를 거의 항상 합성할 수 있다.
- 적대적 예제는 과적합의 증상이 아닐 가능성이 크다. 모델 사이에 보존되고 저용량 모델에도 나타난다. 지나치게 선형적인(단순한) 모델의 외삽과 분포 이동이 원인일 것으로 보인다.
적대적 공격 (Adversarial Attacks)
형식적 정의
원본 이미지 \(x\)와 변형된 이미지 \(x'\) 사이의 관계 \(R(x, x')\)를 정한다. 예를 들어 \(R_\infty(x, x') = \lVert x - x' \rVert_\infty\)는 각 픽셀이 최대 얼마나 바뀌었는지다. 공격은 \(x\)에 가까운 \(x'\) 가운데 손실을 최대화하는 것을 고르는 문제다.
\[x^\star \leftarrow \arg\max_{x' : R(x, x') \le \epsilon} \mathcal{L}_\theta(x', y)\]손실은 원하는 것을 쓴다. 예를 들어 \(\mathcal{L}_\theta(x, y) = -\log p_\theta(y \mid x)\)다. 방어는 이 최악의 경우 손실, 즉 강건 손실(robust loss) 을 최소화하는 것이다.
\[\theta^\star \leftarrow \arg\min_\theta \sum_{(x, y) \in \mathcal{D}} \max_{x' : R(x, x') \le \epsilon} \mathcal{L}_\theta(x', y)\]주의할 점이 있다. 적대적 공격을 형식적으로 정의하는 것은 수학적 분석에는 도움이 되지만 중요한 현실 문제를 가릴 수 있다. 실제 공격자는 정의를 신경 쓰지 않는다. 표지판에 스티커를 붙이는 공격에서 \(\epsilon\)은 무엇인가?
Fast Gradient Sign Method (FGSM)
무한 노름 관계 \(R(x, x') = \lVert x - x' \rVert_\infty\)에 대한 매우 간단한 근사 방법이다. 손실을 1차 근사한다.
\[\mathcal{L}(x', y) \approx \mathcal{L}(x, y) + (x' - x)^T \nabla_x \mathcal{L}\]그러면 공격은
\[x^\star \leftarrow \arg\max_{x' : \lVert x - x' \rVert_\infty \le \epsilon} (x' - x)^T \nabla_x \mathcal{L}\]가 되고, 최적해는 \(x\)의 각 차원을 \(\nabla_x \mathcal{L}\)의 부호 방향으로 \(\epsilon\)만큼 움직이는 것이다.
\[x^\star = x + \epsilon\, \mathrm{sign}(\nabla_x \mathcal{L})\]보통이라면 1차 근사에 기반한 공격은 매우 약할 것이라 생각하겠지만, 앞서 보았듯 신경망은 국소적으로 선형처럼 동작한다. FGSM은 표준적인(순진한) 신경망에 매우 잘 통한다. 간단한 방어로 막을 수 있지만, 더 발전된 공격은 더 끈질기다.
더 일반적인 형식화
제약 최적화 문제를 라그랑주 승수 \(\lambda\)로 바꾼다.
\[x^\star \leftarrow \arg\max_{x'} \mathcal{L}_\theta(x', y) - \lambda R(x, x')\]\(\lambda\)는 경험적으로 고르거나 쌍대 경사 하강(dual gradient descent) 등으로 최적화한다. 이 문제는 Adam 같은 방법으로 수렴할 때까지 최적화한다. 섭동 \(\delta = x' - x\)로 쓰면
\[\delta^\star \leftarrow \arg\max_\delta \mathcal{L}_\theta(x + \delta, y) - \lambda \lVert \delta \rVert_\infty\]이다. 일반적으로 지각적 손실(perceptual loss)을 포함한 다양한 손실을 쓸 수 있다. 이런 반복 공격은 일반적으로 막기 매우 어렵다.
공격의 전이성
한 모델로 만든 적대적 예제가 다른 모델도 속이는 비율을 측정하면(Papernot et al., 2016), 서로 다른 모델 계열 사이에서도 대체로 그냥 통한다. 이는 실제로 공격하려는 신경망의 기울기에 직접 접근할 필요가 없다는 뜻이다. 다른 신경망으로 적대적 예제를 만들면 된다.
제로샷 블랙박스 공격
공격자는 자신이 가진 화이트박스 모델(또는 여러 모델의 앙상블)을 공격해 적대적 예제를 만들고, 그것을 블랙박스 시스템에 그대로 전이한다(Liu et al., 2017). 앙상블을 쓰면 여러 모델을 동시에 속이는 예제가 되어 미지의 모델에도 전이될 가능성이 커진다.
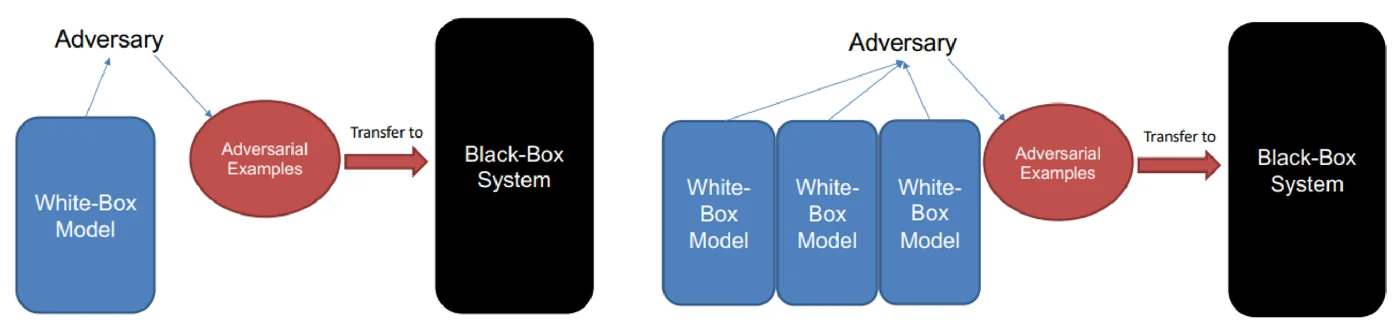 제로샷 블랙박스 공격의 두 형태. 왼쪽은 화이트박스 모델 하나로 만든 적대적 예제를 블랙박스 시스템에 전이하고, 오른쪽은 여러 화이트박스 모델을 동시에 속이는 예제를 만들어 전이한다. 출처: CS 182 Lecture 20 slides.
그림에서 공격자(Adversary)는 파란 화이트박스 모델의 내부(파라미터, 기울기)에 완전히 접근할 수 있으므로 FGSM이나 반복 공격으로 적대적 예제를 계산한다. 검은 블랙박스 시스템에는 질의조차 하지 않는다. “제로샷”이라는 이름이 이 점을 가리킨다. 오른쪽 형태에서는 손실을 여러 모델의 손실 합으로 두고 최적화하므로, 특정 모델 하나의 특이한 성질이 아니라 여러 모델이 공유하는 방향을 찾게 된다. 선형 모델 가설에 따르면 그런 공유 방향은 블랙박스 모델에도 존재할 가능성이 높으며, 실제로 앙상블 기반 예제의 전이율이 더 높다.
유한 차분으로 기울기 추정
웹 서버의 모델처럼 기울기에 직접 접근할 수 없어도, 적당한 수의 질의로 기울기를 추정할 수 있다. FGSM에 필요한 것은 기울기의 부호뿐이다. \(x\)의 각 차원 \(i\)에 대해 작은 수만큼 움직여 손실을 질의한다.
\[v_i \leftarrow \mathcal{L}(x + 10^{-3} e_i, y), \quad \nabla_x \mathcal{L} \approx (v - \mathcal{L}(x, y)) / 10^{-3}\]여기서 \(e_i\)는 \(i\)번째 표준 기저 벡터다. 필요한 질의 수를 더 줄이는 정교한 기법들도 있다.
적대적 공격에 대한 방어
모델을 “강건하게” 만드는 방법은 문헌에 매우 많다. 간단한 방법은 적대적 학습(adversarial training) 으로, 강건 손실을 근사적으로 최소화한다.
- 데이터셋 \(\mathcal{D}\)에서 미니배치 \(\{(x_i, y_i)\}\)를 뽑는다.
- 각 \(x_i\)에 대해 적대적 예제 \(x_i'\)를 계산한다. 예: FGSM \(x_i' \leftarrow x_i + \epsilon\, \mathrm{sign}(\nabla_{x_i} \mathcal{L}_\theta(x_i, y_i))\).
- SGD 스텝 \(\theta \leftarrow \theta - \alpha \sum_i \nabla_\theta \mathcal{L}_\theta(x_i', y_i)\)를 밟는다. 보통 원래 손실의 기울기 \(\nabla_\theta \mathcal{L}_\theta(x_i, y_i)\)도 함께 더한다.
이것은 공짜가 아니다. 적대적 공격에 대한 강건성은 높아지지만(속는 비율 감소), 순진한 네트워크에 비해 테스트셋 전체 정확도는 낮아진다.
요약
- FGSM은 무한 노름 제약(각 픽셀이 최대 작은 양만큼만 변함) 하에서 공격을 만드는 간단하고 편리한 방법이다.
- 더 나은 공격은 제약 하에서 여러 스텝의 경사 하강으로 이미지를 최적화한다.
- 모델의 기울기 없이도 블랙박스 공격이 가능하다. 자신의 모델(또는 앙상블)을 공격해 제로샷으로 전이하거나, 질의로 기울기를 추정한다(유한 차분 등).
- 방어는 활발히 연구되는 주제이지만 매우 어렵다.
정리
- 딥넷은 같은 분포의 테스트셋에서는 잘 일반화하지만, 허위 상관을 배우는 Clever Hans 문제와 분포 이동에 취약하고, 특히 OOD 입력에서 잘 보정되어 있지 않다.
- 적대적 예제는 거의 보이지 않는 섭동으로 분류를 바꾸며, 모델 사이에 전이되고, 실제 세계에서도 동작하고, 선형 모델을 포함한 거의 모든 학습 모델에 나타난다.
- 증거는 과적합 가설보다 선형 모델 가설을 지지한다. 국소적으로 선형인 모델이 고차원에서 데이터 다양체 밖으로 외삽하며 생기는 현상이다.
- 공격은 \(\max_{R(x, x') \le \epsilon} \mathcal{L}_\theta(x', y)\)로 형식화되고, FGSM은 1차 근사로 \(x^\star = x + \epsilon\, \mathrm{sign}(\nabla_x \mathcal{L})\)를 준다. 반복 최적화 공격은 더 강하다.
- 전이성과 유한 차분 기울기 추정 덕분에 블랙박스 공격도 가능하다.
- 적대적 학습은 강건 손실을 최소화해 강건성을 높이지만 깨끗한 데이터에서의 정확도를 희생한다.