- UC Berkeley CS 182 (Spring 2021) 19강 정리
- 강의: Sergey Levine
- 관련 Discussion: Discussion 11
GAN의 아이디어 (Generative Adversarial Networks)
잠재변수 모델로 다시 보기
잠재변수 모델로 생성하는 과정은 두 단계다. \(z \sim p(z)\)로 무작위 수 벡터를 만들고, \(x = G(z)\)로 그 벡터를 이미지로 바꾼다. VAE는 이를 위해 인코더를 함께 학습했다. 다른 접근이 가능하다. 인코더 없이, 생성된 이미지 집합이 모집단 수준에서(at the population level) 실제 이미지 집합과 비슷해 보이도록 모델 전체를 학습하는 것이다. 두 얼굴이 똑같을 필요는 없고, 생성된 얼굴들의 분포가 실제 얼굴들의 분포와 구별되지 않으면 된다.
판별기를 손실함수로 쓰기
어떤 이미지가 진짜이고 어떤 이미지가 가짜인지 맞히는 네트워크를 학습하고, 이 네트워크를 생성기의 손실함수로 쓰면 된다. 첫 시도는 다음과 같다.
- “진짜” 데이터셋 \(\mathcal{D}_T = \{x_i\}\)를 준비한다.
- 생성기 \(G_\theta(z)\)를 준비한다.
- “가짜” 데이터셋 \(\mathcal{D}_F\)를 \(z \sim p(z)\), \(x = G(z)\)로 만든다.
- \(\mathcal{D}_T\)와 \(\mathcal{D}_F\)로 판별기(discriminator) \(D_\phi(x) = p_\phi(y \mid x)\)를 학습한다.
- \(-\log D(x)\)를 “손실”로 써서 \(G(z)\)를 학습한다.
이 방식은 거의 동작하지만 두 가지 큰 문제가 있다. 처음 생성기를 어디서 얻느냐는 문제와, 판별기를 한 번만 학습하면 생성기가 그 고정된 판별기를 너무 쉽게 “속인다”는 문제다.
해결은 간단하다. 생성기는 무작위 초기화로 시작하고, 3-5단계를 반복하되 판별기와 생성기를 각각 SGD 한 스텝씩 번갈아 갱신한다. 이것이 생성적 적대 신경망(generative adversarial network, GAN) 이다. 실제로는 다양한 손실 변형이 있지만 아이디어는 같다.
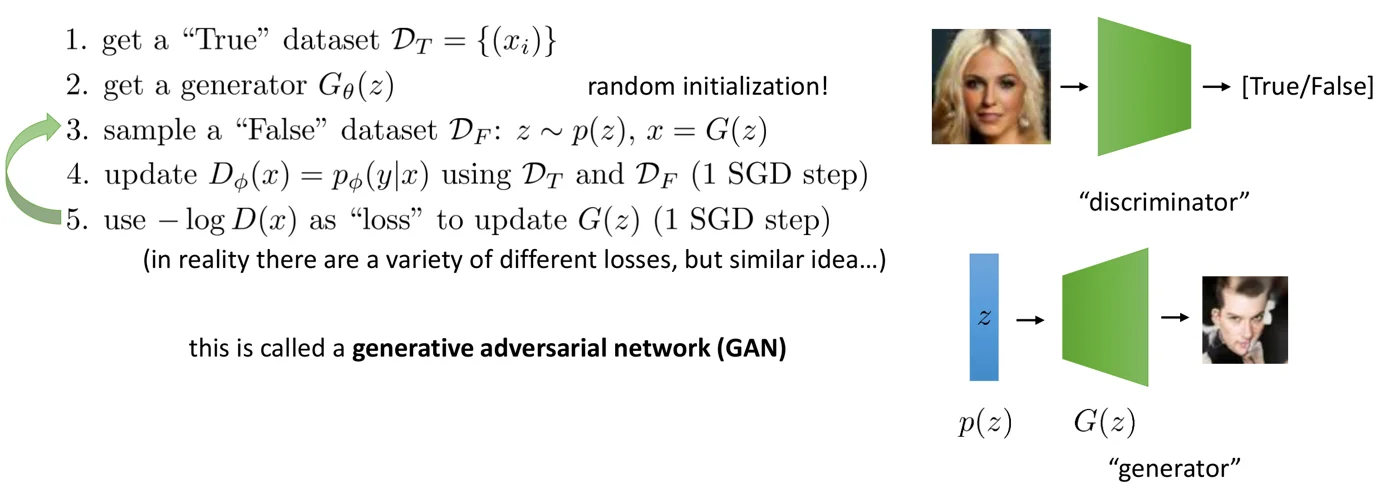 GAN 학습 알고리즘. 왼쪽 초록 화살표는 3-5단계를 반복한다는 뜻이고, 오른쪽 위는 이미지를 받아 참/거짓을 내는 판별기, 오른쪽 아래는 \(z \sim p(z)\)를 받아 이미지를 내는 생성기다. 출처: CS 182 Lecture 19 slides.
그림의 두 네트워크를 이어 붙이면 GAN의 계산 그래프가 된다. 생성기의 출력(오른쪽 아래 얼굴)이 그대로 판별기의 입력(오른쪽 위 얼굴 자리)으로 들어간다. 4단계에서는 진짜 이미지에는 레이블 “참”, 생성 이미지에는 레이블 “거짓”을 붙인 이진 분류 문제로 판별기 \(\phi\)를 한 스텝 갱신한다. 5단계에서는 판별기를 고정하고, 생성 이미지에 대한 판별기 출력 \(D(G(z))\)가 커지도록 그 기울기를 이미지를 거쳐 생성기 \(\theta\)까지 역전파한다. 판별기가 학습 가능한 손실함수 역할을 하는 셈이다.
“random initialization!”이라는 주석이 첫 번째 문제의 답이다. 생성기를 미리 준비할 필요 없이 무작위 생성기에서 출발해도, 판별기와 번갈아 조금씩 갱신하면 둘이 함께 개선된다. 각 단계에서 SGD 한 스텝만 밟는 것이 두 번째 문제의 답이다. 판별기가 완전히 수렴하기 전에 생성기가 움직이므로, 고정된 판별기의 약점 하나를 파고드는 해에 빠지지 않는다.
GAN은 왜 분포를 학습하는가
판별기가 “진짜인지 가짜인지 모르겠다”고 하게 만들려면 생성기는 두 가지를 해야 한다. 사실적인 이미지를 만들어야 하는 것은 당연하고, 더해서 가능한 모든 사실적인 이미지를 만들어야 한다.
예를 들어 실제 데이터에 개와 다른 동물이 섞여 있는데 생성기가 매우 사실적인 개 사진만 만든다고 하자. 그러면 판별기는 개 사진을 보면 가짜일 가능성이 높다고 판단할 수 있다(진짜일 확률이 1.0이 아니라 0.25 정도). 반면 다른 동물 사진은 확실히 진짜라고 본다. 따라서 생성기는 데이터 분포 전체를 덮을 때 더 좋은 점수를 받는다.
결과 예시
- 작은 GAN (Goodfellow et al., 2014): MNIST와 작은 이미지에서의 첫 결과.
- 고해상도 GAN (Progressive Growing of GANs, Karras et al., 2017): 저해상도에서 시작해 점점 해상도를 키운다.
- 큰 GAN (BigGAN, Brock et al., 2018): 대규모 학습으로 ImageNet 클래스 조건부 생성.
- 이미지 간 변환 (pix2pix, Isola et al., 2017): 스케치를 고양이 사진으로 바꾸는 등의 조건부 생성.
GAN 게임 (The GAN Game)
미니맥스 목적함수
GAN 학습은 두 플레이어의 게임이다.
\[\min_\theta \max_\phi V(\theta, \phi) = E_{x \sim p_{\text{data}}(x)}[\log D_\phi(x)] + E_{z \sim p(z)}[\log(1 - D_\phi(G_\theta(z)))]\]판별기는 \(V\)를 최대화하고 생성기는 최소화한다. 구현에서 중요한 세부사항은 두 가지다. 확률적 경사 하강/상승으로 어떻게 동작시키느냐, 그리고 기울기를 어떻게 계산하느냐다. 둘 다 간단하다. 미니배치로 기댓값을 근사하고 번갈아 갱신한다.
\[\phi \leftarrow \phi + \alpha \nabla_\phi \left( \frac{1}{N} \sum_{i=1}^{N} \log D_\phi(x_i) + \frac{1}{N} \sum_{j=1}^{N} \log(1 - D_\phi(x_j)) \right), \quad x_i \in \mathcal{D}_T,\ x_j = G(z_j)\] \[\theta \leftarrow \theta - \alpha \nabla_\theta \left( \frac{1}{N} \sum_{j=1}^{N} \log(1 - D_\phi(G_\theta(z_j))) \right)\]판별기 갱신은 그냥 이진 교차 엔트로피 손실이다. 생성기 갱신은 판별기에서 생성기로 그대로 역전파하면 된다. 생성된 이미지 \(G_\theta(z_j)\)를 판별기에 넣고, 판별기 출력에서 이미지를 거쳐 \(\theta\)까지 기울기를 흘려보낸다.
최적 판별기
수렴했을 때 \(G\)에 대해 무엇을 말할 수 있을까? \(D\)를 \(G\)의 함수로서 닫힌 형태로 쓰는 것이 아이디어다. \(p = p_{\text{data}}\), \(q = p_G\)라 하자. 판별기가 충분히 표현력이 크다면 각 \(x\)마다 따로 최적화할 수 있다.
\[D^\star = \arg\max_D E_p[\log D(x)] + E_q[\log(1 - D(x))]\]점별로 \(D(x)\)에 대해 미분해 0으로 두면
\[\frac{p(x)}{D(x)} - \frac{q(x)}{1 - D(x)} = 0 \quad \Rightarrow \quad D^\star_G(x) = \frac{p_{\text{data}}(x)}{p_{\text{data}}(x) + p_G(x)}\]이다.
GAN이 최소화하는 것: Jensen-Shannon 발산
\(D^\star_G\)를 대입하면 목적함수는 \(G\)만의 함수가 된다.
\[V(D^\star_G, G) = E_{p_{\text{data}}}[\log p_{\text{data}}(x) - \log(p_{\text{data}}(x) + p_G(x))] + E_{p_G}[\log p_G(x) - \log(p_{\text{data}}(x) + p_G(x))]\]혼합 분포 \(q(x) = \frac{p_{\text{data}}(x) + p_G(x)}{2}\)를 정의하면 분모의 \(\frac{1}{2}\) 인자를 \(-\log 4\)로 뽑아낼 수 있다.
\[V(D^\star_G, G) = D_{\mathrm{KL}}(p_{\text{data}} \lVert q) + D_{\mathrm{KL}}(p_G \lVert q) - \log 4 = 2 D_{\mathrm{JS}}(p_{\text{data}} \lVert p_G) - \log 4\]Jensen-Shannon 발산은 KL 발산과 달리 대칭이고, 두 분포가 일치할 때 0이 된다. 따라서 GAN은 실제로 데이터 분포에 맞추려 한다. 다만 이것은 내시 균형(Nash equilibrium)에서 무엇이 최소화되는지를 말할 뿐, 실제로 그 균형을 찾는다는 보장은 아니다.
실용적인 생성기 손실
이론상 생성기 손실은 \(E_{z \sim p(z)}[\log(1 - D_\phi(G_\theta(z)))]\), 즉 “이미지가 가짜일 확률을 최소화”하는 것이다. 실제로는 대신 \(E_{z \sim p(z)}[-\log D_\phi(G_\theta(z))]\), 즉 “이미지가 진짜일 확률을 최대화”하는 손실을 자주 쓴다.
이유는 기울기의 크기다. \(\log(1 - D)\)는 \(D\)가 0 근처일 때, 즉 생성기가 나쁠 때 기울기가 작다. 학습 초반에 가장 기울기가 필요한 시점에 신호가 약한 셈이다. \(-\log D\)는 반대로 \(D\)가 0 근처일 때 기울기가 크고, 생성기가 좋아져 \(D\)가 1에 가까워지면 기울기가 작아진다. 다른 변형도 있다.
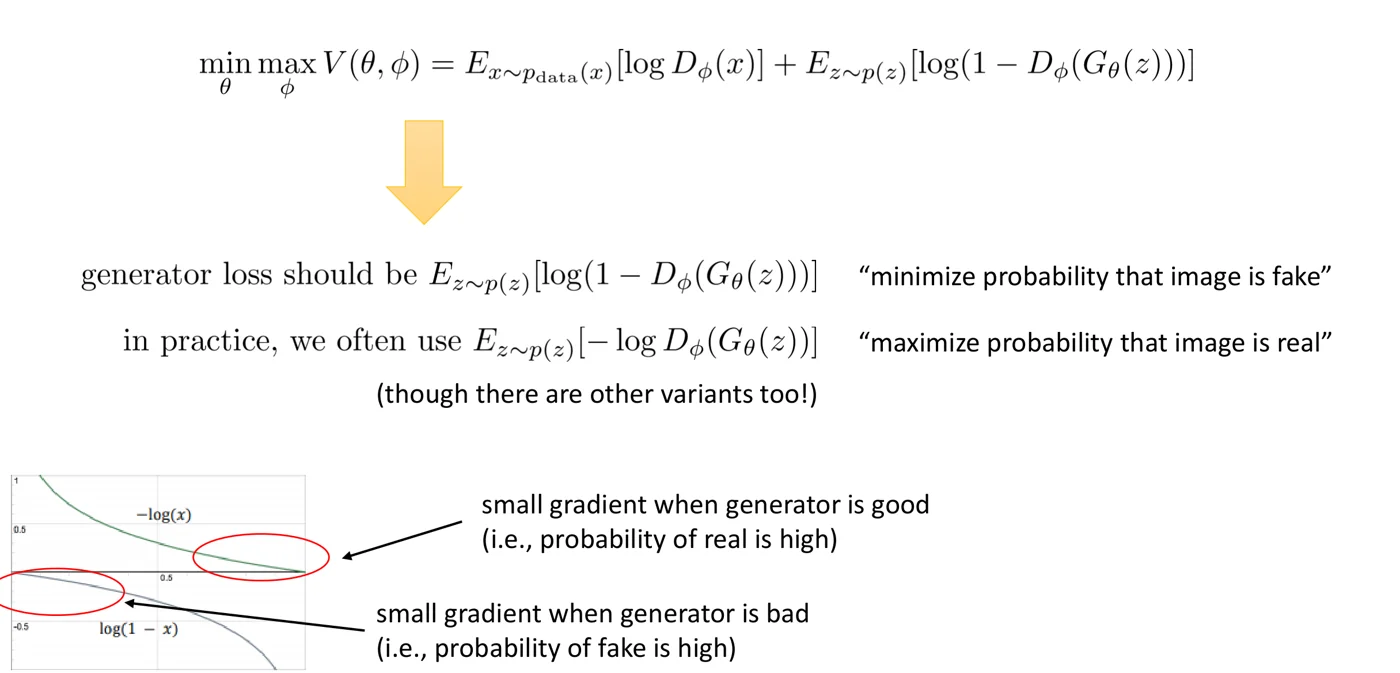 이론상의 생성기 손실 \(\log(1 - D)\)와 실전에서 쓰는 \(-\log D\)의 비교. 왼쪽 아래 그래프에서 가로축은 판별기 출력 \(D(G(z))\)이고, 빨간 원은 각 곡선의 기울기가 작은 구간이다. 출처: CS 182 Lecture 19 slides.
그래프의 아래쪽 곡선 \(\log(1 - x)\)는 \(x = 0\) 근처에서 거의 수평이다. 학습 초반에는 생성 이미지가 엉망이라 판별기가 쉽게 가짜로 판정하므로 \(D(G(z)) \approx 0\)이고, 바로 이 평평한 구간(왼쪽 빨간 원)에 놓이게 된다. 생성기가 가장 많이 배워야 할 때 기울기가 거의 0인 것이다. 위쪽 곡선 \(-\log x\)는 \(x = 0\) 근처에서 매우 가파르고, 생성기가 이미 잘하는 \(x \approx 1\) 근처(오른쪽 빨간 원)에서만 평평하다. 두 손실 모두 \(D(G(z))\)를 키우는 방향이라는 점은 같으므로 최적점은 바뀌지 않고, 기울기가 큰 구간만 학습 초반 쪽으로 옮겨진다.
구조
생성기는 완전연결층이나, 작은 공간 해상도에서 시작해 전치 합성곱으로 키우는 합성곱 구조를 쓴다. 판별기는 이미지를 받아 참/거짓을 출력하는 일반 분류기다. BigGAN 같은 실제 구조는 잔차 블록 등으로 이루어진 훨씬 큰 네트워크다.
조건부 GAN
클래스 레이블 같은 조건 정보를 생성기와 판별기 모두에 붙이면 조건부 GAN(conditional GAN)이 된다(Mirza & Osindero, 2014). 생성기는 \(G(z, c)\), 판별기는 \(D(x, c)\)가 되어, 판별기가 “이 조건에 맞는 진짜 이미지인가”를 판단한다.
CycleGAN
말 사진을 얼룩말 사진으로 바꾸고 싶은데, 어느 말 사진과 어느 얼룩말 사진이 짝인지 모른다고 하자. 짝지은 데이터가 없으므로 pix2pix 같은 조건부 GAN을 쓸 수 없다. 두 생성기 \(G: X \to Y\)와 \(F: Y \to X\), 두 판별기를 두고 각각 GAN 손실로 학습하면 변환된 이미지가 얼룩말처럼 보이게 할 수는 있다.
문제는 변환된 얼룩말이 원래 말과 닮아야 할 이유가 없다는 점이다. CycleGAN(Zhu et al., 2017)은 순환 일관성(cycle consistency) 을 추가한다. 말을 얼룩말로 바꾼 뒤 다시 말로 바꾸면 원래 말이 나와야 한다.
\[\mathcal{L}_{\text{cyc}} = E_{x}[\lVert F(G(x)) - x \rVert_1] + E_{y}[\lVert G(F(y)) - y \rVert_1]\]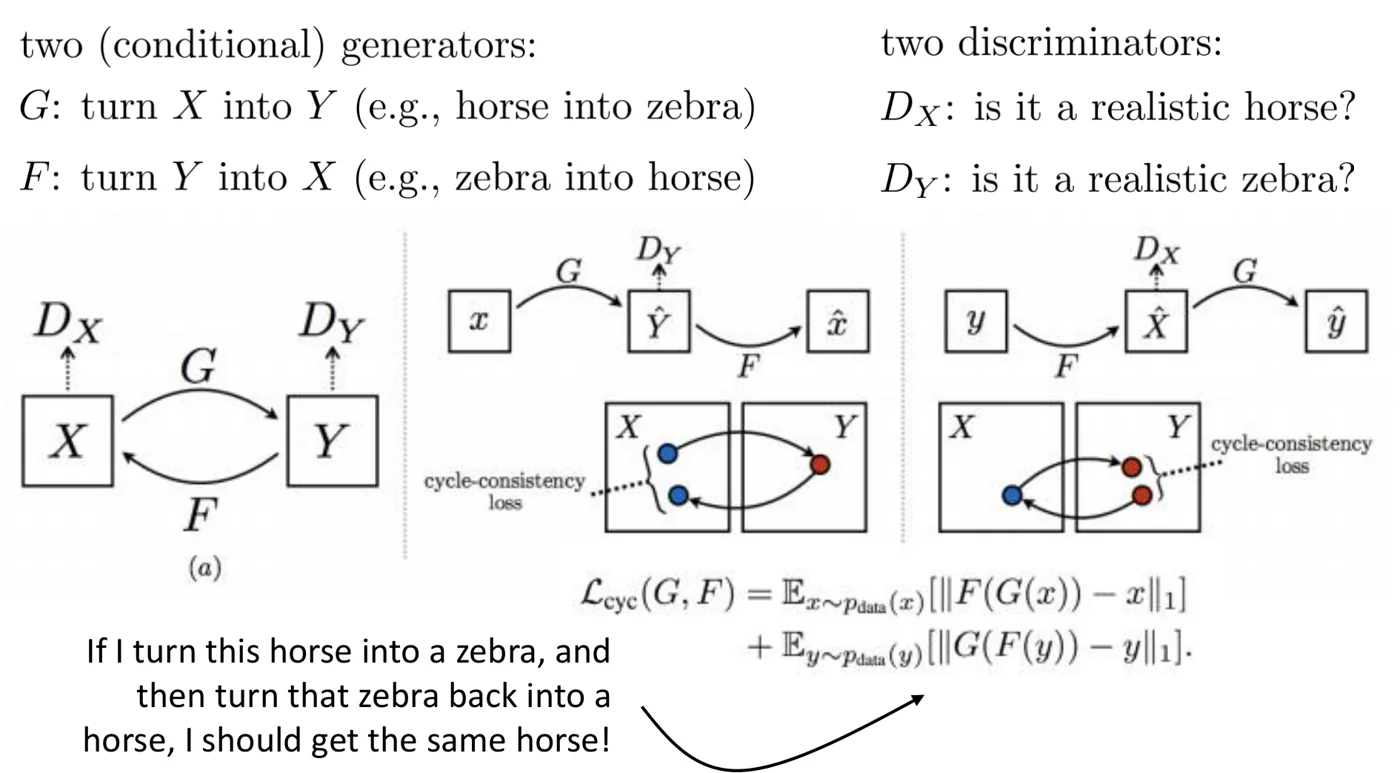 CycleGAN의 구조. (a) 두 도메인 \(X\)(말)와 \(Y\)(얼룩말) 사이를 오가는 생성기 \(G, F\)와 각 도메인의 판별기 \(D_X, D_Y\). 가운데와 오른쪽은 각각 \(x \to \hat{Y} \to \hat{x}\), \(y \to \hat{X} \to \hat{y}\)로 한 바퀴 돌아온 결과를 원래 입력과 비교하는 순환 일관성 손실이다. 출처: CS 182 Lecture 19 slides.
가운데 그림을 따라가 보자. 말 사진 \(x\)를 \(G\)로 얼룩말 \(\hat{Y}\)로 바꾸면, 판별기 \(D_Y\)는 그것이 진짜 얼룩말처럼 보이는지를 판정한다(GAN 손실). 이어서 \(F\)로 다시 말 \(\hat{x}\)로 되돌리고, 아래 상자에서처럼 \(\hat{x}\)(아래 파란 점)와 원래 \(x\)(위 파란 점) 사이의 거리를 순환 일관성 손실로 벌한다. 오른쪽 그림은 얼룩말에서 출발하는 반대 방향의 같은 과정이다.
GAN 손실만 있으면 \(G\)는 입력과 무관하게 아무 얼룩말 사진이나 내도 \(D_Y\)를 속일 수 있다. 순환 일관성 손실은 \(G(x)\)에 원래 말의 자세, 배경 같은 정보가 남아 있어야 \(F\)가 그것을 복원할 수 있게 만들므로, 짝지은 데이터 없이도 입력과 출력이 대응되도록 강제한다.
요약
GAN은 두 플레이어의 게임이다. 최적 판별기를 유도하면 내시 균형에서 최소화되는 목적함수(JS 발산)를 알 수 있지만, 실제로 균형을 찾는다는 보장은 없다. 완전연결 GAN과 합성곱 GAN 모두 학습할 수 있고, 말을 얼룩말로 바꿀 수도 있다.
GAN 학습 개선 (Improved GAN Training)
GAN 학습은 왜 어려운가
1차원 예를 생각하자. 실제 데이터와 생성 데이터가 멀리 떨어져 있으면, 판별기는 둘을 완벽하게 구분할 수 있다. 이때 \(D(x)\)는 실제 데이터 근처에서 1, 생성 데이터 근처에서 0인 계단 모양이 된다. 생성 데이터 위치에서 \(D\)는 거의 평평하므로 \(\log(1 - D_\phi(G_\theta(z)))\) 값이 모두 비슷하고, 생성기 기울기가 사실상 0이다. 생성기는 어느 방향으로 가야 실제 데이터에 가까워지는지 알 수 없다.
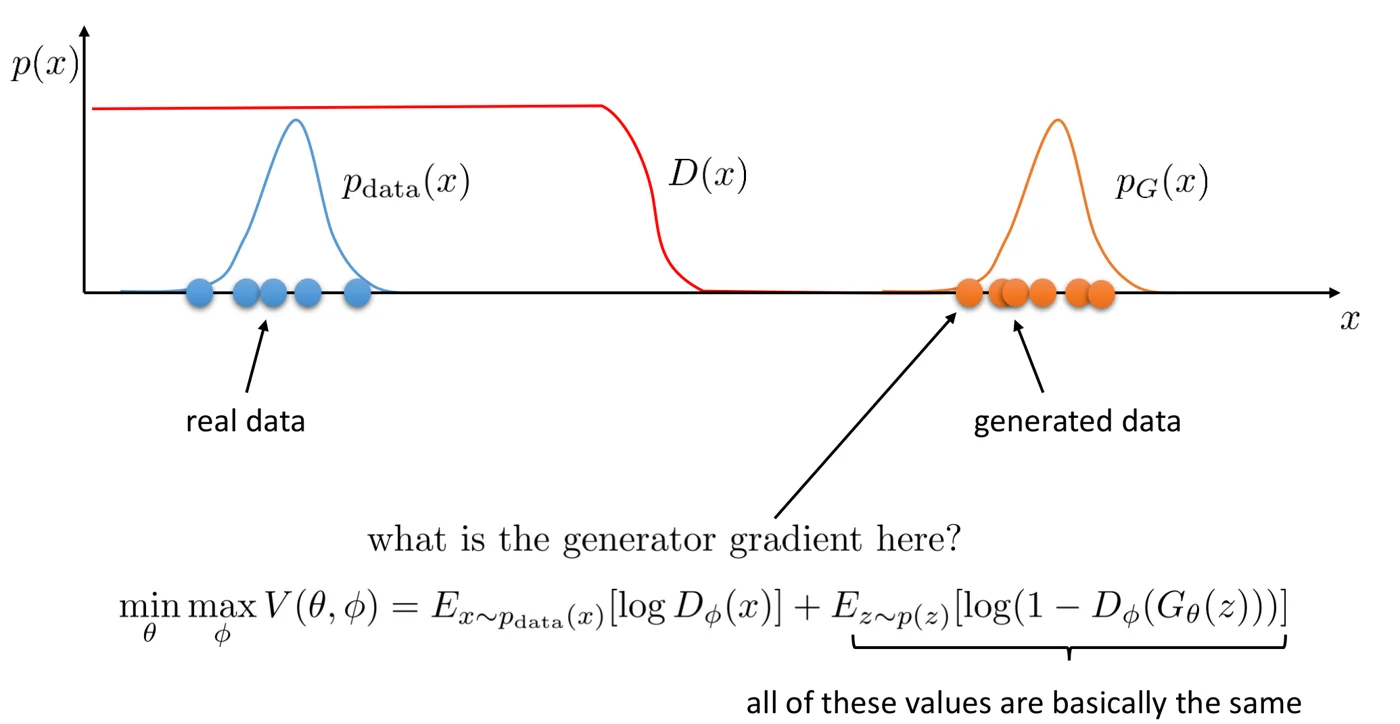 1차원에서 실제 데이터 분포 \(p_{\text{data}}(x)\)(파랑)와 생성 분포 \(p_G(x)\)(주황)가 멀리 떨어져 있을 때의 최적 판별기 \(D(x)\)(빨강). 생성 데이터가 놓인 곳에서 \(D(x)\)가 완전히 평평하다. 출처: CS 182 Lecture 19 slides.
그림의 빨간 곡선은 왼쪽(실제 데이터 쪽)에서 1, 오른쪽(생성 데이터 쪽)에서 0이며, 두 분포 사이의 빈 공간 어딘가에서 급격히 떨어진다. 생성기의 기울기는 생성 샘플(주황 점) 위치에서 \(D\)를 \(x\)에 대해 미분한 값에 비례한다. 그런데 주황 점들은 모두 \(D = 0\)인 평평한 바닥에 놓여 있으므로 미분값이 0이다. 아래의 중괄호가 가리키듯 생성 샘플들의 \(\log(1 - D)\) 값이 모두 같으니, 샘플을 왼쪽으로 조금 옮겨도 손실이 줄지 않는다. 판별기가 너무 잘 학습될수록 오히려 생성기는 배울 신호를 잃는다.
어떻게 개선하는가
두 방향이 있다.
- 더 나은 판별기: 생성 데이터에서 실제 데이터 쪽으로 완만하게 기울어진 판별기는 생성기에 유용한 방향을 알려 준다.
- 더 넓은 분포: 실제 분포와 생성 분포를 퍼뜨려 서로 겹치게 하면 판별기가 완벽해질 수 없어 기울기가 살아난다.
개선 기법들은 다음과 같다(순서는 무의미).
- Least-squares GAN (LSGAN): 판별기가 확률 대신 실수값을 출력하고 제곱 오차로 학습한다.
- Wasserstein GAN (WGAN): 판별기를 Lipschitz 연속으로 제한한다.
- 기울기 벌점(gradient penalty): 판별기를 더 강하게 연속으로 만든다.
- 스펙트럼 정규화(spectral norm): 판별기를 아주 확실하게 연속으로 만든다.
- Instance noise: 실제 데이터와 생성 샘플 모두에 잡음을 더한다.
Mescheder et al.(2018)의 분석처럼, 이 중 몇 가지는 현재에도 좋은 선택이다.
Wasserstein GAN
고전 GAN의 JS 발산은 “거리”를 고려하지 않는다. 두 분포가 아주 멀리 떨어져 있을 때와 꽤 가까이 있을 때, 겹치지 않는 한 JS 발산(그리고 KL 발산과 대부분의 다른 발산)은 거의 같은 값이다. 그래서 GAN 학습이 어렵다.
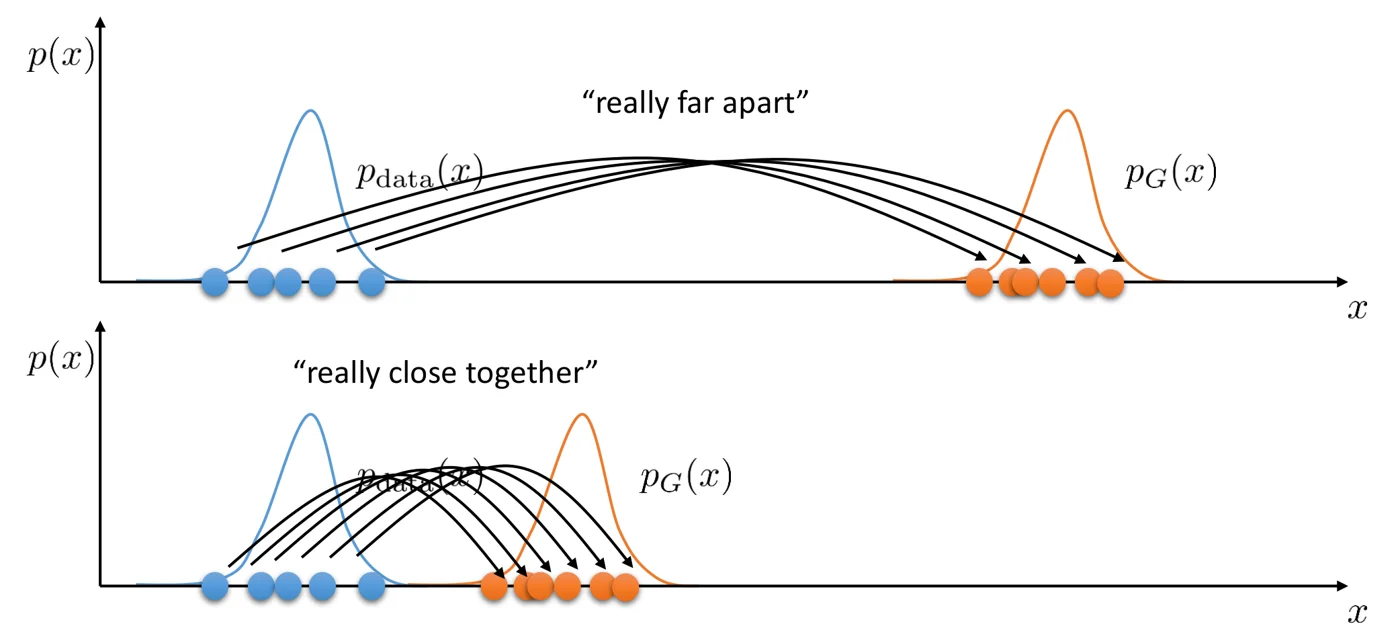 최적 수송의 직관. 위는 두 분포가 “아주 멀리” 떨어진 경우, 아래는 “아주 가까운” 경우이며, 화살표는 실제 데이터의 확률 질량을 생성 분포 쪽으로 옮기는 경로다. 출처: CS 182 Lecture 19 slides.
그림에서 위와 아래 모두 두 분포는 서로 겹치지 않는다. 그래서 JS 발산은 두 경우에 같은 값(\(\log 2\))을 가지며, 생성 분포를 실제 분포 쪽으로 옮겨도 겹치기 전까지는 전혀 줄지 않는다. 반면 Earth mover’s distance는 화살표의 길이, 즉 파란 점 하나하나를 주황 점 위치로 옮기는 데 드는 거리의 총합이다. 위 그림의 화살표는 길고 아래 그림의 화살표는 짧으므로, 두 분포가 가까워질수록 값이 연속적으로 줄어든다. 생성기에게 “어느 방향으로 가면 나아지는가”를 알려 주는 척도가 바로 이것이다.
더 나은 척도는 확률의 “조각”들이 유클리드 공간에서 얼마나 떨어져 있는지 보는 것이다. 정확히는 최적 수송(optimal transport), 즉 Earth mover’s distance다. 한 분포를 다른 분포로 “옮기는” 데 얼마나 멀리 움직여야 하는지를 잰다. 쌍대성(duality)을 이용하면(증명은 생략) Wasserstein 거리는 다음과 같이 쓸 수 있다.
\[W(p_{\text{data}}, p_G) = \sup_{\lVert f \rVert_L \le 1} E_{p_{\text{data}}}[f(x)] - E_{p_G(x)}[f(x)]\]상한은 모든 1-Lipschitz 스칼라 함수, 즉 \(\lvert f(x) - f(y) \rvert \le \lvert x - y \rvert\)를 만족하는 함수에 대해 취한다. 기울기가 유계라는 뜻, 즉 함수가 너무 가파르지 않다는 뜻이다.
어떻게 이 제약을 걸까? \(f\)가 ReLU 신경망이면 가중치 \(W\)를 제한하면 된다. 1층 \(f_\theta(x) = \mathrm{ReLU}(W_1 x + b_1)\)에서 \(W_{1,i,j} \in [-0.01, 0.01]\)이면 기울기는 \(0.01 \times D\)보다 클 수 없다. 2층 \(f_\theta(x) = W_2 \mathrm{ReLU}(W_1 x + b_1) + b_2\)에서도 모든 \(W_{\ell,i,j} \in [-0.01, 0.01]\)이면 기울기는 유계다(다만 0.01보다는 크다). 이렇게 하면 1-Lipschitz는 보장되지 않지만 어떤 유한한 \(K\)에 대한 \(K\)-Lipschitz는 보장된다. 상수배는 최적화 방향에 영향을 주지 않는다.
WGAN 알고리즘은 다음과 같다(Arjovsky et al., 2017).
- \(E_{x \sim p_{\text{data}}}[f_\theta(x)] - E_{z \sim p(z)}[f_\theta(G(z))]\)의 기울기로 \(f_\theta\)를 갱신한다.
- \(\theta\)의 모든 가중치 행렬을 \([-c, c]\)로 자른다(weight clipping).
- \(E_{z \sim p(z)}[f_\theta(G(z))]\)를 최대화하도록 생성기를 갱신한다.
판별기(“critic”)는 참/거짓 확률이 아니라 실수를 출력한다. 1차원 예에서 일반 GAN 판별기는 생성 데이터 근처에서 기울기가 사라지지만, WGAN critic은 거의 선형이라 기울기가 남는다.
더 나은 판별기 정규화: 기울기 벌점
가중치 자르기는 Lipschitz 제약을 거는 데 분명히 좋지 않은 방법이다. 기울기 벌점(Gulrajani et al., 2017)은 기울기 노름이 1에 가깝도록 직접 벌점을 준다. 다음 식의 기울기로 \(f_\theta\)를 갱신한다.
\[E_{x \sim p_{\text{data}}}\left[ f_\theta(x) - \lambda (\lVert \nabla_x f_\theta(x) \rVert_2 - 1)^2 \right] - E_{z \sim p(z)}[f_\theta(G(z))]\]스펙트럼 정규화
아이디어는 각 층 가중치 \(W_\ell\)의 특이값으로 Lipschitz 상수를 제한하는 것이다(Miyato et al., 2018). 신경망은 층(선형, 합성곱, ReLU 등)의 합성 \(f = f_3 \circ f_2 \circ f_1\)이고, 합성의 Lipschitz 상수는 각 층 상수의 곱으로 위에서 묶인다.
\[\lVert f \rVert_{\text{Lip}} \le \lVert f_3 \rVert_{\text{Lip}} \cdot \lVert f_2 \rVert_{\text{Lip}} \cdot \lVert f_1 \rVert_{\text{Lip}}\]직관적으로는 각 층이 선형 함수라고 생각하면 기울기들이 곱해진다. ReLU는 \(\max(0, x)\)이므로 최대 기울기가 1이다. 선형 층 \(Wx + b\)의 최대 기울기는 스펙트럼 노름(spectral norm), 즉 \(W\)의 최대 특이값이다.
\[\sigma(W) = \max_{h \ne 0} \frac{\lVert Wh \rVert}{\lVert h \rVert} = \max_{\lVert h \rVert \le 1} \lVert Wh \rVert\]방법은 매 기울기 스텝 후 \(W_\ell \leftarrow W_\ell / \sigma(W_\ell)\)로 강제하는 것이다. 효율적인 구현(거듭제곱 반복법 등)은 논문에 있다.
요약
GAN 학습이 어려운 이유는 판별기가 나쁜 기울기를 줄 수 있기 때문이다. 여러 “요령”이 GAN 학습을 훨씬 실용적으로 만든다. LSGAN, WGAN, WGAN-GP, 스펙트럼 정규화 같은 “매끄러운” 실수값 판별기, 그리고 instance noise가 그 예다. 이론은 상당히 복잡하지만 실제 방법은 매우 간단하며, 이런 GAN은 학습이 훨씬 쉽다.
정리
- GAN은 진짜와 가짜를 구분하는 판별기를 생성기의 학습 가능한 손실함수로 쓴다. 판별기와 생성기를 SGD 한 스텝씩 번갈아 갱신한다.
- 목적함수는 \(\min_\theta \max_\phi E_{p_{\text{data}}}[\log D_\phi(x)] + E_{p(z)}[\log(1 - D_\phi(G_\theta(z)))]\)이고, 생성기 기울기는 판별기를 거쳐 역전파한다.
- 최적 판별기는 \(D^\star(x) = p_{\text{data}}(x) / (p_{\text{data}}(x) + p_G(x))\)이며, 이를 대입하면 생성기는 JS 발산을 최소화한다. 그래서 GAN은 일부가 아닌 데이터 분포 전체를 덮으려 한다.
- 실제로는 초반 기울기가 큰 \(-\log D(G(z))\)를 생성기 손실로 자주 쓴다. 조건부 GAN은 조건을 양쪽에 넣고, CycleGAN은 순환 일관성으로 짝 없는 변환을 학습한다.
- 분포가 겹치지 않으면 판별기가 평평해져 생성기 기울기가 사라진다. JS 발산은 분포 사이의 거리를 반영하지 못한다.
- WGAN은 Wasserstein 거리와 Lipschitz 제약을 쓰고, 기울기 벌점과 스펙트럼 정규화는 그 제약을 더 잘 거는 방법이다. Instance noise도 효과적이다.