- PyTorch for Deep Learning (Daniel Bourke, freeCodeCamp) Chapter 0 정리
- 교재: learnpytorch.io
- 코드: MIT License
이 글은 강의 Chapter 0(PyTorch Fundamentals)의 도입부, 즉 텐서를 직접 다루기 전까지의 내용을 정리한다. 노트북 00_pytorch_fundamentals의 앞부분과 영상의 개념 설명 구간에 해당한다.
딥러닝이란
머신러닝(machine learning) 은 데이터를 숫자로 바꾸고, 그 숫자 안에서 패턴을 찾는 일이다. 패턴을 사람이 직접 규칙으로 적어 넣는 대신, 코드와 수학이 데이터로부터 패턴을 스스로 찾게 만든다. 딥러닝(deep learning) 은 머신러닝의 하위 분야로, 여러 층을 쌓은 신경망(neural network)을 써서 이 패턴을 찾는다. 인공지능(AI) ⊃ 머신러닝 ⊃ 딥러닝의 포함 관계로 보면 된다.
전통적인 프로그래밍과 비교하면 차이가 분명하다.
- 전통적 프로그래밍: 입력과 규칙을 사람이 정해 주면 프로그램이 출력을 만든다. 예를 들어 “닭고기 굽기 → 채소 썰기 → 섞기” 같은 조리법(규칙)을 순서대로 실행해 요리(출력)를 얻는다.
- 머신러닝: 입력과 출력(정답 예시)을 주면 알고리즘이 그 사이의 규칙을 찾아낸다. 재료와 완성된 요리를 많이 보여 주고 조리법을 알아내게 하는 셈이다.
머신러닝과 딥러닝을 쓰는 이유
규칙을 모두 적을 수 있다면 굳이 머신러닝이 필요 없다. 그러나 자율주행처럼 고려해야 할 상황이 끝없이 많은 문제는 규칙을 일일이 적을 수 없다. 이런 복잡한 문제에서 머신러닝, 특히 딥러닝이 힘을 발휘한다.
딥러닝이 잘 맞는 경우는 다음과 같다.
- 규칙 목록이 매우 긴 문제: 전통적 접근이 실패하는 곳에서 대안이 된다.
- 환경이 계속 바뀌는 문제: 새로운 시나리오에 맞춰 다시 학습(적응)할 수 있다.
- 대량의 데이터에서 통찰을 찾는 문제: 예를 들어 음식 사진 수만 장의 특징을 사람이 손으로 정의하기는 어렵다.
반대로 딥러닝이 (보통) 잘 맞지 않는 경우도 있다.
- 설명 가능성이 필요할 때: 딥러닝이 학습한 패턴(가중치)은 사람이 해석하기 어렵다.
- 전통적 방법이 더 나을 때: 단순한 규칙 기반 시스템으로 풀린다면 그쪽이 낫다.
- 오류를 용납할 수 없을 때: 출력이 확률적이어서 항상 예측 가능한 결과를 보장하지 않는다.
- 데이터가 많지 않을 때: 좋은 결과를 내려면 보통 많은 데이터가 필요하다(이를 우회하는 기법도 있다).
머신러닝의 제1 규칙
강의는 Google의 머신러닝 규칙(Rules of Machine Learning) 중 첫 번째를 강조한다. 머신러닝 없이 단순한 규칙 기반 시스템으로 풀 수 있다면 그렇게 하라. 머신러닝은 강력하지만 데이터 수집, 학습, 유지보수 비용이 따른다. 문제를 먼저 규칙으로 풀어 보고, 그것이 한계에 부딪힐 때 머신러닝을 꺼내는 것이 순서다.
머신러닝 대 딥러닝
데이터의 형태에 따라 잘 맞는 도구가 갈린다.
| 데이터 | 예시 | 주로 쓰는 방법 |
|---|---|---|
| 구조화 데이터(structured data) | 표 형태의 데이터(엑셀 시트, 데이터베이스 테이블) | 전통적 머신러닝: 그래디언트 부스팅(XGBoost 등), 랜덤 포레스트, SVM, 나이브 베이즈, k-최근접 이웃 |
| 비구조화 데이터(unstructured data) | 이미지, 텍스트, 음성, 영상 | 딥러닝: 신경망, 완전연결 신경망, 합성곱 신경망(CNN), 순환 신경망(RNN), 트랜스포머 |
경계가 엄격한 것은 아니다. 신경망으로 표 데이터를 다룰 수도 있고, 비구조화 데이터를 특징 추출로 표로 만들어 전통적 알고리즘에 넣을 수도 있다. 다만 이미지나 텍스트처럼 사람이 특징을 정의하기 어려운 데이터에서는 딥러닝이 표준이 되었다.
신경망의 구조
신경망으로 문제를 푸는 흐름은 다음 다섯 단계로 정리된다.
- 입력(inputs): 이미지, 텍스트, 음성 등 원래 데이터.
- 수치 인코딩(numerical encoding): 입력을 숫자, 즉 텐서로 바꾼다.
- 표현 학습(learns representation): 신경망이 숫자 안의 패턴(특징, 가중치)을 학습한다.
- 표현 출력(representation outputs): 신경망이 숫자로 된 출력(예: 클래스별 확률)을 낸다.
- 사람이 이해할 수 있는 출력(outputs): 숫자를 “라멘”, “스팸 아님” 같은 결과로 바꾼다.
신경망 자체는 입력층(input layer), 하나 이상의 은닉층(hidden layer), 출력층(output layer) 으로 이루어진다. 각 층은 여러 개의 뉴런(neuron, 은닉 유닛) 을 갖고, 층과 층 사이의 연결마다 학습 가능한 가중치가 있다. 은닉층이 많을수록 “깊은(deep)” 신경망이 된다. 층을 거칠 때 선형 계산과 함께 활성화 함수(activation function) 라는 비선형 함수를 적용하는데, 이것이 직선이 아닌 패턴을 학습하는 열쇠다(이 시리즈의 6편에서 직접 확인한다).
학습 패러다임
- 지도 학습(supervised learning): 데이터와 정답 레이블이 함께 있다. 예를 들어 고양이와 개 사진에 각각 “고양이”, “개” 레이블이 붙어 있다. 이 강의의 대부분이 지도 학습이다.
- 비지도 학습(unsupervised learning)과 자기지도 학습(self-supervised learning): 레이블 없이 데이터만으로 구조를 학습한다. 고양이와 개 사진에서 “두 종류가 있다”는 패턴은 찾지만, 그것이 고양이인지 개인지는 모른다.
- 전이 학습(transfer learning): 한 문제에서 학습한 모델의 패턴을 다른 문제에 가져와 쓴다. 적은 데이터로도 좋은 결과를 내는 강력한 방법이다.
- 강화 학습(reinforcement learning): 환경 안에서 행동하는 에이전트가 보상을 최대화하도록 학습한다(이 강의에서는 다루지 않는다).
딥러닝을 어디에 쓰는가
- 추천 시스템: 다음에 볼 영상이나 살 상품을 추천한다.
- 번역: 한 언어의 문장(시퀀스)을 다른 언어의 문장으로 바꾼다(seq2seq).
- 음성 인식: 음성 파형을 텍스트나 명령으로 바꾼다.
- 컴퓨터 비전(computer vision): 이미지 분류, 객체 탐지(예: 블랙박스 영상에서 차량 찾기).
- 자연어 처리(natural language processing, NLP): 스팸 분류, 감성 분석 등.
번역과 음성 인식처럼 입력과 출력이 모두 시퀀스인 문제를 seq2seq 문제, 이미지 분류나 스팸 판별처럼 입력을 정해진 범주로 나누는 문제를 분류(classification) 문제, 수치를 예측하는 문제를 회귀(regression) 문제라 부른다.
PyTorch란 무엇이고 왜 쓰는가
PyTorch는 오픈소스 머신러닝, 딥러닝 프레임워크다. 파이썬 코드로 데이터를 다루고 머신러닝 알고리즘을 작성할 수 있게 해 준다.
누가 쓰는가. Meta(Facebook), Tesla, Microsoft 같은 대형 기술 기업과 OpenAI 같은 AI 연구 기업이 연구와 제품에 PyTorch를 쓴다. Tesla는 자율주행 컴퓨터 비전 모델을, 농업 분야에서는 트랙터의 컴퓨터 비전을 PyTorch로 구동한다.
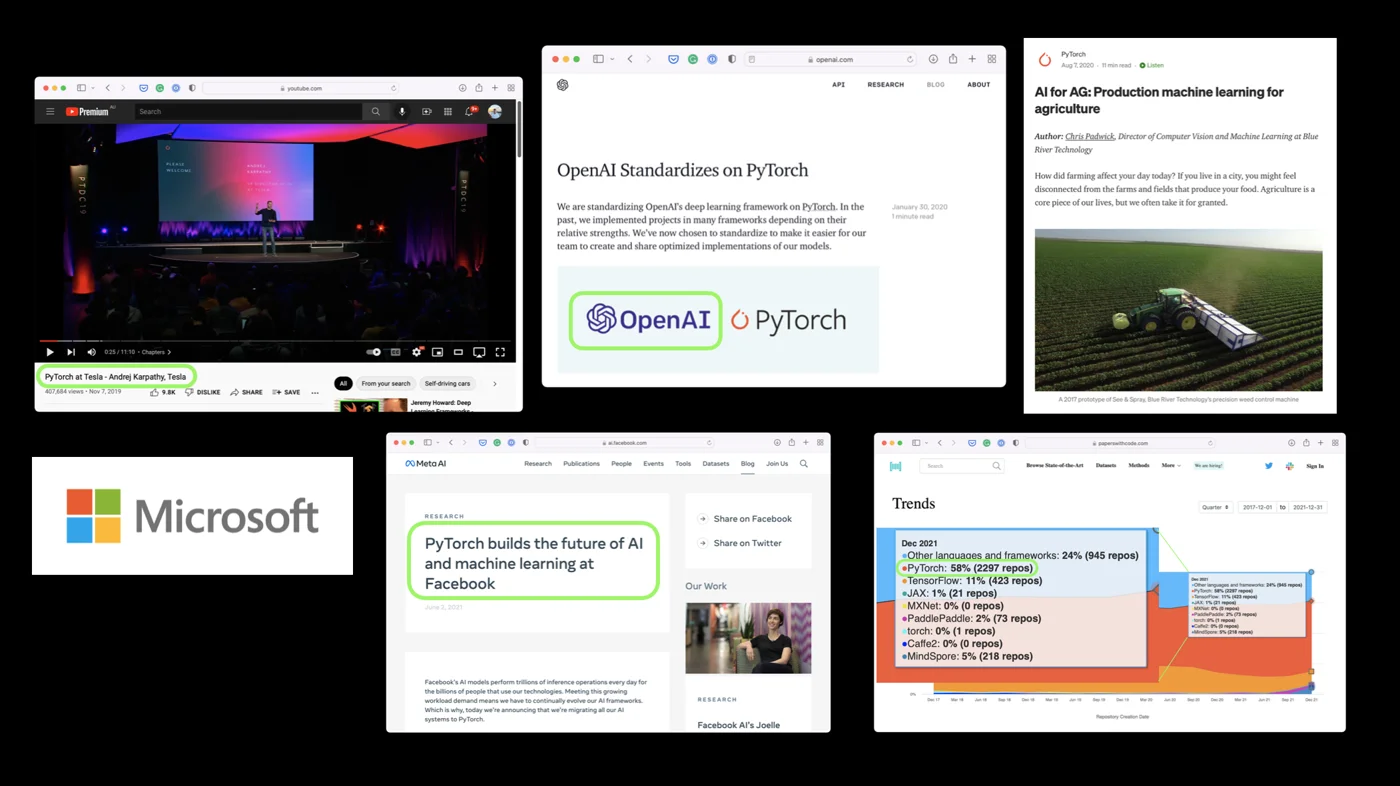 연구와 산업 전반에서 쓰이는 PyTorch. Tesla의 Andrej Karpathy 발표, OpenAI의 PyTorch 표준화 발표, 농업용 컴퓨터 비전 사례, Microsoft, Meta AI의 PyTorch 전환 발표, 그리고 Papers with Code 집계에서 PyTorch가 2021년 12월 기준 논문 코드 저장소의 58%를 차지한 추세 그래프다. 출처: learnpytorch.io (Daniel Bourke, MIT License).
왜 쓰는가.
- 연구자들이 가장 많이 쓴다. 2022년 2월 기준 Papers with Code에서 가장 많이 쓰인 딥러닝 프레임워크다. 최신 논문의 구현을 PyTorch로 찾기 쉽다는 뜻이기도 하다.
- GPU 가속을 뒤에서 처리해 준다. 텐서 연산을 GPU에서 빠르게 돌리는 일을 PyTorch가 맡으므로, 사용자는 데이터 처리와 알고리즘 작성에 집중할 수 있다.
- 파이썬답다(Pythonic). NumPy와 비슷한 문법으로 텐서를 다루고, 모델을 파이썬 클래스로 정의한다.
- 생태계가 넓다.
torchvision(이미지),torchtext(텍스트),torchaudio(오디오) 같은 도메인 라이브러리와 사전 학습 모델 저장소(TorchHub)가 있다. - 배포까지 이어진다. 수십억 명에게 콘텐츠를 전달하고 수천 대의 차량을 움직이는 서비스에서 쓰일 만큼 실제 배포에도 검증되었다.
텐서란 무엇인가
텐서(tensor) 는 머신러닝과 딥러닝의 기본 구성 요소이며, 데이터를 숫자로 표현하는 역할을 한다. 앞의 “신경망의 구조”에서 본 흐름으로 말하면, 입력을 수치 인코딩한 결과도 텐서이고, 신경망이 학습하는 가중치도 텐서이며, 신경망의 출력도 텐서다.
예를 들어 이미지는 [3, 224, 224] 모양의 텐서로 표현할 수 있다. 이는 [colour_channels, height, width], 즉 색 채널 3개(빨강, 초록, 파랑)와 높이 224픽셀, 너비 224픽셀을 뜻한다. 텐서 용어로 말하면 이 텐서는 색 채널, 높이, 너비의 3개 차원(dimension) 을 가진다.
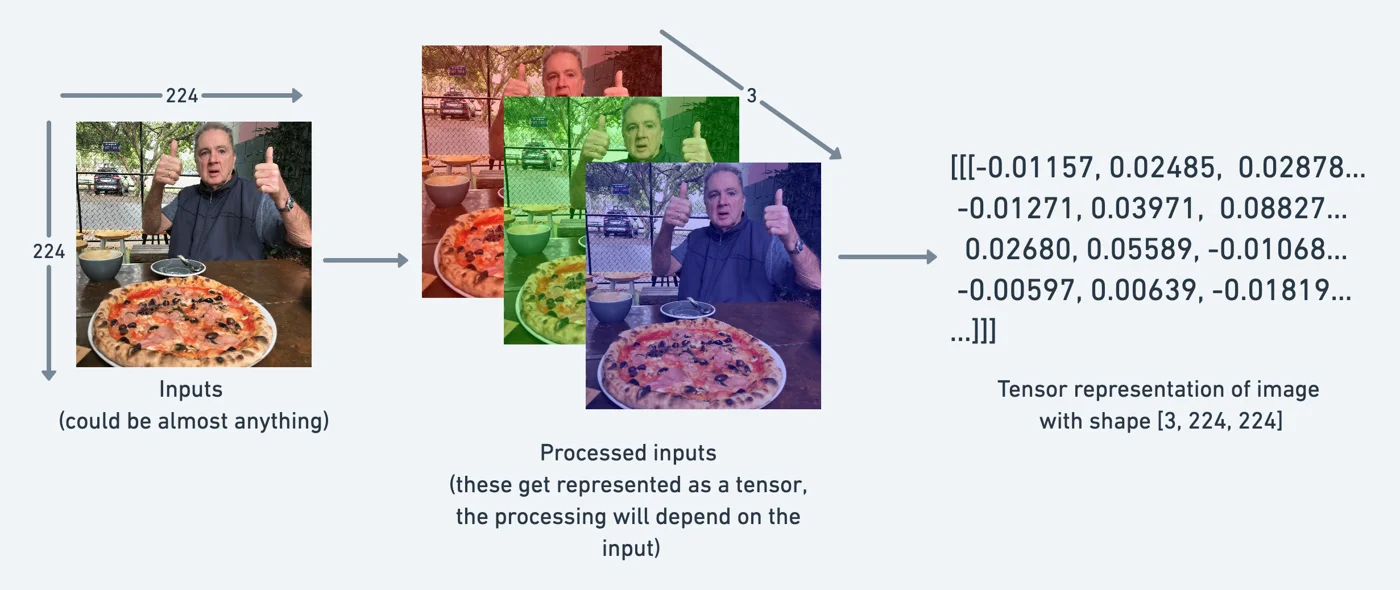 224×224 크기의 입력 이미지가 빨강, 초록, 파랑 3개 채널로 분해되고, 최종적으로
[3, 224, 224] 모양의 숫자 텐서로 표현되는 과정. 입력은 거의 무엇이든 될 수 있고, 텐서로 바꾸는 전처리 방식은 입력의 종류에 따라 달라진다. 출처: learnpytorch.io (Daniel Bourke, MIT License).
그림의 왼쪽은 원본 사진, 가운데는 채널별로 분리된 사진 3장, 오른쪽은 그 픽셀 값을 숫자로 늘어놓은 텐서다. 신경망은 사진을 “보는” 것이 아니라 오른쪽의 숫자 텐서를 받아 연산한다. 텐서를 실제로 만들고 다루는 방법은 다음 글에서 정리한다.
강의 구성
강의는 노트북 단위(00, 01, 02, …)로 나뉘고, 뒤의 노트북은 앞의 지식을 바탕으로 한다. 이 시리즈는 다음 다섯 개 노트북을 다룬다.
| 노트북 | 주제 |
|---|---|
| 00 | PyTorch 기초: 텐서 생성, 정보 확인, 연산, 모양 다루기, 인덱싱, NumPy 연동, 재현성, GPU |
| 01 | PyTorch 워크플로: 데이터 준비, 모델 구축, 학습, 평가, 저장과 불러오기 |
| 02 | 신경망 분류: 이진 분류와 다중 클래스 분류, 비선형성 |
| 03 | 컴퓨터 비전: FashionMNIST, 미니배치, CNN |
| 04 | 커스텀 데이터셋: 직접 모은 이미지 데이터, 데이터 증강 |
노트북 00이 다루는 세부 주제는 다음과 같다.
| 주제 | 내용 |
|---|---|
| 텐서 소개 | 텐서는 모든 머신러닝, 딥러닝의 기본 구성 요소다. |
| 텐서 생성 | 텐서는 이미지, 단어, 숫자 표 등 거의 모든 데이터를 표현할 수 있다. |
| 텐서에서 정보 얻기 | 텐서에 넣은 정보를 꺼내는 방법. |
| 텐서 조작 | 덧셈, 곱셈, 결합 등 신경망 알고리즘이 쓰는 여러 연산. |
| 텐서 모양 다루기 | 머신러닝에서 가장 흔한 오류는 모양 불일치다. |
| 텐서 인덱싱 | 파이썬 리스트, NumPy 배열과 비슷하지만 차원이 훨씬 많을 수 있다. |
| PyTorch와 NumPy | torch.Tensor와 np.ndarray를 오가는 방법. |
| 재현성 | 무작위성을 덜 무작위하게 만드는 방법. |
| GPU에서 텐서 실행 | GPU로 코드를 빠르게 돌리는 방법. |
강의를 대하는 방법
강의 전반에 걸쳐 반복되는 태도는 다음과 같다.
- 코드를 직접 작성한다(code along). 영상과 함께 코드를 타이핑하는 것이 가장 효과적이다.
- 의심스러우면 코드를 실행한다(if in doubt, run the code). 결과를 추측하기보다 실행해서 확인한다.
- 실험, 실험, 실험(experiment, experiment, experiment). 값과 설정을 바꿔 보며 무엇이 달라지는지 관찰한다.
- 시각화, 시각화, 시각화(visualize, visualize, visualize). 데이터와 예측을 그림으로 그려 보면 이해가 빨라진다.
- 질문한다. 모르는 것은 검색하고, 토론 게시판에 묻는다.
- 연습 문제를 푼다. 각 노트북 끝의 연습 문제와 추가 학습(extra-curriculum)을 활용한다.
- 배운 것을 공유한다. 정리하고 공개하는 과정에서 이해가 깊어진다.
그리고 “나는 못 배운다”는 생각에 갇히지 않는 것이 중요하다. 처음에는 낯선 개념이 많지만, 반복하면 익숙해진다.
참고 자료
- 강의 자료 전체: GitHub 저장소
- 질문: 저장소의 Discussions 페이지
- 온라인 교재: learnpytorch.io
- PyTorch 공식 문서와 PyTorch 개발자 포럼
실습 환경 준비
강의는 Google Colab을 기본 환경으로 쓴다. Colab은 브라우저에서 돌아가는 Jupyter 노트북 환경으로, PyTorch를 비롯한 주요 라이브러리가 미리 설치되어 있고 무료 GPU도 제공한다. GPU를 쓰려면 메뉴에서 런타임(Runtime) → 런타임 유형 변경(Change runtime type) → 하드웨어 가속기(Hardware accelerator)를 GPU로 바꾼다. 로컬 컴퓨터에서 실습한다면 PyTorch 설치 안내를 따른다.
설치가 끝났으면 PyTorch를 불러오고 버전을 확인한다.
import torch
torch.__version__
'1.13.1+cu116'
출력의 +cu116은 CUDA 11.6용으로 빌드된 PyTorch라는 뜻이다. 강의 자료는 PyTorch 1.10.0 이상을 기준으로 하며, 버전이 훨씬 높으면 일부 출력이 조금 다를 수 있다.
Colab에서 GPU가 연결되었는지는 셸 명령으로 확인할 수 있다. 노트북 셀에서 !로 시작하는 줄은 파이썬이 아니라 명령줄에서 실행된다.
!nvidia-smi
NVIDIA GPU가 있으면 GPU 이름, 메모리 사용량, CUDA 버전 등이 표로 출력되고, 없으면 드라이버와 통신할 수 없다는 오류가 출력된다. PyTorch 안에서 GPU를 확인하고 쓰는 방법은 다음 글의 마지막 부분에서 다룬다.
정리
- 머신러닝은 데이터를 숫자로 바꾸고 그 안의 패턴을 찾는 일이며, 딥러닝은 여러 층의 신경망으로 이를 수행하는 머신러닝의 하위 분야다.
- 전통적 프로그래밍은 입력과 규칙으로 출력을 만들고, 머신러닝은 입력과 출력으로부터 규칙을 찾는다.
- 규칙 기반으로 풀 수 있는 문제라면 머신러닝을 쓰지 않는 것이 머신러닝의 제1 규칙이다. 설명 가능성이 중요하거나 오류를 용납할 수 없거나 데이터가 적을 때도 딥러닝은 적합하지 않을 수 있다.
- 구조화 데이터에는 그래디언트 부스팅 같은 전통적 머신러닝이, 이미지나 텍스트 같은 비구조화 데이터에는 딥러닝이 주로 쓰인다.
- 신경망은 입력을 수치 인코딩하고, 은닉층에서 표현을 학습한 뒤, 출력층에서 숫자 출력을 내며, 이를 사람이 이해할 수 있는 결과로 바꾼다.
- PyTorch는 연구에서 가장 많이 쓰이는 파이썬 기반 딥러닝 프레임워크로, GPU 가속과 넓은 생태계를 제공한다.
- 텐서는 데이터와 모델의 가중치, 출력을 모두 표현하는 숫자 배열이며, 이미지는 예를 들어
[3, 224, 224]모양의 텐서가 된다.