- PyTorch for Deep Learning (Daniel Bourke, freeCodeCamp) Chapter 2 정리
- 교재: learnpytorch.io
- 코드: MIT License
지난 글에서는 make_circles로 만든 빨강/파랑 원 데이터를 이진 분류(binary classification)하는 모델을 만들었다. 층을 하나 더 쌓고(CircleModelV1, 은닉 유닛 10개, 선형 층 3개) 1000 에폭을 학습해도 정확도는 50% 근처에 머물렀고, 결정 경계(decision boundary)를 그려 보면 모델은 여전히 두 원 사이에 직선만 긋고 있었다. 이 글은 그 원인을 찾는 데서 출발한다.
이 글의 코드는 지난 글에서 정의한 device, accuracy_fn, 그리고 강의 저장소의 helper_functions.py에 있는 plot_predictions, plot_decision_boundary를 그대로 쓴다.
import torch
from torch import nn
import matplotlib.pyplot as plt

device = "cuda" if torch.cuda.is_available() else "cpu"

def accuracy_fn(y_true, y_pred):
    correct = torch.eq(y_true, y_pred).sum().item()  # 두 텐서가 같은 위치의 개수
    return (correct / len(y_pred)) * 100

# helper_functions.py는 github.com/mrdbourke/pytorch-deep-learning 에서 내려받는다
from helper_functions import plot_predictions, plot_decision_boundary
직선 데이터로 모델 점검하기
모델이 직선만 긋는다면, 적어도 직선 데이터는 맞힐 수 있어야 한다. 이것을 확인하면 “모델이 아무것도 배우지 못하는 구조인가, 아니면 데이터에 맞지 않는 구조인가”를 가를 수 있다. PyTorch 3에서 쓴 선형 회귀 데이터(가중치 0.7, 편향 0.3)를 다시 만든다.
weight = 0.7
bias = 0.3
start, end, step = 0, 1, 0.01

X_regression = torch.arange(start, end, step).unsqueeze(dim=1)  # [100] -> [100, 1]
y_regression = weight * X_regression + bias                     # 선형 회귀 공식

print(len(X_regression))
X_regression[:5], y_regression[:5]
100
(tensor([[0.0000],
         [0.0100],
         [0.0200],
         [0.0300],
         [0.0400]]),
 tensor([[0.3000],
         [0.3070],
         [0.3140],
         [0.3210],
         [0.3280]]))
unsqueeze(dim=1)은 특성 차원을 하나 추가한다. nn.Linear는 입력의 마지막 차원을 특성으로 보므로, 샘플 100개에 특성 1개인 [100, 1] 모양이 필요하다. 앞 80%를 학습용, 뒤 20%를 테스트용으로 자른다(시계열처럼 순서가 있는 데이터이므로 섞지 않는다).
train_split = int(0.8 * len(X_regression))
X_train_regression, y_train_regression = X_regression[:train_split], y_regression[:train_split]
X_test_regression, y_test_regression = X_regression[train_split:], y_regression[train_split:]

print(len(X_train_regression), len(y_train_regression),
      len(X_test_regression), len(y_test_regression))
80 80 20 20
model_1 구조로 직선 맞추기
model_1과 같은 구조(선형 층 3개, 은닉 유닛 10개)를 nn.Sequential로 다시 만든다. 달라진 점은 두 가지다. 입력 특성이 2개(원 데이터의 x, y 좌표)에서 1개로 줄었고, 회귀 문제이므로 손실 함수를 nn.L1Loss()(평균 절대 오차, MAE)로 바꿨다.
model_2 = nn.Sequential(
    nn.Linear(in_features=1, out_features=10),
    nn.Linear(in_features=10, out_features=10),
    nn.Linear(in_features=10, out_features=1)
).to(device)

loss_fn = nn.L1Loss()
optimizer = torch.optim.SGD(model_2.parameters(), lr=0.1)
학습 루프는 지금까지와 같은 다섯 단계다.
- 순전파(forward pass):
model_2(X)로 예측을 계산한다. - 손실 계산:
loss_fn(y_pred, y). 회귀이므로 정확도는 계산하지 않는다. optimizer.zero_grad(): 이전 스텝에서 누적된 그래디언트를 지운다.loss.backward(): 역전파로 각 매개변수의 그래디언트를 구한다.optimizer.step(): 그래디언트로 매개변수를 갱신한다.
torch.manual_seed(42)
epochs = 1000

# 데이터도 모델과 같은 장치에 있어야 한다
X_train_regression, y_train_regression = X_train_regression.to(device), y_train_regression.to(device)
X_test_regression, y_test_regression = X_test_regression.to(device), y_test_regression.to(device)

for epoch in range(epochs):
    ### 학습
    model_2.train()
    y_pred = model_2(X_train_regression)
    loss = loss_fn(y_pred, y_train_regression)
    optimizer.zero_grad()
    loss.backward()
    optimizer.step()

    ### 테스트
    model_2.eval()
    with torch.inference_mode():
        test_pred = model_2(X_test_regression)
        test_loss = loss_fn(test_pred, y_test_regression)

    if epoch % 100 == 0:
        print(f"Epoch: {epoch} | Train loss: {loss:.5f}, Test loss: {test_loss:.5f}")
Epoch: 0 | Train loss: 0.75986, Test loss: 0.54143
Epoch: 100 | Train loss: 0.09309, Test loss: 0.02901
Epoch: 200 | Train loss: 0.07376, Test loss: 0.02850
Epoch: 300 | Train loss: 0.06745, Test loss: 0.00615
Epoch: 400 | Train loss: 0.06107, Test loss: 0.02004
Epoch: 500 | Train loss: 0.05698, Test loss: 0.01061
Epoch: 600 | Train loss: 0.04857, Test loss: 0.01326
Epoch: 700 | Train loss: 0.06109, Test loss: 0.02127
Epoch: 800 | Train loss: 0.05599, Test loss: 0.01426
Epoch: 900 | Train loss: 0.05571, Test loss: 0.00603
model.eval()은 드롭아웃이나 배치 정규화처럼 학습과 평가에서 다르게 동작하는 층을 평가 모드로 바꾸고, torch.inference_mode()는 그래디언트 추적을 끄고 계산을 빠르게 한다. 분류 데이터에서는 손실이 0.693 근처(무작위 추측 수준)에서 꼼짝하지 않았던 것과 달리, 여기서는 손실이 분명히 줄어든다.
예측을 그려 확인한다. matplotlib은 GPU 텐서를 다루지 못하므로 .cpu()로 옮긴 뒤 넘긴다.
model_2.eval()
with torch.inference_mode():
    y_preds = model_2(X_test_regression)

plot_predictions(train_data=X_train_regression.cpu(),
                 train_labels=y_train_regression.cpu(),
                 test_data=X_test_regression.cpu(),
                 test_labels=y_test_regression.cpu(),
                 predictions=y_preds.cpu())
예측점이 테스트 데이터의 직선 위에 거의 겹친다. 즉 이 모델은 학습할 능력은 있다. 문제는 모델이 그릴 수 있는 것이 직선뿐이라는 데 있다.
모델을 디버깅할 때는 가능한 한 작게 시작하는 것이 좋다. 작은 네트워크와 작은 데이터셋으로 먼저 동작을 확인하고, 일부러 과적합(overfitting)까지 시켜 본 다음에 데이터나 모델을 키운다.
빠진 조각: 비선형성
선형 층을 아무리 쌓아도 결과는 하나의 선형 함수다. \(W_3(W_2(W_1 x + b_1) + b_2) + b_3\)를 전개하면 \(W x + b\) 꼴이 되기 때문이다. 원 모양의 데이터를 가르려면 곧지 않은 선, 즉 비선형(non-linear) 함수가 필요하다.
원 데이터 다시 만들기
from sklearn.datasets import make_circles
from sklearn.model_selection import train_test_split

X, y = make_circles(n_samples=1000, noise=0.03, random_state=42)

# NumPy(float64) -> torch.float32. PyTorch의 기본 자료형에 맞춘다
X = torch.from_numpy(X).type(torch.float)
y = torch.from_numpy(y).type(torch.float)

X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
X_train[:5], y_train[:5]
(tensor([[ 0.6579, -0.4651],
         [ 0.6319, -0.7347],
         [-1.0086, -0.1240],
         [-0.9666, -0.2256],
         [-0.1666,  0.7994]]),
 tensor([1., 0., 0., 0., 1.]))
ReLU를 넣은 모델
PyTorch에는 여러 비선형 활성화 함수가 준비되어 있다. 가장 흔하고 성능이 좋은 것 중 하나가 ReLU(rectified linear unit), nn.ReLU()다. 은닉층 사이에 끼워 넣는다.
class CircleModelV2(nn.Module):
    def __init__(self):
        super().__init__()
        self.layer_1 = nn.Linear(in_features=2, out_features=10)
        self.layer_2 = nn.Linear(in_features=10, out_features=10)
        self.layer_3 = nn.Linear(in_features=10, out_features=1)
        self.relu = nn.ReLU()  # 매개변수가 없으므로 하나를 만들어 여러 번 써도 된다

    def forward(self, x):
        # 선형 -> ReLU -> 선형 -> ReLU -> 선형
        return self.layer_3(self.relu(self.layer_2(self.relu(self.layer_1(x)))))

model_3 = CircleModelV2().to(device)
print(model_3)
CircleModelV2(
  (layer_1): Linear(in_features=2, out_features=10, bias=True)
  (layer_2): Linear(in_features=10, out_features=10, bias=True)
  (layer_3): Linear(in_features=10, out_features=1, bias=True)
  (relu): ReLU()
)
마지막 층 뒤에는 ReLU를 두지 않았다. 출력은 로짓(logit)이어야 하고, 시그모이드는 손실 함수 nn.BCEWithLogitsLoss()가 내부에서 처리하기 때문이다.
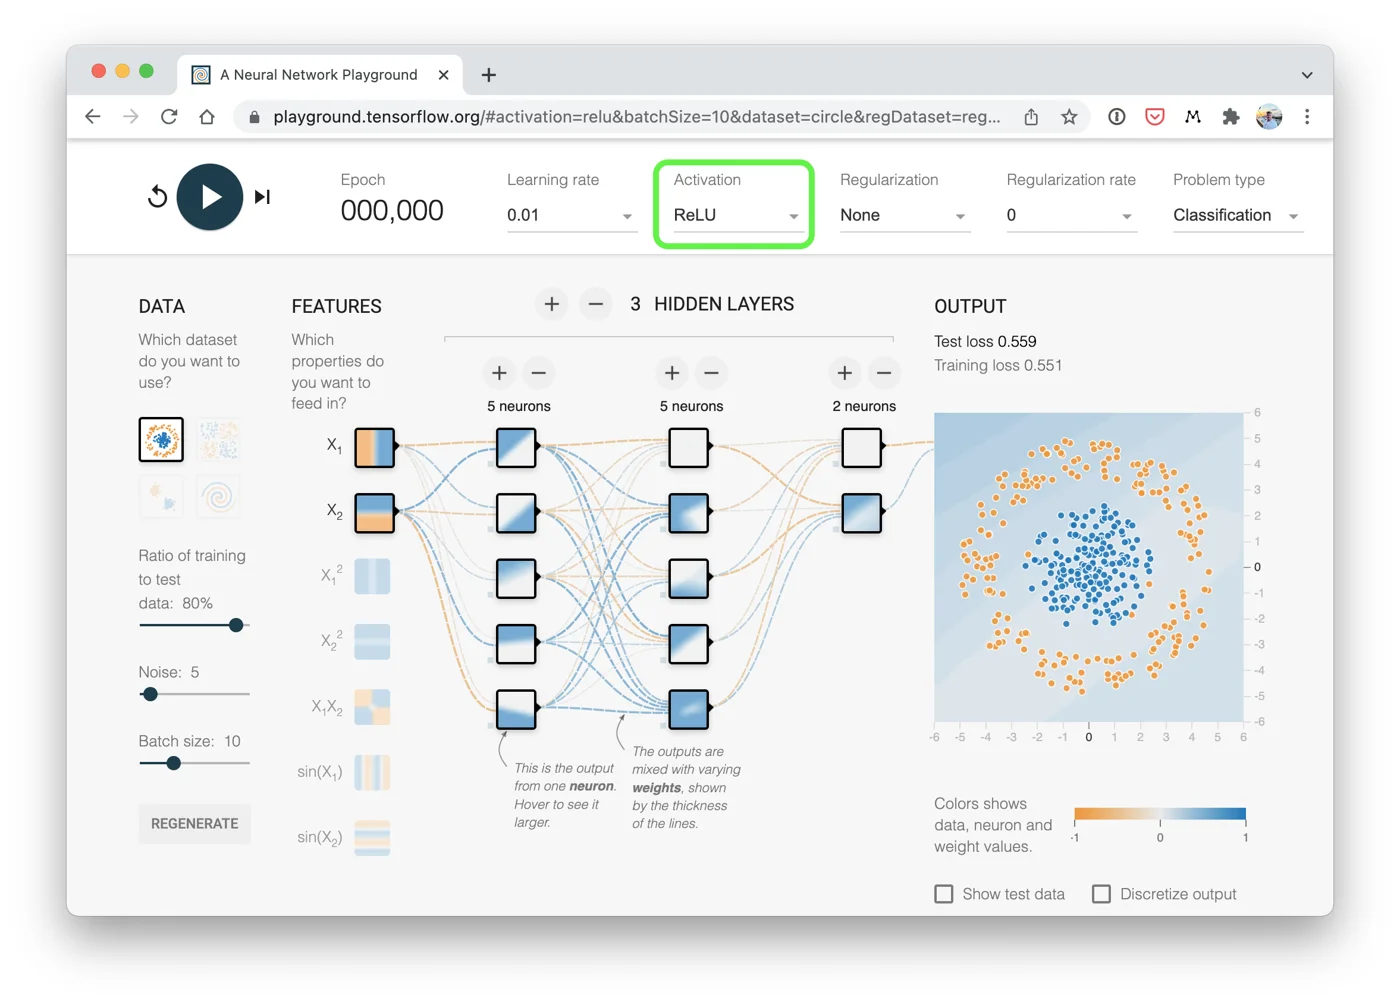 TensorFlow Playground에서 방금 만든 것과 비슷한 신경망(은닉층 3개, ReLU 활성화)을 원 데이터에 적용한 화면. 출처: learnpytorch.io (Daniel Bourke, MIT License).
위 화면의 Activation 칸(초록 테두리)이 ReLU로 설정되어 있고, 가운데에 은닉층 뉴런들이 굵기가 다른 선(가중치)으로 연결되어 있다. 오른쪽 OUTPUT 패널에는 안쪽 파란 점과 바깥 주황 점으로 이루어진 원 데이터가 보인다. 직접 TensorFlow Playground에서 활성화를 Linear로 바꿔 보면 아무리 학습해도 경계가 직선에 머물고, ReLU로 두면 원을 둘러싸는 경계가 생긴다.
비선형 활성화 함수는 보통 은닉층 사이와 출력층 직후에 둔다. 다만 정해진 규칙은 없으며, 실험으로 정한다.
학습과 평가
loss_fn = nn.BCEWithLogitsLoss()  # 로짓을 받아 내부에서 시그모이드 + BCE를 계산
optimizer = torch.optim.SGD(model_3.parameters(), lr=0.1)

torch.manual_seed(42)
epochs = 1000
X_train, y_train = X_train.to(device), y_train.to(device)
X_test, y_test = X_test.to(device), y_test.to(device)

for epoch in range(epochs):
    model_3.train()
    # 1. 순전파. 출력 [800, 1]을 squeeze해 레이블과 같은 [800]으로 맞춘다
    y_logits = model_3(X_train).squeeze()
    y_pred = torch.round(torch.sigmoid(y_logits))  # 로짓 -> 확률 -> 레이블(0/1)

    # 2. 손실은 로짓으로, 정확도는 레이블로 계산
    loss = loss_fn(y_logits, y_train)
    acc = accuracy_fn(y_true=y_train, y_pred=y_pred)

    optimizer.zero_grad()   # 3
    loss.backward()         # 4
    optimizer.step()        # 5

    model_3.eval()
    with torch.inference_mode():
        test_logits = model_3(X_test).squeeze()
        test_pred = torch.round(torch.sigmoid(test_logits))
        test_loss = loss_fn(test_logits, y_test)
        test_acc = accuracy_fn(y_true=y_test, y_pred=test_pred)

    if epoch % 100 == 0:
        print(f"Epoch: {epoch} | Loss: {loss:.5f}, Accuracy: {acc:.2f}% | "
              f"Test Loss: {test_loss:.5f}, Test Accuracy: {test_acc:.2f}%")
Epoch: 0 | Loss: 0.69295, Accuracy: 50.00% | Test Loss: 0.69319, Test Accuracy: 50.00%
Epoch: 100 | Loss: 0.69115, Accuracy: 52.88% | Test Loss: 0.69102, Test Accuracy: 52.50%
Epoch: 200 | Loss: 0.68977, Accuracy: 53.37% | Test Loss: 0.68940, Test Accuracy: 55.00%
Epoch: 300 | Loss: 0.68795, Accuracy: 53.00% | Test Loss: 0.68723, Test Accuracy: 56.00%
Epoch: 400 | Loss: 0.68517, Accuracy: 52.75% | Test Loss: 0.68411, Test Accuracy: 56.50%
Epoch: 500 | Loss: 0.68102, Accuracy: 52.75% | Test Loss: 0.67941, Test Accuracy: 56.50%
Epoch: 600 | Loss: 0.67515, Accuracy: 54.50% | Test Loss: 0.67285, Test Accuracy: 56.00%
Epoch: 700 | Loss: 0.66659, Accuracy: 58.38% | Test Loss: 0.66322, Test Accuracy: 59.00%
Epoch: 800 | Loss: 0.65160, Accuracy: 64.00% | Test Loss: 0.64757, Test Accuracy: 67.50%
Epoch: 900 | Loss: 0.62362, Accuracy: 74.00% | Test Loss: 0.62145, Test Accuracy: 79.00%
후반부로 갈수록 정확도가 빠르게 오른다. 테스트 데이터로 예측을 만들고 결정 경계를 비교한다.
model_3.eval()
with torch.inference_mode():
    y_preds = torch.round(torch.sigmoid(model_3(X_test))).squeeze()

plt.figure(figsize=(12, 6))
plt.subplot(1, 2, 1); plt.title("Train")
plot_decision_boundary(model_1, X_train, y_train)  # model_1: 비선형성 없음
plt.subplot(1, 2, 2); plt.title("Test")
plot_decision_boundary(model_3, X_test, y_test)    # model_3: ReLU 있음
model_1은 여전히 평면을 직선으로 반씩 나누지만, model_3은 안쪽 원을 감싸는 굽은 경계를 그린다. 완벽하지는 않으므로 더 오래 학습하거나 은닉 유닛을 늘리거나 학습률을 바꾸는 등 지난 글의 모델 개선 기법을 시도해 볼 수 있다.
비선형 활성화 함수 직접 구현하기
ReLU와 시그모이드가 실제로 무엇을 하는지 직접 만들어 확인한다. 먼저 -10부터 9까지의 직선 텐서를 만든다.
A = torch.arange(-10, 10, 1, dtype=torch.float32)
A
tensor([-10.,  -9.,  -8.,  -7.,  -6.,  -5.,  -4.,  -3.,  -2.,  -1.,   0.,   1.,
          2.,   3.,   4.,   5.,   6.,   7.,   8.,   9.])
plt.plot(A)는 그냥 직선이다. ReLU는 음수를 0으로 바꾸고 양수는 그대로 둔다. \(\mathrm{ReLU}(x) = \max(0, x)\)이다.
def relu(x):
    return torch.maximum(torch.tensor(0), x)  # 두 인자 모두 텐서여야 한다

relu(A)
tensor([0., 0., 0., 0., 0., 0., 0., 0., 0., 0., 0., 1., 2., 3., 4., 5., 6., 7.,
        8., 9.])
plt.plot(relu(A))를 그리면 0에서 꺾이는 하키 스틱 모양이 나온다. 시그모이드(sigmoid) 는 다음과 같다.
def sigmoid(x):
    return 1 / (1 + torch.exp(-x))

sigmoid(A)
tensor([4.5398e-05, 1.2339e-04, 3.3535e-04, 9.1105e-04, 2.4726e-03, 6.6929e-03,
        1.7986e-02, 4.7426e-02, 1.1920e-01, 2.6894e-01, 5.0000e-01, 7.3106e-01,
        8.8080e-01, 9.5257e-01, 9.8201e-01, 9.9331e-01, 9.9753e-01, 9.9909e-01,
        9.9966e-01, 9.9988e-01])
모든 값이 0과 1 사이로 눌리고, 0에서 정확히 0.5가 된다. 이진 분류에서 로짓을 예측 확률로 바꿀 때 쓴 것이 바로 이 함수다. 그래프는 직선에서 S자 곡선으로 바뀐다.
직선(선형)과 곧지 않은 선(비선형)을 무제한으로 쓸 수 있다면 거의 어떤 패턴이든 그릴 수 있다. 신경망이 하는 일이 바로 그것이다. 모델에게 무엇을 하라고 지시하는 대신 선형 함수와 비선형 함수라는 도구를 주고, 데이터에서 패턴을 찾는 방법은 모델이 스스로 알아내게 한다.
다중 클래스 분류 문제 만들기
이진 분류는 둘 중 하나(고양이 또는 개)를 고르고, 다중 클래스 분류(multi-class classification) 는 셋 이상의 선택지(고양이, 개, 닭) 중 하나를 고른다. 예를 들어 컴퓨터 비전 벤치마크인 ImageNet-1k는 클래스가 1000개다.
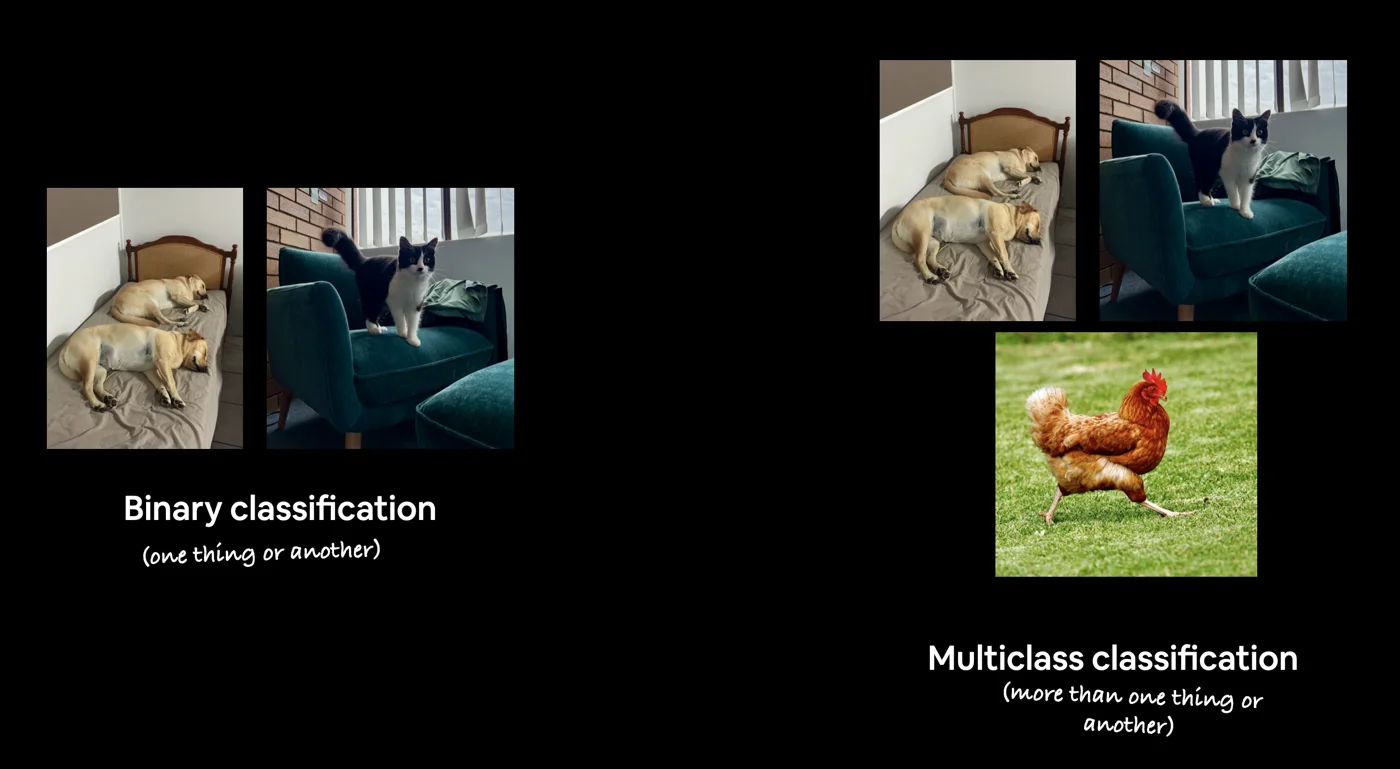 왼쪽은 개와 고양이 사진 중 하나를 고르는 이진 분류, 오른쪽은 개, 고양이, 닭 중 하나를 고르는 다중 클래스 분류다. 출처: learnpytorch.io (Daniel Bourke, MIT License).
데이터: make_blobs
Scikit-Learn의 make_blobs()는 centers 개수만큼의 점 무리(클래스)를 만든다. 순서는 다음과 같다.
make_blobs()로 다중 클래스 데이터를 만든다.- 텐서로 바꾼다(기본 출력은 NumPy 배열).
train_test_split()으로 학습/테스트 세트를 나눈다.- 시각화한다.
from sklearn.datasets import make_blobs
from sklearn.model_selection import train_test_split

NUM_CLASSES = 4
NUM_FEATURES = 2
RANDOM_SEED = 42

# 1. 데이터 생성
X_blob, y_blob = make_blobs(n_samples=1000,
                            n_features=NUM_FEATURES,  # X 특성 수
                            centers=NUM_CLASSES,      # y 클래스 수
                            cluster_std=1.5,          # 무리를 조금 흩뜨린다(기본값 1.0)
                            random_state=RANDOM_SEED)

# 2. 텐서로 변환. 레이블은 정수(LongTensor)여야 한다
X_blob = torch.from_numpy(X_blob).type(torch.float)
y_blob = torch.from_numpy(y_blob).type(torch.LongTensor)
print(X_blob[:5], y_blob[:5])

# 3. 분할
X_blob_train, X_blob_test, y_blob_train, y_blob_test = train_test_split(
    X_blob, y_blob, test_size=0.2, random_state=RANDOM_SEED)

# 4. 시각화
plt.figure(figsize=(10, 7))
plt.scatter(X_blob[:, 0], X_blob[:, 1], c=y_blob, cmap=plt.cm.RdYlBu)
tensor([[-8.4134,  6.9352],
        [-5.7665, -6.4312],
        [-6.0421, -6.7661],
        [ 3.9508,  0.6984],
        [ 4.2505, -0.2815]]) tensor([3, 2, 2, 1, 1])
이진 분류에서는 레이블을 float로 바꿨지만, 여기서는 torch.LongTensor(int64)로 바꾼다. 뒤에서 쓸 nn.CrossEntropyLoss가 클래스 인덱스 형태의 정수 레이블을 기대하기 때문이다.
모델: BlobModel
입력 특성 수, 출력 특성 수(= 클래스 수), 은닉 유닛 수를 하이퍼파라미터로 받는 모델을 만든다.
class BlobModel(nn.Module):
    def __init__(self, input_features, output_features, hidden_units=8):
        super().__init__()
        self.linear_layer_stack = nn.Sequential(
            nn.Linear(in_features=input_features, out_features=hidden_units),
            # nn.ReLU(),  # 이 데이터에 비선형성이 필요할까? 주석을 풀어 비교해 볼 것
            nn.Linear(in_features=hidden_units, out_features=hidden_units),
            # nn.ReLU(),
            nn.Linear(in_features=hidden_units, out_features=output_features),  # 클래스마다 출력 1개
        )

    def forward(self, x):
        return self.linear_layer_stack(x)

model_4 = BlobModel(input_features=NUM_FEATURES,
                    output_features=NUM_CLASSES,
                    hidden_units=8).to(device)
model_4
BlobModel(
  (linear_layer_stack): Sequential(
    (0): Linear(in_features=2, out_features=8, bias=True)
    (1): Linear(in_features=8, out_features=8, bias=True)
    (2): Linear(in_features=8, out_features=4, bias=True)
  )
)
ReLU를 일부러 주석 처리해 두었다. 네 무리는 직선 몇 개로도 나눌 수 있을 만큼 떨어져 있으므로, 선형 층만으로 충분한지 확인해 보려는 것이다.
손실 함수와 옵티마이저
다중 클래스 분류의 표준 손실 함수는 nn.CrossEntropyLoss()다. 이 함수는 로짓을 그대로 받아 내부에서 softmax와 음의 로그우도를 함께 계산한다.
loss_fn = nn.CrossEntropyLoss()
optimizer = torch.optim.SGD(model_4.parameters(), lr=0.1)
로짓에서 예측 확률로: softmax
학습 전에 순전파를 한 번 해 보고 출력 모양을 확인한다.
model_4(X_blob_train.to(device))[:5]
tensor([[-1.2711, -0.6494, -1.4740, -0.7044],
        [ 0.2210, -1.5439,  0.0420,  1.1531],
        [ 2.8698,  0.9143,  3.3169,  1.4027],
        [ 1.9576,  0.3125,  2.2244,  1.1324],
        [ 0.5458, -1.2381,  0.4441,  1.1804]], device='cuda:0',
       grad_fn=<SliceBackward0>)
샘플마다 클래스 수만큼, 즉 4개의 값이 나온다. 이 원시 출력이 로짓이다. 이진 분류에서는 로짓 -> 시그모이드 -> 반올림으로 레이블을 얻었다. 다중 클래스에서는 로짓 -> softmax -> argmax를 쓴다. softmax 는 각 클래스의 로짓을 다른 모든 클래스와 비교한 확률로 바꾼다.
y_logits = model_4(X_blob_test.to(device))
y_pred_probs = torch.softmax(y_logits, dim=1)  # dim=1: 클래스 차원을 따라 정규화
print(y_logits[:5])
print(y_pred_probs[:5])
tensor([[-1.2549, -0.8112, -1.4795, -0.5696],
        [ 1.7168, -1.2270,  1.7367,  2.1010],
        [ 2.2400,  0.7714,  2.6020,  1.0107],
        [-0.7993, -0.3723, -0.9138, -0.5388],
        [-0.4332, -1.6117, -0.6891,  0.6852]], device='cuda:0',
       grad_fn=<SliceBackward0>)
tensor([[0.1872, 0.2918, 0.1495, 0.3715],
        [0.2824, 0.0149, 0.2881, 0.4147],
        [0.3380, 0.0778, 0.4854, 0.0989],
        [0.2118, 0.3246, 0.1889, 0.2748],
        [0.1945, 0.0598, 0.1506, 0.5951]], device='cuda:0',
       grad_fn=<SliceBackward0>)
dim=1이 중요하다. 출력 모양이 [샘플 수, 클래스 수]이므로, 한 샘플 안의 네 값(한 행)을 합이 1이 되게 만들어야 한다. dim=0으로 하면 배치 방향으로 정규화되어 의미가 없어진다. 실제로 첫 행을 더하면 1이다.
torch.sum(y_pred_probs[0])
tensor(1., device='cuda:0', grad_fn=<SumBackward0>)
가장 큰 확률의 인덱스가 모델이 고른 클래스다. torch.argmax()로 구한다.
print(y_pred_probs[0])
print(torch.argmax(y_pred_probs[0]))
tensor([0.1872, 0.2918, 0.1495, 0.3715], device='cuda:0',
       grad_fn=<SelectBackward0>)
tensor(3, device='cuda:0')
아직 학습 전이므로 이 예측은 무작위 추측(맞을 확률 25%)이다.
다중 클래스 학습 루프
학습 루프의 뼈대는 같고, 예측 레이블을 만드는 줄만 torch.softmax(..., dim=1).argmax(dim=1)로 바뀐다. 다중 클래스 모델에서 흔히 부딪히는 오류도 여기서 나온다. 레이블이 float이면 CrossEntropyLoss가 자료형 오류를 내므로 LongTensor로 바꿔야 하고, 모델과 데이터가 서로 다른 장치에 있으면 장치 오류가 나므로 모두 device로 옮겨야 한다.
torch.manual_seed(42)
epochs = 100

X_blob_train, y_blob_train = X_blob_train.to(device), y_blob_train.to(device)
X_blob_test, y_blob_test = X_blob_test.to(device), y_blob_test.to(device)

for epoch in range(epochs):
    ### 학습
    model_4.train()
    y_logits = model_4(X_blob_train)                         # [800, 4] 로짓
    y_pred = torch.softmax(y_logits, dim=1).argmax(dim=1)    # [800] 레이블

    loss = loss_fn(y_logits, y_blob_train)  # 로짓 [800, 4]와 정수 레이블 [800]
    acc = accuracy_fn(y_true=y_blob_train, y_pred=y_pred)

    optimizer.zero_grad()
    loss.backward()
    optimizer.step()

    ### 테스트
    model_4.eval()
    with torch.inference_mode():
        test_logits = model_4(X_blob_test)
        test_pred = torch.softmax(test_logits, dim=1).argmax(dim=1)
        test_loss = loss_fn(test_logits, y_blob_test)
        test_acc = accuracy_fn(y_true=y_blob_test, y_pred=test_pred)

    if epoch % 10 == 0:
        print(f"Epoch: {epoch} | Loss: {loss:.5f}, Acc: {acc:.2f}% | "
              f"Test Loss: {test_loss:.5f}, Test Acc: {test_acc:.2f}%")
Epoch: 0 | Loss: 1.04324, Acc: 65.50% | Test Loss: 0.57861, Test Acc: 95.50%
Epoch: 10 | Loss: 0.14398, Acc: 99.12% | Test Loss: 0.13037, Test Acc: 99.00%
Epoch: 20 | Loss: 0.08062, Acc: 99.12% | Test Loss: 0.07216, Test Acc: 99.50%
Epoch: 30 | Loss: 0.05924, Acc: 99.12% | Test Loss: 0.05133, Test Acc: 99.50%
Epoch: 40 | Loss: 0.04892, Acc: 99.00% | Test Loss: 0.04098, Test Acc: 99.50%
Epoch: 50 | Loss: 0.04295, Acc: 99.00% | Test Loss: 0.03486, Test Acc: 99.50%
Epoch: 60 | Loss: 0.03910, Acc: 99.00% | Test Loss: 0.03083, Test Acc: 99.50%
Epoch: 70 | Loss: 0.03643, Acc: 99.00% | Test Loss: 0.02799, Test Acc: 99.50%
Epoch: 80 | Loss: 0.03448, Acc: 99.00% | Test Loss: 0.02587, Test Acc: 99.50%
Epoch: 90 | Loss: 0.03300, Acc: 99.12% | Test Loss: 0.02423, Test Acc: 99.50%
10 에폭 만에 테스트 정확도가 99%에 이른다. 비선형성 없이도 잘 되는 것은 이 데이터가 직선으로 나눌 수 있는(linearly separable) 데이터이기 때문이다.
다중 클래스 예측과 평가
학습된 모델로 테스트 세트를 예측한다.
model_4.eval()
with torch.inference_mode():
    y_logits = model_4(X_blob_test)

y_logits[:3]
tensor([[  4.3377,  10.3539, -14.8948,  -9.7642],
        [  5.0142, -12.0371,   3.3860,  10.6699],
        [ -5.5885, -13.3448,  20.9894,  12.7711]], device='cuda:0')
여전히 로짓이다. 레이블(y_blob_test, 정수)과 비교하려면 같은 형태로 바꿔야 한다.
y_pred_probs = torch.softmax(y_logits, dim=1)  # 로짓 -> 확률
y_preds = y_pred_probs.argmax(dim=1)           # 확률 -> 레이블

print(f"Predictions: {y_preds[:10]}\nLabels: {y_blob_test[:10]}")
print(f"Test accuracy: {accuracy_fn(y_true=y_blob_test, y_pred=y_preds)}%")
Predictions: tensor([1, 3, 2, 1, 0, 3, 2, 0, 2, 0], device='cuda:0')
Labels: tensor([1, 3, 2, 1, 0, 3, 2, 0, 2, 0], device='cuda:0')
Test accuracy: 99.5%
softmax는 단조 함수이므로 순서를 바꾸지 않는다. 그래서 torch.argmax(y_logits, dim=1)처럼 로짓에 바로 argmax를 적용해도 같은 레이블을 얻는다. 계산 한 단계를 아끼는 대신 예측 확률은 얻지 못한다.
결정 경계를 그려 보면 네 무리를 직선 경계들이 깔끔하게 나눈다(plot_decision_boundary가 내부에서 데이터를 CPU로 옮긴다).
plt.figure(figsize=(12, 6))
plt.subplot(1, 2, 1); plt.title("Train")
plot_decision_boundary(model_4, X_blob_train, y_blob_train)
plt.subplot(1, 2, 2); plt.title("Test")
plot_decision_boundary(model_4, X_blob_test, y_blob_test)
그 밖의 분류 평가 지표
지금까지는 정확도, 손실, 예측 시각화로 평가했다. 분류 모델에는 다음 지표도 자주 쓴다.
| 지표 | 의미 | 코드 |
|---|---|---|
| 정확도(accuracy) | 예측 100개 중 맞힌 개수의 비율 | torchmetrics.Accuracy(), sklearn.metrics.accuracy_score() |
| 정밀도(precision) | 양성이라고 예측한 것 중 실제 양성의 비율. 높을수록 거짓 양성이 적다 | torchmetrics.Precision(), sklearn.metrics.precision_score() |
| 재현율(recall) | 실제 양성 중 양성이라고 예측한 비율. 높을수록 거짓 음성이 적다 | torchmetrics.Recall(), sklearn.metrics.recall_score() |
| F1 점수(F1-score) | 정밀도와 재현율을 하나로 합친 값. 1이 최고, 0이 최저 | torchmetrics.F1Score(), sklearn.metrics.f1_score() |
| 혼동 행렬(confusion matrix) | 예측과 정답을 표로 비교. 모두 맞으면 대각선에만 값이 있다 | torchmetrics.ConfusionMatrix |
| 분류 보고서(classification report) | 정밀도, 재현율, F1 등을 한꺼번에 출력 | sklearn.metrics.classification_report() |
정밀도와 재현율은 서로 맞바꾸는 관계(precision-recall tradeoff)에 있다. 클래스 비율이 크게 치우친 데이터에서는 정확도만으로는 모델을 제대로 평가할 수 없으므로 이 지표들이 필요하다. PyTorch 텐서와 장치를 그대로 쓰려면 TorchMetrics가 편하다.
from torchmetrics import Accuracy

# 지표 객체도 데이터와 같은 장치에 있어야 한다
torchmetrics_accuracy = Accuracy(task="multiclass", num_classes=4).to(device)
torchmetrics_accuracy(y_preds, y_blob_test)
tensor(0.9950, device='cuda:0')
직접 만든 accuracy_fn은 백분율(99.5)을, TorchMetrics는 0과 1 사이 값(0.995)을 반환한다.
정리
- 모델이 직선만 긋는다면 먼저 직선 회귀 데이터로 점검한다.
model_1과 같은 구조가 직선은 잘 맞히므로, 문제는 학습 능력이 아니라 비선형성의 부재였다. - 선형 층을 아무리 쌓아도 전체는 하나의 선형 함수다. 은닉층 사이에
nn.ReLU()를 넣자 원 데이터를 감싸는 굽은 결정 경계를 학습했다. - ReLU는 \(\max(0, x)\), 시그모이드는 \(1/(1+e^{-x})\)이며 둘 다 텐서 연산 몇 줄로 직접 구현할 수 있다.
- 다중 클래스 분류는 출력 유닛을 클래스 수만큼 두고, 손실은
nn.CrossEntropyLoss(), 레이블은 정수(torch.LongTensor)로 둔다. - 예측은
로짓 -> torch.softmax(dim=1) -> argmax(dim=1)순서로 만든다. softmax는 각 행의 합을 1로 만든다. make_blobs네 무리처럼 직선으로 나눌 수 있는 데이터는 비선형성 없이도 99.5% 정확도를 얻는다.- 정확도 외에 정밀도, 재현율, F1, 혼동 행렬 같은 지표가 있으며, TorchMetrics로 장치 위에서 바로 계산할 수 있다.