- PyTorch for Deep Learning (Daniel Bourke, freeCodeCamp) Chapter 2 정리
- 교재: learnpytorch.io
- 코드: MIT License
이 글은 노트북 02_pytorch_classification의 앞부분, 이진 분류 모델을 만들고 학습시킨 뒤 개선을 시도하는 데까지를 정리한다.
분류 문제란
분류(classification) 문제는 어떤 것이 이것인지 저것인지를 예측하는 문제다. 숫자를 예측하는 회귀(regression, 이전 글의 직선 예측)와 함께 가장 흔한 머신러닝 문제 유형이다.
| 문제 유형 | 의미 | 예 |
|---|---|---|
| 이진 분류(binary classification) | 정답이 두 가지 중 하나(예/아니오) | 건강 지표로 심장병 여부 예측 |
| 다중 클래스 분류(multi-class classification) | 정답이 셋 이상 중 하나 | 사진이 음식, 사람, 개 중 무엇인지 판단 |
| 다중 레이블 분류(multi-label classification) | 한 샘플에 정답이 여러 개일 수 있음 | 위키백과 문서에 붙일 분류(수학, 과학, 철학 등) 예측 |
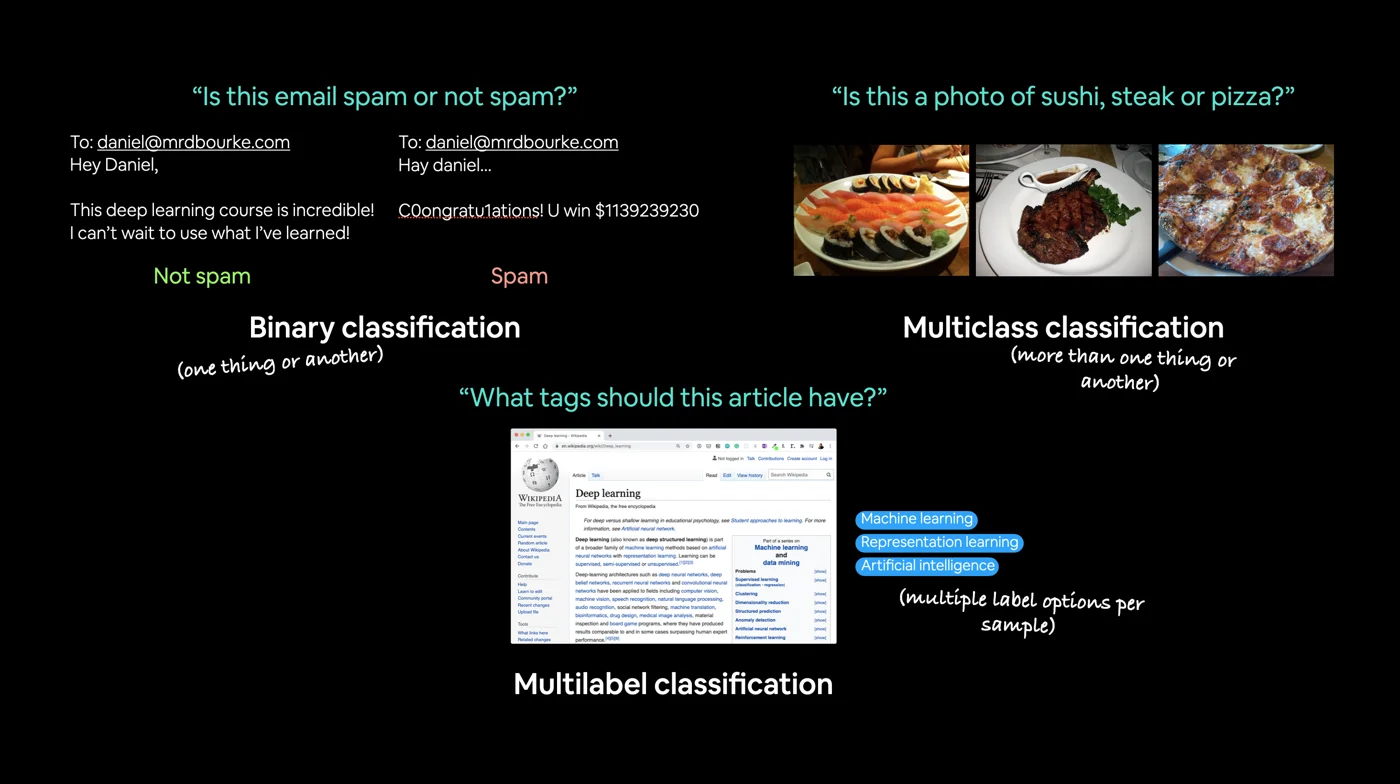 세 가지 분류 문제. 왼쪽 위는 이메일이 스팸인지 아닌지를 가리는 이진 분류(둘 중 하나), 오른쪽 위는 사진이 초밥, 스테이크, 피자 중 무엇인지 가리는 다중 클래스 분류(셋 이상 중 하나), 아래는 위키백과의 “Deep learning” 문서에 “Machine learning”, “Representation learning”, “Artificial intelligence” 태그를 동시에 붙이는 다중 레이블 분류(샘플당 레이블 여러 개)다. 출처: learnpytorch.io (Daniel Bourke, MIT License).
다중 클래스와 다중 레이블의 차이는 “하나만 고르느냐, 여러 개를 동시에 고를 수 있느냐”다. 사진 한 장은 초밥, 스테이크, 피자 중 정확히 하나에 속하지만, 문서 한 편은 여러 주제에 동시에 속할 수 있다.
이 장은 PyTorch 워크플로를 그대로 반복하되, 직선 대신 분류 문제를 푼다. 다루는 내용은 분류 신경망의 구조, 이진 분류 데이터 준비, 분류 모델 구축, 학습, 예측과 평가, 모델 개선, 비선형성, 다중 클래스 분류다. 이 글은 모델 개선 시도까지를 다룬다.
분류 문제의 입력과 출력
음식 사진 분류를 예로 들면 흐름은 다음과 같다.
- 입력: 사진. 컴퓨터가 다루려면 숫자로 바꿔야 한다.
- 수치 인코딩: 사진을
[batch_size, color_channels, height, width]모양의 텐서로 바꾼다. 예를 들어 224×224 컬러 사진 32장이면[32, 3, 224, 224]다. 배치 크기(batch size)는 한 번에 모델에 넣는 샘플 수이며, 32가 흔한 값이다. - 모델: 신경망이 숫자의 패턴을 학습한다. 사전 학습된 모델을 가져다 쓸 수도 있다.
- 출력: 클래스마다 하나씩 예측 확률(prediction probability) 이 나온다. 예를 들어
[0.97, 0.00, 0.03]이면 첫 번째 클래스(예: 초밥)일 확률이 가장 높다. - 사람이 이해할 수 있는 출력: 가장 높은 확률의 클래스 이름(“초밥”)을 내놓는다.
모델은 정답이 붙은 예시를 많이 보면서 입력과 출력의 관계를 배운다. 입력 모양과 출력 모양은 문제에 따라 달라지지만, “입력은 숫자 텐서, 출력은 클래스별 확률”이라는 틀은 같다.
분류 신경망의 구조
분류 신경망은 크기와 모양이 다양하지만 대체로 비슷한 설계도를 따른다.
| 하이퍼파라미터 | 이진 분류 | 다중 클래스 분류 |
|---|---|---|
입력층 모양 (in_features) |
특징 수와 같다(예: 심장병 예측에서 나이, 성별, 키, 몸무게, 흡연 여부의 5개) | 이진 분류와 같다 |
| 은닉층 | 문제에 따라 다르다. 최소 1개, 최대 제한 없음 | 이진 분류와 같다 |
| 은닉층당 뉴런 수 | 문제에 따라 다르다. 보통 10~512 | 이진 분류와 같다 |
출력층 모양 (out_features) |
1 (한 클래스 또는 다른 클래스) | 클래스당 1개 (예: 음식, 사람, 개 사진이면 3) |
| 은닉층 활성화 함수 | 보통 ReLU(rectified linear unit), 그 밖에도 많다 | 이진 분류와 같다 |
| 출력 활성화 함수 | 시그모이드(sigmoid, torch.sigmoid) |
소프트맥스(softmax, torch.softmax) |
| 손실 함수 | 이진 교차 엔트로피(torch.nn.BCELoss) |
교차 엔트로피(torch.nn.CrossEntropyLoss) |
| 옵티마이저 | SGD, Adam 등(torch.optim) |
이진 분류와 같다 |
이 목록은 문제에 따라 바뀌지만 시작점으로는 충분하다. 이 장에서는 이 표를 하나씩 코드로 옮긴다.
분류 데이터 만들기
Scikit-Learn의 make_circles()로 서로 다른 색의 점으로 이루어진 원 두 개를 만든다.
from sklearn.datasets import make_circles

n_samples = 1000

X, y = make_circles(n_samples,
                    noise=0.03,       # 점에 약간의 잡음
                    random_state=42)  # 같은 데이터를 다시 얻기 위한 시드

print(f"First 5 X features:\n{X[:5]}")
print(f"\nFirst 5 y labels:\n{y[:5]}")
First 5 X features:
[[ 0.75424625  0.23148074]
 [-0.75615888  0.15325888]
 [-0.81539193  0.17328203]
 [-0.39373073  0.69288277]
 [ 0.44220765 -0.89672343]]

First 5 y labels:
[1 1 1 1 0]
y 값 하나에 X 값이 두 개씩 대응한다. pandas DataFrame으로 정리하고 클래스별 개수를 센다.
import pandas as pd

circles = pd.DataFrame({"X1": X[:, 0],
                        "X2": X[:, 1],
                        "label": y})
print(circles.head(5))
print(circles.label.value_counts())
         X1        X2  label
0  0.754246  0.231481      1
1 -0.756159  0.153259      1
2 -0.815392  0.173282      1
3 -0.393731  0.692883      1
4  0.442208 -0.896723      0
label
1    500
0    500
Name: count, dtype: int64
각 점은 좌표 X1, X2와 0 또는 1의 레이블을 가지므로 이진 분류 문제다. 클래스마다 500개씩으로 균형이 맞다. 그림으로 그려 본다.
import matplotlib.pyplot as plt

plt.scatter(x=X[:, 0],
            y=X[:, 1],
            c=y,
            cmap=plt.cm.RdYlBu)
그림에는 반지름 약 1인 바깥 원(빨강, 레이블 0)과 반지름 약 0.8인 안쪽 원(파랑, 레이블 1)이 겹치지 않게 놓인다. 목표는 점의 좌표로 빨간 점(0)인지 파란 점(1)인지 분류하는 신경망이다. 이런 데이터셋을 토이 문제(toy problem) 라 하는데, 작지만 “숫자로 표현된 데이터를 클래스로 나눈다”는 분류의 핵심을 모두 담고 있다.
입력과 출력의 모양
딥러닝에서 가장 흔한 오류는 모양 오류다. 이를 피하는 확실한 방법은 없지만, 다루는 데이터의 모양에 계속 익숙해지는 것이 최선이다. “입력의 모양은 무엇이고 출력의 모양은 무엇인가?”를 늘 묻는다.
print(X.shape, y.shape)

X_sample = X[0]
y_sample = y[0]
print(f"Values for one sample of X: {X_sample} and the same for y: {y_sample}")
print(f"Shapes for one sample of X: {X_sample.shape} and the same for y: {y_sample.shape}")
(1000, 2) (1000,)
Values for one sample of X: [0.75424625 0.23148074] and the same for y: 1
Shapes for one sample of X: (2,) and the same for y: ()
첫 번째 차원(1000)은 샘플 수로 X와 y가 같다. X의 두 번째 차원 2는 샘플마다 특징이 두 개(벡터)라는 뜻이고, y는 샘플마다 값 하나(스칼라)다. 즉 입력 2개, 출력 1개인 문제다.
텐서로 바꾸고 학습/테스트 세트로 나누기
- 데이터를 텐서로 바꾼다. 지금은 NumPy 배열이고, PyTorch는 텐서를 선호한다.
- 학습 세트와 테스트 세트로 나눈다.
import torch

X = torch.from_numpy(X).type(torch.float)
y = torch.from_numpy(y).type(torch.float)

X[:5], y[:5]
(tensor([[ 0.7542,  0.2315],
         [-0.7562,  0.1533],
         [-0.8154,  0.1733],
         [-0.3937,  0.6929],
         [ 0.4422, -0.8967]]),
 tensor([1., 1., 1., 1., 0.]))
NumPy의 기본 자료형은 float64(레이블은 int64)이므로 type(torch.float)로 PyTorch의 기본인 float32에 맞춘다. 그렇지 않으면 나중에 모델 가중치(float32)와 계산할 때 자료형 오류가 난다. 레이블도 실수형으로 바꾸는 이유는 이진 교차 엔트로피 손실이 실수형 정답을 받기 때문이다.
분할에는 Scikit-Learn의 train_test_split()을 쓴다. 직선 데이터와 달리 이 데이터는 무작위로 섞어서 나눠야 하므로 random_state로 분할을 재현 가능하게 한다.
from sklearn.model_selection import train_test_split

X_train, X_test, y_train, y_test = train_test_split(X,
                                                    y,
                                                    test_size=0.2,    # 20% 테스트, 80% 학습
                                                    random_state=42)  # 분할 재현

len(X_train), len(X_test), len(y_train), len(y_test)
(800, 200, 800, 200)
학습용 800개, 테스트용 200개가 생겼다.
분류 신경망 코드 작성
모델 구축은 다음 순서로 진행한다.
- 장치 독립 코드 설정
nn.Module을 상속해 모델 구성- 손실 함수와 옵티마이저 정의
- 학습 루프 작성
import torch
from torch import nn

device = "cuda" if torch.cuda.is_available() else "cpu"
device
'cuda'
특징 X가 주어졌을 때 레이블 y를 예측하는 모델을 만든다. 데이터가 입력에 대한 정답을 알려 주므로 이것은 지도 학습(supervised learning) 이다. 모델은 X의 모양(특징 2개)을 받아 y의 모양(값 1개)을 내놓아야 한다.
# 1. nn.Module을 상속한 모델 클래스
class CircleModelV0(nn.Module):
    def __init__(self):
        super().__init__()
        # 2. X와 y의 모양을 처리할 수 있는 nn.Linear 층 2개
        self.layer_1 = nn.Linear(in_features=2, out_features=5)  # 특징 2개 -> 5개
        self.layer_2 = nn.Linear(in_features=5, out_features=1)  # 특징 5개 -> 1개 (y와 같은 모양)

    # 3. 순전파 계산
    def forward(self, x):
        # layer_1을 먼저 통과하고, 그 출력이 layer_2를 통과한다
        return self.layer_2(self.layer_1(x))

# 4. 인스턴스를 만들고 대상 장치로
model_0 = CircleModelV0().to(device)
model_0
CircleModelV0(
  (layer_1): Linear(in_features=2, out_features=5, bias=True)
  (layer_2): Linear(in_features=5, out_features=1, bias=True)
)
self.layer_1은 입력 특징 2개(in_features=2)를 받아 출력 특징 5개(out_features=5)를 만든다. 이 5개를 은닉 유닛(hidden unit) 또는 뉴런(neuron) 이라 한다. 특징을 2개에서 5개로 늘리면 모델이 숫자 2개가 아니라 5개에서 패턴을 배울 수 있어 잠재적으로 더 나은 결과를 낼 수 있다. 항상 그렇지는 않다.
은닉 유닛 수는 사람이 정하는 하이퍼파라미터이며 정해진 값은 없다. 많을수록 대체로 좋지만 지나치게 많을 수도 있다. 데이터가 작고 단순하므로 작게 둔다. 지켜야 할 규칙은 하나다. 다음 층의 in_features는 이전 층의 out_features와 같아야 한다. 그래서 layer_2는 in_features=5로 layer_1의 출력 5개를 받아 y와 같은 모양인 1개로 줄인다.
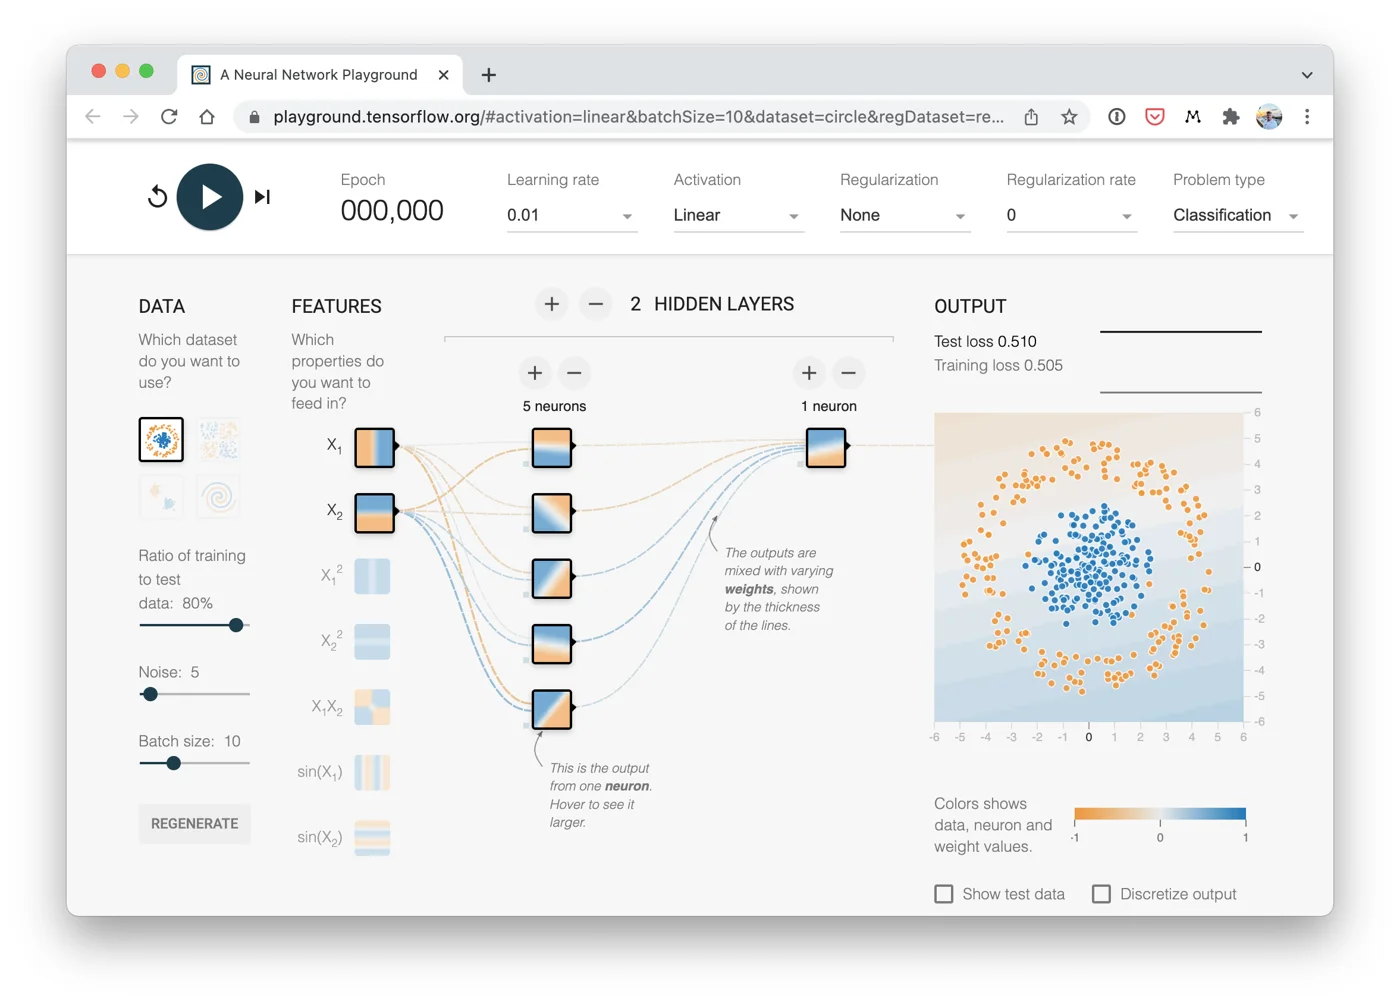 방금 만든 모델과 비슷한 신경망을 TensorFlow Playground에서 구성한 모습. 원형 데이터셋에 입력 특징 \(X_1\), \(X_2\)를 넣고, 뉴런 5개짜리 은닉층과 뉴런 1개짜리 출력층을 쌓았으며 활성화 함수는 Linear다. 선의 굵기는 가중치의 크기를 나타낸다. 출처: learnpytorch.io (Daniel Bourke, MIT License).
그림 오른쪽 출력 패널의 배경색이 모델이 각 영역을 어느 클래스로 보는지를 나타낸다. 학습 전이라 배경은 대각선 방향의 단순한 그라데이션이고, 주황(바깥 원)과 파랑(안쪽 원)을 전혀 구분하지 못한다. 활성화 함수가 Linear라는 점은 뒤에서 중요해진다.
nn.Sequential 사용하기
같은 모델을 nn.Sequential로 더 간단히 만들 수 있다. nn.Sequential은 입력을 층이 나열된 순서대로 통과시킨다.
model_0 = nn.Sequential(
    nn.Linear(in_features=2, out_features=5),
    nn.Linear(in_features=5, out_features=1)
).to(device)

model_0
Sequential(
  (0): Linear(in_features=2, out_features=5, bias=True)
  (1): Linear(in_features=5, out_features=1, bias=True)
)
nn.Sequential은 단순한 순차 계산에 적합하지만, 이름 그대로 항상 순서대로만 실행한다. 분기나 건너뛰기처럼 다른 흐름이 필요하면 nn.Module을 상속한 클래스를 직접 정의한다.
학습 전 모델에 데이터를 넣어 본다.
untrained_preds = model_0(X_test.to(device))
print(f"Length of predictions: {len(untrained_preds)}, Shape: {untrained_preds.shape}")
print(f"Length of test samples: {len(y_test)}, Shape: {y_test.shape}")
print(f"\nFirst 5 predictions:\n{untrained_preds[:5]}")
print(f"\nFirst 5 test labels:\n{y_test[:5]}")
Length of predictions: 200, Shape: torch.Size([200, 1])
Length of test samples: 200, Shape: torch.Size([200])

First 5 predictions:
tensor([[0.0555],
        [0.0169],
        [0.2254],
        [0.0071],
        [0.3345]], device='cuda:0', grad_fn=<SliceBackward0>)

First 5 test labels:
tensor([1., 0., 1., 0., 1.])
예측 개수(200)는 레이블 개수와 같지만, 모양([200, 1] 대 [200])과 형태(임의의 실수 대 0 또는 1)가 다르다. X_test.to(device)는 모델이 GPU에 있으므로 데이터도 같은 장치로 옮기는 것이다. 이 차이를 해결하는 방법은 아래에서 다룬다.
손실 함수, 옵티마이저, 평가 함수
문제 유형마다 알맞은 손실 함수가 다르다. 옵티마이저는 대체로 여러 문제에 공통으로 쓸 수 있다.
| 손실 함수/옵티마이저 | 문제 유형 | PyTorch 코드 |
|---|---|---|
| SGD 옵티마이저 | 분류, 회귀 등 다수 | torch.optim.SGD() |
| Adam 옵티마이저 | 분류, 회귀 등 다수 | torch.optim.Adam() |
| 이진 교차 엔트로피 손실 | 이진 분류 | torch.nn.BCEWithLogitsLoss 또는 torch.nn.BCELoss |
| 교차 엔트로피 손실 | 다중 클래스 분류 | torch.nn.CrossEntropyLoss |
| 평균 절대 오차(MAE), L1 손실 | 회귀 | torch.nn.L1Loss |
| 평균 제곱 오차(MSE), L2 손실 | 회귀 | torch.nn.MSELoss |
PyTorch 문서에서는 손실 함수를 “criterion(기준)”이라 부르기도 한다. 이진 분류에는 이진 교차 엔트로피(binary cross entropy, BCE) 를 쓴다. 정답 \(y_i \in \lbrace 0, 1 \rbrace\), 클래스 1일 예측 확률을 \(p_i\)라 하면 다음과 같다.
\[\mathcal{L} = -\frac{1}{n} \sum_{i=1}^{n} \Big[ y_i \log p_i + (1 - y_i) \log (1 - p_i) \Big]\]정답이 1인데 \(p_i\)가 0에 가까우면, 또는 정답이 0인데 \(p_i\)가 1에 가까우면 로그 항이 매우 커져 큰 벌점을 준다.
PyTorch에는 BCE 구현이 두 개 있다.
torch.nn.BCELoss(): 확률(0~1)을 입력으로 받는다. 모델 출력에 시그모이드를 직접 적용한 뒤 넣어야 한다.torch.nn.BCEWithLogitsLoss(): 위와 같지만 시그모이드 층(nn.Sigmoid)이 내장되어 있어 모델의 원시 출력을 바로 받는다.
문서에 따르면 2번이 nn.Sigmoid 다음에 nn.BCELoss를 쓰는 것보다 수치적으로 더 안정적이다. 그래서 보통 2번을 쓴다. 옵티마이저는 학습률 0.1의 SGD다.
# loss_fn = nn.BCELoss()  # 시그모이드 내장 안 됨
loss_fn = nn.BCEWithLogitsLoss()  # 시그모이드 내장

optimizer = torch.optim.SGD(params=model_0.parameters(),
                            lr=0.1)
평가 지표(evaluation metric) 도 하나 만든다. 손실 함수가 모델이 얼마나 틀렸는지 잰다면, 평가 지표는 얼마나 맞았는지를 다른 관점에서 보여 준다. 분류에서 가장 기본적인 지표는 정확도(accuracy), 즉 전체 예측 중 맞은 예측의 비율이다. 100개 중 99개를 맞히면 99%다.
def accuracy_fn(y_true, y_pred):
    correct = torch.eq(y_true, y_pred).sum().item()  # 두 텐서가 같은 위치의 개수
    acc = (correct / len(y_pred)) * 100
    return acc
torch.eq()는 원소별로 같은지를 True/False 텐서로 돌려주고, sum()은 True의 개수를, item()은 이를 파이썬 숫자로 꺼낸다.
로짓에서 예측 확률, 예측 레이블로
학습 루프를 만들기 전에 순전파의 출력이 무엇인지 살펴본다.
y_logits = model_0(X_test.to(device))[:5]
y_logits
tensor([[0.0555],
        [0.0169],
        [0.2254],
        [0.0071],
        [0.3345]], device='cuda:0', grad_fn=<SliceBackward0>)
학습 전이므로 사실상 무작위 값이다. 이 값은 두 개의 nn.Linear 층, 즉 다음 식의 결과다.
이 식의 원시(가공하지 않은) 출력을 로짓(logit) 이라 한다. 로짓은 해석하기 어렵고 정답 레이블(0 또는 1)과 비교할 수 없다. 로짓을 비교 가능한 형태로 바꾸는 것이 시그모이드(sigmoid) 활성화 함수다.
\[\sigma(z) = \frac{1}{1 + e^{-z}}\]시그모이드는 어떤 실수든 0과 1 사이로 눌러 준다.
y_pred_probs = torch.sigmoid(y_logits)
y_pred_probs
tensor([[0.5139],
        [0.5042],
        [0.5561],
        [0.5018],
        [0.5829]], device='cuda:0', grad_fn=<SigmoidBackward0>)
이제 값이 예측 확률이 되었다. 모델이 각 샘플을 클래스 1이라고 얼마나 믿는지를 나타낸다. 0.5를 기준으로 나눈다.
y_pred_probs≥ 0.5이면 클래스 1y_pred_probs< 0.5이면 클래스 0
반올림(torch.round)하면 정확히 이 규칙이 된다.
# 예측 확률 -> 예측 레이블
y_preds = torch.round(y_pred_probs)

# 한 줄로: 로짓 -> 예측 확률 -> 예측 레이블
y_pred_labels = torch.round(torch.sigmoid(model_0(X_test.to(device))[:5]))

print(torch.eq(y_preds.squeeze(), y_pred_labels.squeeze()))
print(y_preds.squeeze())  # 여분의 차원 제거
print(y_test[:5])
tensor([True, True, True, True, True], device='cuda:0')
tensor([1., 1., 1., 1., 1.], device='cuda:0', grad_fn=<SqueezeBackward0>)
tensor([1., 0., 1., 0., 1.])
squeeze()로 [5, 1]을 [5]로 줄이면 예측이 정답 레이블과 같은 형태가 된다. 정리하면 로짓 → (시그모이드) → 예측 확률 → (반올림) → 예측 레이블이다.
시그모이드는 이진 분류의 로짓에 쓴다. 다중 클래스 분류에서는 소프트맥스를 쓴다(다음 글). 또 nn.BCEWithLogitsLoss는 시그모이드를 내장하고 있으므로, 손실을 계산할 때는 시그모이드를 거치지 않은 로짓을 그대로 넣는다(이름의 “logits”가 그 뜻이다).
학습 루프와 테스트 루프
학습 루프의 다섯 단계는 회귀와 같다.
- 순전파: 모델이 학습 데이터 전체에 대해
forward()를 수행한다. - 손실 계산: 예측을 정답과 비교한다.
- 기울기 초기화:
optimizer.zero_grad() - 역전파:
loss.backward() - 옵티마이저 스텝(경사하강법):
optimizer.step()
분류에서 달라지는 점은 순전파 출력이 로짓이라는 것이다. 손실에는 로짓을 넣고, 정확도에는 로짓을 레이블로 바꿔 넣는다. 100 에폭 학습하고 10 에폭마다 출력한다.
torch.manual_seed(42)

epochs = 100

# 데이터를 대상 장치로
X_train, y_train = X_train.to(device), y_train.to(device)
X_test, y_test = X_test.to(device), y_test.to(device)

for epoch in range(epochs):
    ### 학습
    model_0.train()

    # 1. 순전파 (모델은 로짓을 출력)
    y_logits = model_0(X_train).squeeze()          # [800, 1] -> [800]
    y_pred = torch.round(torch.sigmoid(y_logits))  # 로짓 -> 확률 -> 레이블

    # 2. 손실과 정확도
    loss = loss_fn(y_logits,  # BCEWithLogitsLoss는 로짓을 그대로 받는다
                   y_train)
    acc = accuracy_fn(y_true=y_train, y_pred=y_pred)

    # 3. 기울기 초기화
    optimizer.zero_grad()

    # 4. 역전파
    loss.backward()

    # 5. 옵티마이저 스텝
    optimizer.step()

    ### 테스트
    model_0.eval()
    with torch.inference_mode():
        test_logits = model_0(X_test).squeeze()
        test_pred = torch.round(torch.sigmoid(test_logits))
        test_loss = loss_fn(test_logits, y_test)
        test_acc = accuracy_fn(y_true=y_test, y_pred=test_pred)

    if epoch % 10 == 0:
        print(f"Epoch: {epoch} | Loss: {loss:.5f}, Accuracy: {acc:.2f}% | Test loss: {test_loss:.5f}, Test acc: {test_acc:.2f}%")
Epoch: 0 | Loss: 0.70034, Accuracy: 50.00% | Test loss: 0.69484, Test acc: 52.50%
Epoch: 10 | Loss: 0.69718, Accuracy: 53.75% | Test loss: 0.69242, Test acc: 54.50%
Epoch: 20 | Loss: 0.69590, Accuracy: 51.12% | Test loss: 0.69161, Test acc: 53.50%
Epoch: 30 | Loss: 0.69530, Accuracy: 50.62% | Test loss: 0.69136, Test acc: 53.00%
Epoch: 40 | Loss: 0.69497, Accuracy: 49.75% | Test loss: 0.69131, Test acc: 53.50%
Epoch: 50 | Loss: 0.69474, Accuracy: 50.12% | Test loss: 0.69134, Test acc: 53.50%
Epoch: 60 | Loss: 0.69457, Accuracy: 49.88% | Test loss: 0.69139, Test acc: 53.50%
Epoch: 70 | Loss: 0.69442, Accuracy: 49.62% | Test loss: 0.69146, Test acc: 54.00%
Epoch: 80 | Loss: 0.69430, Accuracy: 49.62% | Test loss: 0.69153, Test acc: 54.50%
Epoch: 90 | Loss: 0.69418, Accuracy: 49.62% | Test loss: 0.69161, Test acc: 54.50%
.squeeze()는 모델 출력[800, 1]을 레이블과 같은[800]으로 맞춘다. 모양이 다르면 손실 계산에서 경고나 오류가 난다. 모델과 데이터가 같은 장치에 있어야 순전파가 동작한다.nn.BCELoss를 쓴다면loss_fn(torch.sigmoid(y_logits), y_train)처럼 시그모이드를 먼저 적용해야 한다.- f-string의
:.5f는 소수점 아래 다섯 자리까지 출력하라는 형식 지정이다.
학습과 테스트 단계는 문제없이 돌았지만 결과가 거의 움직이지 않는다. 정확도가 50% 근처에 머문다. 클래스가 500개씩 균형 잡힌 이진 분류에서 50%는 무작위 추측과 같은 수준이다. 늘 클래스 1만 예측해도 50%가 나온다. 손실도 0.693 근처인데, 이는 모든 샘플에 확률 0.5를 줄 때의 BCE 값 \(-\log 0.5 \approx 0.693\)과 같다.
예측하고 평가하기
지표만 보면 모델은 무작위로 추측하고 있다. 원인을 찾기 위해 데이터 탐험가의 좌우명 “시각화, 시각화, 시각화”를 따른다. 강의 저장소의 helper_functions.py를 내려받아 plot_decision_boundary()를 쓴다. 이 함수는 NumPy 격자(meshgrid) 위의 모든 점에 대해 모델의 예측 클래스를 계산해 색으로 칠한다.
import requests
from pathlib import Path

# helper_functions.py 내려받기 (이미 있으면 건너뜀)
if Path("helper_functions.py").is_file():
    print("helper_functions.py already exists, skipping download")
else:
    print("Downloading helper_functions.py")
    request = requests.get("https://raw.githubusercontent.com/mrdbourke/pytorch-deep-learning/main/helper_functions.py")
    with open("helper_functions.py", "wb") as f:
        f.write(request.content)

from helper_functions import plot_predictions, plot_decision_boundary
plt.figure(figsize=(12, 6))
plt.subplot(1, 2, 1)
plt.title("Train")
plot_decision_boundary(model_0, X_train, y_train)
plt.subplot(1, 2, 2)
plt.title("Test")
plot_decision_boundary(model_0, X_test, y_test)
학습 세트와 테스트 세트 모두에서 결정 경계(decision boundary)가 원 한가운데를 가로지르는 직선이다. 빨간 점과 파란 점이 원형으로 배치되어 있으니 직선으로는 기껏해야 원을 반으로 가를 수밖에 없고, 그래서 정확도가 50%다. 머신러닝 용어로 모델이 과소적합(underfitting), 즉 데이터에서 예측에 쓸 만한 패턴을 학습하지 못하고 있다.
모델을 개선하는 방법
데이터가 아니라 모델 쪽에서 과소적합을 고치는 방법은 여러 가지다.
| 개선 기법 | 효과 |
|---|---|
| 층 추가 | 층마다 새로운 패턴을 배울 수 있어 학습 능력이 잠재적으로 커진다. 신경망을 더 깊게(deeper) 만든다고 한다. |
| 은닉 유닛 추가 | 층당 은닉 유닛이 많아지면 역시 학습 능력이 잠재적으로 커진다. 신경망을 더 넓게(wider) 만든다고 한다. |
| 더 오래 학습(에폭 증가) | 데이터를 볼 기회가 많아지면 더 배울 수 있다. |
| 활성화 함수 변경 | 직선만으로는 맞출 수 없는 데이터가 있다. 비선형 활성화 함수가 도움이 된다. |
| 학습률 변경 | 옵티마이저가 한 스텝에 매개변수를 얼마나 바꿀지 정한다. 너무 크면 과하게 고치고, 너무 작으면 충분히 배우지 못한다. |
| 손실 함수 변경 | 문제마다 맞는 손실 함수가 다르다. 예를 들어 이진 교차 엔트로피는 다중 클래스 분류에 맞지 않는다. |
| 전이 학습 사용 | 비슷한 문제에서 사전 학습된 모델을 가져와 내 문제에 맞게 조정한다. |
이 값들은 모두 사람이 직접 조정하므로 하이퍼파라미터다. 어떤 조합이 최선인지 미리 알 방법은 없으므로 “실험, 실험, 실험”이 답이다. 머신러닝이 반은 과학, 반은 기술(art)이라고 하는 이유다.
먼저 층을 하나 추가하고(2개 → 3개), 은닉 유닛을 5개에서 10개로 늘리고, 에폭을 100에서 1000으로 늘려 본다.
class CircleModelV1(nn.Module):
    def __init__(self):
        super().__init__()
        self.layer_1 = nn.Linear(in_features=2, out_features=10)
        self.layer_2 = nn.Linear(in_features=10, out_features=10)  # 추가된 층
        self.layer_3 = nn.Linear(in_features=10, out_features=1)

    def forward(self, x):  # forward 철자를 꼭 확인한다
        # 아래와 같은 계산이지만, 한 줄로 쓰면 가능한 경우 속도 이점이 있다
        # z = self.layer_1(x)
        # z = self.layer_2(z)
        # z = self.layer_3(z)
        # return z
        return self.layer_3(self.layer_2(self.layer_1(x)))

model_1 = CircleModelV1().to(device)
model_1
CircleModelV1(
  (layer_1): Linear(in_features=2, out_features=10, bias=True)
  (layer_2): Linear(in_features=10, out_features=10, bias=True)
  (layer_3): Linear(in_features=10, out_features=1, bias=True)
)
손실 함수와 옵티마이저는 같은 설정으로 다시 만든다. 옵티마이저에는 새 모델의 매개변수를 넘겨야 한다.
loss_fn = nn.BCEWithLogitsLoss()  # 입력에 시그모이드 필요 없음
optimizer = torch.optim.SGD(model_1.parameters(), lr=0.1)
torch.manual_seed(42)

epochs = 1000  # 더 오래 학습

X_train, y_train = X_train.to(device), y_train.to(device)
X_test, y_test = X_test.to(device), y_test.to(device)

for epoch in range(epochs):
    ### 학습
    model_1.train()

    # 1. 순전파
    y_logits = model_1(X_train).squeeze()
    y_pred = torch.round(torch.sigmoid(y_logits))  # 로짓 -> 예측 확률 -> 예측 레이블

    # 2. 손실과 정확도
    loss = loss_fn(y_logits, y_train)
    acc = accuracy_fn(y_true=y_train, y_pred=y_pred)

    # 3. 기울기 초기화
    optimizer.zero_grad()

    # 4. 역전파
    loss.backward()

    # 5. 옵티마이저 스텝
    optimizer.step()

    ### 테스트
    model_1.eval()
    with torch.inference_mode():
        test_logits = model_1(X_test).squeeze()
        test_pred = torch.round(torch.sigmoid(test_logits))
        test_loss = loss_fn(test_logits, y_test)
        test_acc = accuracy_fn(y_true=y_test, y_pred=test_pred)

    if epoch % 100 == 0:
        print(f"Epoch: {epoch} | Loss: {loss:.5f}, Accuracy: {acc:.2f}% | Test loss: {test_loss:.5f}, Test acc: {test_acc:.2f}%")
Epoch: 0 | Loss: 0.69396, Accuracy: 50.88% | Test loss: 0.69261, Test acc: 51.00%
Epoch: 100 | Loss: 0.69305, Accuracy: 50.38% | Test loss: 0.69379, Test acc: 48.00%
Epoch: 200 | Loss: 0.69299, Accuracy: 51.12% | Test loss: 0.69437, Test acc: 46.00%
Epoch: 300 | Loss: 0.69298, Accuracy: 51.62% | Test loss: 0.69458, Test acc: 45.00%
Epoch: 400 | Loss: 0.69298, Accuracy: 51.12% | Test loss: 0.69465, Test acc: 46.00%
Epoch: 500 | Loss: 0.69298, Accuracy: 51.00% | Test loss: 0.69467, Test acc: 46.00%
Epoch: 600 | Loss: 0.69298, Accuracy: 51.00% | Test loss: 0.69468, Test acc: 46.00%
Epoch: 700 | Loss: 0.69298, Accuracy: 51.00% | Test loss: 0.69468, Test acc: 46.00%
Epoch: 800 | Loss: 0.69298, Accuracy: 51.00% | Test loss: 0.69468, Test acc: 46.00%
Epoch: 900 | Loss: 0.69298, Accuracy: 51.00% | Test loss: 0.69468, Test acc: 46.00%
노트북 원본의 이 루프에는 model_1.train() 호출이 빠져 있는데, 위 코드에서는 습관대로 넣었다. 이 모델에는 학습과 평가에서 다르게 동작하는 층이 없으므로 결과는 같다.
층을 하나 더 쌓고 열 배 오래 학습했는데도 정확도는 여전히 무작위 추측 수준이다. 결정 경계를 다시 그려 보면 이유가 보인다.
plt.figure(figsize=(12, 6))
plt.subplot(1, 2, 1)
plt.title("Train")
plot_decision_boundary(model_1, X_train, y_train)
plt.subplot(1, 2, 2)
plt.title("Test")
plot_decision_boundary(model_1, X_test, y_test)
결정 경계는 여전히 직선이다. 이유는 모델의 구조에 있다. nn.Linear 층은 모두 \(xW^T + b\) 꼴의 선형 변환이고, 선형 변환을 몇 번 합성해도 결과는 하나의 선형 변환이다.
층을 아무리 쌓고 넓혀도 이 모델은 직선(평면) 경계만 그릴 수 있다. 원형 데이터를 가르려면 곡선이 필요하다. 그렇다면 이 모델이 적어도 직선 데이터는 맞출 수 있는지 확인해 보고, 무엇이 빠졌는지, 즉 비선형성(non-linearity) 을 추가하는 일은 다음 글에서 다룬다.
정리
- 분류는 이진 분류, 다중 클래스 분류, 다중 레이블 분류로 나뉜다. 분류 모델의 입력은 숫자 텐서, 출력은 클래스별 예측 확률이다.
- 이진 분류 신경망은 출력층 1개, 출력 활성화 시그모이드, 손실 이진 교차 엔트로피를 쓰고, 다중 클래스 분류는 클래스 수만큼의 출력, 소프트맥스, 교차 엔트로피를 쓴다.
make_circles로 만든 1000개 점(특징 2개, 레이블 0/1)을float32텐서로 바꾸고train_test_split으로 800:200으로 나눴다.- 모델은
nn.Module상속이나nn.Sequential로 만들며, 다음 층의in_features는 이전 층의out_features와 같아야 한다. - 모델의 원시 출력은 로짓이며, 시그모이드로 예측 확률을, 반올림으로 예측 레이블을 얻는다.
nn.BCEWithLogitsLoss는 시그모이드가 내장되어 로짓을 그대로 받고 수치적으로 더 안정적이다. - 손실 외에 정확도 같은 평가 지표로 모델이 얼마나 맞히는지 함께 본다.
- 선형 층만 쌓은 모델은 정확도 50% 근처에서 멈추고 결정 경계가 직선이었다. 층, 은닉 유닛, 에폭을 늘려도 선형 변환의 합성은 선형이므로 원형 데이터를 가를 수 없다.
- 모델 개선 수단(층, 은닉 유닛, 에폭, 활성화 함수, 학습률, 손실 함수, 전이 학습)은 모두 하이퍼파라미터이며 실험으로 찾는다.