- PyTorch for Deep Learning (Daniel Bourke, freeCodeCamp) Chapter 1 정리
- 교재: learnpytorch.io
- 코드: MIT License
이 글은 노트북 01_pytorch_workflow의 앞부분, 데이터를 준비하고 첫 모델을 만들어 (학습 전) 예측해 보는 데까지를 정리한다.
PyTorch 워크플로
머신러닝과 딥러닝의 본질은 과거의 데이터에서 신경망 같은 알고리즘으로 패턴을 찾고, 그 패턴으로 미래를 예측하는 것이다. 이 장에서는 가장 단순한 예, 직선을 대상으로 PyTorch 모델이 직선의 패턴을 학습하게 한다. 문제는 단순하지만, 그 과정은 이후 모든 장에서 반복되는 표준 워크플로를 그대로 따른다.
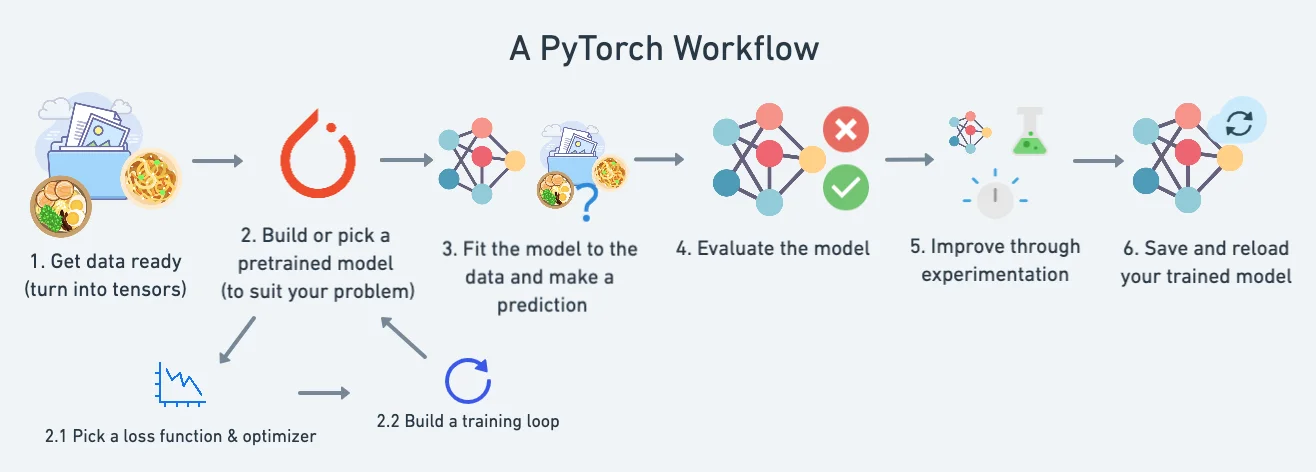 PyTorch 워크플로. 1) 데이터를 준비해 텐서로 바꾸고, 2) 문제에 맞는 모델을 만들거나 사전 학습 모델을 고르며(2.1 손실 함수와 옵티마이저 선택, 2.2 학습 루프 작성), 3) 모델을 데이터에 맞추고 예측하고, 4) 모델을 평가하고, 5) 실험을 통해 개선하고, 6) 학습된 모델을 저장하고 다시 불러온다. 출처: learnpytorch.io (Daniel Bourke, MIT License).
그림의 2번 아래쪽 화살표는 모델을 고른 뒤 손실 함수와 옵티마이저를 정하고(2.1) 학습 루프를 만든 다음(2.2) 다시 모델로 돌아오는 작은 순환을 나타낸다. 실제 프로젝트에서는 4번 평가와 5번 개선 사이를 여러 번 오간다. 이 장에서 다루는 내용은 다음과 같다.
| 주제 | 내용 |
|---|---|
| 1. 데이터 준비 | 간단한 직선 데이터를 만든다. |
| 2. 모델 구축 | 데이터의 패턴을 학습할 모델을 만들고, 손실 함수, 옵티마이저, 학습 루프를 정한다. |
| 3. 모델 학습 | 모델이 학습 데이터에서 패턴을 찾게 한다. |
| 4. 예측과 평가(추론) | 모델이 찾은 패턴을 테스트 데이터와 비교한다. |
| 5. 저장과 불러오기 | 모델을 다른 곳에서 쓰거나 나중에 다시 불러온다. |
| 6. 종합 | 위 과정을 모두 합친다. |
이 글은 1, 2번과 학습 전 예측까지, 다음 글은 3번부터 6번까지를 다룬다.
준비
torch, torch.nn, matplotlib을 불러온다. nn은 신경망(neural network)의 약자로, PyTorch에서 신경망을 만드는 모든 구성 요소가 들어 있다.
import torch
from torch import nn  # 신경망의 구성 요소
import matplotlib.pyplot as plt

torch.__version__
'1.12.1+cu113'
선형 회귀로 데이터 만들기
머신러닝에서 “데이터”는 숫자 표, 이미지, 영상, 음성, 단백질 구조, 텍스트 등 거의 무엇이든 될 수 있다.
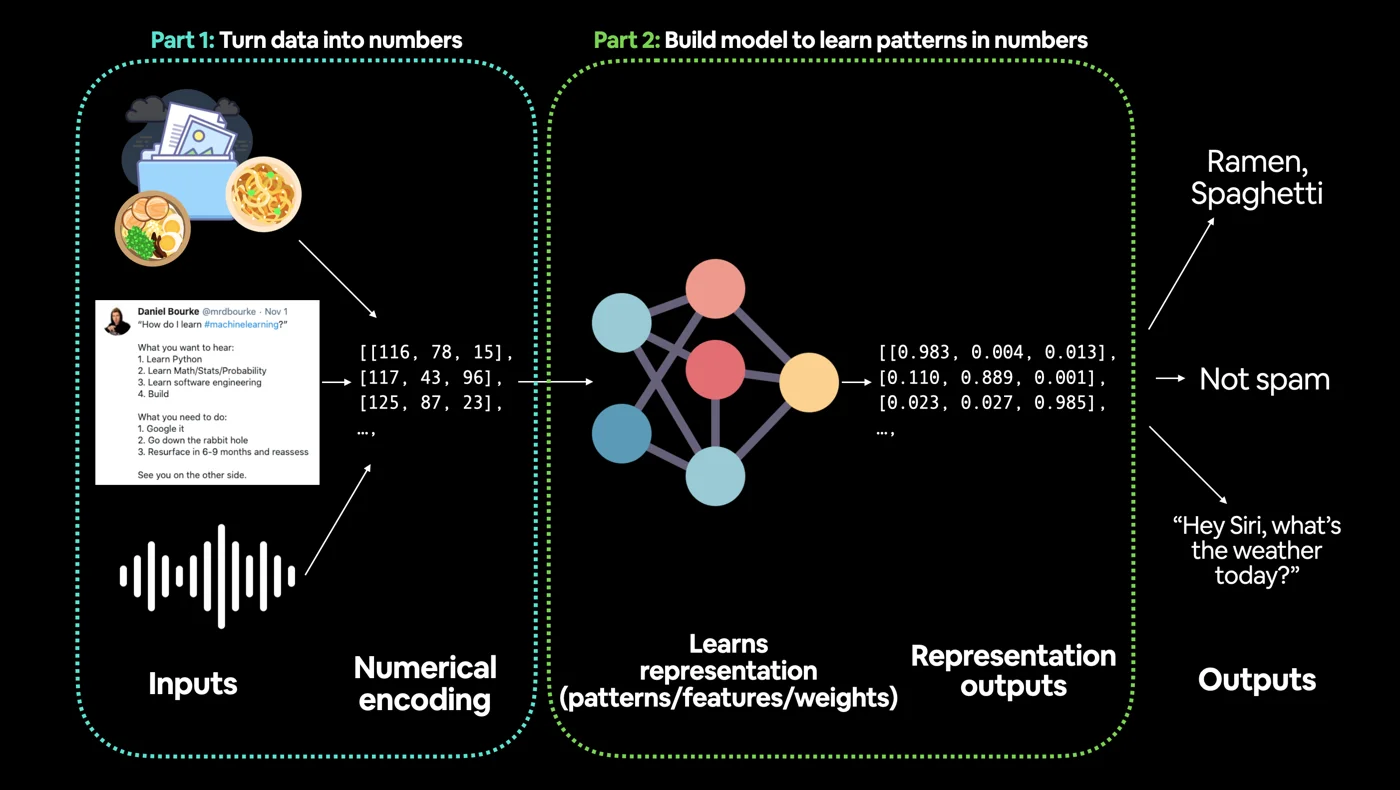 머신러닝은 두 부분으로 이루어진 게임이다. 1부: 이미지, 텍스트, 음성 같은 입력을 숫자로 바꾼다(수치 인코딩). 2부: 모델을 만들어 그 숫자 속 패턴(특징, 가중치)을 학습하고, 표현 출력을 다시 “라멘, 스파게티”, “스팸 아님” 같은 사람이 이해할 수 있는 출력으로 바꾼다. 출처: learnpytorch.io (Daniel Bourke, MIT License).
즉 머신러닝은 다음 두 단계다.
- 데이터를 숫자(표현)로 바꾼다.
- 그 표현을 최대한 잘 학습하는 모델을 고르거나 만든다.
지금은 데이터가 없으므로 직접 만든다. 선형 회귀(linear regression) 공식 \(y = wX + b\)로, 이미 알고 있는 매개변수(parameter) 값을 써서 직선 데이터를 만든다. 그다음 PyTorch 모델이 경사하강법(gradient descent) 으로 이 매개변수를 추정할 수 있는지 확인하는 것이 이 장의 목표다.
# 이미 알고 있는 매개변수
weight = 0.7
bias = 0.3

# 데이터 생성
start = 0
end = 1
step = 0.02
X = torch.arange(start, end, step).unsqueeze(dim=1)
y = weight * X + bias

print(X[:5], y[:5])
print(X.shape, y.shape)
tensor([[0.0000],
        [0.0200],
        [0.0400],
        [0.0600],
        [0.0800]]) tensor([[0.3000],
        [0.3140],
        [0.3280],
        [0.3420],
        [0.3560]])
torch.Size([50, 1]) torch.Size([50, 1])
torch.arange(0, 1, 0.02)는 0부터 0.98까지 50개의 값을 만든다(end인 1은 포함하지 않는다).unsqueeze(dim=1)은 모양을[50]에서[50, 1]로 바꾼다. 샘플 50개가 각각 특징 1개를 갖는다는 뜻이다. 나중에nn.Linear같은 층에 넣을 때 이 모양이 필요하다.y = weight * X + bias는 원소별 연산이므로y도[50, 1]이다.
이제 X(특징, features)와 y(레이블, labels)의 관계를 학습하는 모델을 만드는 것이 목표다.
학습 세트와 테스트 세트 나누기
머신러닝 프로젝트에서 가장 중요한 단계 중 하나는 데이터를 학습 세트와 테스트 세트(필요하면 검증 세트까지)로 나누는 것이다.
| 분할 | 목적 | 전체 데이터 중 비율 | 사용 빈도 |
|---|---|---|---|
| 학습 세트(training set) | 모델이 이 데이터로 학습한다(학기 중 공부하는 강의 자료). | 약 60~80% | 항상 |
| 검증 세트(validation set) | 이 데이터로 모델을 조정한다(기말고사 전 모의고사). | 약 10~20% | 자주, 그러나 항상은 아님 |
| 테스트 세트(test set) | 모델이 배운 것을 평가한다(학기 말 기말고사). | 약 10~20% | 항상 |
목표는 일반화(generalization), 즉 모델이 처음 보는 데이터에서도 잘 작동하는 능력이다. 시험 문제를 미리 보고 공부하면 시험 점수가 실력을 말해 주지 못하듯, 테스트 세트는 학습에 절대 쓰지 않아야 한다. 실제 데이터에서는 프로젝트를 시작하자마자 테스트 세트를 따로 떼어 둔다.
여기서는 학습 세트와 테스트 세트만 쓴다. 데이터가 이미 순서대로 정렬된 직선이므로 앞의 80%를 학습용, 뒤의 20%를 테스트용으로 자른다.
train_split = int(0.8 * len(X))  # 80%는 학습, 20%는 테스트
X_train, y_train = X[:train_split], y[:train_split]
X_test, y_test = X[train_split:], y[train_split:]

len(X_train), len(y_train), len(X_test), len(y_test)
(40, 40, 10, 10)
학습용 40개, 테스트용 10개가 생겼다. 모델은 X_train과 y_train의 관계를 학습하고, X_test와 y_test로 평가받는다.
숫자만 봐서는 감이 오지 않으므로 그림으로 그리는 함수를 만든다. 데이터 탐험가의 좌우명은 “시각화, 시각화, 시각화(visualize, visualize, visualize)”다.
def plot_predictions(train_data=X_train,
                     train_labels=y_train,
                     test_data=X_test,
                     test_labels=y_test,
                     predictions=None):
    """학습 데이터, 테스트 데이터, (있다면) 예측을 함께 그린다."""
    plt.figure(figsize=(10, 7))

    # 학습 데이터는 파란색
    plt.scatter(train_data, train_labels, c="b", s=4, label="Training data")

    # 테스트 데이터는 초록색
    plt.scatter(test_data, test_labels, c="g", s=4, label="Testing data")

    if predictions is not None:
        # 예측(테스트 데이터에 대해 만든 것)은 빨간색
        plt.scatter(test_data, predictions, c="r", s=4, label="Predictions")

    plt.legend(prop={"size": 14})

plot_predictions()
그림에는 \(x = 0\)부터 \(0.78\)까지 파란 점 40개, \(0.8\)부터 \(0.98\)까지 초록 점 10개가 기울기 0.7, 절편 0.3인 하나의 직선 위에 놓인다. 목표는 파란 점으로 학습해 초록 점을 예측하는 모델이다.
첫 PyTorch 모델 만들기
순수 PyTorch로 표준 선형 회귀 모델을 만든다. 코드부터 보고 하나씩 설명한다.
class LinearRegressionModel(nn.Module):  # PyTorch의 거의 모든 것은 nn.Module이다
    def __init__(self):
        super().__init__()
        self.weights = nn.Parameter(torch.randn(1,                  # 무작위 가중치에서 시작
                                                dtype=torch.float), # 기본 자료형 float32
                                    requires_grad=True)            # 경사하강법으로 갱신 가능
        self.bias = nn.Parameter(torch.randn(1,
                                             dtype=torch.float),
                                 requires_grad=True)

    # forward()는 모델이 수행할 계산을 정의한다
    def forward(self, x: torch.Tensor) -> torch.Tensor:  # x는 입력 데이터
        return self.weights * x + self.bias              # 선형 회귀 공식
nn.Module을 상속(subclass) 한다.nn.Module은 모든 신경망 모듈의 기반 클래스이며, 신경망 레고 블록이라고 생각하면 된다.super().__init__()으로 부모 클래스를 먼저 초기화해야 매개변수 등록 같은 기능이 동작한다.nn.Parameter로 감싼 텐서는 모델의 학습 가능한 매개변수로 등록된다.torch.randn(1)은 표준정규분포에서 값 하나를 뽑으므로 가중치와 편향은 무작위로 시작한다.requires_grad=True는 이 매개변수에 대해 PyTorch가 기울기(gradient) 를 자동으로 추적하라는 뜻이다(torch.autograd). 이 기울기로 경사하강법이 값을 갱신한다.forward()는 입력 데이터가 모델을 통과할 때의 계산(순전파, forward pass)을 정의한다.nn.Module을 상속하면 반드시 구현해야 한다. 여기서는 \(y = wx + b\)다.
모델의 목표는 무작위 weights와 bias에서 시작해 데이터를 보면서, 데이터를 만든 실제 값(0.7과 0.3)에 가깝게 조정하는 것이다. 이를 가능하게 하는 두 알고리즘이 경사하강법과 역전파(backpropagation) 다. requires_grad=True 덕분에 PyTorch가 역전파에 필요한 기울기를 자동으로 계산한다.
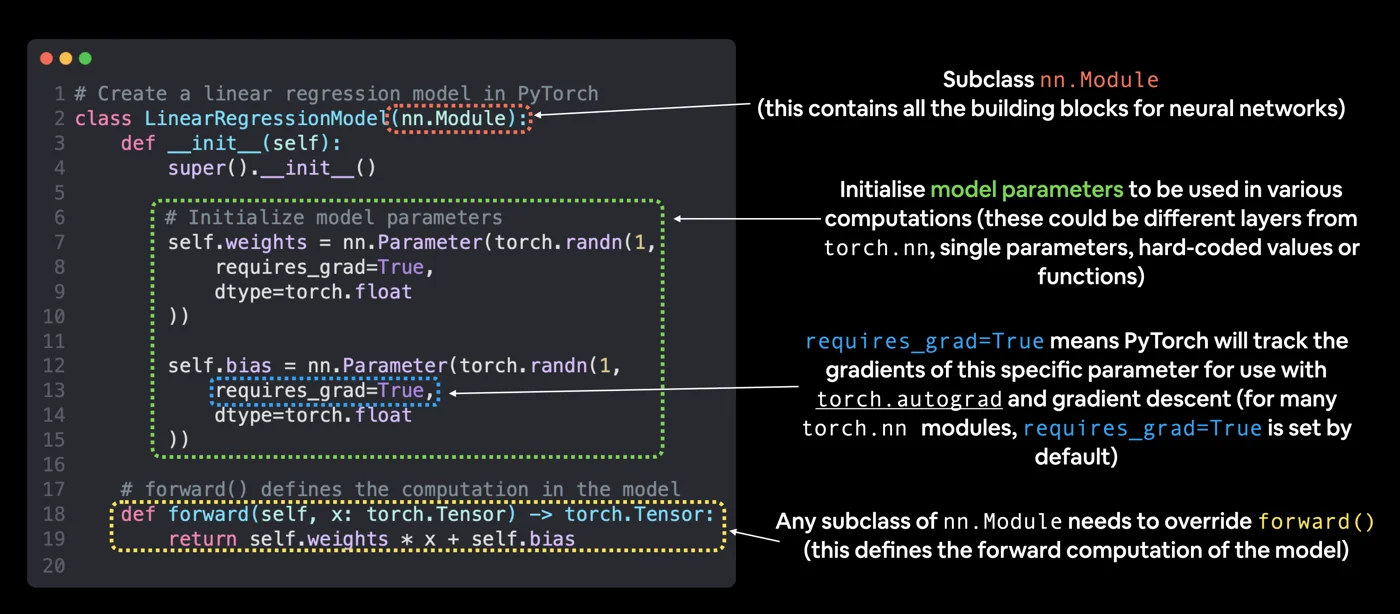
nn.Module을 상속해 PyTorch 모델을 만드는 기본 구성 요소. 빨간 박스는 nn.Module 상속, 초록 박스는 계산에 쓸 모델 매개변수 초기화(층, 단일 매개변수, 고정값, 함수 등 무엇이든 가능), 파란 박스의 requires_grad=True는 PyTorch가 이 매개변수의 기울기를 추적해 torch.autograd와 경사하강법에 쓰게 한다는 뜻(많은 torch.nn 모듈은 기본값이 True), 노란 박스는 반드시 재정의해야 하는 forward() 메서드다. 출처: learnpytorch.io (Daniel Bourke, MIT License).
파이썬 클래스 문법이 익숙하지 않다면 Real Python의 Object-Oriented Programming in Python 3을 먼저 읽어 두면 좋다.
모델 구축의 핵심 클래스
PyTorch에는 거의 모든 신경망을 만들 수 있는 네 가지 핵심 모듈이 있다. torch.nn, torch.optim, torch.utils.data.Dataset, torch.utils.data.DataLoader이다. 지금은 앞의 두 개에 집중하고, 뒤의 두 개는 컴퓨터 비전 장에서 다룬다.
| PyTorch 모듈 | 역할 |
|---|---|
torch.nn |
계산 그래프(정해진 방식으로 실행되는 일련의 계산)를 만드는 모든 구성 요소를 담고 있다. |
torch.nn.Parameter |
nn.Module과 함께 쓰는 텐서를 저장한다. requires_grad=True면 경사하강법에 쓰이는 기울기를 자동으로 계산한다(autograd). |
torch.nn.Module |
모든 신경망 모듈의 기반 클래스. PyTorch로 신경망을 만들면 이 클래스를 상속해야 하며, forward()를 구현해야 한다. |
torch.optim |
다양한 최적화 알고리즘. nn.Parameter에 저장된 매개변수를 어떻게 바꿔야 손실이 줄어드는지 알려 준다. |
def forward() |
모든 nn.Module 하위 클래스가 구현해야 하는 메서드로, 입력 데이터에 수행할 계산을 정의한다. |
한 문장으로 정리하면 다음과 같다.
nn.Module은 큰 구성 요소(층)를 담는다.nn.Parameter는 가중치와 편향 같은 작은 매개변수를 담는다(이것들이 모여nn.Module이 된다).forward()는 큰 구성 요소가 입력에 어떤 계산을 할지 정한다.torch.optim은nn.Parameter안의 값을 데이터를 더 잘 표현하도록 개선하는 방법을 담는다.
더 많은 모듈과 용례는 PyTorch Cheat Sheet에 정리되어 있다.
모델 내부 확인하기
모델 인스턴스를 만들고 .parameters()로 매개변수를 확인한다. nn.Parameter는 무작위로 초기화되므로 결과를 재현하려면 시드를 고정한다.
torch.manual_seed(42)

model_0 = LinearRegressionModel()
list(model_0.parameters())
[Parameter containing:
 tensor([0.3367], requires_grad=True),
 Parameter containing:
 tensor([0.1288], requires_grad=True)]
.state_dict()는 모델이 담고 있는 상태를 이름과 함께 돌려준다.
model_0.state_dict()
OrderedDict([('weights', tensor([0.3367])), ('bias', tensor([0.1288]))])
weights는 0.3367, bias는 0.1288로, torch.randn()이 만든 무작위 값이다. 목표값(0.7, 0.3)과는 거리가 멀다. 시드 값을 바꾸면 이 초기값도 바뀐다.
모델로 예측하기
무작위 매개변수로 시작한 모델의 예측력을 확인해 보자. 데이터를 모델에 넣으면 forward()가 실행되어 결과를 낸다. 이때 torch.inference_mode()를 컨텍스트 매니저(context manager) 로 쓴다.
with torch.inference_mode():
    y_preds = model_0(X_test)

# 예전 코드에서는 torch.no_grad()를 쓰기도 한다
# with torch.no_grad():
#     y_preds = model_0(X_test)

print(f"Number of testing samples: {len(X_test)}")
print(f"Number of predictions made: {len(y_preds)}")
print(f"Predicted values:\n{y_preds}")
Number of testing samples: 10
Number of predictions made: 10
Predicted values:
tensor([[0.3982],
        [0.4049],
        [0.4116],
        [0.4184],
        [0.4251],
        [0.4318],
        [0.4386],
        [0.4453],
        [0.4520],
        [0.4588]])
torch.inference_mode()는 이름 그대로 추론(inference), 즉 예측할 때 쓴다. 학습에는 필요하지만 추론에는 필요 없는 기능, 대표적으로 기울기 추적을 꺼서 순전파를 빠르게 한다. 블록 안에서 만든 y_preds에는 grad_fn이 붙지 않는다. torch.no_grad()도 비슷한 일을 하지만, inference_mode()가 더 새롭고 잠재적으로 더 빠르므로 권장된다.
model_0(X_test)처럼 모델을 함수처럼 호출하면 내부적으로 forward()가 실행된다. forward()를 직접 부르지 않고 이렇게 호출하는 것이 관례다(PyTorch가 호출 전후에 필요한 처리를 함께 해 준다). 테스트 샘플 하나당 예측값이 하나씩 나왔는데, 직선 데이터는 X 하나가 y 하나에 대응하기 때문이다. 일반적으로는 입력 100개가 출력 여러 개에 대응하는 등 문제에 따라 달라진다.
plot_predictions(predictions=y_preds)

y_test - y_preds
tensor([[0.4618],
        [0.4691],
        [0.4764],
        [0.4836],
        [0.4909],
        [0.4982],
        [0.5054],
        [0.5127],
        [0.5200],
        [0.5272]])
그림에서 빨간 예측 점들은 약 0.40~0.46 근처에 낮게 깔려 있어, 0.86~0.99 사이의 초록 점들과 크게 떨어져 있다. 차이(y_test - y_preds)도 0.46~0.53으로 크다. 무작위 매개변수로 예측했으니 당연하다. 모델은 아직 파란 점(학습 데이터)을 한 번도 보지 않았다. 매개변수를 데이터에 맞게 조정하는 학습 과정은 다음 글에서 다룬다.
정리
- PyTorch 워크플로는 데이터 준비 → 모델 구축(손실 함수, 옵티마이저, 학습 루프) → 학습 → 평가 → 개선 → 저장과 불러오기의 순서를 따른다.
- 머신러닝은 데이터를 숫자로 바꾸는 단계와, 그 숫자의 패턴을 학습하는 모델을 만드는 단계로 이루어진다.
weight = 0.7,bias = 0.3으로 만든 직선 데이터 50개를 80:20으로 나눠 학습 40개, 테스트 10개를 얻었다.unsqueeze(dim=1)로X의 모양을[50, 1]로 맞췄다.- 테스트 세트는 일반화 성능을 재기 위한 것이므로 학습에 절대 쓰지 않는다.
- 모델은
nn.Module을 상속하고,nn.Parameter로 학습 가능한 매개변수를 등록하고,forward()에 계산을 정의한다.requires_grad=True면 autograd가 기울기를 추적한다. parameters()와state_dict()로 모델의 매개변수를 확인할 수 있으며,torch.manual_seed로 무작위 초기값을 재현한다.- 예측은
torch.inference_mode()안에서 수행해 기울기 추적을 끄고 속도를 높인다. 학습 전 모델의 예측은 실제 값과 크게 어긋난다.