- PyTorch for Deep Learning (Daniel Bourke, freeCodeCamp) Chapter 1 정리
- 교재: learnpytorch.io
- 코드: MIT License
이 글은 노트북 01_pytorch_workflow의 뒷부분을 정리한다. 이전 글에서 만든 직선 데이터(X_train, y_train, X_test, y_test), plot_predictions() 함수, LinearRegressionModel 클래스와 그 인스턴스 model_0(시드 42, weights 0.3367, bias 0.1288)을 그대로 이어서 쓴다.
모델 학습의 직관
지금 모델은 무작위 매개변수로 계산하므로 사실상 무작위로 추측하고 있다. 학습이란 nn.Parameter()와 torch.randn()으로 무작위하게 정한 weights와 bias를 데이터를 더 잘 표현하는 값으로 갱신하는 일이다.
정답(0.7, 0.3)을 알고 있으니 직접 넣을 수도 있지만, 실제 문제에서는 이상적인 매개변수를 모르는 경우가 대부분이고, 매개변수가 수천만 개를 넘기도 한다. 그래서 모델이 스스로 값을 찾도록 코드를 작성한다. 이를 위해 두 가지가 더 필요하다. 손실 함수와 옵티마이저다.
손실 함수와 옵티마이저
| 함수 | 역할 | PyTorch 위치 | 흔한 선택 |
|---|---|---|---|
| 손실 함수(loss function) | 모델의 예측(y_preds)이 정답(y_test)과 얼마나 다른지 잰다. 낮을수록 좋다. |
torch.nn |
회귀: 평균 절대 오차(MAE, nn.L1Loss()). 이진 분류: 이진 교차 엔트로피(nn.BCELoss()). |
| 옵티마이저(optimizer) | 손실을 가장 잘 낮추도록 모델의 내부 매개변수를 어떻게 갱신할지 정한다. | torch.optim |
확률적 경사하강법(torch.optim.SGD()), Adam(torch.optim.Adam()). |
어떤 손실 함수와 옵티마이저를 쓸지는 문제에 따라 다르다. 여기서는 숫자를 예측하는 회귀 문제이므로 평균 절대 오차(mean absolute error, MAE) 를 쓴다. PyTorch에서는 nn.L1Loss()다.
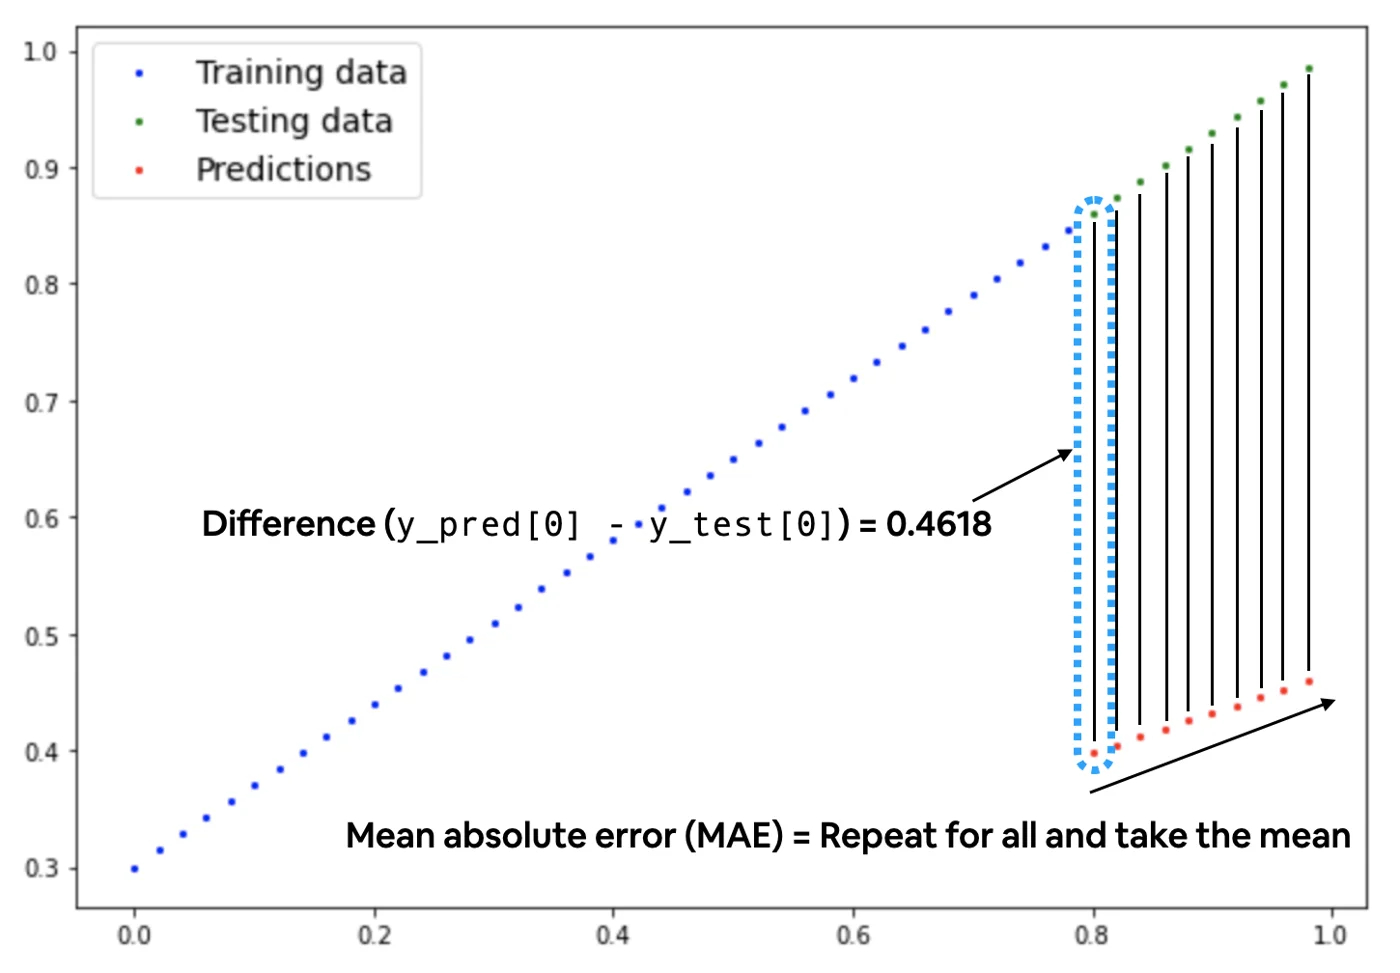 평균 절대 오차(MAE). 테스트 구간에서 각 초록 점(정답)과 빨간 점(예측) 사이의 세로 거리를 잰다. 첫 번째 쌍의 차이(
y_pred[0] - y_test[0]의 절댓값)는 0.4618이며, 이를 모든 점에 대해 반복해 평균을 낸 것이 MAE다. 출처: learnpytorch.io (Daniel Bourke, MIT License).
| 그림의 검은 세로선 10개가 각각 $$\left | y_i - \hat{y}_i \right | $$이다. 학습 전 모델의 예측(빨간 점)이 정답(초록 점)보다 한참 아래에 있어서 선이 길다. 학습의 목표는 이 선들의 평균 길이를 줄이는 것이다. |
옵티마이저로는 SGD를 쓴다. torch.optim.SGD(params, lr)의 인자는 다음과 같다.
params: 최적화할 모델 매개변수(여기서는weights와bias).lr: 학습률(learning rate). 한 번에 매개변수를 얼마나 크게 바꿀지 정한다. 너무 크면 갱신이 지나쳐 학습이 실패하고, 너무 작으면 이상적인 값에 도달하는 데 오래 걸린다. 사람이 정하는 값이므로 하이퍼파라미터(hyperparameter) 다. 흔한 시작값은0.01,0.001,0.0001이며, 학습 중에 바꾸는 것을 학습률 스케줄링이라 한다.
loss_fn = nn.L1Loss()  # MAE

optimizer = torch.optim.SGD(params=model_0.parameters(),  # 최적화할 매개변수
                            lr=0.01)                      # 학습률
경사하강법 한 스텝은 각 매개변수 \(\theta\)를 손실의 기울기 반대 방향으로 학습률만큼 움직인다.
\[\theta \leftarrow \theta - \text{lr} \cdot \frac{\partial \mathcal{L}}{\partial \theta}\]PyTorch 학습 루프
이제 학습 루프(training loop) 와 테스트 루프(testing loop) 를 만든다. 학습 루프는 모델이 학습 데이터를 돌며 특징과 레이블의 관계를 배우는 과정이고, 테스트 루프는 학습에서 한 번도 보지 않은 테스트 데이터로 배운 패턴이 얼마나 좋은지 평가하는 과정이다. 데이터 전체를 한 번 훑는 것을 에폭(epoch) 이라 한다.
학습 루프의 단계는 다음과 같다.
- 순전파(forward pass): 모델이 학습 데이터 전체에 대해
forward()계산을 수행한다.model(x_train) - 손실 계산: 모델의 출력(예측)을 정답과 비교해 얼마나 틀렸는지 잰다.
loss = loss_fn(y_pred, y_train) - 기울기 초기화: 옵티마이저의 기울기를 0으로 만든다. 기울기는 기본적으로 누적되므로, 매 스텝 새로 계산하려면 초기화해야 한다.
optimizer.zero_grad() - 역전파(backpropagation): 갱신할 모든 매개변수(
requires_grad=True)에 대해 손실의 기울기를 계산한다.loss.backward() - 옵티마이저 스텝(경사하강법): 계산된 기울기로 매개변수를 갱신한다.
optimizer.step()
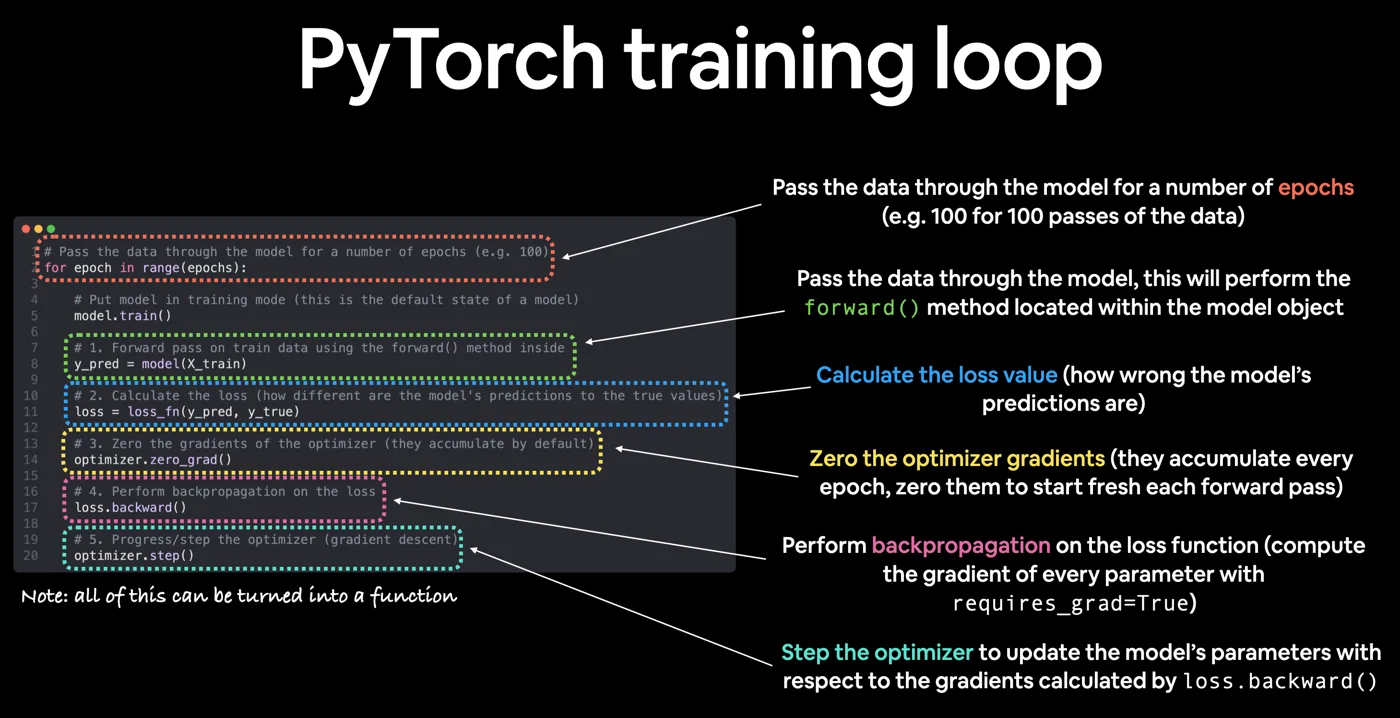 주석을 단 PyTorch 학습 루프. 에폭 수만큼 데이터를 모델에 통과시키고, 모델을 학습 모드로 두고(
model.train()), 1) 순전파, 2) 손실 계산, 3) 옵티마이저 기울기 초기화(에폭마다 누적되므로 매번 새로 시작), 4) 손실에 대한 역전파(requires_grad=True인 모든 매개변수의 기울기 계산), 5) loss.backward()가 계산한 기울기로 매개변수를 갱신하는 옵티마이저 스텝을 차례로 수행한다. 출처: learnpytorch.io (Daniel Bourke, MIT License).
순서에 대한 경험칙은 세 가지다.
- 손실을 계산(
loss = ...)한 다음 역전파(loss.backward())한다. - 기울기를 초기화(
optimizer.zero_grad())한 다음 역전파(loss.backward())한다. - 역전파(
loss.backward())한 다음 옵티마이저 스텝(optimizer.step())을 밟는다.
3번 단계가 1, 2번보다 앞에 오는 코드도 흔하다. 위 세 가지 규칙만 지키면 된다. 강의는 이 순서를 외우기 위한 “비공식 PyTorch 최적화 루프 노래(unofficial PyTorch optimization loop song)”도 소개한다.
에폭 단위로 학습 루프 돌리기
학습 루프의 핵심 부분만 떼어 보면 다음과 같다.
epochs = 1

for epoch in range(epochs):
    model_0.train()                    # 학습 모드 (모델의 기본 상태)

    y_pred = model_0(X_train)          # 1. 순전파
    loss = loss_fn(y_pred, y_train)    # 2. 손실 계산
    optimizer.zero_grad()              # 3. 기울기 초기화
    loss.backward()                    # 4. 역전파
    optimizer.step()                   # 5. 매개변수 갱신

print(model_0.state_dict())
이 셀을 실행할 때마다 state_dict()의 weights와 bias가 목표값(0.7, 0.3) 쪽으로 조금씩 움직이고 손실은 조금씩 줄어든다. epochs를 키우면 같은 과정을 여러 번 반복한다.
model.train()은 모델을 학습 모드로 둔다. 이 모델에는 영향이 없지만, 드롭아웃(dropout)이나 배치 정규화(batch normalization)처럼 학습할 때와 평가할 때 다르게 동작하는 층이 있으면 이 설정이 그 동작을 결정한다. 그래서 학습 루프에서는 model.train(), 평가할 때는 model.eval()을 명시하는 습관을 들인다.
PyTorch 테스트 루프
테스트 루프의 단계는 다음과 같다.
- 순전파: 모델이 테스트 데이터 전체에 대해
forward()를 수행한다.model(x_test) - 손실 계산: 예측과 정답을 비교한다.
loss = loss_fn(y_pred, y_test) - 평가 지표 계산(선택): 손실 외에 정확도 같은 지표를 계산한다.
테스트 루프에는 역전파(loss.backward())와 옵티마이저 스텝(optimizer.step())이 없다. 테스트에서는 매개변수를 바꾸지 않고 순전파 출력만 보기 때문이다.
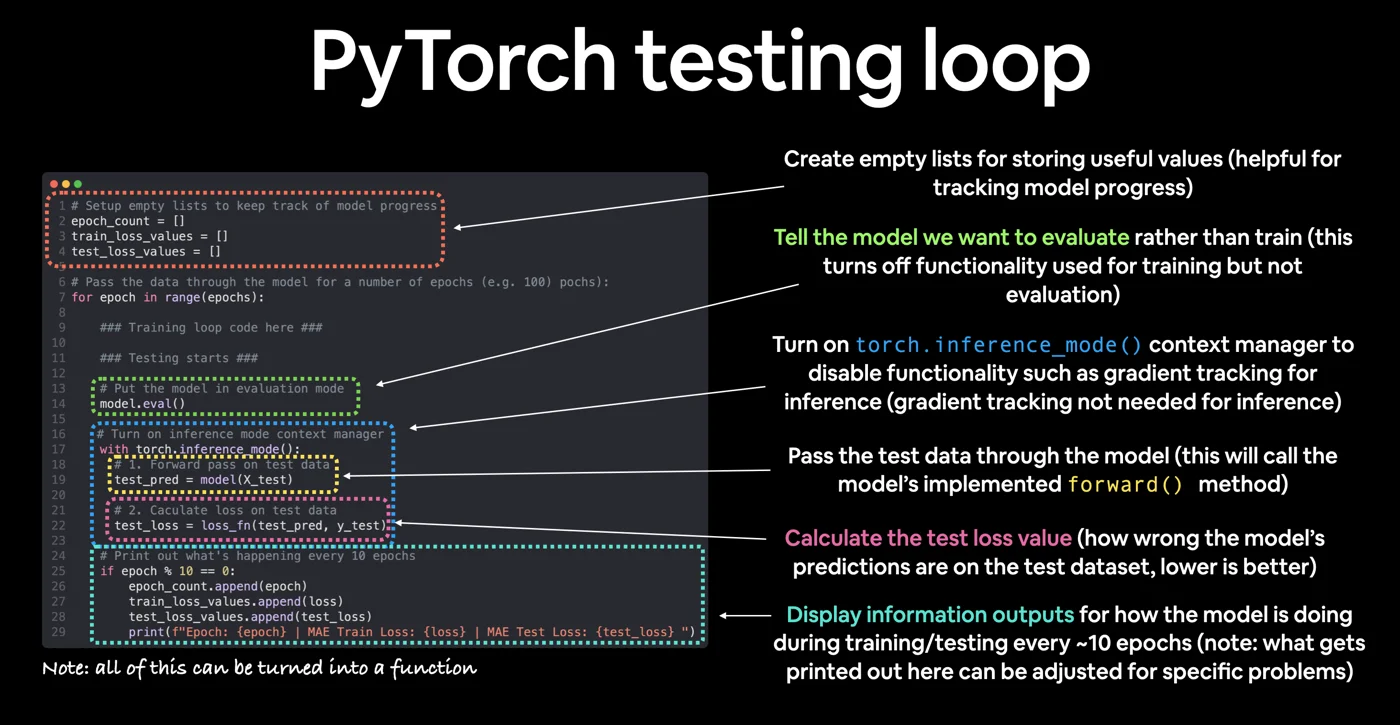 주석을 단 PyTorch 테스트 루프. 진행 상황을 기록할 빈 리스트를 만들고, 학습 코드 뒤에
model.eval()로 평가 모드를 켜고(학습에만 쓰는 기능을 끔), torch.inference_mode() 컨텍스트 매니저로 기울기 추적 등을 끈 상태에서 테스트 데이터로 순전파하고, 테스트 손실을 계산하고, 10 에폭마다 진행 상황을 출력한다. 출처: learnpytorch.io (Daniel Bourke, MIT License).
학습과 테스트를 합쳐 100 에폭 동안 학습하고 10 에폭마다 평가한다(model_0을 처음 상태부터 다시 학습시키려면 앞의 모델 생성 셀부터 다시 실행한다).
torch.manual_seed(42)

epochs = 100  # 학습 데이터를 몇 번 훑을지

# 손실 값을 기록할 리스트
train_loss_values = []
test_loss_values = []
epoch_count = []

for epoch in range(epochs):
    ### 학습
    model_0.train()

    y_pred = model_0(X_train)          # 1. 순전파
    loss = loss_fn(y_pred, y_train)    # 2. 손실 계산
    optimizer.zero_grad()              # 3. 기울기 초기화
    loss.backward()                    # 4. 역전파
    optimizer.step()                   # 5. 옵티마이저 스텝

    ### 테스트
    model_0.eval()                     # 평가 모드

    with torch.inference_mode():
        test_pred = model_0(X_test)                               # 1. 순전파
        test_loss = loss_fn(test_pred, y_test.type(torch.float))  # 2. 손실 계산

        if epoch % 10 == 0:
            epoch_count.append(epoch)
            train_loss_values.append(loss.detach().numpy())
            test_loss_values.append(test_loss.detach().numpy())
            print(f"Epoch: {epoch} | MAE Train Loss: {loss} | MAE Test Loss: {test_loss} ")
Epoch: 0 | MAE Train Loss: 0.31288138031959534 | MAE Test Loss: 0.48106518387794495
Epoch: 10 | MAE Train Loss: 0.1976713240146637 | MAE Test Loss: 0.3463551998138428
Epoch: 20 | MAE Train Loss: 0.08908725529909134 | MAE Test Loss: 0.21729660034179688
Epoch: 30 | MAE Train Loss: 0.053148526698350906 | MAE Test Loss: 0.14464017748832703
Epoch: 40 | MAE Train Loss: 0.04543796554207802 | MAE Test Loss: 0.11360953003168106
Epoch: 50 | MAE Train Loss: 0.04167863354086876 | MAE Test Loss: 0.09919948130846024
Epoch: 60 | MAE Train Loss: 0.03818932920694351 | MAE Test Loss: 0.08886633068323135
Epoch: 70 | MAE Train Loss: 0.03476089984178543 | MAE Test Loss: 0.0805937647819519
Epoch: 80 | MAE Train Loss: 0.03132382780313492 | MAE Test Loss: 0.07232122868299484
Epoch: 90 | MAE Train Loss: 0.02788739837706089 | MAE Test Loss: 0.06473556160926819
몇 가지 줄을 짚어 둔다.
model_0.eval()은 평가 모드로 바꾼다. 학습에만 필요한 동작을 끈다.torch.inference_mode()안에서는 기울기를 추적하지 않는다. 테스트에서는 매개변수를 갱신하지 않으므로 기울기가 필요 없고, 끄면 계산이 빨라진다.y_test.type(torch.float)는 예측(torch.float32)과 정답의 자료형을 맞추기 위한 것이다. 여기서는 이미 둘 다float32지만 습관적으로 맞춰 둔다.loss.detach().numpy(): 학습 손실loss는 기울기 그래프에 연결되어 있어서 바로 NumPy로 바꿀 수 없다.detach()로 그래프에서 떼어 낸 뒤numpy()로 변환해 matplotlib에서 쓸 수 있게 한다.
손실이 에폭마다 줄어든다. 손실 곡선(loss curve)을 그려 확인한다.
plt.plot(epoch_count, train_loss_values, label="Train loss")
plt.plot(epoch_count, test_loss_values, label="Test loss")
plt.title("Training and test loss curves")
plt.ylabel("Loss")
plt.xlabel("Epochs")
plt.legend()
두 곡선 모두 에폭이 지날수록 내려간다. 학습 손실은 0.31에서 0.03 근처로, 테스트 손실은 0.48에서 0.06 근처로 떨어진다. 손실이 줄어든 이유는 손실 함수와 옵티마이저가 모델의 weights와 bias를 데이터의 패턴을 더 잘 반영하도록 갱신했기 때문이다.
print("The model learned the following values for weights and bias:")
print(model_0.state_dict())
print("\nAnd the original values for weights and bias are:")
print(f"weights: {weight}, bias: {bias}")
The model learned the following values for weights and bias:
OrderedDict([('weights', tensor([0.5784])), ('bias', tensor([0.3513]))])

And the original values for weights and bias are:
weights: 0.7, bias: 0.3
0.3367이던 가중치는 0.5784로, 0.1288이던 편향은 0.3513으로 바뀌어 원래 값에 상당히 가까워졌다. 더 오래 학습하면(예: epochs = 200) 더 가까워진다. 이것이 머신러닝의 핵심 아이디어다. 데이터를 설명하는 이상적인 값이 있고, 그 값을 손으로 찾는 대신 모델을 학습시켜 프로그램이 찾게 한다.
학습된 모델로 예측하기
학습이 끝난 모델로 예측(추론)할 때 기억할 세 가지가 있다.
- 모델을 평가 모드로 둔다(
model.eval()). - 추론 모드 컨텍스트 매니저 안에서 예측한다(
with torch.inference_mode(): ...). - 모델과 데이터를 같은 장치에 둔다(둘 다 GPU이거나 둘 다 CPU).
1, 2번은 학습에만 필요한 계산과 설정을 꺼서 계산을 빠르게 하고, 3번은 장치 간 오류를 막는다.
model_0.eval()

with torch.inference_mode():
    # 아직 장치 독립 코드를 쓰지 않았으므로 모델과 데이터 모두 CPU에 있다
    y_preds = model_0(X_test)

print(y_preds)
plot_predictions(predictions=y_preds)
tensor([[0.8141],
        [0.8256],
        [0.8372],
        [0.8488],
        [0.8603],
        [0.8719],
        [0.8835],
        [0.8950],
        [0.9066],
        [0.9182]])
학습 전에는 0.40~0.46이던 예측이 0.81~0.92로 올라가, 그림에서 빨간 점이 초록 점에 훨씬 가까워진다. 다만 기울기가 아직 0.58이라 오른쪽으로 갈수록 정답보다 조금씩 낮다.
모델 저장하고 불러오기
학습한 모델은 다른 애플리케이션에서 쓰거나 나중에 이어서 작업하기 위해 저장한다. 알아야 할 메서드는 세 가지다.
| 메서드 | 역할 |
|---|---|
torch.save |
파이썬의 pickle로 객체를 직렬화해 디스크에 저장한다. 모델, 텐서, 딕셔너리 등을 저장할 수 있다. |
torch.load |
pickle로 저장된 객체를 역직렬화해 메모리로 불러온다. 어떤 장치로 불러올지도 정할 수 있다. |
torch.nn.Module.load_state_dict |
저장된 state_dict()로 모델의 매개변수 딕셔너리를 채운다. |
pickle은 안전하지 않다. 신뢰할 수 있는 출처의 파일만 불러와야 하며, PyTorch 모델 파일도 마찬가지다.
state_dict 저장하기
추론용 모델을 저장하고 불러오는 권장 방법은 모델 전체가 아니라 state_dict()를 저장하는 것이다.
pathlib으로 모델을 저장할models디렉터리를 만든다.- 저장할 파일 경로를 만든다. 관례상 확장자는
.pt또는.pth다. torch.save(obj, f)로state_dict()를 저장한다.
from pathlib import Path

# 1. 디렉터리 생성
MODEL_PATH = Path("models")
MODEL_PATH.mkdir(parents=True, exist_ok=True)

# 2. 저장 경로
MODEL_NAME = "01_pytorch_workflow_model_0.pth"
MODEL_SAVE_PATH = MODEL_PATH / MODEL_NAME

# 3. state_dict 저장 (학습된 매개변수만 저장된다)
print(f"Saving model to: {MODEL_SAVE_PATH}")
torch.save(obj=model_0.state_dict(), f=MODEL_SAVE_PATH)
Saving model to: models/01_pytorch_workflow_model_0.pth
mkdir(parents=True, exist_ok=True)는 상위 디렉터리가 없으면 함께 만들고, 이미 있으면 오류 없이 넘어간다. 저장된 파일은 약 1KB다. 매개변수 두 개뿐이기 때문이다.
state_dict 불러오기
state_dict()는 학습된 매개변수의 딕셔너리일 뿐 모델 자체가 아니므로, 먼저 torch.load()로 딕셔너리를 읽고, 같은 클래스의 새 인스턴스를 만들어 load_state_dict()로 넣어 준다.
모델 전체를 저장하는 방법도 있지만, PyTorch 문서에 따르면 그렇게 직렬화한 데이터는 저장 당시의 특정 클래스와 디렉터리 구조에 묶이므로, 다른 프로젝트에서 쓰거나 코드를 리팩터링하면 여러 방식으로 깨질 수 있다. state_dict()만 저장하는 쪽이 더 유연하다.
# 새 인스턴스 (무작위 가중치로 초기화된다)
loaded_model_0 = LinearRegressionModel()

# 저장된 state_dict로 매개변수를 덮어쓴다
loaded_model_0.load_state_dict(torch.load(f=MODEL_SAVE_PATH))
<All keys matched successfully>
불러온 모델로 예측해 저장 전 예측과 비교한다. 추론 규칙(평가 모드, 추론 모드, 같은 장치)을 그대로 따른다.
loaded_model_0.eval()

with torch.inference_mode():
    loaded_model_preds = loaded_model_0(X_test)

y_preds == loaded_model_preds
tensor([[True],
        [True],
        [True],
        [True],
        [True],
        [True],
        [True],
        [True],
        [True],
        [True]])
모든 예측이 같으므로 저장과 불러오기가 제대로 동작했다.
모두 합치기
지금까지의 과정을 한 번에 다시 구성한다. 이번에는 장치 독립 코드를 써서 GPU가 있으면 GPU를, 없으면 CPU를 쓴다. Colab에서 GPU를 켜려면 런타임 → 런타임 유형 변경 → 하드웨어 가속기 → GPU를 선택한다(런타임이 재시작되어 변수가 초기화된다).
import torch
from torch import nn
import matplotlib.pyplot as plt

device = "cuda" if torch.cuda.is_available() else "cpu"
print(f"Using device: {device}")
Using device: cuda
데이터
weight = 0.7
bias = 0.3

start = 0
end = 1
step = 0.02

X = torch.arange(start, end, step).unsqueeze(dim=1)  # unsqueeze가 없으면 나중에 선형 층에서 모양 오류가 난다
y = weight * X + bias

train_split = int(0.8 * len(X))
X_train, y_train = X[:train_split], y[:train_split]
X_test, y_test = X[train_split:], y[train_split:]

len(X_train), len(y_train), len(X_test), len(y_test)
(40, 40, 10, 10)
nn.Linear로 선형 모델 만들기
이번에는 nn.Parameter()로 가중치와 편향을 직접 만드는 대신 nn.Linear(in_features, out_features)를 쓴다. in_features는 입력 데이터의 차원 수, out_features는 출력 차원 수다. 이 데이터는 레이블(y) 하나당 입력 특징(X)이 하나이므로 둘 다 1이다.
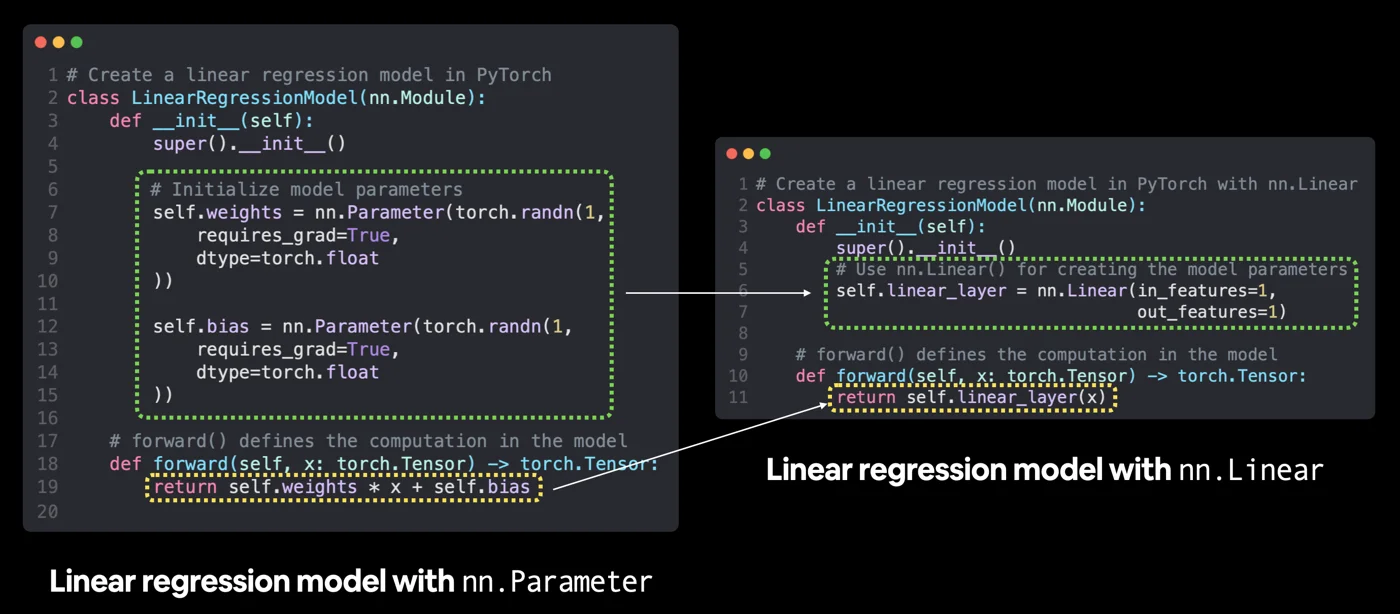
nn.Parameter로 만든 선형 회귀 모델(왼쪽)과 nn.Linear로 만든 같은 모델(오른쪽). 왼쪽 초록 박스의 weights와 bias 초기화가 오른쪽에서는 nn.Linear(in_features=1, out_features=1) 한 줄로, 노란 박스의 self.weights * x + self.bias는 self.linear_layer(x)로 바뀐다. torch.nn에는 이처럼 미리 만들어진 계산(층)이 많다. 출처: learnpytorch.io (Daniel Bourke, MIT License).
class LinearRegressionModelV2(nn.Module):
    def __init__(self):
        super().__init__()
        # nn.Linear가 가중치와 편향을 만들어 준다
        self.linear_layer = nn.Linear(in_features=1,
                                      out_features=1)

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        return self.linear_layer(x)

torch.manual_seed(42)
model_1 = LinearRegressionModelV2()
model_1, model_1.state_dict()
(LinearRegressionModelV2(
   (linear_layer): Linear(in_features=1, out_features=1, bias=True)
 ),
 OrderedDict([('linear_layer.weight', tensor([[0.7645]])),
              ('linear_layer.bias', tensor([0.8300]))]))
nn.Linear가 무작위 weight(모양 [1, 1])와 bias(모양 [1])를 만들었다. 내부적으로 \(y = xA^T + b\)를 계산하므로, 입력 X_train의 모양 [40, 1]에서 마지막 차원 1이 in_features=1과 맞아야 한다. 데이터를 만들 때 unsqueeze(dim=1)을 한 이유가 이것이다.
모델을 대상 장치로 옮긴다. 모델의 장치는 매개변수의 장치로 확인한다.
print(next(model_1.parameters()).device)  # 기본은 CPU

model_1.to(device)
print(next(model_1.parameters()).device)
cpu
cuda:0
next(model_1.parameters())는 매개변수 중 첫 번째를 꺼낸다. 텐서와 달리 모델의 to()는 모델 자체를 제자리에서 옮기므로 재할당하지 않아도 된다.
학습
손실 함수와 옵티마이저는 앞과 같다. 단, 옵티마이저에는 새 모델의 매개변수(model_1.parameters())를 넘긴다.
loss_fn = nn.L1Loss()
optimizer = torch.optim.SGD(params=model_1.parameters(), lr=0.01)
이전 학습 루프와 달라지는 점은 데이터를 대상 장치에 올리는 것뿐이다. 모델이 GPU에 있으면 데이터도 GPU에 있어야 한다. 이번에는 1000 에폭 동안 학습한다.
torch.manual_seed(42)

epochs = 1000

# 데이터를 대상 장치로 (모델과 데이터가 다른 장치에 있으면 오류)
X_train = X_train.to(device)
X_test = X_test.to(device)
y_train = y_train.to(device)
y_test = y_test.to(device)

for epoch in range(epochs):
    ### 학습
    model_1.train()

    y_pred = model_1(X_train)          # 1. 순전파
    loss = loss_fn(y_pred, y_train)    # 2. 손실 계산
    optimizer.zero_grad()              # 3. 기울기 초기화
    loss.backward()                    # 4. 역전파
    optimizer.step()                   # 5. 옵티마이저 스텝

    ### 테스트
    model_1.eval()
    with torch.inference_mode():
        test_pred = model_1(X_test)
        test_loss = loss_fn(test_pred, y_test)

    if epoch % 100 == 0:
        print(f"Epoch: {epoch} | Train loss: {loss} | Test loss: {test_loss}")
Epoch: 0 | Train loss: 0.5551779866218567 | Test loss: 0.5739762187004089
Epoch: 100 | Train loss: 0.006215683650225401 | Test loss: 0.014086711220443249
Epoch: 200 | Train loss: 0.0012645035749301314 | Test loss: 0.013801801018416882
Epoch: 300 | Train loss: 0.0012645035749301314 | Test loss: 0.013801801018416882
...
Epoch: 900 | Train loss: 0.0012645035749301314 | Test loss: 0.013801801018416882
200 에폭 이후로는 손실이 더 줄지 않는다. 학습률 0.01에서 갈 수 있는 만큼 수렴한 것이다. 같은 시드라도 CPU와 GPU에서 결과가 미세하게 다를 수 있는데, 차이가 작다면 무시해도 된다.
from pprint import pprint

print("The model learned the following values for weights and bias:")
pprint(model_1.state_dict())
print("\nAnd the original values for weights and bias are:")
print(f"weights: {weight}, bias: {bias}")
The model learned the following values for weights and bias:
OrderedDict([('linear_layer.weight', tensor([[0.6968]], device='cuda:0')),
             ('linear_layer.bias', tensor([0.3025], device='cuda:0'))])

And the original values for weights and bias are:
weights: 0.7, bias: 0.3
0.6968과 0.3025로, 원래 값(0.7, 0.3)과 거의 같다. 실제 문제에서는 정답 매개변수를 미리 알 수 없고 매개변수가 수천만 개에 이르지만, 원리는 같다.
예측
model_1.eval()
with torch.inference_mode():
    y_preds = model_1(X_test)
y_preds
tensor([[0.8600],
        [0.8739],
        [0.8878],
        [0.9018],
        [0.9157],
        [0.9296],
        [0.9436],
        [0.9575],
        [0.9714],
        [0.9854]], device='cuda:0')
device='cuda:0'은 결과가 0번 GPU에 있다는 뜻이다. pandas, matplotlib, NumPy 같은 라이브러리는 GPU 위의 데이터를 다루지 못하므로, 그림을 그리려면 .cpu()로 CPU에 복사한다.
# plot_predictions(predictions=y_preds)  # 오류: 데이터가 GPU에 있다
plot_predictions(predictions=y_preds.cpu())
빨간 예측 점이 초록 정답 점과 거의 완벽하게 겹친다.
저장하고 불러오기
from pathlib import Path

MODEL_PATH = Path("models")
MODEL_PATH.mkdir(parents=True, exist_ok=True)
MODEL_NAME = "01_pytorch_workflow_model_1.pth"
MODEL_SAVE_PATH = MODEL_PATH / MODEL_NAME

print(f"Saving model to: {MODEL_SAVE_PATH}")
torch.save(obj=model_1.state_dict(), f=MODEL_SAVE_PATH)
Saving model to: models/01_pytorch_workflow_model_1.pth
불러올 때는 새 인스턴스를 만들고, state_dict를 넣고, 대상 장치로 옮긴다. 데이터가 GPU에 있으면 모델도 GPU에 있어야 예측할 수 있다.
loaded_model_1 = LinearRegressionModelV2()
loaded_model_1.load_state_dict(torch.load(MODEL_SAVE_PATH))
loaded_model_1.to(device)

print(f"Loaded model:\n{loaded_model_1}")
print(f"Model on device:\n{next(loaded_model_1.parameters()).device}")

loaded_model_1.eval()
with torch.inference_mode():
    loaded_model_1_preds = loaded_model_1(X_test)
print(y_preds == loaded_model_1_preds)
Loaded model:
LinearRegressionModelV2(
  (linear_layer): Linear(in_features=1, out_features=1, bias=True)
)
Model on device:
cuda:0
tensor([[True],
        [True],
        [True],
        [True],
        [True],
        [True],
        [True],
        [True],
        [True],
        [True]], device='cuda:0')
불러온 모델의 예측이 저장 전과 모두 같다. 이로써 데이터 준비부터 저장까지 PyTorch 워크플로 전체를 한 번 거쳤다.
정리
- 손실 함수는 예측이 얼마나 틀렸는지 재고(회귀에는 MAE,
nn.L1Loss), 옵티마이저는 손실을 줄이도록 매개변수를 갱신한다(torch.optim.SGD, 학습률lr은 하이퍼파라미터). - 학습 루프는 순전파 → 손실 계산 →
optimizer.zero_grad()→loss.backward()→optimizer.step()의 다섯 단계이며, 기울기는 누적되므로 매 스텝 초기화한다. - 테스트 루프는
model.eval()과torch.inference_mode()아래에서 순전파와 손실(및 지표) 계산만 하고, 역전파와 옵티마이저 스텝은 하지 않는다. model.train()과model.eval()은 드롭아웃, 배치 정규화처럼 학습과 평가에서 다르게 동작하는 층의 모드를 정한다.- 100 에폭 학습 후
model_0의 매개변수는 (0.5784, 0.3513)으로,nn.Linear기반model_1은 1000 에폭 후 (0.6968, 0.3025)로 실제 값(0.7, 0.3)에 접근했다. - 모델은
torch.save(model.state_dict(), path)로 저장하고, 새 인스턴스에load_state_dict(torch.load(path))로 불러오는 것이 권장 방법이다.pickle기반이므로 신뢰하는 파일만 불러온다. - 장치 독립 코드에서는 모델과 데이터를 모두
to(device)로 같은 장치에 두고, NumPy나 matplotlib에 넘길 때는.cpu()로 되돌린다.