- PyTorch for Deep Learning (Daniel Bourke, freeCodeCamp) Chapter 0 정리
- 교재: learnpytorch.io
- 코드: MIT License
이 글은 노트북 00_pytorch_fundamentals의 텐서 부분을 정리한다. 모든 코드는 import torch 이후에 실행한다고 가정한다.
텐서 소개
텐서(tensor)는 데이터를 숫자로 표현하는 머신러닝의 기본 구성 요소다. PyTorch에서는 torch.Tensor 클래스가 이를 담당하며, torch.tensor()로 직접 만들 수 있다.
스칼라
스칼라(scalar) 는 숫자 하나이며, 텐서 용어로는 0차원 텐서다.
import torch

scalar = torch.tensor(7)
print(scalar)         # tensor(7)
print(scalar.ndim)    # 차원 수
print(scalar.item())  # 파이썬 숫자로 꺼내기 (원소가 하나인 텐서에서만 가능)
tensor(7)
0
7
scalar는 숫자 하나지만 자료형은 torch.Tensor다. ndim은 차원 수, item()은 원소가 하나뿐인 텐서에서 파이썬 정수나 실수를 꺼낸다.
벡터
벡터(vector) 는 1차원 텐서로, 여러 숫자를 담을 수 있다. 예를 들어 [3, 2]로 집의 [침실 수, 욕실 수]를 나타낼 수 있다.
vector = torch.tensor([7, 7])
print(vector, vector.ndim, vector.shape)
tensor([7, 7]) 1 torch.Size([2])
숫자가 두 개인데 차원은 1이다. 차원 수는 바깥쪽 대괄호 [의 개수(한쪽만 센다)로 알 수 있다. shape는 원소가 어떻게 배열되어 있는지를 알려 주며, torch.Size([2])는 원소 2개가 한 줄로 있다는 뜻이다.
행렬
MATRIX = torch.tensor([[7, 8],
                       [9, 10]])
print(MATRIX.ndim, MATRIX.shape)
2 torch.Size([2, 2])
바깥 대괄호가 두 개이므로 2차원이고, 2행 2열이므로 모양은 [2, 2]다.
텐서
TENSOR = torch.tensor([[[1, 2, 3],
                        [3, 6, 9],
                        [2, 4, 5]]])
print(TENSOR.ndim, TENSOR.shape)
3 torch.Size([1, 3, 3])
모양은 바깥 차원에서 안쪽 차원 순서로 읽는다. [1, 3, 3]은 “3×3 행렬이 1개”라는 뜻이다.
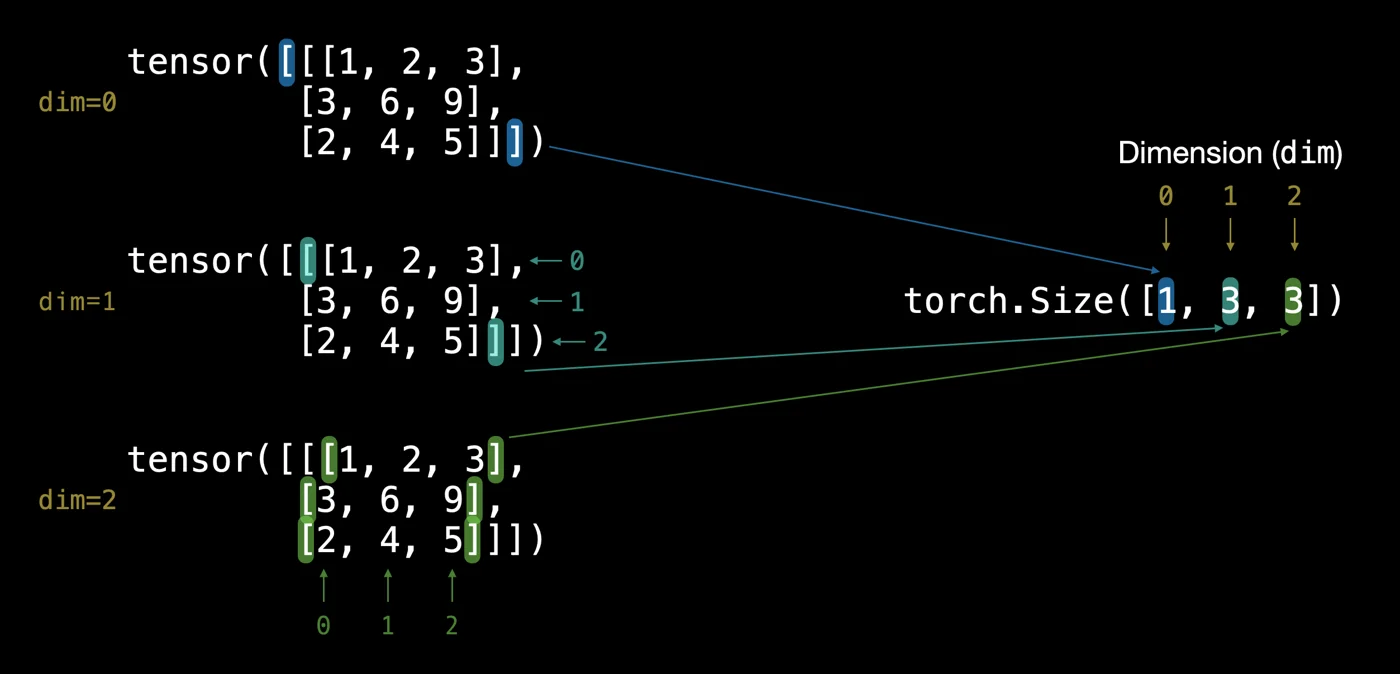
TENSOR의 각 차원이 torch.Size([1, 3, 3])의 어느 숫자에 대응하는지 보여 주는 그림. 가장 바깥 대괄호 안의 원소는 1개(dim=0), 그 안의 행은 3개(dim=1), 각 행의 원소는 3개(dim=2)다. 출처: learnpytorch.io (Daniel Bourke, MIT License).
그림의 위쪽은 가장 바깥 대괄호(파랑)가 감싸는 덩어리가 하나뿐이어서 dim 0의 크기가 1임을, 가운데는 그 안에 행(청록)이 0, 1, 2로 세 개 있어 dim 1의 크기가 3임을, 아래쪽은 각 행 안의 원소(초록)가 세 개라 dim 2의 크기가 3임을 보여 준다.
텐서는 거의 무엇이든 나타낼 수 있다. 위의 TENSOR는 예를 들어 요일별 스테이크와 아몬드 버터 판매량일 수 있다.
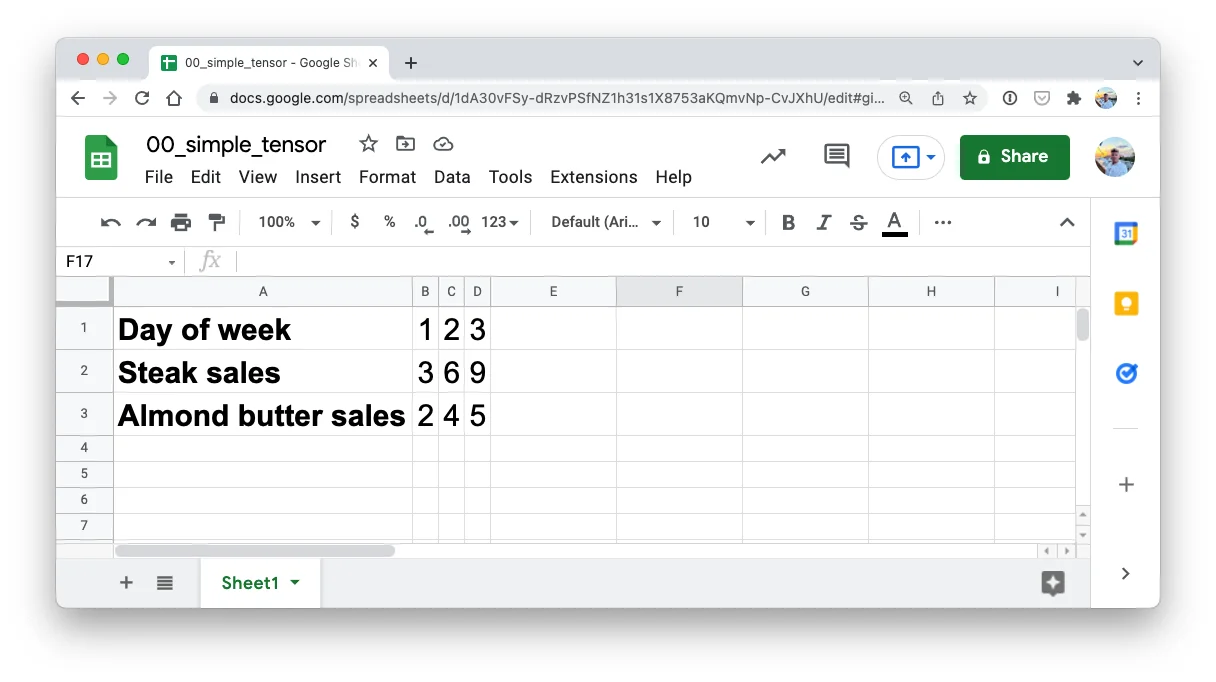 스프레드시트로 표현한 간단한 텐서. 첫 행은 요일(1, 2, 3), 둘째 행은 스테이크 판매량(3, 6, 9), 셋째 행은 아몬드 버터 판매량(2, 4, 5)으로, 위
TENSOR의 값과 같다. 출처: learnpytorch.io (Daniel Bourke, MIT License).
관례상 스칼라와 벡터는 소문자(a, y), 행렬과 텐서는 대문자(Q, X, W)로 적는다. 실제로는 모두 torch.Tensor이므로 “행렬”과 “텐서”라는 이름을 섞어 쓰는 경우가 많다.
| 이름 | 의미 | 차원 수 | 표기(예) |
|---|---|---|---|
| 스칼라 | 숫자 하나 | 0 | 소문자 a |
| 벡터 | 방향이 있는 수, 또는 여러 숫자의 나열 | 1 | 소문자 y |
| 행렬 | 2차원 숫자 배열 | 2 | 대문자 Q |
| 텐서 | n차원 숫자 배열 | 임의(0차원은 스칼라, 1차원은 벡터) | 대문자 X |
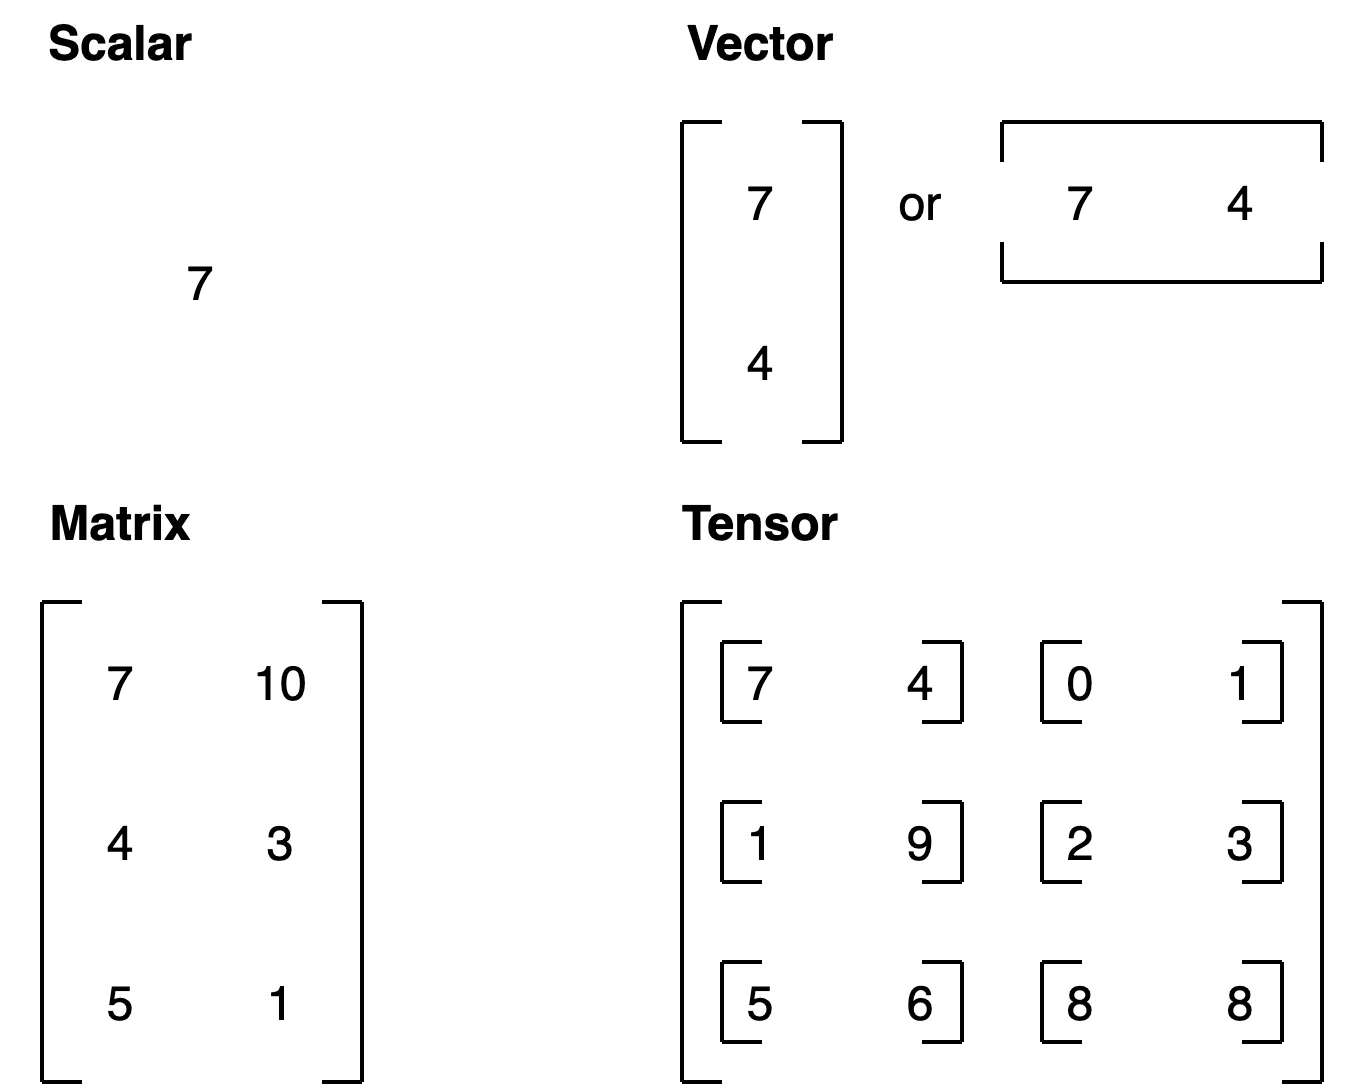 스칼라(숫자 7 하나), 벡터(세로 또는 가로로 늘어놓은 7, 4), 행렬(3행 2열), 텐서(행렬보다 차원이 하나 이상 더 많은 배열)의 모양 비교. 출처: learnpytorch.io (Daniel Bourke, MIT License).
텐서 만들기
무작위 텐서
실제로 텐서를 손으로 만드는 일은 드물다. 신경망은 보통 큰 무작위 텐서에서 출발해 데이터를 보면서 그 값을 조정한다.
무작위 숫자로 시작 → 데이터 보기 → 숫자 갱신 → 데이터 보기 → 숫자 갱신 → ...
시작 방식은 초기화(initialization), 데이터를 보는 방식은 표현(representation), 갱신 방식은 최적화(optimization) 라 부른다. 무작위 텐서는 torch.rand()에 size를 넘겨 만든다. 값은 \([0, 1)\) 구간의 균등분포에서 뽑힌다.
random_tensor = torch.rand(size=(3, 4))
print(random_tensor, random_tensor.dtype)

# 흔한 이미지 모양 [height, width, color_channels]
random_image_size_tensor = torch.rand(size=(224, 224, 3))
print(random_image_size_tensor.shape, random_image_size_tensor.ndim)
tensor([[0.6541, 0.4807, 0.2162, 0.6168],
        [0.4428, 0.6608, 0.6194, 0.8620],
        [0.2795, 0.6055, 0.4958, 0.5483]]) torch.float32
torch.Size([224, 224, 3]) 3
무작위 값이므로 실행할 때마다 숫자는 달라진다. 이를 고정하는 방법은 아래 “재현성”에서 다룬다.
0과 1로 채운 텐서
마스킹(masking, 일부 값을 0으로 가려 모델이 학습하지 않게 하는 것) 등에 0이나 1로 채운 텐서가 자주 쓰인다.
zeros = torch.zeros(size=(3, 4))
ones = torch.ones(size=(3, 4))
print(zeros.dtype, ones.dtype)
torch.float32 torch.float32
범위와 같은 모양의 텐서
torch.arange(start, end, step)은 start부터 end 직전까지 step 간격의 값을 만든다. 파이썬의 range()처럼 end는 포함하지 않는다. torch.range()는 더 이상 권장되지 않는다(deprecated).
zero_to_ten = torch.arange(start=0, end=10, step=1)
print(zero_to_ten)

# 다른 텐서와 같은 모양의 0 텐서
ten_zeros = torch.zeros_like(input=zero_to_ten)
print(ten_zeros)
tensor([0, 1, 2, 3, 4, 5, 6, 7, 8, 9])
tensor([0, 0, 0, 0, 0, 0, 0, 0, 0, 0])
torch.zeros_like(input)과 torch.ones_like(input)은 input과 같은 모양(그리고 같은 자료형, 장치)의 0 또는 1 텐서를 만든다.
텐서 자료형
PyTorch에는 여러 텐서 자료형이 있다. 가장 흔하고 기본값인 것은 32비트 부동소수점 torch.float32(= torch.float)다. 그 밖에 16비트 torch.float16(= torch.half), 64비트 torch.float64(= torch.double), 그리고 8, 16, 32, 64비트 정수형이 있다.
자료형이 여러 개인 이유는 정밀도(precision), 즉 숫자 하나를 표현하는 데 쓰는 정보량 때문이다. 정밀도가 높을수록 숫자를 자세히 표현하지만 계산량이 늘어난다. 정밀도가 낮은 자료형은 계산이 빠르고 모델이 작아지는 대신 정확도 같은 지표가 조금 나빠질 수 있다. 모바일용 신경망이 8비트 정수를 쓰는 것이 그 예다.
float_32_tensor = torch.tensor([3.0, 6.0, 9.0],
                               dtype=None,          # None이면 기본값 torch.float32
                               device=None,         # None이면 기본 장치(CPU)
                               requires_grad=False) # True면 이 텐서에 대한 연산을 기록(기울기 계산용)
print(float_32_tensor.shape, float_32_tensor.dtype, float_32_tensor.device)

float_16_tensor = torch.tensor([3.0, 6.0, 9.0], dtype=torch.float16)
print(float_16_tensor.dtype)
torch.Size([3]) torch.float32 cpu
torch.float16
PyTorch에서 가장 자주 만나는 오류는 세 가지다.
- 모양(shape) 불일치: 연산에 맞지 않는 모양의 텐서를 섞었다.
- 자료형(dtype) 불일치: 예를 들어 하나는
torch.float32, 다른 하나는torch.float16이다. - 장치(device) 불일치: 하나는 CPU에, 다른 하나는 GPU에 있다.
텐서에서 정보 얻기
가장 자주 확인하는 속성은 위 오류와 정확히 대응하는 세 가지다.
shape: 텐서의 모양dtype: 원소의 자료형device: 텐서가 저장된 장치(CPU 또는 GPU)
some_tensor = torch.rand(3, 4)
print(f"Shape of tensor: {some_tensor.shape}")
print(f"Datatype of tensor: {some_tensor.dtype}")
print(f"Device tensor is stored on: {some_tensor.device}")  # 기본은 CPU
Shape of tensor: torch.Size([3, 4])
Datatype of tensor: torch.float32
Device tensor is stored on: cpu
오류가 나면 “무슨 모양(what shape), 무슨 자료형(what datatype), 어디에(where)”를 먼저 확인하는 습관이 도움이 된다.
텐서 조작
신경망이 하는 일은 결국 텐서에 대한 연산의 조합이다. 기본 연산은 덧셈, 뺄셈, 원소별 곱셈, 나눗셈, 그리고 행렬 곱셈이다. 이 블록들을 적절히 쌓으면 아무리 정교한 신경망도 만들 수 있다.
tensor = torch.tensor([1, 2, 3])
print(tensor + 10)   # 덧셈
print(tensor * 10)   # 곱셈
print(tensor)        # 재할당하지 않으면 원래 값은 그대로
tensor = tensor - 10 # 재할당
print(tensor)
tensor = tensor + 10
print(torch.multiply(tensor, 10))  # torch 함수로도 가능 (torch.mul, torch.add 등)
print(tensor * tensor)             # 원소별 곱셈
tensor([11, 12, 13])
tensor([10, 20, 30])
tensor([1, 2, 3])
tensor([-9, -8, -7])
tensor([10, 20, 30])
tensor([1, 4, 9])
연산 결과는 새 텐서로 반환되며, 원래 텐서는 다시 할당하지 않는 한 바뀌지 않는다. torch.mul() 같은 함수 대신 * 같은 연산자를 쓰는 편이 더 흔하다.
행렬 곱셈
머신러닝에서 가장 흔한 연산 중 하나가 행렬 곱셈(matrix multiplication) 이다. PyTorch에서는 torch.matmul() 또는 파이썬의 @ 연산자로 계산한다. 원소별 곱셈과의 차이는 곱한 값들을 더한다는 점이다.
| 연산 | 계산 | 코드 |
|---|---|---|
| 원소별 곱셈 | [1*1, 2*2, 3*3] = [1, 4, 9] |
tensor * tensor |
| 행렬 곱셈 | [1*1 + 2*2 + 3*3] = [14] |
tensor.matmul(tensor) |
tensor = torch.tensor([1, 2, 3])
print(tensor * tensor)
print(torch.matmul(tensor, tensor))
print(tensor @ tensor)
tensor([1, 4, 9])
tensor(14)
tensor(14)
파이썬 for 루프로 직접 계산해도 같은 값이 나오지만, 노트북에서 %%time으로 재 보면 루프는 약 773µs, torch.matmul()은 약 146µs가 걸렸다. 내장 연산은 벡터화되어 훨씬 빠르므로 루프는 피한다.
# 직접 계산 (비교용, 실제로는 피한다)
value = 0
for i in range(len(tensor)):
    value += tensor[i] * tensor[i]
print(value)  # tensor(14)
행렬 곱셈에는 두 가지 규칙이 있다.
- 안쪽 차원이 같아야 한다.
(3, 2) @ (3, 2)는 불가능하다.(2, 3) @ (3, 2)와(3, 2) @ (2, 3)은 가능하다.
- 결과는 바깥쪽 차원의 모양이 된다.
(2, 3) @ (3, 2)→(2, 2)(3, 2) @ (2, 3)→(3, 3)
모양 오류와 전치
딥러닝에서 가장 흔한 오류는 모양 불일치다. 행렬 곱셈의 모양 규칙이 엄격하기 때문이다.
tensor_A = torch.tensor([[1, 2],
                         [3, 4],
                         [5, 6]], dtype=torch.float32)
tensor_B = torch.tensor([[7, 10],
                         [8, 11],
                         [9, 12]], dtype=torch.float32)

torch.matmul(tensor_A, tensor_B)  # 오류
RuntimeError: mat1 and mat2 shapes cannot be multiplied (3x2 and 3x2)
두 텐서 모두 (3, 2)라 안쪽 차원(2와 3)이 맞지 않는다. 한쪽을 전치(transpose) 해서 두 차원을 맞바꾸면 해결된다. torch.transpose(input, dim0, dim1) 또는 tensor.T를 쓴다.
print(tensor_B.T)  # (3, 2) -> (2, 3)
output = torch.matmul(tensor_A, tensor_B.T)  # (3, 2) @ (2, 3) -> (3, 3)
print(output)
print(output.shape)
tensor([[ 7.,  8.,  9.],
        [10., 11., 12.]])
tensor([[ 27.,  30.,  33.],
        [ 61.,  68.,  75.],
        [ 95., 106., 117.]])
torch.Size([3, 3])
torch.mm()은 torch.matmul()의 2차원 전용 축약형이며 같은 결과를 낸다.
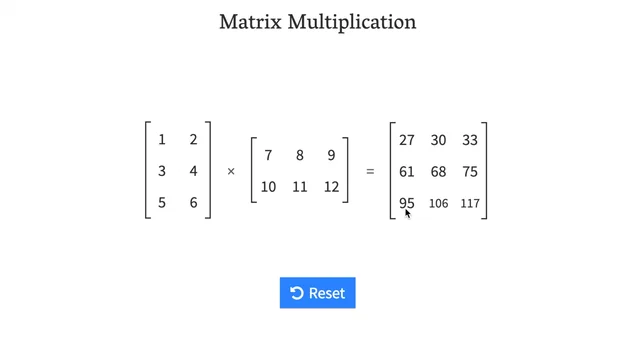
tensor_A (3, 2)와 tensor_B.T (2, 3)의 행렬 곱셈 결과. 예를 들어 결과의 왼쪽 위 원소 27은 tensor_A의 첫 행 [1, 2]와 tensor_B.T의 첫 열 [7, 10]의 내적 \(1 \cdot 7 + 2 \cdot 10\)이다. 원본은 matrixmultiplication.xyz를 녹화한 GIF이며, 여기서는 계산이 끝난 마지막 프레임을 실었다. 출처: learnpytorch.io (Daniel Bourke, MIT License).
결과의 \((i, j)\) 원소는 왼쪽 행렬의 \(i\)번째 행과 오른쪽 행렬의 \(j\)번째 열의 내적(dot product)이다. 그래서 왼쪽의 열 수와 오른쪽의 행 수, 즉 안쪽 차원이 같아야 한다.
선형 층도 행렬 곱셈이다
torch.nn.Linear() 모듈(피드포워드 층, 완전연결 층이라고도 한다)은 입력 \(x\)와 가중치 행렬 \(A\)의 행렬 곱셈을 수행한다.
- \(x\): 층의 입력. 딥러닝은 이런 층을 여러 개 쌓은 것이다.
- \(A\): 층이 만든 가중치 행렬. 무작위 값에서 시작해 학습하면서 조정된다. 전치(\(T\))가 붙어 있다는 점에 주목한다. \(W\)로 적기도 한다.
- \(b\): 편향(bias). 가중치와 입력의 곱을 조금 이동시킨다.
- \(y\): 출력.
고등학교에서 본 \(y = mx + b\)와 같은 선형 함수이며, 직선을 그릴 수 있다.
torch.manual_seed(42)  # 가중치가 무작위로 초기화되므로 재현성을 위해 시드 고정
linear = torch.nn.Linear(in_features=2,   # 입력의 안쪽 차원과 일치해야 한다
                         out_features=6)  # 출력의 바깥쪽 값
x = tensor_A                              # (3, 2)
output = linear(x)
print(f"Input shape: {x.shape}")
print(f"Output shape: {output.shape}")
Input shape: torch.Size([3, 2])
Output shape: torch.Size([3, 6])
가중치 \(A\)의 모양은 (out_features, in_features) = (6, 2)이므로 \(A^T\)는 (2, 6)이고, (3, 2) @ (2, 6) → (3, 6)이 된다. 출력 끝에 붙는 grad_fn=<AddmmBackward0>는 이 텐서가 기울기 계산을 위한 연산 기록을 갖고 있다는 표시다. in_features를 3으로 바꾸면 안쪽 차원이 맞지 않아 오류가 난다.
집계: 최솟값, 최댓값, 평균, 합
집계(aggregation) 는 많은 값을 적은 값으로 줄이는 연산이다.
x = torch.arange(0, 100, 10)
print(x)
print(f"Minimum: {x.min()}")
print(f"Maximum: {x.max()}")
# print(f"Mean: {x.mean()}")  # 오류: 정수형(int64)에는 mean을 쓸 수 없다
print(f"Mean: {x.type(torch.float32).mean()}")
print(f"Sum: {x.sum()}")
tensor([ 0, 10, 20, 30, 40, 50, 60, 70, 80, 90])
Minimum: 0
Maximum: 90
Mean: 45.0
Sum: 450
torch.arange(0, 100, 10)은 정수 인자로 만들었으므로 자료형이 torch.int64다. mean()은 부동소수점 텐서를 요구하므로 type(torch.float32)로 바꾼 뒤 계산한다. torch.max(x), torch.min(x), torch.mean(...), torch.sum(x)처럼 함수 형태로도 쓸 수 있다.
위치 기반 최솟값, 최댓값
값 자체가 아니라 최댓값, 최솟값이 있는 위치(인덱스) 가 필요할 때는 torch.argmax()와 torch.argmin()을 쓴다. 뒤에서 소프트맥스(softmax) 출력에서 가장 확률이 높은 클래스를 고를 때 사용한다.
tensor = torch.arange(10, 100, 10)
print(f"Tensor: {tensor}")
print(f"Index where max value occurs: {tensor.argmax()}")
print(f"Index where min value occurs: {tensor.argmin()}")
Tensor: tensor([10, 20, 30, 40, 50, 60, 70, 80, 90])
Index where max value occurs: 8
Index where min value occurs: 0
자료형 바꾸기
자료형 불일치 오류는 torch.Tensor.type(dtype)으로 고친다.
tensor = torch.arange(10., 100., 10.)  # 실수 인자 -> torch.float32
print(tensor.dtype)
print(tensor.type(torch.float16))
print(tensor.type(torch.int8))
torch.float32
tensor([10., 20., 30., 40., 50., 60., 70., 80., 90.], dtype=torch.float16)
tensor([10, 20, 30, 40, 50, 60, 70, 80, 90], dtype=torch.int8)
모양 바꾸기, 뷰, 쌓기
값은 그대로 두고 모양이나 차원만 바꿔야 할 때가 많다. 행렬 곱셈의 모양 규칙 때문에, 올바른 원소끼리 연산되도록 모양을 맞추는 일이 자주 필요하다.
| 메서드 | 설명 |
|---|---|
torch.reshape(input, shape) |
input을 호환되는 shape로 바꾼다. tensor.reshape()도 가능. |
tensor.view(shape) |
원래 텐서와 같은 데이터를 공유하는 다른 모양의 뷰를 반환한다. |
torch.stack(tensors, dim=0) |
같은 크기의 텐서들을 새 차원을 따라 이어 붙인다. |
torch.squeeze(input) |
크기가 1인 차원을 모두 제거한다. |
torch.unsqueeze(input, dim) |
dim 위치에 크기 1인 차원을 추가한다. |
torch.permute(input, dims) |
차원의 순서를 dims대로 재배열한 뷰를 반환한다. |
x = torch.arange(1., 8.)
print(x, x.shape)

x_reshaped = x.reshape(1, 7)  # 차원 하나 추가
print(x_reshaped, x_reshaped.shape)

z = x.view(1, 7)              # 같은 데이터를 공유하는 뷰
z[:, 0] = 5                   # 뷰를 바꾸면
print(z, x)                   # 원본 x도 바뀐다
tensor([1., 2., 3., 4., 5., 6., 7.]) torch.Size([7])
tensor([[1., 2., 3., 4., 5., 6., 7.]]) torch.Size([1, 7])
tensor([[5., 2., 3., 4., 5., 6., 7.]]) tensor([5., 2., 3., 4., 5., 6., 7.])
view()는 메모리를 복사하지 않고 같은 데이터를 다른 모양으로 바라볼 뿐이므로, 뷰를 수정하면 원본도 바뀐다. z[:, 0] = 5는 “모든 행의 0번 열을 5로”라는 뜻이다.
x_stacked = torch.stack([x, x, x, x], dim=0)  # dim=1로 바꾸면 (7, 4)
print(x_stacked, x_stacked.shape)
tensor([[5., 2., 3., 4., 5., 6., 7.],
        [5., 2., 3., 4., 5., 6., 7.],
        [5., 2., 3., 4., 5., 6., 7.],
        [5., 2., 3., 4., 5., 6., 7.]]) torch.Size([4, 7])
squeeze, unsqueeze, permute
x_squeezed = x_reshaped.squeeze()          # [1, 7] -> [7]
print(x_squeezed.shape)

x_unsqueezed = x_squeezed.unsqueeze(dim=0) # [7] -> [1, 7]
print(x_unsqueezed.shape)
torch.Size([7])
torch.Size([1, 7])
squeeze()는 크기 1인 차원을 “짜내고”, unsqueeze(dim)은 지정한 위치에 크기 1인 차원을 끼워 넣는다. unsqueeze(dim=1)이면 [7, 1]이 된다.
permute()는 축의 순서를 바꾼다. 이미지 라이브러리는 흔히 [height, width, color_channels] 순서를 쓰지만 PyTorch는 [color_channels, height, width]를 선호하므로 자주 쓰인다.
x_original = torch.rand(size=(224, 224, 3))   # [H, W, C]
x_permuted = x_original.permute(2, 0, 1)       # 새 0번 축 = 옛 2번 축, ...
print(f"Previous shape: {x_original.shape}")
print(f"New shape: {x_permuted.shape}")         # [C, H, W]
Previous shape: torch.Size([224, 224, 3])
New shape: torch.Size([3, 224, 224])
permute도 뷰를 반환하므로 원본과 데이터를 공유한다. 뷰의 값을 바꾸면 원본의 값도 바뀐다.
인덱싱
텐서 인덱싱은 파이썬 리스트, NumPy 배열과 거의 같다. 바깥 차원에서 안쪽 차원 순서로 인덱싱한다.
x = torch.arange(1, 10).reshape(1, 3, 3)
print(x, x.shape)
print(x[0])        # 첫 번째 대괄호
print(x[0][0])     # 두 번째 대괄호
print(x[0][0][0])  # 세 번째 대괄호
tensor([[[1, 2, 3],
         [4, 5, 6],
         [7, 8, 9]]]) torch.Size([1, 3, 3])
tensor([[1, 2, 3],
        [4, 5, 6],
        [7, 8, 9]])
tensor([1, 2, 3])
tensor(1)
:는 “그 차원의 모든 값”, 쉼표 ,는 다음 차원으로 넘어감을 뜻한다.
print(x[:, 0])       # 0번 차원 전부, 1번 차원의 0번 -> tensor([[1, 2, 3]])
print(x[:, :, 1])    # 0, 1번 차원 전부, 2번 차원의 1번 -> tensor([[2, 5, 8]])
print(x[:, 1, 1])    # 0번 차원 전부, 1번과 2번 차원의 1번 -> tensor([5])
print(x[0, 0, :])    # x[0][0]과 같다 -> tensor([1, 2, 3])
tensor([[1, 2, 3]])
tensor([[2, 5, 8]])
tensor([5])
tensor([1, 2, 3])
큰 텐서에서는 인덱싱이 헷갈리기 쉽다. 여러 번 시도하면서 출력을 확인하는 것(“시각화, 시각화, 시각화”)이 가장 빠른 방법이다.
PyTorch와 NumPy
torch.from_numpy(ndarray): NumPy 배열 → PyTorch 텐서tensor.numpy(): PyTorch 텐서 → NumPy 배열
import numpy as np

array = np.arange(1.0, 8.0)
tensor = torch.from_numpy(array)
print(array, tensor)

array = array + 1          # 배열을 새로 할당해도
print(array, tensor)       # 텐서는 그대로
[1. 2. 3. 4. 5. 6. 7.] tensor([1., 2., 3., 4., 5., 6., 7.], dtype=torch.float64)
[2. 3. 4. 5. 6. 7. 8.] tensor([1., 2., 3., 4., 5., 6., 7.], dtype=torch.float64)
NumPy 배열의 기본 자료형은 float64이고, 변환된 텐서도 torch.float64를 유지한다. PyTorch의 많은 연산은 float32를 기본으로 하므로 torch.from_numpy(array).type(torch.float32)로 바꿔 두는 것이 좋다. 위에서 array = array + 1은 새 배열을 만들어 이름에 다시 붙인 것이어서 텐서에 영향이 없다.
tensor = torch.ones(7)         # float32
numpy_tensor = tensor.numpy()  # float32 배열
tensor = tensor + 1
print(tensor, numpy_tensor)
tensor([2., 2., 2., 2., 2., 2., 2.]) [1. 1. 1. 1. 1. 1. 1.]
반대 방향도 마찬가지로, 텐서를 재할당해도 이미 만든 배열은 바뀌지 않는다.
재현성
신경망은 무작위 숫자에서 시작해 텐서 연산으로 그 숫자를 점점 개선한다. 컴퓨터가 만드는 무작위성은 실제로는 결정론적인 의사 난수(pseudorandomness) 다. 무작위성은 유용하지만, 실험을 반복하거나 다른 사람이 결과를 검증하려면 같은 코드에서 같은 결과가 나와야 한다. 이것이 재현성(reproducibility) 이다.
random_tensor_A = torch.rand(3, 4)
random_tensor_B = torch.rand(3, 4)
print(random_tensor_A == random_tensor_B)
tensor([[False, False, False, False],
        [False, False, False, False],
        [False, False, False, False]])
torch.manual_seed(seed)로 난수 생성기의 시드를 고정하면 무작위 값에 “맛”을 입혀 같은 값을 다시 얻을 수 있다.
RANDOM_SEED = 42

torch.manual_seed(seed=RANDOM_SEED)
random_tensor_C = torch.rand(3, 4)

torch.manual_seed(seed=RANDOM_SEED)  # rand()를 부를 때마다 다시 설정해야 같은 값이 나온다
random_tensor_D = torch.rand(3, 4)

print(random_tensor_C)
print(random_tensor_C == random_tensor_D)
tensor([[0.8823, 0.9150, 0.3829, 0.9593],
        [0.3904, 0.6009, 0.2566, 0.7936],
        [0.9408, 0.1332, 0.9346, 0.5936]])
tensor([[True, True, True, True],
        [True, True, True, True],
        [True, True, True, True]])
시드를 한 번 설정한 뒤 torch.rand()를 두 번 부르면 두 번째 호출은 난수열의 다음 값을 쓰므로 C와 D가 달라진다. 그래서 D를 만들기 전에 시드를 다시 설정했다. 더 자세한 내용은 PyTorch 재현성 문서에 있다.
GPU 사용하기
딥러닝은 수많은 수치 연산을 필요로 한다. 기본적으로는 CPU에서 계산하지만, GPU는 신경망에 필요한 연산(특히 행렬 곱셈)을 훨씬 빠르게 처리한다. 이 강의에서 “GPU”는 CUDA를 지원하는 NVIDIA GPU를 뜻한다. CUDA는 GPU를 그래픽 외의 범용 계산에 쓰게 해 주는 플랫폼이자 API다.
GPU를 얻는 방법은 크게 세 가지다.
| 방법 | 설정 난이도 | 장점 | 단점 |
|---|---|---|---|
| Google Colab | 쉬움 | 무료, 설정이 거의 없음, 링크로 공유 | 출력이 저장되지 않음, 연산량 제한, 시간 제한 |
| 개인 GPU | 보통 | 모든 것을 로컬에서 실행 | 초기 비용이 든다 |
| 클라우드(AWS, GCP, Azure) | 보통~어려움 | 초기 비용이 작고 연산량이 사실상 무한 | 계속 켜 두면 비싸고 설정에 시간이 든다 |
NVIDIA GPU가 있는지는 !nvidia-smi로, PyTorch가 GPU를 쓸 수 있는지는 torch.cuda.is_available()로 확인한다.
print(torch.cuda.is_available())   # True면 GPU 사용 가능
print(torch.cuda.device_count())   # 사용 가능한 GPU 수
True
1
Apple Silicon(M1/M2/M3) Mac에서는 torch.backends.mps로 GPU를 쓴다. torch.backends.mps.is_available()이 True면 장치 이름으로 "mps"를 쓸 수 있다.
장치 독립 코드
코드를 누가 어떤 컴퓨터에서 돌리든 동작하도록, GPU가 있으면 GPU를, 없으면 CPU를 쓰게 작성하는 것을 장치 독립 코드(device agnostic code) 라 한다. PyTorch의 권장 관행이다.
device = "cuda" if torch.cuda.is_available() else "cpu"

# Apple Silicon까지 고려하는 경우
if torch.cuda.is_available():
    device = "cuda"   # NVIDIA GPU
elif torch.backends.mps.is_available():
    device = "mps"    # Apple Silicon GPU
else:
    device = "cpu"
print(device)
텐서를 GPU로 옮기기
to(device)로 텐서(와 나중에 볼 모델)를 원하는 장치로 옮긴다. 텐서의 to()는 복사본을 반환하므로, 원래 변수를 덮어쓰려면 some_tensor = some_tensor.to(device)처럼 재할당해야 한다.
tensor = torch.tensor([1, 2, 3])        # 기본은 CPU
print(tensor, tensor.device)

tensor_on_gpu = tensor.to(device)
print(tensor_on_gpu)
tensor([1, 2, 3]) cpu
tensor([1, 2, 3], device='cuda:0')
cuda:0은 0번 GPU라는 뜻이다. GPU가 두 개면 cuda:0, cuda:1이 된다.
텐서를 CPU로 되돌리기
NumPy는 GPU를 쓰지 못하므로 GPU 위의 텐서에 바로 numpy()를 부르면 오류가 난다.
tensor_on_gpu.numpy() # 오류
TypeError: can't convert cuda:0 device type tensor to numpy. Use Tensor.cpu() to copy the tensor to host memory first.
Tensor.cpu()로 CPU 메모리에 복사한 뒤 변환한다. 원래 텐서는 여전히 GPU에 남아 있다.
tensor_back_on_cpu = tensor_on_gpu.cpu().numpy()
print(tensor_back_on_cpu)
print(tensor_on_gpu)
[1 2 3]
tensor([1, 2, 3], device='cuda:0')
정리
- 텐서는 스칼라(0차원), 벡터(1차원), 행렬(2차원), 그 이상의 n차원 배열을 모두 포괄하며, 차원 수는
ndim, 모양은shape로 확인한다. torch.rand,torch.zeros,torch.ones,torch.arange,torch.zeros_like로 텐서를 만들며, 기본 자료형은torch.float32다.- 가장 흔한 오류는 모양, 자료형, 장치의 불일치이며, 각각
shape,dtype,device로 확인한다. - 행렬 곱셈은 안쪽 차원이 같아야 하고 결과는 바깥쪽 차원의 모양이 된다. 맞지 않으면
.T로 전치한다.nn.Linear는 \(y = xA^T + b\)를 계산한다. min,max,mean,sum,argmax,argmin으로 집계하고,mean은 부동소수점 자료형이 필요하다.reshape,view,stack,squeeze,unsqueeze,permute로 값은 그대로 두고 모양을 바꾸며,view와permute는 원본과 데이터를 공유한다.torch.from_numpy와tensor.numpy()로 NumPy와 오가며, NumPy의 기본float64에 주의한다.torch.manual_seed로 재현성을 확보하고,device = "cuda" if torch.cuda.is_available() else "cpu"와to(device)로 장치 독립 코드를 작성한다.