- PyTorch for Deep Learning (Daniel Bourke, freeCodeCamp) Chapter 3 정리
- 교재: learnpytorch.io
- 코드: MIT License
지난 글에서 FashionMNIST에 선형 기준 모델(model_0, 테스트 정확도 83.4%)과 ReLU를 넣은 모델(model_1, 75.0%)을 학습했다. 이 글의 코드는 지난 글의 train_dataloader, test_dataloader, class_names, device, accuracy_fn, train_step(), test_step(), eval_model(), print_train_time()을 그대로 쓴다.
합성곱 신경망
합성곱 신경망(convolutional neural network, CNN 또는 ConvNet) 은 시각 데이터에서 패턴을 찾는 능력으로 잘 알려져 있다. 여기서 만들 모델은 CNN Explainer 웹사이트의 TinyVGG 다. 전형적인 CNN 구조를 따른다.
입력 층 -> [합성곱 층 -> 활성화 층 -> 풀링 층] -> 출력 층
대괄호 안의 묶음은 필요에 따라 키우거나 여러 번 반복할 수 있다.
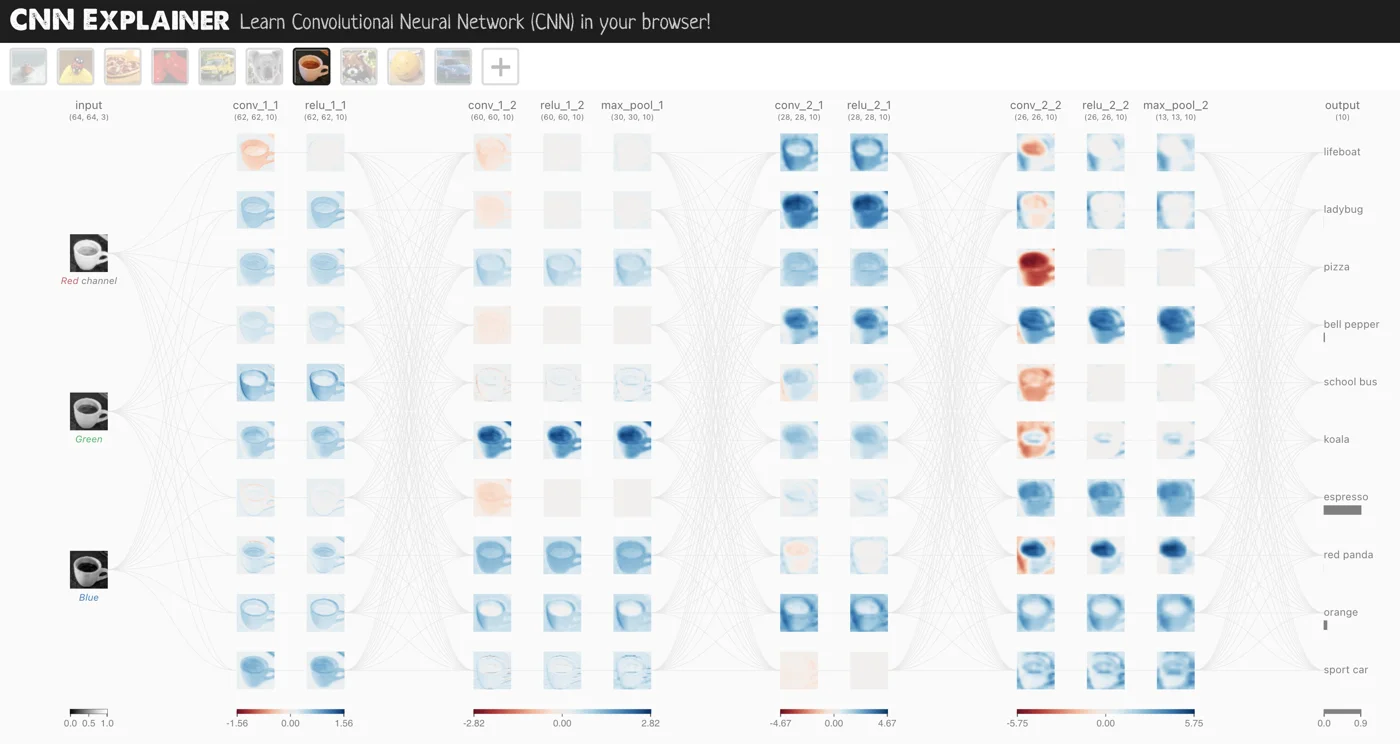 CNN Explainer 웹사이트의 TinyVGG. 왼쪽 입력(64×64×3, 커피잔 사진의 빨강/초록/파랑 채널)이 conv_1_1, relu_1_1, conv_1_2, relu_1_2, max_pool_1, conv_2_1, …, max_pool_2를 차례로 지나 오른쪽 10개 클래스 출력으로 이어진다. 출처: learnpytorch.io (Daniel Bourke, MIT License).
각 열은 한 층의 출력이고, 열마다 10개의 작은 그림이 있다. 층마다 채널(필터)이 10개라는 뜻이다. 열 위에 적힌 크기는 (62, 62, 10) → (60, 60, 10) → (30, 30, 10) → … → (13, 13, 10)으로 줄어든다. 합성곱(패딩 없음)은 가장자리를 1픽셀씩 깎고, 최대 풀링은 크기를 절반으로 줄이기 때문이다. 파란색은 양의 활성, 빨간색은 음의 활성이며, ReLU 열에서는 빨간색이 사라진다. 맨 오른쪽 출력에서는 “espresso” 막대가 가장 길다.
어떤 모델을 써야 하나
일반적인 지침은 다음과 같다(예외는 있다).
| 문제 유형 | 주로 쓰는 모델 | 코드 예 |
|---|---|---|
| 정형 데이터(스프레드시트, 행/열 데이터) | 그래디언트 부스팅, 랜덤 포레스트, XGBoost | sklearn.ensemble, XGBoost |
| 비정형 데이터(이미지, 오디오, 언어) | 합성곱 신경망, 트랜스포머 | torchvision.models, HuggingFace Transformers |
실제 선택은 문제와 제약(데이터 양, 지연 시간 요구 등)에 크게 좌우된다.
TinyVGG 구현
nn.Conv2d()와 nn.MaxPool2d()로 TinyVGG를 옮긴다. 블록 두 개와 분류기 하나로 이루어진다.
import torch
from torch import nn

class FashionMNISTModelV2(nn.Module):
    """TinyVGG (https://poloclub.github.io/cnn-explainer/) 를 따라 만든 모델"""
    def __init__(self, input_shape: int, hidden_units: int, output_shape: int):
        super().__init__()
        self.block_1 = nn.Sequential(
            nn.Conv2d(in_channels=input_shape,
                      out_channels=hidden_units,
                      kernel_size=3,  # 이미지 위를 훑는 정사각형의 크기
                      stride=1,       # 기본값
                      padding=1),     # "valid"(패딩 없음), "same"(입력과 같은 크기), 또는 정수
            nn.ReLU(),
            nn.Conv2d(in_channels=hidden_units,
                      out_channels=hidden_units,
                      kernel_size=3,
                      stride=1,
                      padding=1),
            nn.ReLU(),
            nn.MaxPool2d(kernel_size=2,
                         stride=2)    # stride 기본값은 kernel_size와 같다
        )
        self.block_2 = nn.Sequential(
            nn.Conv2d(hidden_units, hidden_units, 3, padding=1),
            nn.ReLU(),
            nn.Conv2d(hidden_units, hidden_units, 3, padding=1),
            nn.ReLU(),
            nn.MaxPool2d(2)
        )
        self.classifier = nn.Sequential(
            nn.Flatten(),
            # 7*7은 어디서 왔나? 각 층이 입력의 모양을 바꾸고 압축하기 때문이다(아래 설명)
            nn.Linear(in_features=hidden_units*7*7,
                      out_features=output_shape)
        )

    def forward(self, x: torch.Tensor):
        x = self.block_1(x)
        # print(x.shape)  # 모양이 궁금하면 주석을 푼다
        x = self.block_2(x)
        x = self.classifier(x)
        return x

torch.manual_seed(42)
model_2 = FashionMNISTModelV2(input_shape=1,          # 흑백이므로 채널 1
                              hidden_units=10,
                              output_shape=len(class_names)).to(device)
model_2
FashionMNISTModelV2(
  (block_1): Sequential(
    (0): Conv2d(1, 10, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
    (1): ReLU()
    (2): Conv2d(10, 10, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
    (3): ReLU()
    (4): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
  )
  (block_2): Sequential(
    (0): Conv2d(10, 10, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
    (1): ReLU()
    (2): Conv2d(10, 10, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
    (3): ReLU()
    (4): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
  )
  (classifier): Sequential(
    (0): Flatten(start_dim=1, end_dim=-1)
    (1): Linear(in_features=490, out_features=10, bias=True)
  )
)
in_features=hidden_units*7*7 = 490의 계산은 다음과 같다. 입력 [N, 1, 28, 28]은 kernel_size=3, padding=1 합성곱을 지나도 높이와 너비가 그대로 28이고 채널만 10이 된다. block_1 끝의 최대 풀링이 28을 14로, block_2 끝의 최대 풀링이 14를 7로 줄인다. 그래서 분류기 앞의 텐서는 [N, 10, 7, 7]이고, 펴면 490이다. 이 숫자를 손으로 계산하기 어렵다면 forward() 안의 print(x.shape) 주석을 풀고 더미 입력을 한 번 통과시켜 확인하면 된다.
어딘가에서 잘 작동하는 모델 구조를 찾아 코드로 옮기는 것은 머신러닝에서 흔한 작업 방식이다.
nn.Conv2d 뜯어보기
새로 쓴 두 층, nn.Conv2d()(합성곱 층)와 nn.MaxPool2d()(최대 풀링 층)를 하나씩 살펴본다. 이름의 “2d”는 높이와 너비라는 2차원 데이터를 다룬다는 뜻이다. 1차원 데이터(텍스트 등)에는 nn.Conv1d(), 3차원 데이터에는 nn.Conv3d()가 있다.
CNN Explainer와 같은 크기의 장난감 데이터를 만든다.
torch.manual_seed(42)

images = torch.randn(size=(32, 3, 64, 64))  # [batch_size, color_channels, height, width]
test_image = images[0]                      # 이미지 한 장
print(f"Image batch shape: {images.shape} -> [batch_size, color_channels, height, width]")
print(f"Single image shape: {test_image.shape} -> [color_channels, height, width]")
Image batch shape: torch.Size([32, 3, 64, 64]) -> [batch_size, color_channels, height, width]
Single image shape: torch.Size([3, 64, 64]) -> [color_channels, height, width]
nn.Conv2d()의 주요 인자는 다음과 같다.
in_channels: 입력 이미지의 채널 수out_channels: 합성곱이 만들어 내는 채널 수(필터 개수)kernel_size: 합성곱 커널(필터)의 크기stride: 커널이 한 번에 움직이는 칸 수. 기본값 1padding: 입력의 네 변에 덧붙이는 칸 수. 기본값 0
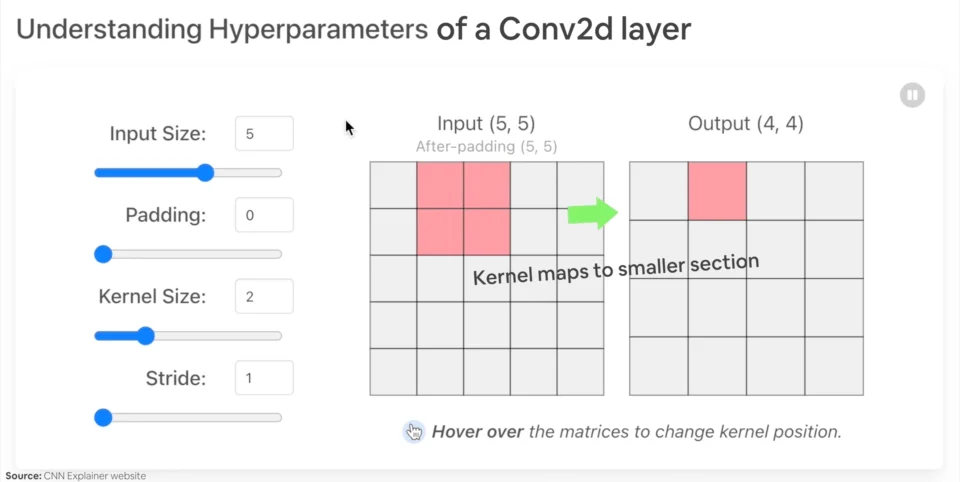 CNN Explainer의 Conv2d 하이퍼파라미터 시연(원본 GIF의 첫 프레임). 입력 크기 5, 패딩 0, 커널 크기 2, 스트라이드 1일 때 5×5 입력 위의 2×2 커널(빨간 칸)이 4×4 출력의 한 칸으로 대응한다. 출처: learnpytorch.io (Daniel Bourke, MIT License).
그림에서 2×2 커널이 입력의 작은 구역을 출력의 한 칸으로 “요약”한다. 커널이 한 칸씩(스트라이드 1) 오른쪽, 아래로 움직이며 이 계산을 반복하므로, 5×5 입력에서는 가로세로 4번씩 놓일 수 있어 4×4 출력이 나온다. 일반적으로 출력 크기는 다음과 같다.
\[H_{out} = \left\lfloor \frac{H_{in} + 2p - k}{s} \right\rfloor + 1\]여기서 \(k\)는 커널 크기, \(p\)는 패딩, \(s\)는 스트라이드다. 그림의 경우 \((5 + 0 - 2)/1 + 1 = 4\)다.
torch.manual_seed(42)
conv_layer = nn.Conv2d(in_channels=3,
                       out_channels=10,
                       kernel_size=3,
                       stride=1,
                       padding=0)

conv_layer(test_image.unsqueeze(dim=0)).shape
torch.Size([1, 10, 62, 62])
nn.Conv2d()는 (N, C, H, W) 4차원 입력을 기대한다. PyTorch 1.11 이전에는 3차원 [3, 64, 64]를 넣으면 “Expected 4-dimensional input” 오류가 났으므로, unsqueeze(dim=0)로 배치 차원을 붙여 [1, 3, 64, 64]로 만들었다(이후 버전은 배치 없는 입력도 받는다). 출력은 채널이 3에서 10으로, 크기가 \((64 - 3)/1 + 1 = 62\)로 바뀌었다. CNN Explainer의 첫 층 conv_1_1의 (62, 62, 10)과 같다.
인자를 바꾸면 모양도 바뀐다.
torch.manual_seed(42)
conv_layer_2 = nn.Conv2d(in_channels=3,
                         out_channels=10,
                         kernel_size=(5, 5),  # 튜플도 된다
                         stride=2,
                         padding=0)

conv_layer_2(test_image.unsqueeze(dim=0)).shape
torch.Size([1, 10, 30, 30])
\(\lfloor (64 - 5)/2 \rfloor + 1 = 29 + 1 = 30\)이다. 합성곱 층은 입력과 내부 매개변수 사이의 연산(합성곱)으로 이미지의 정보를 압축한다. 목표는 다른 신경망과 같다. 데이터를 넣고, 옵티마이저의 도움으로 손실이 줄어들도록 내부 매개변수(패턴)를 갱신한다. 다른 것은 forward()에서 하는 연산의 종류뿐이다.
내부 매개변수를 들여다보면 익숙한 가중치와 편향이 있다.
print(f"conv_layer_2 weight shape: \n{conv_layer_2.weight.shape} -> [out_channels=10, in_channels=3, kernel_size=5, kernel_size=5]")
print(f"\nconv_layer_2 bias shape: \n{conv_layer_2.bias.shape} -> [out_channels=10]")
conv_layer_2 weight shape:
torch.Size([10, 3, 5, 5]) -> [out_channels=10, in_channels=3, kernel_size=5, kernel_size=5]

conv_layer_2 bias shape:
torch.Size([10]) -> [out_channels=10]
출력 채널마다 입력 3채널에 걸친 5×5 필터가 하나씩, 즉 10개의 [3, 5, 5] 필터가 있고, 출력 채널마다 편향이 하나씩 있다. 처음에는 무작위 값이며 학습으로 데이터를 더 잘 표현하도록 갱신된다. kernel_size, stride 같은 값은 직접 정하는 하이퍼파라미터이므로, 여러 값을 실험하거나 TinyVGG처럼 비슷한 문제에서 잘 작동한 예를 따르면 된다.
nn.MaxPool2d 뜯어보기
print(f"Test image original shape: {test_image.shape}")
print(f"Test image with unsqueezed dimension: {test_image.unsqueeze(dim=0).shape}")

max_pool_layer = nn.MaxPool2d(kernel_size=2)

test_image_through_conv = conv_layer(test_image.unsqueeze(dim=0))
print(f"Shape after going through conv_layer(): {test_image_through_conv.shape}")

test_image_through_conv_and_max_pool = max_pool_layer(test_image_through_conv)
print(f"Shape after going through conv_layer() and max_pool_layer(): {test_image_through_conv_and_max_pool.shape}")
Test image original shape: torch.Size([3, 64, 64])
Test image with unsqueezed dimension: torch.Size([1, 3, 64, 64])
Shape after going through conv_layer(): torch.Size([1, 10, 62, 62])
Shape after going through conv_layer() and max_pool_layer(): torch.Size([1, 10, 31, 31])
kernel_size=2인 최대 풀링이 62×62를 31×31로 절반으로 줄였다. 채널 수는 바뀌지 않는다. 작은 텐서로 무슨 일이 일어나는지 본다.
torch.manual_seed(42)
random_tensor = torch.randn(size=(1, 1, 2, 2))
print(f"Random tensor:\n{random_tensor}")

max_pool_tensor = nn.MaxPool2d(kernel_size=2)(random_tensor)
print(f"\nMax pool tensor:\n{max_pool_tensor} <- random_tensor의 최댓값")
print(f"Max pool tensor shape: {max_pool_tensor.shape}")
Random tensor:
tensor([[[[0.3367, 0.1288],
          [0.2345, 0.2303]]]])

Max pool tensor:
tensor([[[[0.3367]]]]) <- random_tensor의 최댓값
Max pool tensor shape: torch.Size([1, 1, 1, 1])
2×2 구역에서 가장 큰 값 0.3367만 남기고 나머지는 버린다. 텐서의 차원은 줄이면서 정보의 중요한 부분은 (바라건대) 유지하는 것이다.
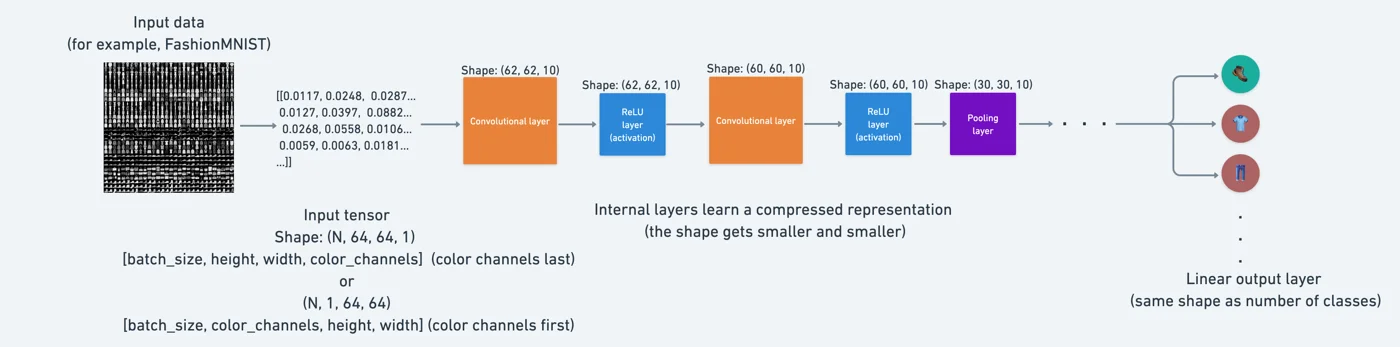 FashionMNIST 같은 입력 텐서(N, 64, 64, 1 또는 N, 1, 64, 64)가 합성곱 층 (62, 62, 10), ReLU, 합성곱 층 (60, 60, 10), ReLU, 풀링 층 (30, 30, 10)을 지나며 점점 작아지고, 마지막 선형 출력 층은 클래스 수와 같은 크기의 출력을 낸다. 출처: learnpytorch.io (Daniel Bourke, MIT License).
그림 가운데 문구처럼 내부 층들은 압축된 표현(compressed representation) 을 학습하며, 모양은 점점 작아진다. 신경망의 모든 층은 고차원 데이터를 저차원 공간으로 압축하려 한다고 볼 수 있다. 원시 숫자를 많이 받아, 원래보다 작으면서도 예측에 쓸모 있는 패턴을 찾는 것이다. 이 관점에서는 지능이 곧 압축이다. nn.MaxPool2d()는 최댓값만 남기는 방식으로, nn.Conv2d()는 합성곱 연산으로 이 압축을 수행한다.
첫 CNN 학습하기
다중 클래스 분류이므로 손실은 nn.CrossEntropyLoss(), 옵티마이저는 SGD(lr=0.1)로 앞의 모델들과 같게 둔다. 지난 글에서 만든 train_step(), test_step()을 그대로 재사용하고 시간을 잰다.
from tqdm.auto import tqdm
from timeit import default_timer as timer

loss_fn = nn.CrossEntropyLoss()
optimizer = torch.optim.SGD(params=model_2.parameters(), lr=0.1)

torch.manual_seed(42)
train_time_start_model_2 = timer()

epochs = 3
for epoch in tqdm(range(epochs)):
    print(f"Epoch: {epoch}\n---------")
    train_step(data_loader=train_dataloader, model=model_2, loss_fn=loss_fn,
               optimizer=optimizer, accuracy_fn=accuracy_fn, device=device)
    test_step(data_loader=test_dataloader, model=model_2, loss_fn=loss_fn,
              accuracy_fn=accuracy_fn, device=device)

train_time_end_model_2 = timer()
total_train_time_model_2 = print_train_time(start=train_time_start_model_2,
                                            end=train_time_end_model_2,
                                            device=device)
Epoch: 0
---------
Train loss: 0.59302 | Train accuracy: 78.41%
Test loss: 0.39771 | Test accuracy: 86.01%

Epoch: 1
---------
Train loss: 0.36149 | Train accuracy: 87.00%
Test loss: 0.35713 | Test accuracy: 87.00%

Epoch: 2
---------
Train loss: 0.32354 | Train accuracy: 88.28%
Test loss: 0.32857 | Test accuracy: 88.38%

Train time on cuda: 44.250 seconds
model_2_results = eval_model(model=model_2, data_loader=test_dataloader,
                             loss_fn=loss_fn, accuracy_fn=accuracy_fn)
model_2_results
{'model_name': 'FashionMNISTModelV2',
 'model_loss': 0.3285697102546692,
 'model_acc': 88.37859424920129}
합성곱 층과 최대 풀링 층 덕분에 테스트 정확도가 88.4%로 올랐다.
모델 결과와 학습 시간 비교
세 모델을 학습했다.
model_0: 선형 층 두 개뿐인 기준 모델model_1: 기준 모델의 선형 층 사이에nn.ReLU()를 넣은 모델model_2: TinyVGG를 따라 만든 첫 CNN
여러 모델로 실험하고 가장 나은 것을 고르는 것은 머신러닝의 일상적인 과정이다. 결과 사전들을 pandas DataFrame으로 모은다.
import pandas as pd
compare_results = pd.DataFrame([model_0_results, model_1_results, model_2_results])
compare_results["training_time"] = [total_train_time_model_0,
                                    total_train_time_model_1,
                                    total_train_time_model_2]
compare_results
            model_name  model_loss  model_acc  training_time
0  FashionMNISTModelV0    0.476639  83.426518      32.348722
1  FashionMNISTModelV1    0.685001  75.019968      36.877976
2  FashionMNISTModelV2    0.328570  88.378594      44.249765
CNN이 손실은 가장 낮고 정확도는 가장 높지만 학습 시간도 가장 길다. 이것이 성능-속도 트레이드오프(performance-speed tradeoff) 다. 크고 복잡한 모델은 대체로 성능이 좋지만 학습과 추론 속도를 희생한다. 학습 시간은 하드웨어에 크게 좌우되며, 코어가 많고 최신일수록 빠르다.
import matplotlib.pyplot as plt
compare_results.set_index("model_name")["model_acc"].plot(kind="barh")
plt.xlabel("accuracy (%)")
plt.ylabel("model")
무작위 테스트 샘플 예측
가장 좋은 model_2를 더 자세히 평가한다. 샘플 목록을 받아 예측 확률을 돌려주는 함수를 만든다.
def make_predictions(model: torch.nn.Module, data: list, device: torch.device = device):
    pred_probs = []
    model.eval()
    with torch.inference_mode():
        for sample in data:
            # [1, 28, 28] -> [1, 1, 28, 28]: 배치 차원 추가 후 장치로 이동
            sample = torch.unsqueeze(sample, dim=0).to(device)

            pred_logit = model(sample)  # [1, 10] 로짓

            # squeeze로 [10]을 만든 뒤 클래스 차원(dim=0)에서 softmax
            pred_prob = torch.softmax(pred_logit.squeeze(), dim=0)

            pred_probs.append(pred_prob.cpu())  # 이후 계산(matplotlib 등)을 위해 CPU로

    return torch.stack(pred_probs)  # 텐서 리스트 -> [샘플 수, 10] 텐서
배치 크기가 1이라 squeeze() 후에는 클래스 차원만 남으므로 dim=0에서 softmax를 계산한다. 배치 차원이 있는 [N, 10]이라면 dim=1이어야 한다.
import random
random.seed(42)
test_samples, test_labels = [], []
for sample, label in random.sample(list(test_data), k=9):  # 테스트 세트에서 무작위 9개
    test_samples.append(sample)
    test_labels.append(label)

print(f"Test sample image shape: {test_samples[0].shape}\nTest sample label: {test_labels[0]} ({class_names[test_labels[0]]})")

pred_probs = make_predictions(model=model_2, data=test_samples)
pred_probs[:2]
Test sample image shape: torch.Size([1, 28, 28])
Test sample label: 5 (Sandal)
tensor([[2.4012e-07, 6.5406e-08, 4.8069e-08, 2.1070e-07, 1.4175e-07, 9.9992e-01,
         2.1711e-07, 1.6177e-05, 3.7849e-05, 2.7548e-05],
        [1.5646e-02, 8.9752e-01, 3.6928e-04, 6.7402e-02, 1.2920e-02, 4.9539e-05,
         5.6485e-03, 1.9456e-04, 2.0808e-04, 3.7861e-05]])
첫 샘플은 인덱스 5(Sandal)에 0.9999의 확률을 주었다. argmax로 레이블을 얻는다.
pred_classes = pred_probs.argmax(dim=1)
test_labels, pred_classes
([5, 1, 7, 4, 3, 0, 4, 7, 1], tensor([5, 1, 7, 4, 3, 0, 4, 7, 1]))
예측 시각화
“시각화하고, 시각화하고, 또 시각화하라.” 예측이 맞으면 초록, 틀리면 빨강 제목으로 3×3 격자를 그린다.
plt.figure(figsize=(9, 9))
nrows, ncols = 3, 3
for i, sample in enumerate(test_samples):
    plt.subplot(nrows, ncols, i + 1)
    plt.imshow(sample.squeeze(), cmap="gray")

    pred_label = class_names[pred_classes[i]]   # 예: "Sandal"
    truth_label = class_names[test_labels[i]]
    title_text = f"Pred: {pred_label} | Truth: {truth_label}"

    if pred_label == truth_label:
        plt.title(title_text, fontsize=10, c="g")  # 맞으면 초록
    else:
        plt.title(title_text, fontsize=10, c="r")  # 틀리면 빨강
    plt.axis(False)
9개 모두 맞혔다. 수십 줄의 PyTorch 코드로 얻은 결과다.
혼동 행렬
분류 평가 지표 중 가장 시각적인 것이 혼동 행렬(confusion matrix) 이다. 모델이 어떤 클래스를 어떤 클래스와 헷갈리는지 보여 준다. 세 단계로 만든다.
- 학습된
model_2로 테스트 세트 전체를 예측한다. torchmetrics.ConfusionMatrix로 혼동 행렬을 계산한다.mlxtend.plotting.plot_confusion_matrix()로 그린다.
# 1. 테스트 세트 전체 예측
y_preds = []
model_2.eval()
with torch.inference_mode():
    for X, y in tqdm(test_dataloader, desc="Making predictions"):
        X, y = X.to(device), y.to(device)
        y_logit = model_2(X)
        # 배치 크기가 32이므로 클래스 차원은 dim=1
        y_pred = torch.softmax(y_logit, dim=1).argmax(dim=1)
        y_preds.append(y_pred.cpu())  # 평가용으로 CPU에 모은다

y_pred_tensor = torch.cat(y_preds)  # 배치별 텐서 리스트 -> [10000] 텐서
torch.cat은 기존 차원을 따라 이어 붙이고(313개의 [32] 또는 [16] → [10000]), 앞의 torch.stack은 새 차원을 만들어 쌓는다는 점이 다르다. 그다음 torchmetrics와 mlxtend(0.19.0 이상)가 필요하다(pip install torchmetrics -U mlxtend).
from torchmetrics import ConfusionMatrix
from mlxtend.plotting import plot_confusion_matrix

# 2. 혼동 행렬 계산: 예측과 정답 비교
confmat = ConfusionMatrix(num_classes=len(class_names), task="multiclass")
confmat_tensor = confmat(preds=y_pred_tensor,
                         target=test_data.targets)

# 3. 그리기
fig, ax = plot_confusion_matrix(
    conf_mat=confmat_tensor.numpy(),  # matplotlib은 NumPy를 선호한다
    class_names=class_names,          # 행/열 레이블을 클래스 이름으로
    figsize=(10, 7)
)
진한 칸이 대부분 왼쪽 위에서 오른쪽 아래로 가는 대각선에 몰려 있다. 이상적인 모델은 대각선에만 값이 있고 나머지는 0이다. 모델이 가장 많이 헷갈리는 것은 비슷한 클래스들이다. 실제로는 “Shirt”인 이미지를 “Pullover”로, “T-shirt/top”인 이미지를 “Shirt”로 예측하는 경우가 많다.
이런 정보는 정확도 숫자 하나보다 유용하다. 모델이 어디서 틀리는지, 그리고 왜 틀리는지에 대한 단서를 주기 때문이다. 셔츠와 티셔츠는 사람이 봐도 헷갈릴 만하므로, 모델의 문제인지 데이터 레이블의 문제인지 살펴볼 근거가 된다.
모델 저장과 불러오기
PyTorch 4에서 본 세 함수를 쓴다.
torch.save: 모델 전체나state_dict()를 저장한다.torch.load: 저장한 PyTorch 객체를 불러온다.torch.nn.Module.load_state_dict(): 저장한state_dict()를 기존 모델 인스턴스에 넣는다.
from pathlib import Path

MODEL_PATH = Path("models")
MODEL_PATH.mkdir(parents=True,   # 필요하면 상위 폴더도 만든다
                 exist_ok=True)  # 이미 있어도 오류를 내지 않는다

MODEL_NAME = "03_pytorch_computer_vision_model_2.pth"
MODEL_SAVE_PATH = MODEL_PATH / MODEL_NAME

print(f"Saving model to: {MODEL_SAVE_PATH}")
torch.save(obj=model_2.state_dict(),  # 학습된 매개변수만 저장
           f=MODEL_SAVE_PATH)
Saving model to: models/03_pytorch_computer_vision_model_2.pth
state_dict()만 저장했으므로, 불러올 때는 같은 하이퍼파라미터로 새 인스턴스를 만든 뒤 넣어야 한다. 예를 들어 hidden_units=128로 만들면 가중치 모양이 맞지 않아 오류가 난다.
loaded_model_2 = FashionMNISTModelV2(input_shape=1,
                                     hidden_units=10,
                                     output_shape=10)
loaded_model_2.load_state_dict(torch.load(f=MODEL_SAVE_PATH))
loaded_model_2 = loaded_model_2.to(device)

torch.manual_seed(42)
loaded_model_2_results = eval_model(model=loaded_model_2, data_loader=test_dataloader,
                                    loss_fn=loss_fn, accuracy_fn=accuracy_fn)
loaded_model_2_results
{'model_name': 'FashionMNISTModelV2',
 'model_loss': 0.3285697102546692,
 'model_acc': 88.37859424920129}
model_2_results와 같다. 두 값이 충분히 가까운지는 torch.isclose()에 절대 허용 오차(atol)와 상대 허용 오차(rtol)를 주어 확인한다.
torch.isclose(torch.tensor(model_2_results["model_loss"]),
              torch.tensor(loaded_model_2_results["model_loss"]),
              atol=1e-08,   # 절대 허용 오차
              rtol=0.0001)  # 상대 허용 오차
tensor(True)
정리
- CNN은
[합성곱 -> 활성화 -> 풀링]묶음을 반복한 뒤 분류기로 끝난다. TinyVGG는 이런 묶음 두 개와Flatten -> Linear분류기로 이루어진다. nn.Conv2d의 출력 크기는 \(\lfloor (H + 2p - k)/s \rfloor + 1\)이고, 가중치 모양은[out_channels, in_channels, k, k]다.kernel_size=3, padding=1이면 크기가 유지된다.nn.MaxPool2d(kernel_size=2)는 2×2 구역마다 최댓값만 남겨 높이와 너비를 절반으로 줄인다. 신경망의 층들은 입력을 더 작고 예측에 쓸모 있는 표현으로 압축한다.- 분류기의
in_features(FashionMNIST에서 10×7×7 = 490)는 층을 지나며 바뀌는 모양으로 정해진다. 헷갈리면 더미 입력을 통과시켜 모양을 출력해 본다. - FashionMNIST에서 CNN은 88.4%로 기준 모델(83.4%)과 ReLU 모델(75.0%)을 앞섰지만 학습 시간은 가장 길었다(성능-속도 트레이드오프).
- 혼동 행렬은 모델이 셔츠/티셔츠/풀오버처럼 비슷한 클래스를 헷갈린다는 것을 보여 주며, 정확도 하나보다 많은 정보를 준다.
state_dict()를torch.save로 저장하고, 같은 구조의 새 인스턴스에load_state_dict(torch.load(...))로 불러온 뒤torch.isclose로 결과가 같은지 확인한다.