- PyTorch for Deep Learning (Daniel Bourke, freeCodeCamp) Chapter 3 정리
- 교재: learnpytorch.io
- 코드: MIT License
컴퓨터 비전이란
컴퓨터 비전(computer vision) 은 컴퓨터가 보도록 가르치는 분야다. 사진이 고양이인지 개인지 고르는 이진 분류, 고양이/개/닭 중 하나를 고르는 다중 클래스 분류, 영상 프레임에서 자동차의 위치를 찾는 객체 탐지(object detection), 이미지 속 물체들을 영역별로 나누는 분할(segmentation) 등이 모두 컴퓨터 비전 문제다. 스마트폰 카메라의 보정, 자동차의 차선 유지, 공장의 불량 검출, 보안 카메라의 침입 감지에도 쓰인다. 시각적으로 기술할 수 있는 것은 무엇이든 컴퓨터 비전 문제가 될 수 있다.
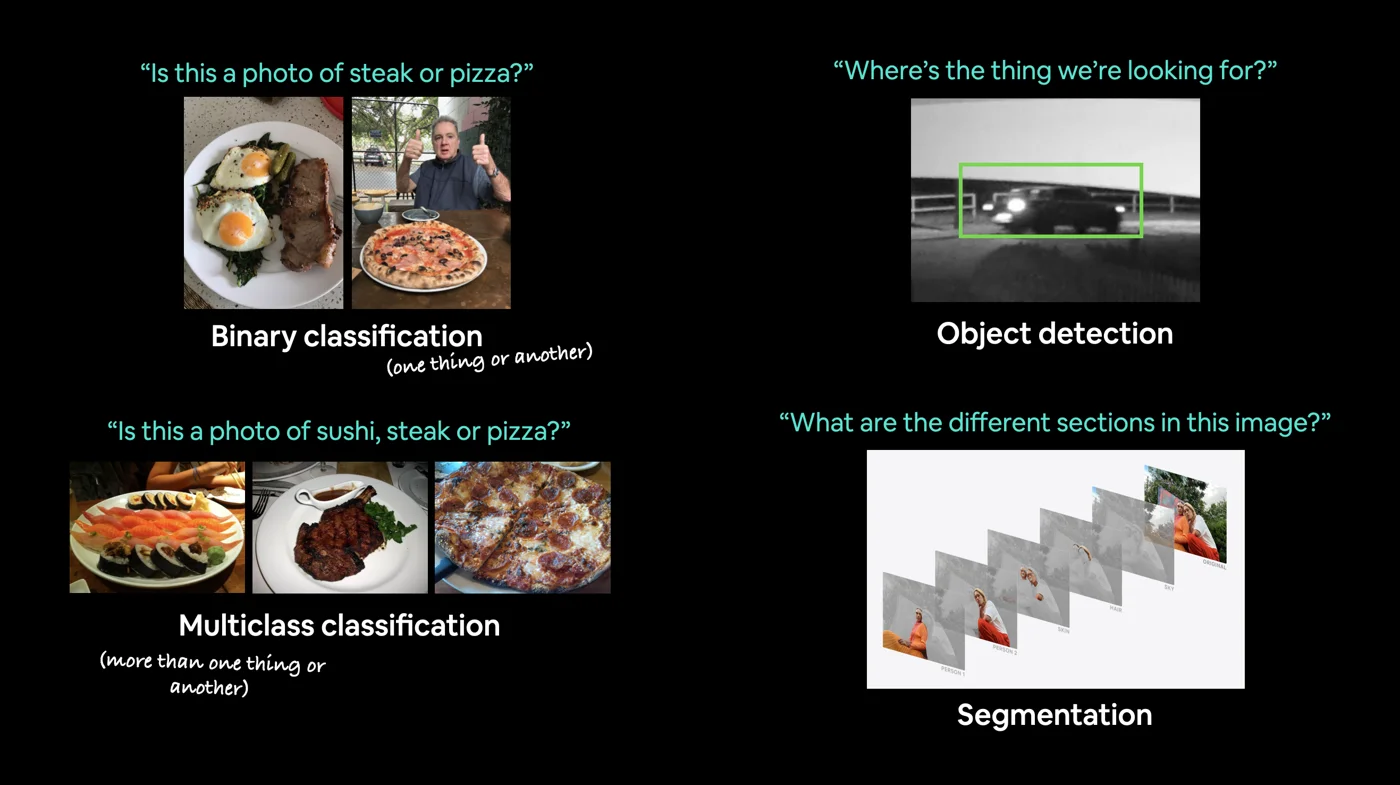 컴퓨터 비전 문제의 네 가지 예. 왼쪽 위는 스테이크와 피자를 가르는 이진 분류, 왼쪽 아래는 초밥/스테이크/피자 중 하나를 고르는 다중 클래스 분류, 오른쪽 위는 야간 카메라 영상에서 자동차를 상자로 찾는 객체 탐지, 오른쪽 아래는 사진을 사람, 피부, 머리카락, 하늘 등의 층으로 나누는 분할이다. 출처: learnpytorch.io (Daniel Bourke, MIT License).
이번 장에서는 지금까지 익힌 PyTorch 워크플로를 컴퓨터 비전에 그대로 적용한다.
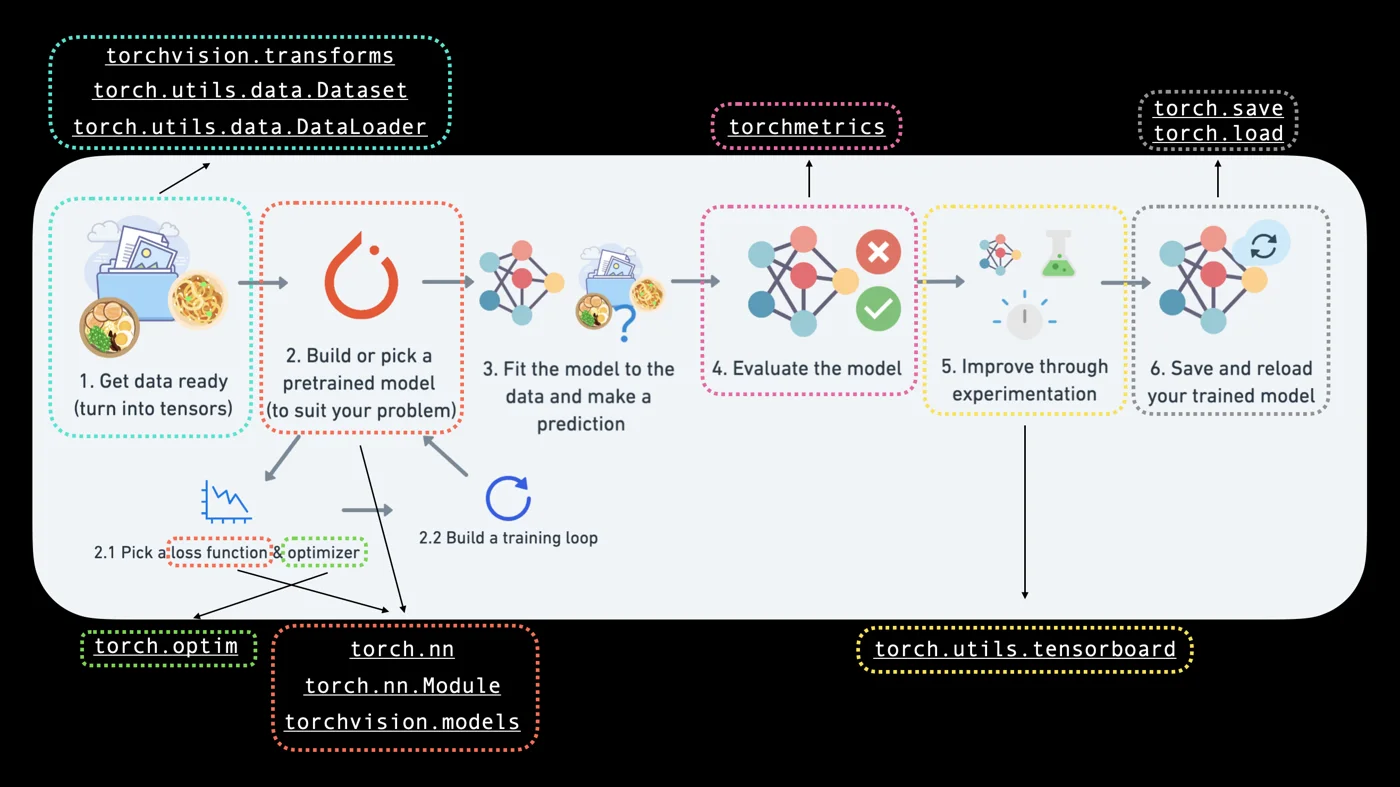 컴퓨터 비전 관점에서 본 PyTorch 워크플로. 1단계 데이터 준비에는
torchvision.transforms, Dataset, DataLoader가, 2단계 모델 구성에는 torch.nn, torchvision.models가, 2.1단계 손실/옵티마이저에는 torch.optim이, 4단계 평가에는 torchmetrics가, 6단계 저장에는 torch.save/torch.load가 대응한다. 출처: learnpytorch.io (Daniel Bourke, MIT License).
입력과 출력
어떤 문제든 전제는 같다. 데이터를 숫자(텐서)로 인코딩하고, 모델이 그 숫자에서 패턴을 찾고, 그 패턴을 의미 있는 출력(예측 확률)으로 바꾼다. 이미지라면 픽셀 값이 입력 텐서가 되고, 출력은 클래스마다 하나씩인 예측 확률 벡터가 된다. 구체적인 모양은 아래 1.1절에서 확인한다.
합성곱 신경망 미리 보기
이미지에서 패턴을 찾는 데 특히 강한 구조가 합성곱 신경망(convolutional neural network, CNN) 이다. 이번 글에서는 먼저 선형 층만 쓴 기준 모델을 만들고, CNN은 다음 글에서 직접 구현한다.
PyTorch의 컴퓨터 비전 라이브러리
| 모듈 | 역할 |
|---|---|
torchvision |
컴퓨터 비전용 데이터셋, 모델 구조, 이미지 변환을 모은 라이브러리 |
torchvision.datasets |
분류, 탐지, 캡셔닝 등 다양한 예제 데이터셋과 사용자 데이터셋용 기반 클래스 |
torchvision.models |
성능 좋은 대표적 비전 모델 구조(사전 학습 가중치 포함) |
torchvision.transforms |
이미지를 숫자로 바꾸고, 가공하고, 증강하는 변환 |
torch.utils.data.Dataset |
PyTorch의 기본 데이터셋 클래스 |
torch.utils.data.DataLoader |
Dataset을 순회 가능한(iterable) 미니배치 묶음으로 만든다 |
Dataset과 DataLoader는 이미지 전용이 아니라 텍스트, 오디오 등 모든 데이터에 쓴다.
import torch
from torch import nn

import torchvision
from torchvision import datasets
from torchvision.transforms import ToTensor

import matplotlib.pyplot as plt

print(f"PyTorch version: {torch.__version__}\ntorchvision version: {torchvision.__version__}")
PyTorch version: 2.0.1+cu118
torchvision version: 0.15.2+cu118
데이터셋 가져오기: FashionMNIST
원조 MNIST(Modified National Institute of Standards and Technology)는 손글씨 숫자 0~9 데이터셋으로, 우편 번호 인식 모델을 만드는 데 쓰였다. Zalando Research가 만든 FashionMNIST 는 같은 형식(28×28 흑백)이지만 숫자 대신 10종류의 옷 이미지를 담고 있다. 클래스가 10개이므로 다중 클래스 분류 문제다.
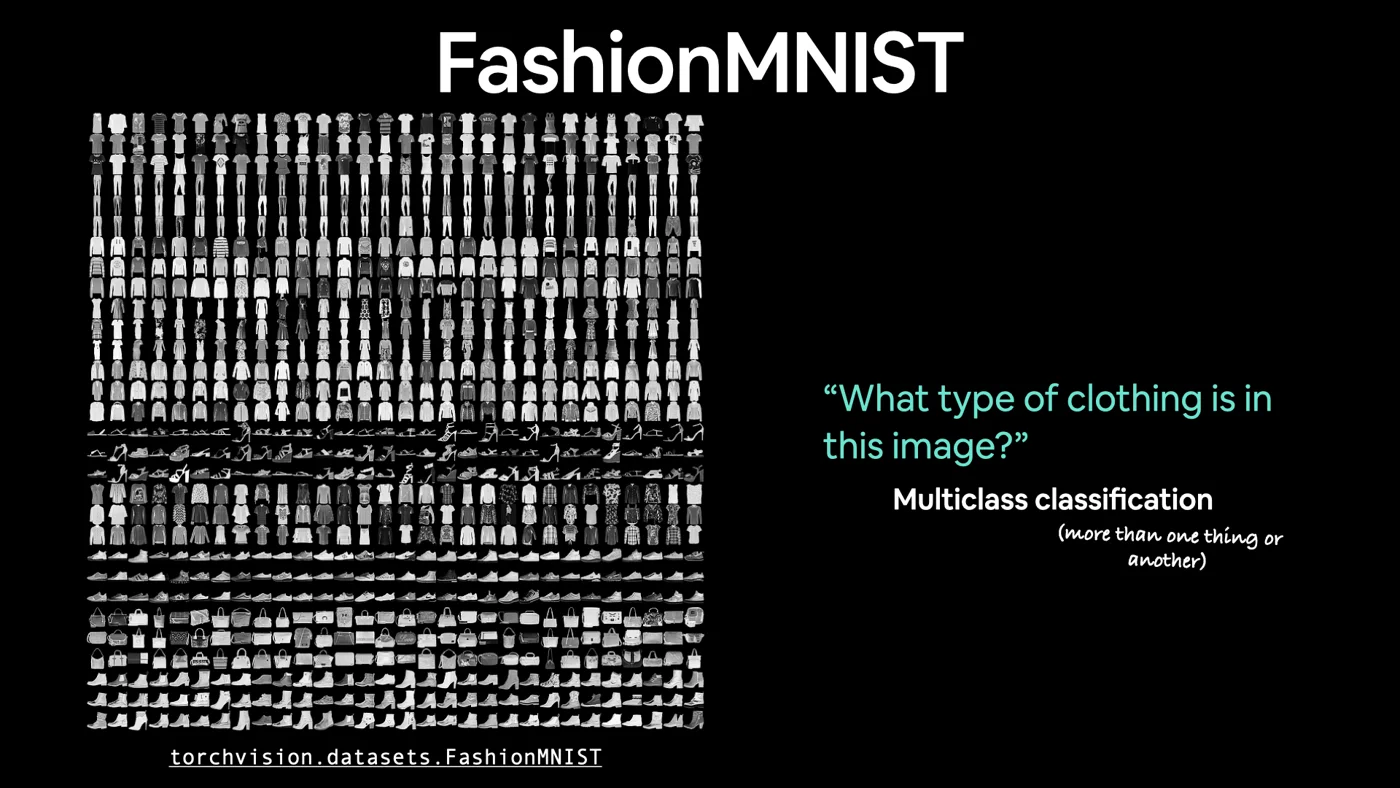 FashionMNIST 이미지들을 격자로 늘어놓은 모습. 위쪽은 티셔츠, 바지, 풀오버, 드레스, 코트, 가운데는 샌들과 셔츠, 아래쪽은 운동화, 가방, 앵클부츠가 클래스별로 줄지어 있다. “이 이미지 속 옷은 어떤 종류인가?”를 묻는 다중 클래스 분류 문제이며
torchvision.datasets.FashionMNIST로 불러온다. 출처: learnpytorch.io (Daniel Bourke, MIT License).
torchvision.datasets.FashionMNIST()에는 다음 인자를 준다(다른 torchvision 데이터셋도 대부분 같다).
root: 데이터를 내려받을 폴더train:True면 학습 세트,False면 테스트 세트download: 디스크에 없으면 내려받을지 여부transform: 데이터(이미지)에 적용할 변환target_transform: 레이블에 적용할 변환
train_data = datasets.FashionMNIST(
    root="data",
    train=True,
    download=True,
    transform=ToTensor(),   # PIL 이미지 -> 0~1 범위의 float32 텐서
    target_transform=None   # 레이블은 그대로
)

test_data = datasets.FashionMNIST(
    root="data",
    train=False,
    download=True,
    transform=ToTensor()
)

image, label = train_data[0]  # (이미지 텐서, 정수 레이블) 튜플
ToTensor()는 0~255 정수 픽셀을 0.0~1.0 실수로 바꾸고, 축 순서를 [채널, 높이, 너비]로 맞춘다.
1.1 컴퓨터 비전 모델의 입력과 출력 모양
image.shape
torch.Size([1, 28, 28])
모양은 [color_channels=1, height=28, width=28]이다. 채널이 1이므로 흑백(grayscale)이고, 컬러라면 빨강/초록/파랑 값을 담는 3채널(RGB)이 된다. 채널이 앞에 오는 이 순서를 CHW(Channels, Height, Width)라 하고, 채널이 뒤에 오면 HWC라 한다. 배치 차원 N(이미지 개수)까지 붙이면 NCHW 또는 NHWC가 된다. 예를 들어 batch_size=32면 [32, 1, 28, 28]이다.
PyTorch는 많은 연산에서 NCHW(채널 먼저)를 기본으로 받는다. 다만 PyTorch 문서는 메모리 배치 면에서 NHWC(channels last)가 더 빠르다고 설명한다. 지금처럼 작은 데이터셋과 모델에서는 차이가 거의 없다.
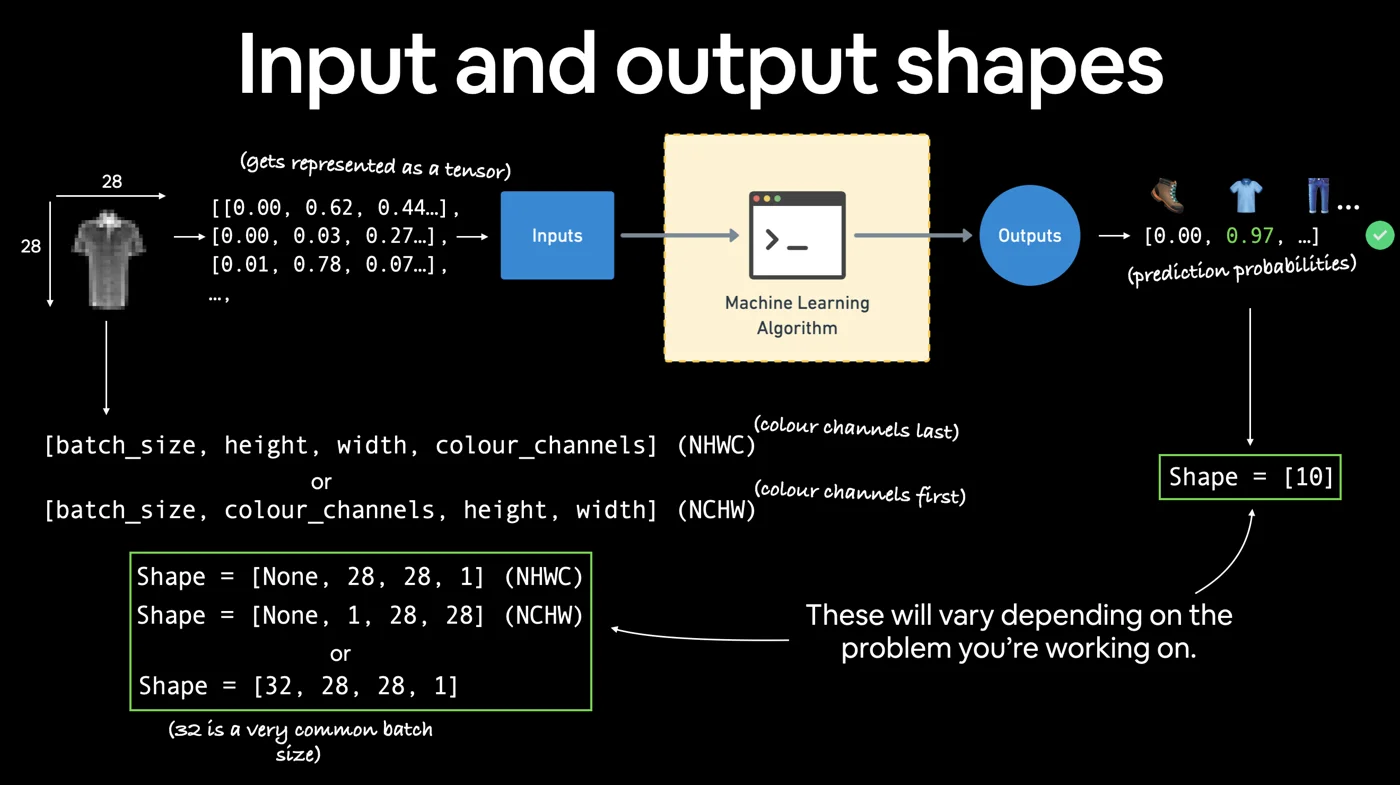 28×28 흑백 셔츠 이미지가 텐서로 표현되어 머신러닝 알고리즘에 들어가고, 출력으로 클래스별 예측 확률(모양
[10])이 나온다. 입력 모양은 NHWC인 [None, 28, 28, 1] 또는 NCHW인 [None, 1, 28, 28]로 쓸 수 있고, 배치 크기 32가 흔하다. 출처: learnpytorch.io (Daniel Bourke, MIT License).
그림에서 None 자리는 배치 크기로, 실행 시점에 정해진다. 입력과 출력 모양은 문제마다 달라지지만, “데이터를 숫자로 인코딩하고, 패턴을 찾고, 의미 있는 출력으로 바꾼다”는 흐름은 같다.
len(train_data.data), len(train_data.targets), len(test_data.data), len(test_data.targets)
(60000, 60000, 10000, 10000)
class_names = train_data.classes
class_names
['T-shirt/top',
 'Trouser',
 'Pullover',
 'Dress',
 'Coat',
 'Sandal',
 'Shirt',
 'Sneaker',
 'Bag',
 'Ankle boot']
학습 샘플 6만 장, 테스트 샘플 1만 장, 클래스 10개다.
1.2 데이터 시각화
image, label = train_data[0]
plt.imshow(image.squeeze(), cmap="gray")  # [1, 28, 28] -> [28, 28]
plt.title(class_names[label])
plt.imshow()는 [H, W] 또는 [H, W, C]를 기대하므로, 채널 차원 1을 squeeze()로 없앤다. cmap="gray"로 흑백으로 그린다. 첫 샘플은 앵클부츠다. 무작위 16장을 격자로 그려 본다.
torch.manual_seed(42)
fig = plt.figure(figsize=(9, 9))
rows, cols = 4, 4
for i in range(1, rows * cols + 1):
    random_idx = torch.randint(0, len(train_data), size=[1]).item()  # 무작위 인덱스 하나
    img, label = train_data[random_idx]
    fig.add_subplot(rows, cols, i)
    plt.imshow(img.squeeze(), cmap="gray")
    plt.title(class_names[label])
    plt.axis(False)
셔츠, 티셔츠, 풀오버, 코트처럼 서로 비슷해 보이는 클래스가 있다는 점을 기억해 두자. 이 데이터를 직선만으로 모델링할 수 있을지, 비선형성이 필요할지도 생각해 볼 만하다.
DataLoader와 미니배치
다음 단계는 데이터를 torch.utils.data.DataLoader로 준비하는 것이다. DataLoader는 큰 Dataset을 작은 묶음인 배치(batch) 또는 미니배치(mini-batch) 로 나눈 Python 순회 객체로 바꾼다. 묶음 크기는 batch_size로 정한다.
배치로 나누는 이유는 두 가지다.
- 계산 효율. 6만 장을 한 번에 순전파/역전파하려면 메모리가 매우 많이 든다. 작은 묶음으로 나누면 한정된 하드웨어로도 처리할 수 있다.
- 더 잦은 갱신. 미니배치마다 경사하강법을 한 번 수행하므로, 에폭당 한 번이 아니라 에폭당 (배치 수)번 매개변수를 갱신한다.
배치 크기는 하이퍼파라미터다. 32가 많은 문제에서 좋은 출발점이며, 보통 2의 거듭제곱(32, 64, 128, 256, 512)을 쓴다.
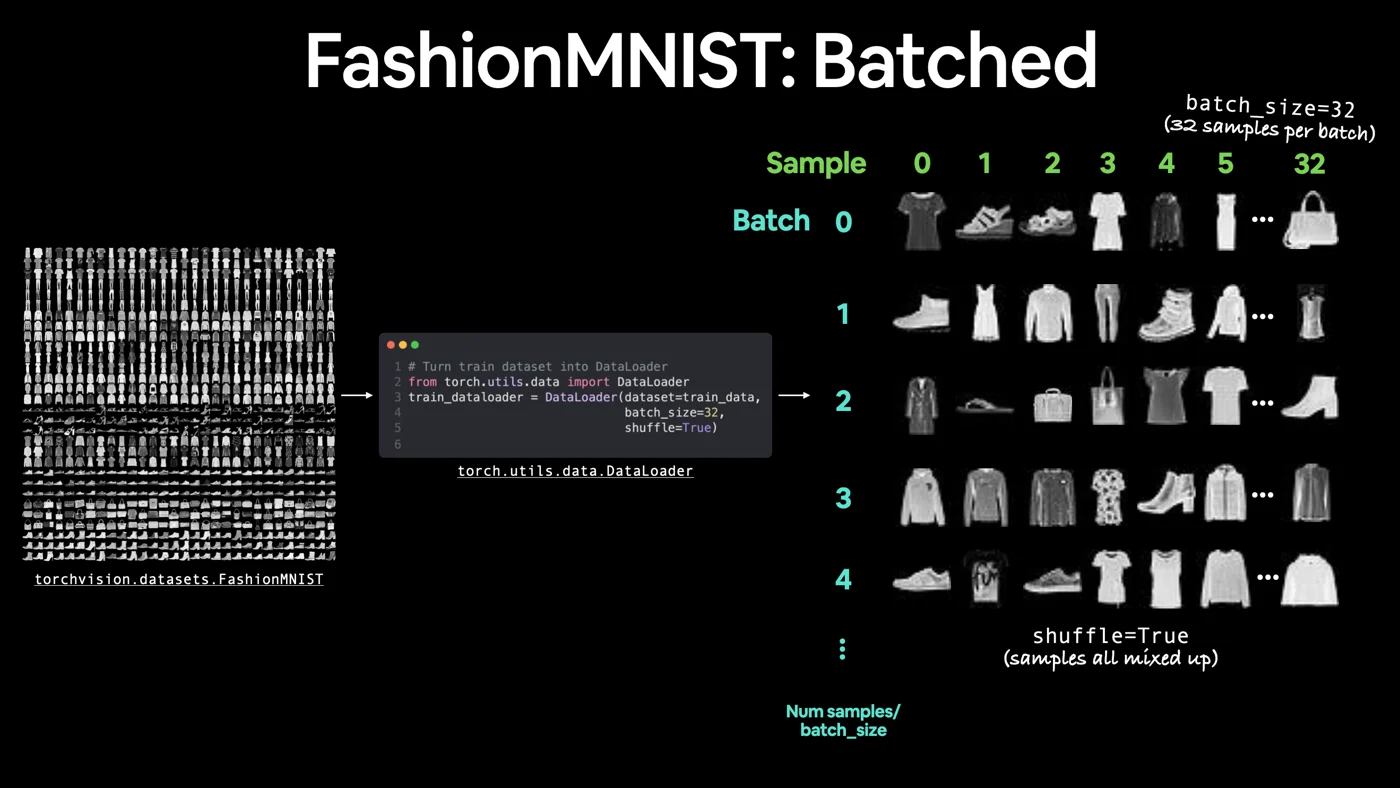 왼쪽의 FashionMNIST 데이터셋이
DataLoader(dataset=train_data, batch_size=32, shuffle=True)를 거쳐, 오른쪽처럼 샘플 32장씩 묶인 배치 0, 1, 2, …로 나뉜다. shuffle=True라서 각 배치 안의 옷 종류가 뒤섞여 있고, 배치 개수는 (샘플 수 / 배치 크기)다. 출처: learnpytorch.io (Daniel Bourke, MIT License).
DataLoader 만들기
from torch.utils.data import DataLoader

BATCH_SIZE = 32

train_dataloader = DataLoader(train_data,
                              batch_size=BATCH_SIZE,
                              shuffle=True)   # 에폭마다 순서를 섞는다

test_dataloader = DataLoader(test_data,
                             batch_size=BATCH_SIZE,
                             shuffle=False)  # 평가용은 섞을 필요가 없다

print(f"Length of train dataloader: {len(train_dataloader)} batches of {BATCH_SIZE}")
print(f"Length of test dataloader: {len(test_dataloader)} batches of {BATCH_SIZE}")
Length of train dataloader: 1875 batches of 32
Length of test dataloader: 313 batches of 32
60000 / 32 = 1875, 10000 / 32 = 312.5이므로 테스트 쪽 마지막 배치는 16장짜리이고 배치 수는 313이다. 학습 데이터를 섞는 이유는 모델이 데이터의 순서(예: 같은 클래스가 연달아 나오는 것)를 학습하지 않게 하기 위해서다.
train_features_batch, train_labels_batch = next(iter(train_dataloader))
train_features_batch.shape, train_labels_batch.shape
(torch.Size([32, 1, 28, 28]), torch.Size([32]))
iter()로 순회자를 만들고 next()로 첫 배치를 꺼냈다. 이미지 배치는 NCHW 모양 [32, 1, 28, 28], 레이블은 [32]다. 배치 안의 한 샘플을 꺼내면 다시 [1, 28, 28] 이미지와 스칼라 레이블이 된다.
Model 0: 기준 모델
기준 모델(baseline model) 은 상상할 수 있는 가장 단순한 모델이다. 이것을 출발점으로 두고 더 복잡한 모델이 실제로 나아지는지 비교한다.
이미지를 nn.Linear에 넣으려면 먼저 nn.Flatten()으로 높이와 너비 차원을 하나의 긴 특성 벡터(feature vector) 로 펴야 한다.
flatten_model = nn.Flatten()  # nn 모듈은 모두 순전파를 할 수 있는 "모델"이다

x = train_features_batch[0]
output = flatten_model(x)

print(f"Shape before flattening: {x.shape} -> [color_channels, height, width]")
print(f"Shape after flattening: {output.shape} -> [color_channels, height*width]")
Shape before flattening: torch.Size([1, 28, 28]) -> [color_channels, height, width]
Shape after flattening: torch.Size([1, 784]) -> [color_channels, height*width]
nn.Flatten()은 기본적으로 첫 차원(배치 차원)을 남기고 나머지를 편다. 그래서 단일 이미지 [1, 28, 28]에서는 채널 차원 1이 배치처럼 남아 [1, 784]가 되고, 배치 [32, 1, 28, 28]에서는 [32, 784]가 된다. 28 × 28 = 784개 픽셀 각각이 특성 하나가 된다.
class FashionMNISTModelV0(nn.Module):
    def __init__(self, input_shape: int, hidden_units: int, output_shape: int):
        super().__init__()
        self.layer_stack = nn.Sequential(
            nn.Flatten(),  # [N, 1, 28, 28] -> [N, 784]
            nn.Linear(in_features=input_shape, out_features=hidden_units),
            nn.Linear(in_features=hidden_units, out_features=output_shape)
        )

    def forward(self, x):
        return self.layer_stack(x)

torch.manual_seed(42)
model_0 = FashionMNISTModelV0(input_shape=784,                  # 픽셀마다 하나 (28x28)
                              hidden_units=10,                  # 은닉 유닛 수
                              output_shape=len(class_names))    # 클래스마다 하나
model_0.to("cpu")  # CPU와 GPU 속도를 비교하려고 일단 CPU에 둔다
FashionMNISTModelV0(
  (layer_stack): Sequential(
    (0): Flatten(start_dim=1, end_dim=-1)
    (1): Linear(in_features=784, out_features=10, bias=True)
    (2): Linear(in_features=10, out_features=10, bias=True)
  )
)
손실 함수, 옵티마이저, 평가 지표
10개 클래스 분류이므로 손실은 nn.CrossEntropyLoss(), 옵티마이저는 SGD(lr=0.1)이다. 정확도는 강의 저장소의 helper_functions.py에 담긴 accuracy_fn(지난 글에서 만든 함수와 동일)을 쓴다. torchmetrics.Accuracy를 써도 된다.
from helper_functions import accuracy_fn

loss_fn = nn.CrossEntropyLoss()  # "criterion", "cost function"이라고도 부른다
optimizer = torch.optim.SGD(params=model_0.parameters(), lr=0.1)
실험 시간 측정 함수
머신러닝에서는 성능뿐 아니라 학습 시간도 중요한 비교 대상이다. Python의 timeit.default_timer()로 시간을 재는 작은 함수를 만든다.
from timeit import default_timer as timer

def print_train_time(start: float, end: float, device: torch.device = None):
    """start와 end 사이의 경과 시간(초)을 출력하고 반환한다."""
    total_time = end - start
    print(f"Train time on {device}: {total_time:.3f} seconds")
    return total_time
배치 단위 학습/테스트 루프
데이터가 배치로 나뉘었으므로 에폭 루프 안에 배치 루프가 하나 더 들어간다. 손실과 정확도도 배치마다 계산되므로, 에폭이 끝나면 배치 수로 나눠 배치당 평균을 구한다.
- 에폭을 반복한다.
- 학습 배치를 반복하며 학습 단계를 수행하고 배치별 학습 손실을 누적한다.
- 테스트 배치를 반복하며 테스트 단계를 수행하고 배치별 테스트 손실과 정확도를 누적한다.
- 진행 상황을 출력한다.
- 전체 시간을 잰다.
from tqdm.auto import tqdm  # 진행 막대

torch.manual_seed(42)
train_time_start_on_cpu = timer()

epochs = 3  # 빠르게 실험하려고 작게 둔다

for epoch in tqdm(range(epochs)):
    print(f"Epoch: {epoch}\n-------")
    ### 학습
    train_loss = 0
    for batch, (X, y) in enumerate(train_dataloader):
        model_0.train()
        y_pred = model_0(X)            # 1. 순전파: [32, 10] 로짓
        loss = loss_fn(y_pred, y)      # 2. 배치 손실
        train_loss += loss             #    에폭 손실에 누적
        optimizer.zero_grad()          # 3
        loss.backward()                # 4
        optimizer.step()               # 5. 배치마다 갱신

        if batch % 400 == 0:
            print(f"Looked at {batch * len(X)}/{len(train_dataloader.dataset)} samples")

    train_loss /= len(train_dataloader)  # 배치당 평균 손실

    ### 테스트
    test_loss, test_acc = 0, 0
    model_0.eval()
    with torch.inference_mode():
        for X, y in test_dataloader:
            test_pred = model_0(X)
            test_loss += loss_fn(test_pred, y)
            test_acc += accuracy_fn(y_true=y, y_pred=test_pred.argmax(dim=1))  # 로짓 -> 레이블

        # 평균 계산도 inference_mode 안에서 한다
        test_loss /= len(test_dataloader)
        test_acc /= len(test_dataloader)

    print(f"\nTrain loss: {train_loss:.5f} | Test loss: {test_loss:.5f}, Test acc: {test_acc:.2f}%\n")

train_time_end_on_cpu = timer()
total_train_time_model_0 = print_train_time(start=train_time_start_on_cpu,
                                            end=train_time_end_on_cpu,
                                            device=str(next(model_0.parameters()).device))
Epoch: 0
-------
Looked at 0/60000 samples
Looked at 12800/60000 samples
Looked at 25600/60000 samples
Looked at 38400/60000 samples
Looked at 51200/60000 samples

Train loss: 0.59039 | Test loss: 0.50954, Test acc: 82.04%

Epoch: 1
-------
...
Train loss: 0.47633 | Test loss: 0.47989, Test acc: 83.20%

Epoch: 2
-------
...
Train loss: 0.45503 | Test loss: 0.47664, Test acc: 83.43%

Train time on cpu: 32.349 seconds
test_pred.argmax(dim=1)은 softmax를 거치지 않고 로짓에서 바로 레이블을 구한 것이다(softmax는 순서를 바꾸지 않는다). next(model_0.parameters()).device는 모델의 첫 매개변수가 놓인 장치를 알려 준다. 선형 층 두 개뿐인 기준 모델이 CPU에서 3 에폭 만에 테스트 정확도 83.4%를 얻었다.
예측과 Model 0 결과
여러 모델을 같은 방식으로 평가하기 위해, 모델과 DataLoader를 받아 손실과 정확도를 사전으로 반환하는 함수를 만든다.
torch.manual_seed(42)
def eval_model(model: torch.nn.Module,
               data_loader: torch.utils.data.DataLoader,
               loss_fn: torch.nn.Module,
               accuracy_fn):
    """data_loader에 대한 model의 예측 결과를 사전으로 반환한다."""
    loss, acc = 0, 0
    model.eval()
    with torch.inference_mode():
        for X, y in data_loader:
            y_pred = model(X)
            loss += loss_fn(y_pred, y)
            acc += accuracy_fn(y_true=y, y_pred=y_pred.argmax(dim=1))
        loss /= len(data_loader)
        acc /= len(data_loader)
    return {"model_name": model.__class__.__name__,  # 클래스로 만든 모델일 때만 동작
            "model_loss": loss.item(),
            "model_acc": acc}

model_0_results = eval_model(model=model_0, data_loader=test_dataloader,
                             loss_fn=loss_fn, accuracy_fn=accuracy_fn)
model_0_results
{'model_name': 'FashionMNISTModelV0',
 'model_loss': 0.47663894295692444,
 'model_acc': 83.42651757188499}
loss.item()으로 단일 값 텐서를 Python 숫자로 바꿔 둔다. 이 사전을 뒤에서 다른 모델의 결과와 비교한다.
장치에 독립적인 코드
이제 GPU가 있으면 GPU를 쓰도록 장치에 독립적인(device-agnostic) 코드를 준비한다. Google Colab이라면 Runtime -> Change runtime type -> Hardware accelerator -> GPU로 GPU를 켠다(런타임이 초기화되므로 위 셀을 다시 실행해야 한다).
device = "cuda" if torch.cuda.is_available() else "cpu"
device
'cuda'
학습 시간은 하드웨어에 크게 좌우된다. 대체로 프로세서가 많을수록, 모델과 데이터가 작을수록 빠르다.
Model 1: 비선형성 추가
지난 글에서 본 비선형성의 힘을 FashionMNIST에도 시험한다. 기준 모델과 똑같이 두되 각 선형 층 뒤에 nn.ReLU()만 추가한다. 한 번에 하나만 바꾸고 결과를 보는 것이 실험의 기본이다.
class FashionMNISTModelV1(nn.Module):
    def __init__(self, input_shape: int, hidden_units: int, output_shape: int):
        super().__init__()
        self.layer_stack = nn.Sequential(
            nn.Flatten(),
            nn.Linear(in_features=input_shape, out_features=hidden_units),
            nn.ReLU(),
            nn.Linear(in_features=hidden_units, out_features=output_shape),
            nn.ReLU()
        )

    def forward(self, x: torch.Tensor):
        return self.layer_stack(x)

torch.manual_seed(42)
model_1 = FashionMNISTModelV1(input_shape=784,
                              hidden_units=10,
                              output_shape=len(class_names)).to(device)  # GPU로
next(model_1.parameters()).device
device(type='cuda', index=0)
loss_fn = nn.CrossEntropyLoss()
optimizer = torch.optim.SGD(params=model_1.parameters(), lr=0.1)
학습/테스트 루프 함수화
같은 루프를 계속 다시 쓰는 대신 함수로 만든다. train_step()은 모델, DataLoader, 손실 함수, 옵티마이저를 받아 한 에폭을 학습하고, test_step()은 옵티마이저 없이 한 에폭을 평가한다. 이번에는 장치 독립적으로 동작하도록 각 배치의 X, y를 device로 옮긴다.
def train_step(model: torch.nn.Module,
               data_loader: torch.utils.data.DataLoader,
               loss_fn: torch.nn.Module,
               optimizer: torch.optim.Optimizer,
               accuracy_fn,
               device: torch.device = device):
    train_loss, train_acc = 0, 0
    model.to(device)
    model.train()
    for batch, (X, y) in enumerate(data_loader):
        X, y = X.to(device), y.to(device)   # 데이터를 모델과 같은 장치로

        y_pred = model(X)                   # 1. 순전파
        loss = loss_fn(y_pred, y)           # 2. 손실
        train_loss += loss
        train_acc += accuracy_fn(y_true=y, y_pred=y_pred.argmax(dim=1))

        optimizer.zero_grad()               # 3
        loss.backward()                     # 4
        optimizer.step()                    # 5

    train_loss /= len(data_loader)
    train_acc /= len(data_loader)
    print(f"Train loss: {train_loss:.5f} | Train accuracy: {train_acc:.2f}%")

def test_step(data_loader: torch.utils.data.DataLoader,
              model: torch.nn.Module,
              loss_fn: torch.nn.Module,
              accuracy_fn,
              device: torch.device = device):
    test_loss, test_acc = 0, 0
    model.to(device)
    model.eval()
    with torch.inference_mode():
        for X, y in data_loader:
            X, y = X.to(device), y.to(device)
            test_pred = model(X)
            test_loss += loss_fn(test_pred, y)
            test_acc += accuracy_fn(y_true=y, y_pred=test_pred.argmax(dim=1))
        test_loss /= len(data_loader)
        test_acc /= len(data_loader)
        print(f"Test loss: {test_loss:.5f} | Test accuracy: {test_acc:.2f}%\n")
에폭 루프 안에서 두 함수를 번갈아 부른다. 테스트 단계를 매 에폭 할지, 5 에폭이나 10 에폭마다 할지는 선택이다.
torch.manual_seed(42)
train_time_start_on_gpu = timer()

epochs = 3
for epoch in tqdm(range(epochs)):
    print(f"Epoch: {epoch}\n---------")
    train_step(data_loader=train_dataloader, model=model_1, loss_fn=loss_fn,
               optimizer=optimizer, accuracy_fn=accuracy_fn)
    test_step(data_loader=test_dataloader, model=model_1, loss_fn=loss_fn,
              accuracy_fn=accuracy_fn)

train_time_end_on_gpu = timer()
total_train_time_model_1 = print_train_time(start=train_time_start_on_gpu,
                                            end=train_time_end_on_gpu,
                                            device=device)
Epoch: 0
---------
Train loss: 1.09199 | Train accuracy: 61.34%
Test loss: 0.95636 | Test accuracy: 65.00%

Epoch: 1
---------
Train loss: 0.78101 | Train accuracy: 71.93%
Test loss: 0.72227 | Test accuracy: 73.91%

Epoch: 2
---------
Train loss: 0.67027 | Train accuracy: 75.94%
Test loss: 0.68500 | Test accuracy: 75.02%

Train time on cuda: 36.878 seconds
GPU를 썼는데 오히려 더 느리다. 데이터셋과 모델이 이렇게 작으면, CPU 메모리에서 GPU 메모리로 데이터를 복사하는 비용이 GPU의 연산 이점보다 클 수 있다. 큰 모델과 큰 데이터에서는 GPU의 이점이 복사 비용을 훨씬 넘어선다. 결과는 사용하는 CPU/GPU에 따라 다르다.
장치 불일치 오류와 eval_model 수정
앞에서 만든 eval_model()을 그대로 model_1에 쓰면 오류가 난다.
RuntimeError: Expected all tensors to be on the same device, but found at least two devices, cuda:0 and cpu!
모델은 GPU에 있는데 eval_model()은 데이터를 CPU에 둔 채 모델에 넣기 때문이다. device 인자를 받아 데이터를 옮기도록 고친다.
torch.manual_seed(42)
def eval_model(model: torch.nn.Module,
               data_loader: torch.utils.data.DataLoader,
               loss_fn: torch.nn.Module,
               accuracy_fn,
               device: torch.device = device):
    loss, acc = 0, 0
    model.eval()
    with torch.inference_mode():
        for X, y in data_loader:
            X, y = X.to(device), y.to(device)  # 추가된 줄
            y_pred = model(X)
            loss += loss_fn(y_pred, y)
            acc += accuracy_fn(y_true=y, y_pred=y_pred.argmax(dim=1))
        loss /= len(data_loader)
        acc /= len(data_loader)
    return {"model_name": model.__class__.__name__,
            "model_loss": loss.item(),
            "model_acc": acc}

model_1_results = eval_model(model=model_1, data_loader=test_dataloader,
                             loss_fn=loss_fn, accuracy_fn=accuracy_fn, device=device)
model_1_results, model_0_results
({'model_name': 'FashionMNISTModelV1',
  'model_loss': 0.6850008964538574,
  'model_acc': 75.01996805111821},
 {'model_name': 'FashionMNISTModelV0',
  'model_loss': 0.47663894295692444,
  'model_acc': 83.42651757188499})
이 경우에는 비선형성을 넣은 모델이 기준 모델보다 나빴다(75.0% vs 83.4%). 될 것 같던 것이 안 되고, 안 될 것 같던 것이 되는 일은 머신러닝에서 흔하다. 노트북은 이를 학습 데이터에 대한 과적합(overfitting), 즉 학습 데이터의 패턴은 익히지만 테스트 데이터로 일반화하지 못하는 상태로 본다. 과적합을 줄이는 대표적인 방법은 두 가지다.
- 더 작거나 다른 모델을 쓴다(어떤 모델은 특정 종류의 데이터에 더 잘 맞는다).
- 더 큰 데이터셋을 쓴다(데이터가 많을수록 일반화되는 패턴을 배울 기회가 많다).
다음 글에서는 1번, 즉 이미지에 맞는 다른 모델인 CNN을 시도한다.
정리
- 컴퓨터 비전은 분류, 객체 탐지, 분할 등 시각 데이터를 다루는 문제이며,
torchvision은 데이터셋(datasets), 모델(models), 변환(transforms)을 제공한다. - FashionMNIST는 28×28 흑백 옷 이미지 6만/1만 장, 10개 클래스로 이루어진 다중 클래스 분류 데이터셋이다.
ToTensor()로 0~1 범위[1, 28, 28]텐서가 된다. - PyTorch 이미지 텐서는 기본적으로
NCHW(배치, 채널, 높이, 너비) 순서이며,matplotlib으로 그릴 때는 채널 차원을 없애거나 뒤로 보내야 한다. DataLoader는 데이터셋을 미니배치(보통 32)로 나눠 메모리 문제를 피하고 에폭당 갱신 횟수를 늘린다. 학습 데이터만shuffle=True로 섞는다.- 기준 모델은
nn.Flatten()으로 784차원 벡터를 만든 뒤 선형 층 두 개로 분류하며, 3 에폭 만에 테스트 정확도 83.4%를 얻었다. - 배치 학습에서는 손실과 정확도를 배치마다 누적한 뒤 배치 수로 나눈다. 반복되는 루프는
train_step()/test_step()/eval_model()로 함수화하고, 모든 텐서를device로 옮겨 장치 불일치 오류를 막는다. - 작은 모델과 데이터에서는 GPU가 더 느릴 수 있다. ReLU를 넣은 모델은 오히려 75.0%로 기준 모델보다 나빴고, 이는 다른 모델(CNN)을 시도할 이유가 된다.