- UC Berkeley CS 182 (Spring 2021) 4강 정리
- 강의: Sergey Levine
- 관련 Discussion: Discussion 2
경사하강법과 손실 지형
경사하강법 복습
경사하강법(gradient descent)은 각 차원마다 기울기의 반대 방향으로 조금씩 움직인다.
\[\theta_{k+1} = \theta_k - \alpha \nabla_\theta \mathcal{L}(\theta_k)\]손실의 등고선(level set contour) 위에서 경로를 그려 보면(Gabriel Goh의 distill.pub 글 “Why Momentum Really Works” 기반 시각화), 경사하강법이 항상 최적점을 향해 움직이지는 않는다는 것을 알 수 있다. 그래디언트는 등고선에 수직인 방향, 즉 가장 가파른 방향을 가리키는데, 길쭉한 골짜기에서는 그 방향이 최적점과 크게 어긋난다. 가장 가파른 방향이 항상 최선은 아니다.
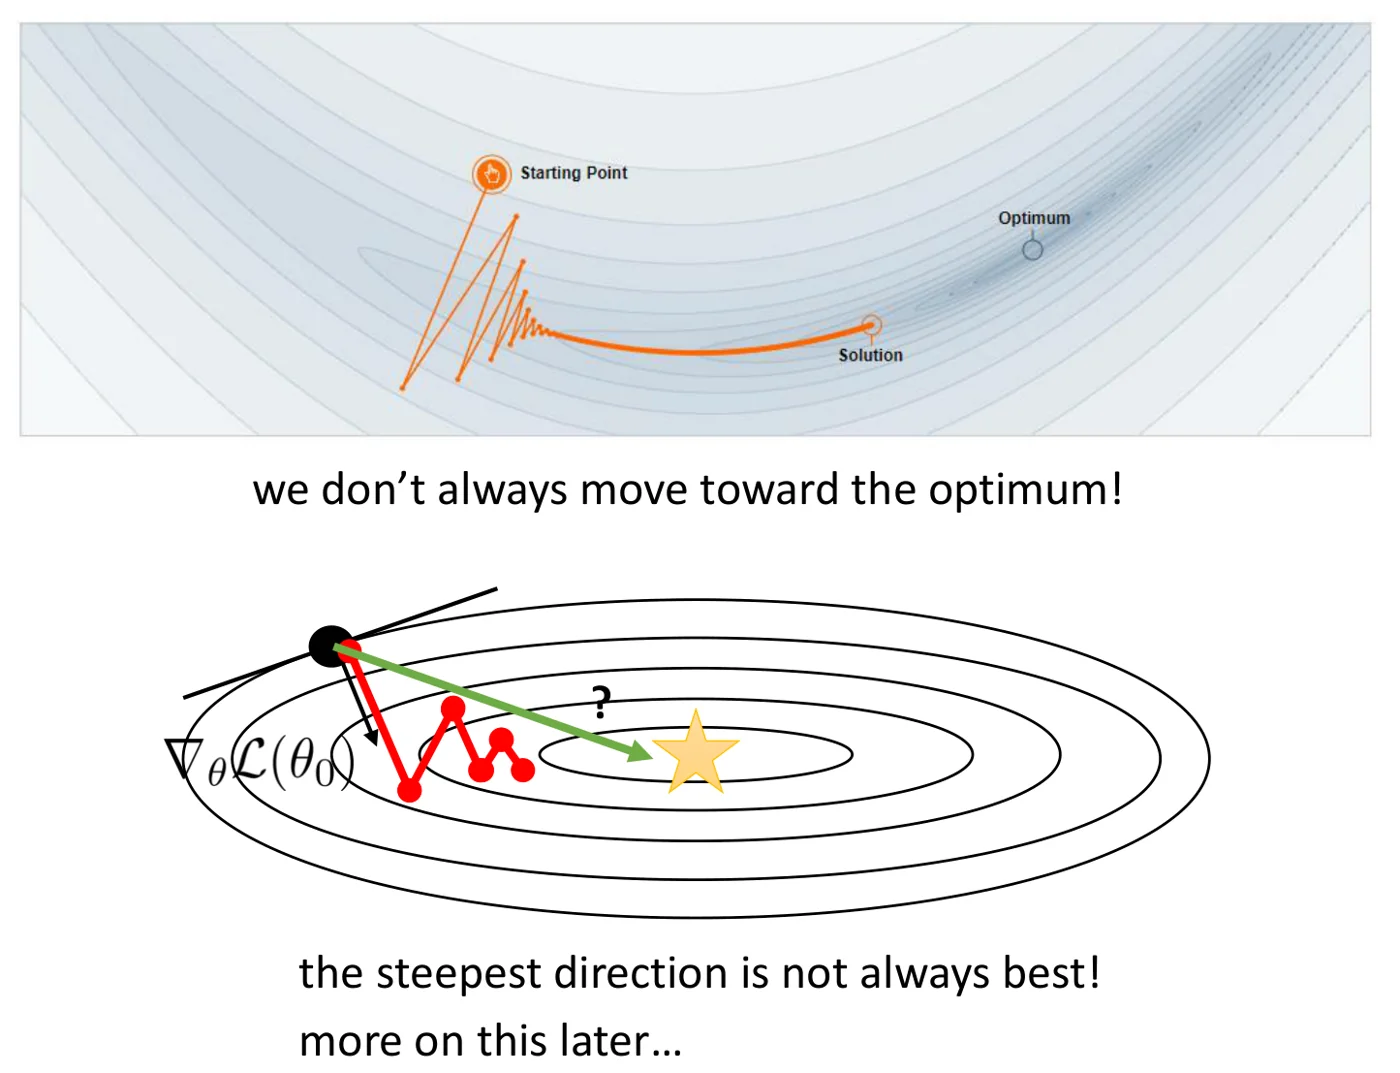 위는 길쭉한 골짜기 모양의 손실에서 경사하강법이 지나간 경로(시작점에서 지그재그로 진동한 뒤 골짜기 바닥을 따라 천천히 이동), 아래는 같은 현상을 타원 등고선으로 단순화한 그림이다. 출처: CS 182 Lecture 4 slides (시각화: distill.pub/2017/momentum).
위 그림에서 주황색 경로는 시작점에서 출발해 골짜기의 양쪽 벽 사이를 몇 번 크게 오가다가, 진동이 잦아든 뒤에야 골짜기 바닥을 따라 최적점 쪽으로 움직인다. 정해진 반복 횟수가 끝났을 때 도달한 “Solution”은 여전히 “Optimum”에서 꽤 떨어져 있다. 아래 그림은 이유를 보여 준다. 검은 점에서의 그래디언트 \(\nabla_\theta \mathcal{L}(\theta_0)\)는 그 점을 지나는 등고선의 접선(검은 직선)에 수직이다. 등고선이 길쭉한 타원이면 이 방향은 타원의 짧은 축 쪽을 향하므로, 별표로 표시한 최적점을 곧장 가리키는 초록 화살표와 크게 어긋난다. 그 결과 빨간 경로처럼 골짜기를 가로질러 지그재그로 움직인다.
볼록 함수
모든 길이 최적점으로 이어지는 손실 지형은 다루기 좋다. 함수가 볼록(convex) 하다는 것은 그래프 위 두 점을 잇는 선분이 항상 그래프 “위”에 놓인다는 뜻이다. 볼록 함수에서는 경사하강법 같은 단순한 알고리즘도 강한 보장을 가진다. 다만 그렇다고 해서 모든 볼록 함수에서 경사하강법이 빠르게 작동한다는 뜻은 아니다.
로지스틱 회귀의 음의 로그우도 손실은 볼록함이 보장된다. 이는 자명한 사실이 아니다.
신경망의 손실 지형
신경망은 매개변수가 매우 많아 손실 지형을 시각화하기 어렵지만, 저차원 단면을 그려 보면 훨씬 험난하다. 다만 어떤 구조의 네트워크는 상대적으로 매끄러운 지형을 가진다. 비볼록(non-convex) 지형의 주요 지형지물은 세 가지다.
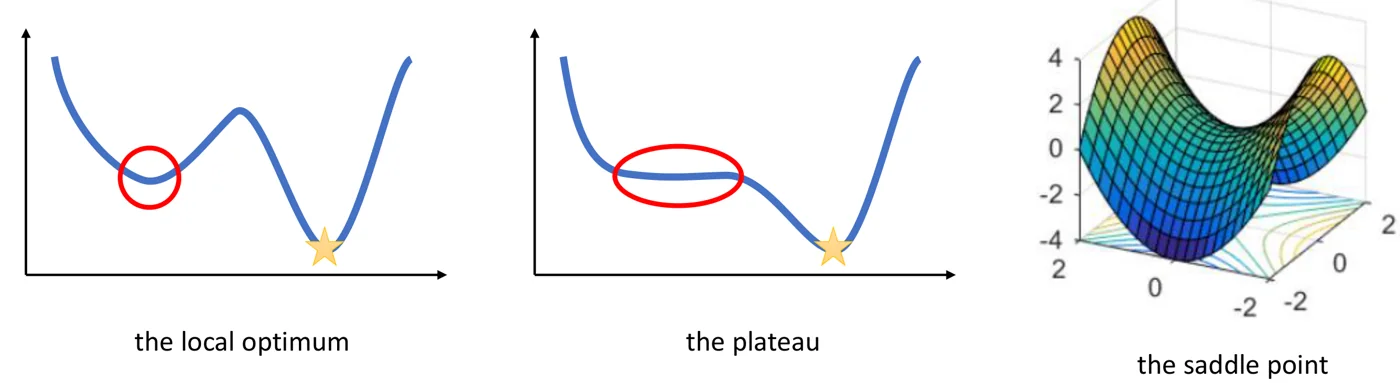 비볼록 손실 지형의 세 가지 지형지물. 왼쪽은 국소 최적점(빨간 원), 가운데는 평탄 구간(빨간 타원), 오른쪽은 안장점이다. 별표는 전역 최적점이다. 출처: CS 182 Lecture 4 slides.
세 그림 모두 경사하강법이 별표에 도달하지 못하게 막는 지점을 표시한다. 왼쪽 그림의 빨간 원 안에서는 그래디언트가 0이고 주변이 모두 오르막이므로, 작은 스텝으로는 빠져나올 수 없다. 가운데 그림의 평탄 구간은 엄밀한 최소점은 아니지만 그래디언트가 매우 작아 스텝도 매우 작아진다. 오른쪽 안장점은 한 방향(앞뒤)으로는 아래로 볼록하고 다른 방향(좌우)으로는 위로 볼록하다. 가운데 점에서는 그래디언트가 0이므로, 좌우로 내려가는 길이 있는데도 그 근처에서 오랫동안 머물게 된다.
국소 최적점(local optimum). 가장 명백한 문제이며, 과거 사람들이 신경망을 꺼린 큰 이유였다. 원리상으로는 경사하강법이 전역 최적점보다 임의로 나쁜 해에 수렴할 수 있으므로 무섭다. 그런데 다소 놀랍게도, 매개변수 수가 늘어날수록 이 문제는 덜 심각해진다. 큰 네트워크에도 국소 최적점은 있지만 전역 최적점보다 크게 나쁘지 않은 경향이 있다(Choromanska et al., “The Loss Surface of Multilayer Networks”).
평탄 구간(plateau). 그래디언트가 거의 0인 넓고 평평한 영역이다. 진동을 막으려고 학습률을 아주 작게 하면 평탄 구간에서 빠져나오지 못한다. 학습률이 평탄 구간을 지날 만큼 커야 한다. 뒤에서 볼 모멘텀이 여기서 크게 도움이 된다.
안장점(saddle point). 안장점 근처에서는 그래디언트가 매우 작아서 빠져나오는 데 오래 걸린다. 특수한 구조처럼 보이지만, 실제로는 신경망 손실 지형의 임계점 대부분이 안장점이다.
왜 안장점이 흔한가
임계점(critical point) 은 \(\nabla_\theta \mathcal{L}(\theta) = 0\)인 점이다. 1차원에서는 2계 도함수로 종류를 판별한다. \(\frac{d^2\mathcal{L}}{d\theta^2} > 0\)이면 (국소) 최소, \(< 0\)이면 (국소) 최대다.
고차원에서는 2계 도함수를 모은 헤시안(Hessian) 행렬을 본다.
\[\nabla_\theta^2 \mathcal{L}(\theta) = \begin{bmatrix} \frac{\partial^2 \mathcal{L}}{\partial \theta_1 \partial \theta_1} & \cdots & \frac{\partial^2 \mathcal{L}}{\partial \theta_1 \partial \theta_n} \\ \vdots & \ddots & \vdots \\ \frac{\partial^2 \mathcal{L}}{\partial \theta_n \partial \theta_1} & \cdots & \frac{\partial^2 \mathcal{L}}{\partial \theta_n \partial \theta_n} \end{bmatrix}\]예를 들어 헤시안이 \(\begin{bmatrix} 1 & 0 \\ 0 & -1 \end{bmatrix}\)이면 한 방향으로는 아래로 볼록, 다른 방향으로는 위로 볼록한 안장점이다. (대각) 헤시안의 모든 대각 성분이 양수이거나 모두 음수여야만 최소나 최대가 된다. 일반적으로는 헤시안의 고유값이 모두 같은 부호여야 한다. 차원이 수백만이라면 모든 방향의 부호가 일치할 가능성은 매우 낮으므로, 임계점은 대부분 안장점이다.
더 나은 방향: 뉴턴법에서 Adam까지
이상적인 방향: 뉴턴법
길쭉한 등고선에서 경사하강법은 지그재그로 움직이지만, 최적점을 곧장 가리키는 방향이 존재한다. 이 방향은 뉴턴법(Newton’s method) 으로 찾을 수 있다. 1차원 테일러 전개는 다음과 같다.
\[f(x) \approx f(x_0) + f'(x_0)(x - x_0) + \frac{1}{2} f''(x_0)(x - x_0)^2\]다변수에서는 다음과 같다.
\[\mathcal{L}(\theta) \approx \mathcal{L}(\theta_0) + \nabla_\theta \mathcal{L}(\theta_0)^T (\theta - \theta_0) + \frac{1}{2} (\theta - \theta_0)^T \nabla_\theta^2 \mathcal{L}(\theta_0) (\theta - \theta_0)\]이 2차 근사는 해석적으로 최적화할 수 있다. \(\theta\)에 대해 미분해 0으로 두면 다음을 얻는다.
\[\theta^\star \leftarrow \theta_0 - \left( \nabla_\theta^2 \mathcal{L}(\theta_0) \right)^{-1} \nabla_\theta \mathcal{L}(\theta_0)\]뉴턴법을 쓸 수 없는 이유
매개변수가 \(n\)개면 헤시안은 \(n \times n\)이고, 순진하게 역행렬을 구하면 \(O(n^3)\)이다. 신경망의 \(n\)은 수백만 이상이므로 감당할 수 없다. 헤시안을 명시적으로 만들지 않는 정교한 방법은 훨씬 빠를 수 있지만, 2계 도함수가 필요 없으면서 경사하강법을 “가속”하는 방법이 더 바람직하다. 뉴턴법은 실제로 쓰지 않지만 지향할 “이상”이다.
모멘텀
지그재그 경로에서 연속한 그래디언트를 평균하면 훨씬 좋은 방향이 나온다. 연속한 스텝이 서로 다른 방향을 가리키면 그 성분은 상쇄하고, 같은 방향을 가리키면 그 방향으로 더 빨리 가야 한다. 이것이 모멘텀(momentum) 이다.
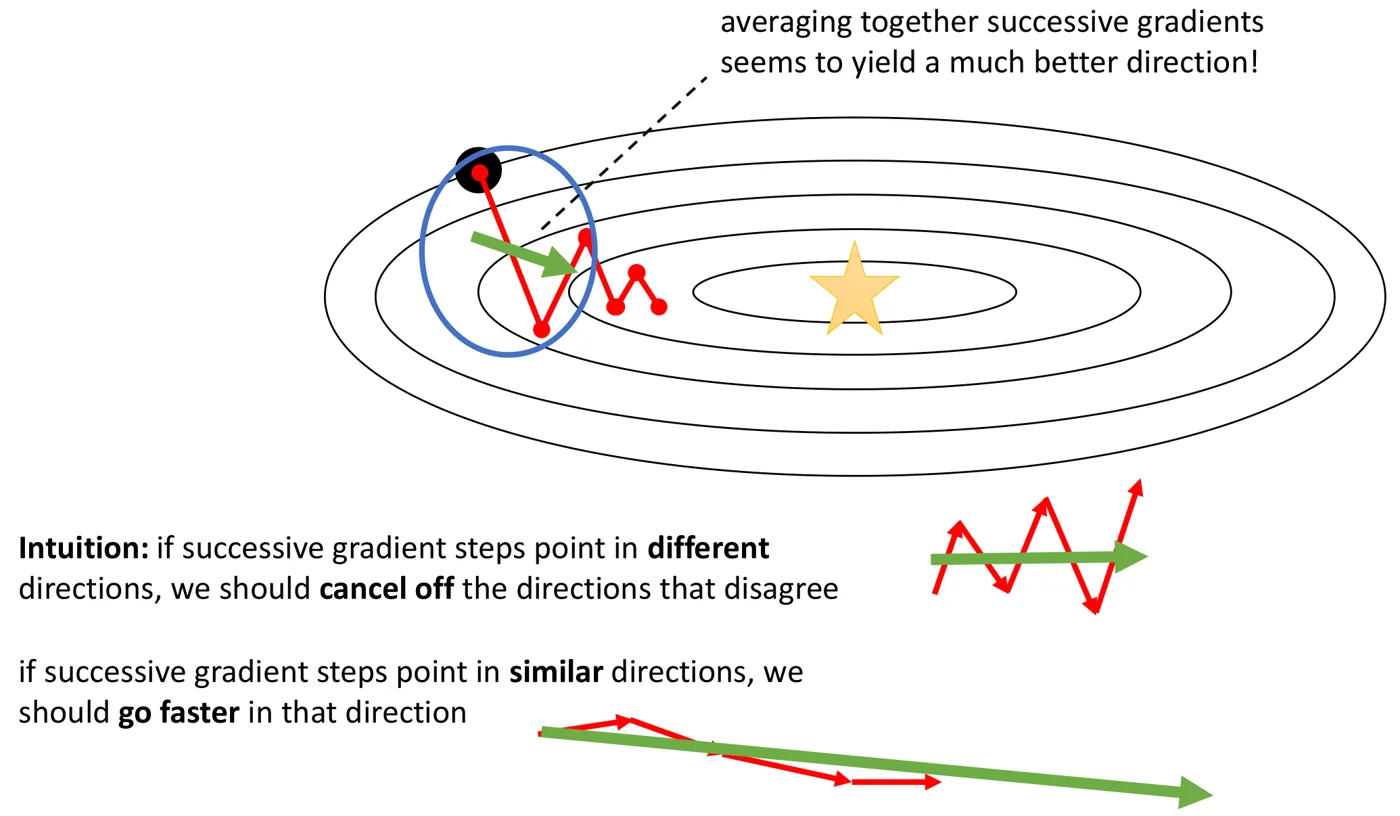 모멘텀의 직관. 위는 지그재그하는 경사하강법 경로에서 연속한 두 스텝(파란 원)을 평균하면 최적점을 더 잘 가리키는 초록 화살표가 나온다는 그림이고, 아래는 방향이 엇갈리는 스텝은 상쇄되고 방향이 같은 스텝은 누적된다는 그림이다. 출처: CS 182 Lecture 4 slides.
위 그림에서 첫 스텝은 오른쪽 아래로, 다음 스텝은 오른쪽 위로 향한다. 두 벡터를 더하면 위아래 성분은 서로 지워지고 오른쪽 성분만 남아, 별표를 향하는 초록 화살표가 된다. 아래 왼쪽 그림의 빨간 화살표들은 위아래로 번갈아 튀지만 평균인 초록 화살표는 수평이다. 아래 오른쪽 그림처럼 스텝이 모두 비슷한 방향이면 평균한 방향이 그대로 유지되면서 누적되어 크기가 커진다. 아래 갱신식의 \(\mu g_{k-1}\) 항이 이 “누적”을 구현한다.
\[g_k = \nabla_\theta \mathcal{L}(\theta_k) + \mu g_{k-1}, \qquad \theta_{k+1} = \theta_k - \alpha g_k\]기존 경사하강법은 \(g_k = \nabla_\theta \mathcal{L}(\theta_k)\)였고, 모멘텀은 이전 방향 \(\mu g_{k-1}\)을 “섞어 넣는다”. 매우 단순한 갱신 규칙이지만, 사실상 비용 없이 뉴턴법의 이점 일부를 가져온다. 이런 모멘텀 방법 자체는 보장이 거의 없다. 밀접한 방법인 Nesterov 가속 경사법(Nesterov accelerated gradient) 은 매력적인 이론적 보장을 갖지만, 실제로는 보통 그냥 모멘텀을 쓴다.
그래디언트 크기 문제
그래디언트의 부호는 각 차원에서 어느 쪽으로 갈지 잘 알려 주지만, 크기는 그다지 믿을 만하지 않다. 게다가 최적화 도중 그래디언트의 전체 크기가 크게 변한다. 최적점에서 멀 때는 거대하고 가까우면 작아서 학습률을 맞추기 어렵다. 그래서 각 차원별로 그래디언트의 크기를 “정규화”해 없애는 방법을 생각한다.
RMSProp
각 차원의 크기를 이동 평균으로 추정한다(제곱과 나눗셈은 성분별이다).
\[s_k \leftarrow \beta s_{k-1} + (1 - \beta) \left( \nabla_\theta \mathcal{L}(\theta_k) \right)^2, \qquad \theta_{k+1} = \theta_k - \alpha \frac{\nabla_\theta \mathcal{L}(\theta_k)}{\sqrt{s_k}}\]\(s_k\)는 대략 각 차원의 제곱 길이이고, 각 차원을 자기 크기로 나누는 셈이다.
AdaGrad
이동 평균 대신 누적 합을 쓴다.
\[s_k \leftarrow s_{k-1} + \left( \nabla_\theta \mathcal{L}(\theta_k) \right)^2, \qquad \theta_{k+1} = \theta_k - \alpha \frac{\nabla_\theta \mathcal{L}(\theta_k)}{\sqrt{s_k}}\]\(s_k\)가 단조 증가하므로 유효 학습률이 시간이 지날수록 “감소”한다. 이는 볼록 문제에서 좋고, AdaGrad는 볼록 문제에서 좋은 보장을 가진다. 하지만 학습률이 너무 줄기 전에 최적점을 빨리 찾아야만 통한다. 딥러닝을 비롯한 대부분의 비볼록 문제에서는 RMSProp이 훨씬 나은 경향이 있다.
Adam
Adam 은 모멘텀과 RMSProp을 결합한다.
\[\begin{aligned} m_k &= (1 - \beta_1) \nabla_\theta \mathcal{L}(\theta_k) + \beta_1 m_{k-1} \\ v_k &= (1 - \beta_2) \left( \nabla_\theta \mathcal{L}(\theta_k) \right)^2 + \beta_2 v_{k-1} \\ \hat{m}_k &= \frac{m_k}{1 - \beta_1^k}, \qquad \hat{v}_k = \frac{v_k}{1 - \beta_2^k} \\ \theta_{k+1} &= \theta_k - \alpha \frac{\hat{m}_k}{\sqrt{\hat{v}_k} + \epsilon} \end{aligned}\]\(m_k\)는 1차 모멘트 추정(모멘텀과 비슷함), \(v_k\)는 2차 모멘트 추정이다. \(\hat{m}_k\), \(\hat{v}_k\)는 편향 보정(bias correction)이다. \(m_0 = 0\), \(v_0 = 0\)에서 시작하므로 초기에는 값이 작게 추정되는데, \(k\)가 작을 때 \(1 - \beta^k\)로 나눠 값을 “키워 준다”. \(\epsilon\)은 0으로 나누는 것을 막는 작은 수다. 좋은 기본값은 \(\alpha = 0.001\), \(\beta_1 = 0.9\), \(\beta_2 = 0.999\), \(\epsilon = 10^{-8}\)이다.
확률적 최적화
경사하강법이 비싼 이유
손실의 그래디언트는 데이터셋 전체에 대한 합이다.
\[\nabla_\theta \mathcal{L}(\theta) = -\nabla_\theta \frac{1}{N} \sum_{i=1}^{N} \log p(y_i \mid x_i, \theta)\]ImageNet은 150만 장이므로 한 스텝마다 전체를 훑는 것은 너무 비싸다. 그런데 이 합은 데이터 분포에 대한 기댓값의 추정이므로, 표본을 더 적게 써도 여전히 올바른(불편, unbiased) 추정량이다.
미니배치 확률적 경사하강법
확률적 경사하강법(stochastic gradient descent, SGD) 은 매 반복마다 다음을 한다.
- 크기 \(N\)인 데이터셋에서 \(B\)개의 데이터를 무작위로 뽑아 미니배치 \(\mathcal{B} \subset \mathcal{D}\)를 만든다.
- 그래디언트를 추정한다. \(g_k \leftarrow -\nabla_\theta \frac{1}{B} \sum_{i \in \mathcal{B}} \log p(y_i \mid x_i, \theta) \approx \nabla_\theta \mathcal{L}(\theta)\)
- 갱신한다. \(\theta_{k+1} \leftarrow \theta_k - \alpha g_k\)
반복마다 다른 미니배치를 쓰며, 모멘텀이나 Adam과도 함께 쓸 수 있다. 실제로는 무작위 추출이 메모리 임의 접근 때문에 느리므로, 데이터셋을 카드 덱처럼 미리 한 번 섞어 두고 연속한 \(B\)개씩 묶어 배치를 만든다. 데이터셋 전체를 한 번 훑는 것을 1 에폭(epoch) 이라 한다.
학습률
에폭에 따른 손실 곡선을 보면 다음과 같다.
- 학습률이 너무 높으면 처음엔 빨리 내려가지만 높은 값에서 정체한다. 최적점 주변에서 튀어 다니기 때문이다.
- 학습률이 너무 낮으면 느리게 내려간다. 또 직관에 반하게, 평탄 구간이나 얕은 골짜기에 갇혀 더 나쁜 값에 수렴할 수도 있다.
- 좋은 학습률은 빠르게 내려가면서 낮은 값에 도달한다.
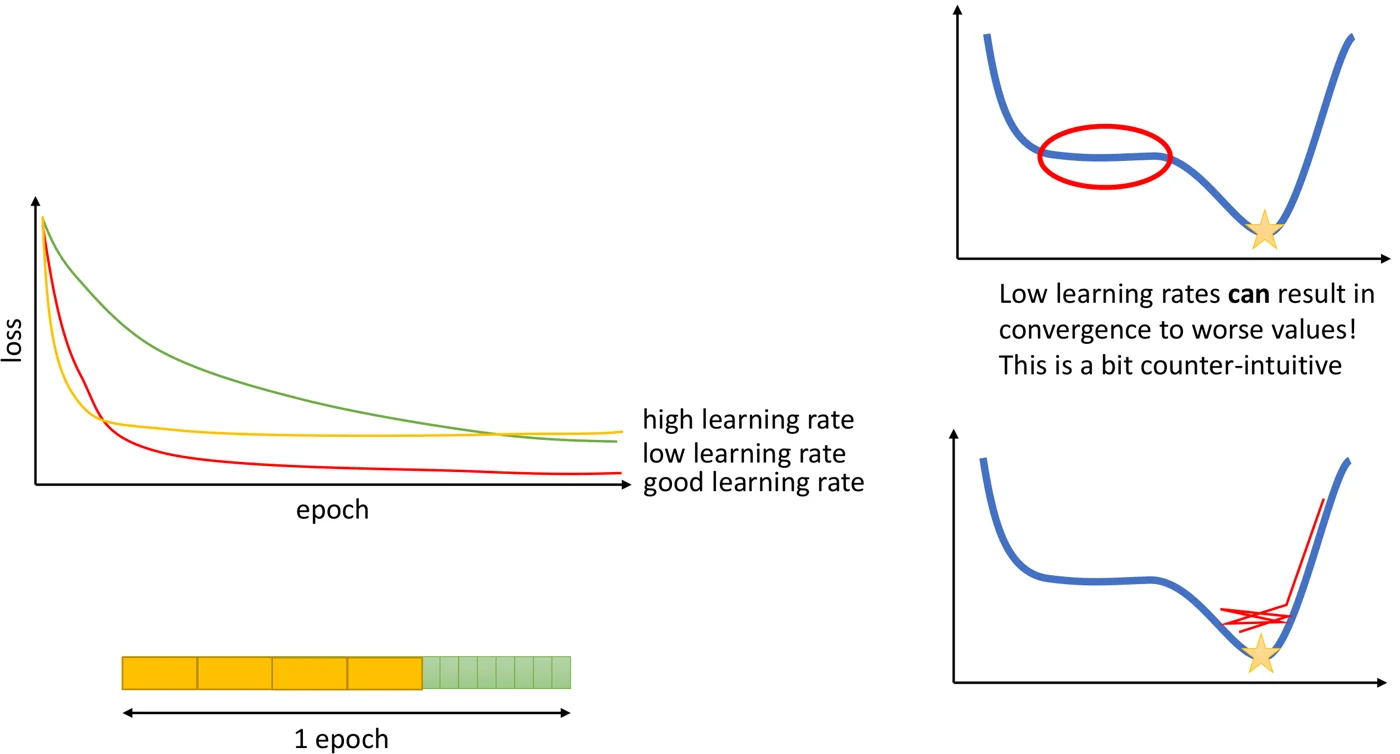 왼쪽은 학습률에 따른 에폭별 손실 곡선(노랑: 너무 높음, 초록: 너무 낮음, 빨강: 적절함)과 1 에폭이 여러 미니배치로 이루어짐을 나타낸 막대, 오른쪽은 낮은 학습률이 평탄 구간에 갇히는 경우(위)와 높은 학습률이 최적점 주위에서 튀는 경우(아래)다. 출처: CS 182 Lecture 4 slides.
왼쪽 그래프에서 노란 곡선(높은 학습률)은 처음에 가장 빨리 떨어지지만 곧 수평이 되어 빨간 곡선보다 높은 곳에 머문다. 오른쪽 아래 그림처럼 스텝이 너무 커서 최적점 주변 골짜기의 양쪽 벽을 오가며 바닥까지 내려가지 못하기 때문이다. 초록 곡선(낮은 학습률)은 꾸준히 내려가지만 매우 느리고, 오른쪽 위 그림처럼 평탄 구간에 들어가면 작은 스텝으로는 그 구간을 건너지 못해 더 나쁜 값에서 멈출 수 있다. 왼쪽 아래 막대는 데이터셋을 미니배치(노란 칸) 단위로 나눠 차례로 쓰고, 전체를 한 번 다 쓰면 1 에폭이 된다는 것을 나타낸다.
학습률 감쇠
AlexNet의 ImageNet 학습 곡선처럼, 학습률을 일정 시점마다 낮추면 손실이 계단식으로 다시 떨어지고 정확도는 계단식으로 다시 올라간다. SGD(+모멘텀)로 최고 성능을 얻으려면 보통 학습률 감쇠 스케줄(learning rate decay schedule)이 필요하다. Adam에서는 대개 필요 없다. 최고 성능만 보면 SGD + 모멘텀이 Adam보다 낫다고 보는 등 의견이 갈리지만, Adam이 튜닝하기 더 쉽다.
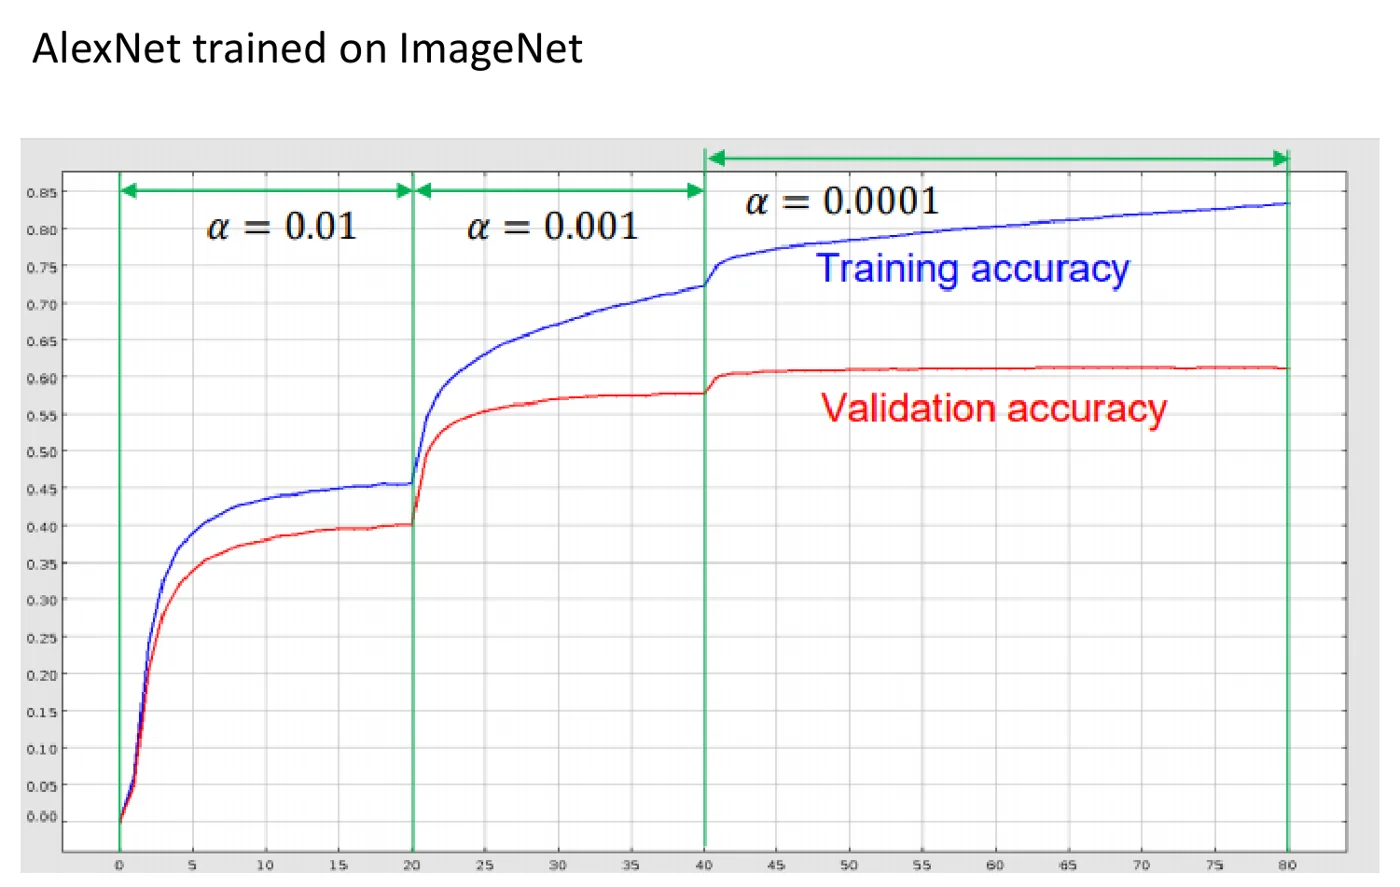 ImageNet에서 학습한 AlexNet의 학습 정확도(파랑)와 검증 정확도(빨강). 가로축은 에폭이며, 20 에폭과 40 에폭에서 학습률을 \(0.01 \to 0.001 \to 0.0001\)로 10배씩 낮췄다. 출처: CS 182 Lecture 4 slides.
그래프를 구간별로 보면 다음과 같다. 처음 20 에폭 동안 \(\alpha = 0.01\)에서 정확도가 빠르게 오르다가 약 0.45(학습), 0.40(검증) 부근에서 거의 멈춘다. 학습률이 너무 커서 더 좁은 골짜기로 내려가지 못하는 상태다. 20 에폭에서 학습률을 낮추자마자 두 곡선이 계단처럼 뛰어오르고, 40 에폭에서 한 번 더 낮추면 다시 작은 계단이 생긴다. 마지막 구간에서는 학습 정확도가 계속 오르는데도 검증 정확도는 약 0.61에서 평평하다. 이 간격은 3강에서 본 과적합의 신호다.
확률적 경사하강법 튜닝
- 배치 크기 \(B\): 클수록 그래디언트 잡음이 적어 대개 “안전”하지만 비용이 크다.
- 학습률 \(\alpha\): 작동하는 범위에서 가장 큰 값을 쓰고, 시간에 따라 감쇠하는 것이 좋다.
- 모멘텀 \(\mu\): 0.99가 좋은 값이다.
- Adam 매개변수 \(\beta_1, \beta_2\): 보통 기본값을 그대로 둔다.
이 하이퍼파라미터는 무엇으로 튜닝하는가? 최적화의 매개변수이므로 원칙적으로는 학습 손실로 맞춰야 하지만, 실제로는 검증 손실로 맞추는 경우가 많다. 확률적 그래디언트와 정규화의 관계는 복잡해서, SGD 자체를 좋은 정규화 수단으로 보는 사람도 있다. 이는 검증 손실을 써야 한다는 근거가 된다.
정리
- 경사하강법은 가장 가파른 방향으로 가지만, 길쭉한 골짜기에서는 그 방향이 최적점을 가리키지 않아 지그재그로 움직인다.
- 볼록 함수(예: 로지스틱 회귀의 NLL)에서는 강한 보장이 있지만, 신경망의 손실은 비볼록이며 국소 최적점, 평탄 구간, 안장점이 있다. 큰 네트워크에서는 국소 최적점이 덜 문제이고, 임계점 대부분은 안장점이다.
- 뉴턴법 \(\theta \leftarrow \theta - (\nabla^2 \mathcal{L})^{-1} \nabla \mathcal{L}\)은 이상적인 방향을 주지만 헤시안 때문에 너무 비싸다.
- 모멘텀은 과거 그래디언트를 섞어 진동을 상쇄하고 일관된 방향을 가속한다. RMSProp과 AdaGrad는 차원별 그래디언트 크기로 나눠 정규화하며, Adam은 둘을 결합하고 편향 보정을 더한다.
- SGD는 무작위 미니배치로 그래디언트를 불편 추정한다. 학습률은 너무 크지도 작지도 않게 고르고, SGD에서는 감쇠 스케줄이 대개 필요하다.