- UC Berkeley CS 182 (Spring 2021) 2강 정리
- 강의: Sergey Levine
- 관련 Discussion: Discussion 2
학습 문제의 종류
학습 문제는 크게 세 가지로 나뉜다.
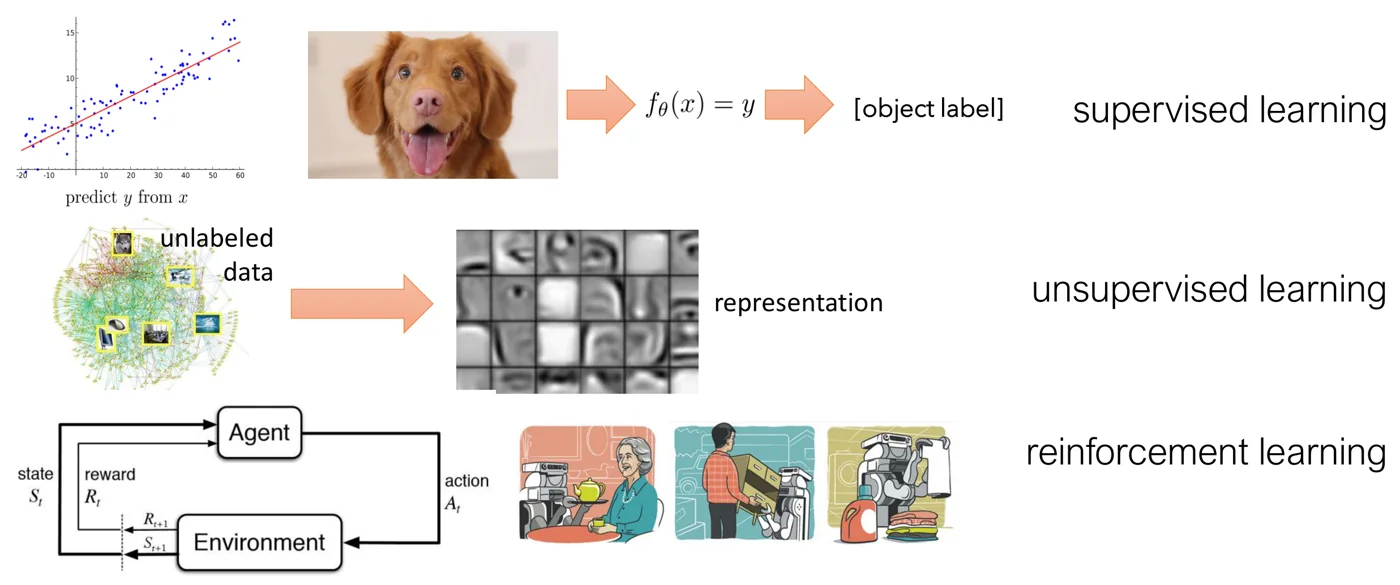 세 가지 학습 문제. 위는 입력에서 레이블을 예측하는 지도학습, 가운데는 레이블 없는 데이터에서 표현을 얻는 비지도학습, 아래는 에이전트가 환경과 상호작용하며 보상을 받는 강화학습이다. 출처: CS 182 Lecture 2 slides.
그림의 세 줄은 무엇이 주어지고 무엇을 얻는지가 다르다. 지도학습 줄에서는 \(x\)와 정답 \(y\)가 함께 주어지고, 그 대응 관계 \(f_\theta\)를 배운다. 비지도학습 줄에서는 왼쪽의 데이터 묶음만 있고 정답은 없으며, 결과물은 레이블이 아니라 가운데 격자 같은 표현이다. 강화학습 줄의 왼쪽 그림은 상호작용의 고리를 보여 준다. 에이전트가 상태 \(S_t\)를 보고 행동 \(A_t\)를 하면 환경이 다음 상태 \(S_{t+1}\)와 보상 \(R_{t+1}\)을 돌려준다. 데이터가 미리 고정되어 있지 않고 에이전트의 행동에 따라 달라진다는 점이 앞의 두 경우와 다르다.
지도학습
지도학습(supervised learning) 에서는 입력과 정답 레이블의 쌍으로 이루어진 데이터셋 \(\mathcal{D} = \{(x_1, y_1), \dots, (x_N, y_N)\}\)이 주어지고, \(f_\theta(x) \approx y\)가 되는 함수 \(f_\theta\)를 학습한다. 이때 답해야 할 질문은 세 가지다. \(f_\theta\)를 어떻게 표현할 것인가, \(\theta\)를 어떻게 고를 것인가, 그리고 학습한 \(f_\theta\)가 새로운 입력에서도 잘 작동하는가.
비지도학습
비지도학습(unsupervised learning) 에서는 레이블 없는 데이터만 주어지고, 그로부터 어떤 표현을 얻는다. “표현을 얻는다”는 말은 여러 뜻이 될 수 있다.
- 생성 모델링(generative modeling): 데이터 분포 자체를 모델링한다. GAN, VAE, pixel RNN 등이 있다.
- 자기지도 표현 학습(self-supervised representation learning): 데이터 자체에서 만든 과제를 풀면서 이후 과제에 유용한 표현을 학습한다.
강화학습
강화학습(reinforcement learning) 에서는 고정된 데이터셋 대신 에이전트가 환경과 상호작용한다. 관측(observation)을 보고 행동(action)을 고르며, 보상(reward)을 최대화하도록 학습한다. 예를 들면 다음과 같다.
- 동물: 행동은 근육 수축, 관측은 시각과 후각, 보상은 먹이다.
- 로봇: 행동은 모터 전류나 토크, 관측은 카메라 이미지, 보상은 달리기 속도 같은 과제 성공 척도다.
- 재고 관리: 행동은 무엇을 구매할지, 관측은 재고 수준, 보상은 이익이다.
이 밖에도 치료법 추천, 다음 학습 주제 추천, 동영상 추천, 광고 배치 등 응용이 많다.
지도학습과 확률 모델
지도학습의 위치
산업에서 쓰이는 머신러닝의 압도적 다수는 지도학습이다. 정답 데이터로 학습하는 모든 예측과 인식 모델이 여기에 속한다. 이미지로 물체 범주를, 프랑스어 문장으로 영어 문장을, X선 영상으로 질병 유무를, 음성으로 문장을 예측하는 것이 모두 지도학습이다.
레이블 대신 확률을 예측한다
손글씨 숫자를 생각하자. 어떤 이미지는 5인지 9인지, 3인지 4인지 애매하다. 이럴 때는 하나의 이산 레이블보다 각 레이블의 확률을 예측하는 것이 더 자연스럽다. 예를 들어 “5일 확률 90%, 6일 확률 8%” 같은 출력이다.
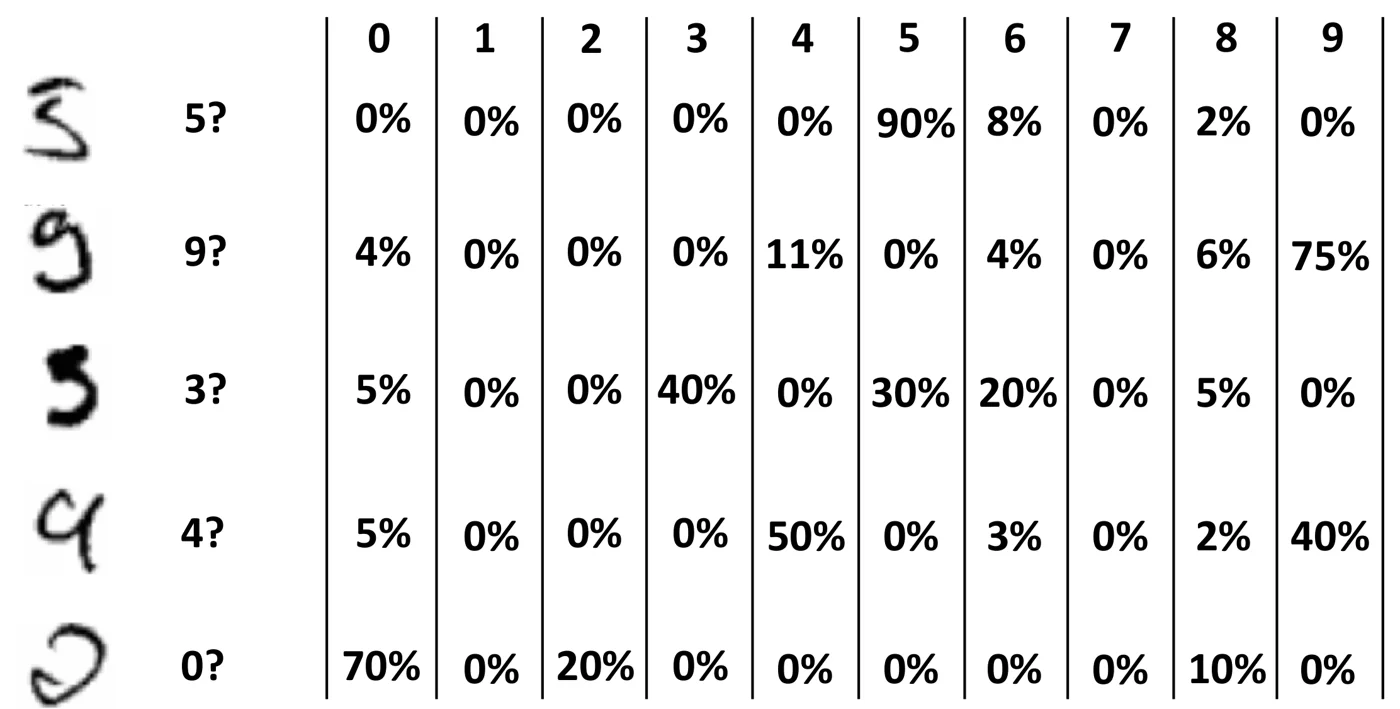 애매한 손글씨 숫자 다섯 개에 대해 0~9 각 숫자일 확률을 적은 표. 행마다 확률의 합이 100%이다. 출처: CS 182 Lecture 2 slides.
표의 각 행을 읽어 보면 확률 출력이 왜 유용한지 알 수 있다. 첫 행의 숫자는 5일 확률 90%로 거의 확실하다. 셋째 행은 3일 확률 40%, 5일 확률 30%, 6일 확률 20%로 사람이 봐도 판단이 갈린다. 넷째 행은 4(50%)와 9(40%) 사이에서 망설인다. 이산 레이블 하나만 내놓는 모델은 셋째 행에도 “3”이라고만 답하므로, 그 답이 얼마나 불확실한지는 전달하지 못한다. 확률 벡터는 이 불확실성까지 담는다.
확률 예측은 학습도 더 쉽게 만든다. 이산 레이블은 “조금” 바꿀 수 없다. 맞거나 틀리거나 둘 중 하나다. 반면 확률은 조금씩 바꿀 수 있으므로 매끄러운(smooth) 목적함수를 얻는다. 따라서 목표는 \(p_\theta(y \mid x)\)를 학습하는 것이다.
조건부 확률
입력 \(x\)와 출력 \(y\)를 확률변수로 본다. 입력이 확률변수인 이유는 데이터가 어떤 분포에서 뽑혀 나오기 때문이다. 연쇄 법칙(chain rule)과 조건부 확률의 정의는 다음과 같다.
\[p(x, y) = p(x)\, p(y \mid x), \qquad p(y \mid x) = \frac{p(x, y)}{p(x)}\]확률을 어떻게 표현하는가
레이블이 10개라면 프로그램은 10개의 수를 출력해야 하고, 그 수들은 양수이며 합이 1이어야 한다. 이를 위해 임의의 실수 출력을 받아 이 조건을 만족하는 수로 바꾸는 함수를 쓴다. 원칙적으로는 이 조건을 만족하고, 가능하면 일대일 대응(one-to-one & onto)인 함수라면 무엇이든 된다.
개와 고양이를 구분하는 예를 보자. 각 클래스에 선형 함수 \(f_{\text{dog}}(x) = x^T\theta_{\text{dog}}\), \(f_{\text{cat}}(x) = x^T\theta_{\text{cat}}\)를 두고 다음과 같이 확률로 바꾼다.
\[p(\text{dog} \mid x) = \frac{\exp(f_{\text{dog}}(x))}{\exp(f_{\text{dog}}(x)) + \exp(f_{\text{cat}}(x))}\]지수함수 \(\exp\)는 실수 전체를 양의 실수 전체로 일대일 대응시키므로 값을 양수로 만들기에 편리하다. 분모로 나누는 것은 합을 1로 만든다. 이 방식에 특별한 마법은 없으며 유일한 방법도 아니다.
소프트맥스
일반적으로 \(m\)개 클래스에 대해 다음을 소프트맥스(softmax) 라 한다.
\[p_\theta(y = i \mid x) = \operatorname{softmax}(f_\theta(x))_i = \frac{\exp(f_{\theta,i}(x))}{\sum_{j=1}^{m} \exp(f_{\theta,j}(x))}\]1차원에서 빨강/파랑 두 클래스를 생각하면, 결정 경계에서 멀어질수록 한쪽 클래스의 확률이 지수적으로 커지고, 경계 근처에서는 “확실하지 않음”에 해당하는 확률이 나온다.
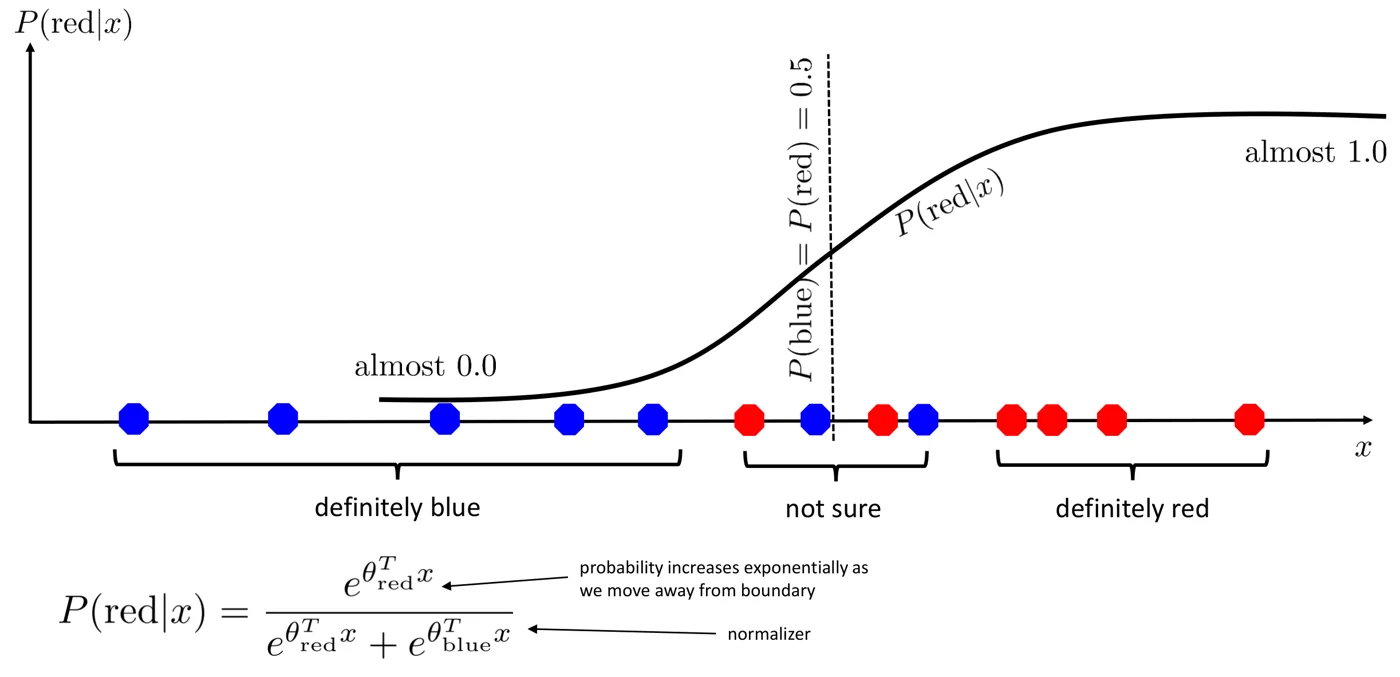 1차원 입력 \(x\) 위의 빨강/파랑 점과, 소프트맥스로 계산한 \(P(\text{red} \mid x)\) 곡선. 점선은 두 확률이 0.5로 같아지는 결정 경계다. 출처: CS 182 Lecture 2 slides.
그림에서 왼쪽 끝은 파란 점만 있는 “definitely blue” 구간으로, 곡선이 거의 0이다. 오른쪽 끝은 “definitely red” 구간으로 곡선이 거의 1이다. 가운데 “not sure” 구간에는 빨강과 파랑이 섞여 있고, 곡선도 0.5 근처를 지나며 모델이 확신하지 못함을 나타낸다. 아래 식에서 분자 \(e^{\theta_{\text{red}}^T x}\)는 경계에서 멀어질수록 지수적으로 커지고, 분모는 두 값을 합해 확률이 1을 넘지 않도록 정규화한다.
왜 “소프트”맥스인가
매개변수를 크게 키우면, 예를 들어 \(\theta\) 대신 \(5\theta\)나 \(100\theta\)를 쓰면, 확률 곡선이 점점 가팔라져 계단 함수에 가까워진다. 극한에서는 \(\max_y \theta_y^T x\)를 내는 클래스에 확률 1을 주는 hard max가 된다. 소프트맥스는 이 max 연산을 매끄럽게 만든 것이다.
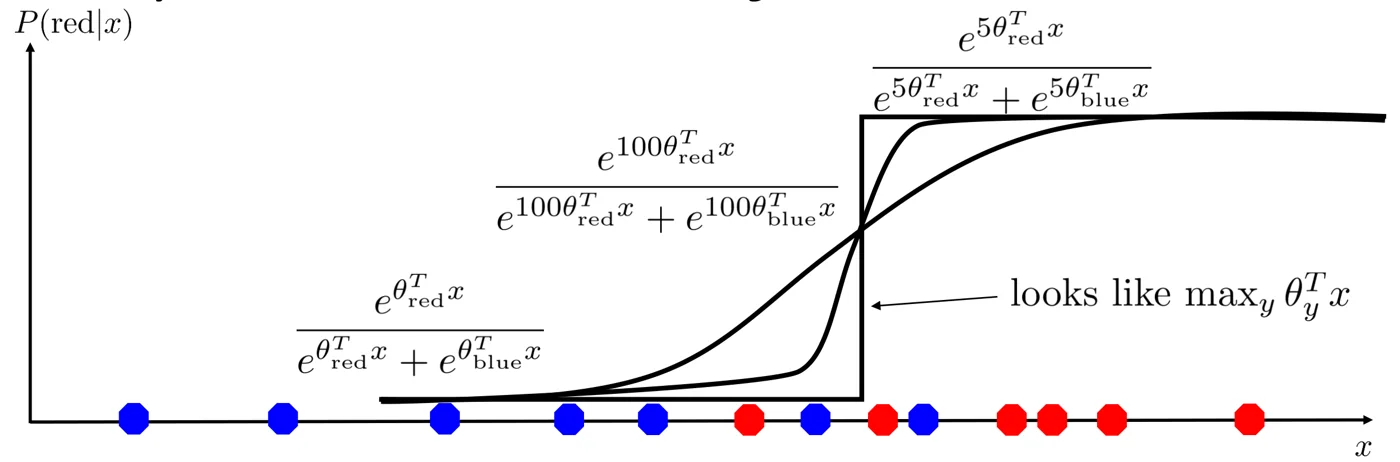 같은 데이터에 대해 \(\theta\), \(5\theta\), \(100\theta\)를 쓴 소프트맥스 곡선. 배율이 커질수록 곡선이 가팔라져 계단 모양의 hard max에 가까워진다. 출처: CS 182 Lecture 2 slides.
세 곡선은 모두 같은 점, 즉 \(\theta_{\text{red}}^T x = \theta_{\text{blue}}^T x\)인 결정 경계에서 0.5를 지난다. 매개변수에 상수 \(c\)를 곱하면 두 지수의 비가 \(e^{c(\theta_{\text{red}} - \theta_{\text{blue}})^T x}\)가 되므로, 경계에서 조금만 벗어나도 비가 매우 커지거나 작아진다. 그래서 \(c\)가 클수록 경계 근처의 “확실하지 않은” 구간이 좁아진다. 이 점은 학습과도 관련된다. 데이터를 완벽히 분리할 수 있다면 NLL을 줄이기 위해 \(\theta\)의 크기를 끝없이 키우려는 경향이 생긴다.
손실 함수
머신러닝의 일반적 방법
어떤 문제든 머신러닝으로 풀 때는 다음 순서를 따른다.
- 모델 집합(model class)을 정한다. “프로그램”을 어떻게 표현할 것인가.
- 손실 함수(loss function)를 정한다. 모델 집합 안의 한 모델이 다른 모델보다 나은지 어떻게 잴 것인가.
- 최적화기(optimizer)를 고른다. 손실을 최소화하는 모델을 모델 집합에서 어떻게 찾을 것인가.
- 큰 GPU에서 돌린다.
이는 Marr의 분석 수준(levels of analysis)과 비슷하다. 계산 수준(“왜?”)은 손실 함수, 알고리즘 수준(“무엇을?”)은 모델, 구현 수준(“어떻게?”)은 최적화 알고리즘에 대응한다고 볼 수 있다. 마지막 단계는 “어느 GPU에서?”다.
데이터셋은 어떻게 “생성”되는가
데이터는 사진의 분포 \(p(x)\)에서 \(x\)를 뽑고, 레이블의 조건부 분포 \(p(y \mid x)\)에서 \(y\)를 뽑아 만들어진다고 본다. 학습 집합 \(\mathcal{D} = \{(x_i, y_i)\}\)의 각 쌍이 독립이라면, 모델 \(p_\theta(y \mid x)\) 아래에서 데이터셋의 확률은 다음과 같다.
\[p(\mathcal{D}) = \prod_i p(x_i)\, p_\theta(y_i \mid x_i)\]1 이하인 수를 많이 곱하면 값이 매우 작아지므로 로그를 취한다.
\[\log p(\mathcal{D}) = \sum_i \left[ \log p(x_i) + \log p_\theta(y_i \mid x_i) \right] = \sum_i \log p_\theta(y_i \mid x_i) + \text{const}\]\(p(x_i)\) 항은 \(\theta\)와 무관하므로 상수다.
최대우도 추정과 음의 로그우도
데이터를 가장 그럴듯하게 만드는 \(\theta\)를 고르는 것을 최대우도 추정(maximum likelihood estimation, MLE) 이라 한다.
\[\theta^\star \leftarrow \arg\max_\theta \sum_i \log p_\theta(y_i \mid x_i)\]부호를 바꾸면 최소화 문제가 되고, 이것이 손실 함수인 음의 로그우도(negative log-likelihood, NLL) 다.
\[\theta^\star \leftarrow \arg\min_\theta \; -\sum_i \log p_\theta(y_i \mid x_i)\]여러 손실 함수
손실 함수는 \(\theta\)가 얼마나 “나쁜지”를 수량화하며, 가장 덜 나쁜 \(\theta\)를 찾는 것이 목표다. 예는 다음과 같다.
- 음의 로그우도: \(-\sum_i \log p_\theta(y_i \mid x_i)\). 교차 엔트로피(cross-entropy)라고도 부른다.
- 0-1 손실: \(\sum_i \delta(f_\theta(x_i) \neq y_i)\). 틀리면 1, 맞으면 0이다.
- 평균제곱오차(mean squared error, MSE): \(\sum_i \frac{1}{2} \lVert f_\theta(x_i) - y_i \rVert^2\). 이것도 사실 음의 로그우도다. 출력 분포를 평균 \(f_\theta(x)\), 분산 고정인 가우시안으로 두면 NLL이 상수 차이를 빼고 MSE가 된다.
왜 교차 엔트로피인가
두 분포 \(p\)와 \(p_\theta\)가 얼마나 비슷한지를 재는 교차 엔트로피는 다음과 같다.
\[H(p, p_\theta) = -\sum_y p(y \mid x_i) \log p_\theta(y \mid x_i)\]\(y_i \sim p(y \mid x_i)\)라는 표본 하나로 이 기댓값을 근사하면 \(H(p, p_\theta) \approx -\log p_\theta(y_i \mid x_i)\)다. 따라서 NLL은 실제 분포와 모델 분포 사이의 교차 엔트로피를 표본으로 추정한 것이다.
최적화와 로지스틱 회귀
손실 지형과 경사하강법
손실 \(\mathcal{L}(\theta)\)를 \(\theta\)의 함수로 그린 것을 손실 “지형(landscape)”이라 한다. 1차원에서는 기울기가 음수면 오른쪽으로, 양수면 왼쪽으로 가면 손실이 줄어든다. 다차원에서는 각 차원마다 그 차원의 기울기와 반대 방향으로 간다. 기울기를 모은 벡터가 그래디언트(gradient) 다.
\[\nabla_\theta \mathcal{L}(\theta) = \begin{bmatrix} \frac{d\mathcal{L}}{d\theta_1} \\ \vdots \\ \frac{d\mathcal{L}}{d\theta_n} \end{bmatrix}, \qquad \theta \leftarrow \theta - \alpha \nabla_\theta \mathcal{L}(\theta)\]여기서 \(\alpha\)는 작은 상수로, 학습률(learning rate) 또는 스텝 크기(step size)라 한다. 경사하강법(gradient descent)은 그래디언트 계산과 갱신을 반복한다. 자세한 내용은 4강에서 다룬다.
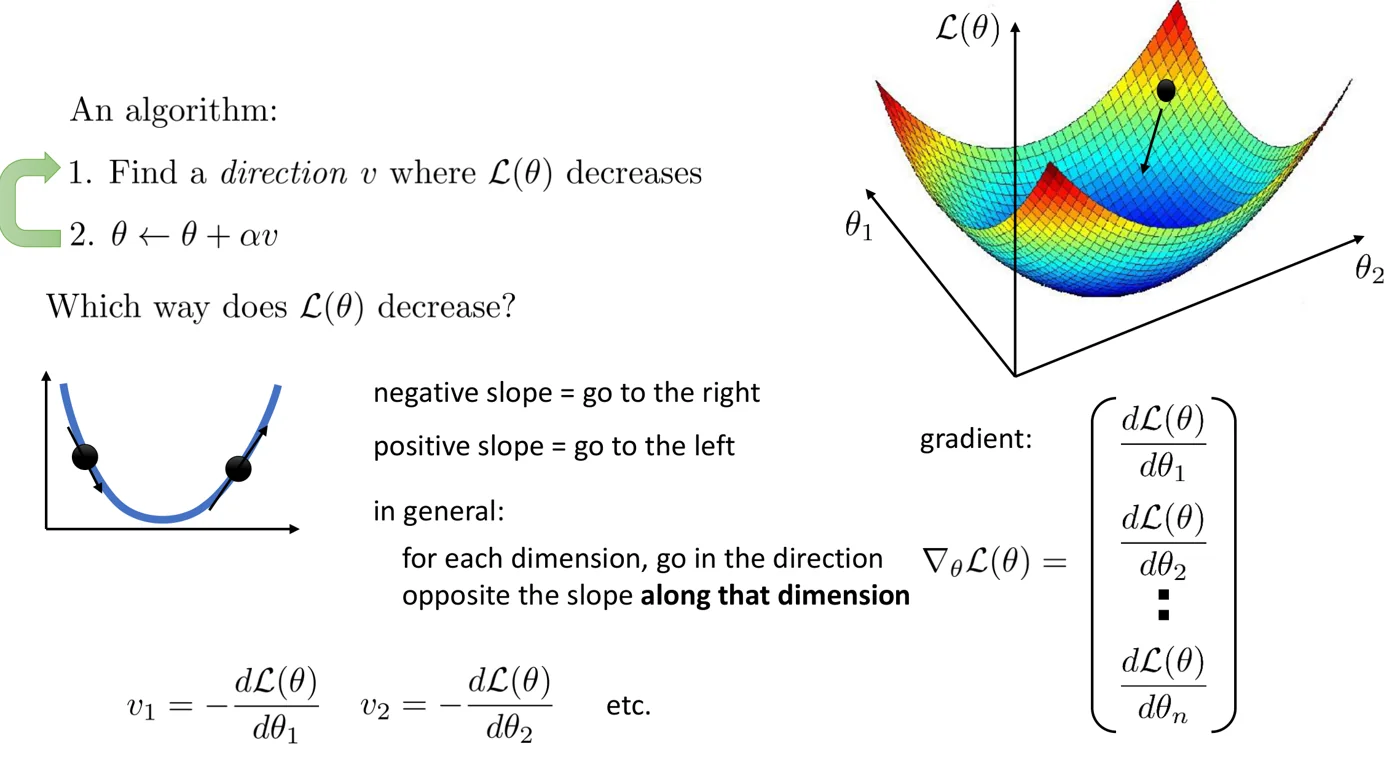 경사하강법의 그림. 왼쪽 위는 “손실이 줄어드는 방향 \(v\)를 찾고 \(\theta \leftarrow \theta + \alpha v\)로 이동”하는 반복, 왼쪽 아래는 1차원에서 기울기 부호에 따라 움직이는 방향, 오른쪽은 2차원 손실 지형과 그래디언트 벡터다. 출처: CS 182 Lecture 2 slides.
왼쪽 아래 1차원 그림에서 왼쪽 공은 기울기가 음수인 곳에 있으므로 오른쪽으로 가야 내려가고, 오른쪽 공은 기울기가 양수이므로 왼쪽으로 가야 한다. 두 경우 모두 이동 방향은 기울기의 반대 부호다. 다차원에서는 이 규칙을 차원마다 따로 적용해 \(v_1 = -\frac{d\mathcal{L}}{d\theta_1}\), \(v_2 = -\frac{d\mathcal{L}}{d\theta_2}\), …로 정하고, 이를 모으면 \(v = -\nabla_\theta \mathcal{L}(\theta)\)가 된다. 오른쪽 그릇 모양 지형 위의 검은 점과 화살표가 바로 이 한 걸음이다. 화살표는 지형에서 가장 가파르게 내려가는 방향을 가리킨다.
로지스틱 회귀
지금까지의 요소를 모으면 로지스틱 회귀(logistic regression) 가 된다. 각 클래스 \(y_j\)에 매개변수 벡터 \(\theta_{y_j}\)를 두고, 이를 열로 모은 행렬을 \(\theta\)라 하면 다음과 같다.
\[f_\theta(x) = \begin{bmatrix} x^T\theta_{y_1} \\ \vdots \\ x^T\theta_{y_m} \end{bmatrix} = (x^T\theta)^T, \qquad p_\theta(y = i \mid x) = \frac{\exp(f_{\theta,i}(x))}{\sum_{j=1}^{m} \exp(f_{\theta,j}(x))}\]손실은 NLL \(\mathcal{L}(\theta) = -\sum_{i=1}^{n} \log p_\theta(y_i \mid x_i)\)이고, 최적화는 경사하강법으로 한다. 결정 경계는 선형이며, 경계에서 멀어질수록 한쪽 클래스의 확률이 커진다.
이진 분류와 시그모이드
클래스가 두 개뿐이면 \(P(y_1 \mid x) + P(y_2 \mid x) = 1\)이므로 하나만 알면 된다. 즉 소프트맥스 표현은 약간 중복적이다. 분자와 분모에 \(e^{-\theta_{y_1}^T x}\)를 곱하면 다음을 얻는다.
\[P(y_1 \mid x) = \frac{e^{\theta_{y_1}^T x}}{e^{\theta_{y_1}^T x} + e^{\theta_{y_2}^T x}} = \frac{1}{1 + e^{(\theta_{y_2} - \theta_{y_1})^T x}} = \frac{1}{1 + e^{-\theta_+^T x}}\]여기서 \(\theta_+ = \theta_{y_1} - \theta_{y_2}\)다. 이 식을 로지스틱 함수(logistic equation) 또는 시그모이드(sigmoid) 라 한다.
경험적 위험과 실제 위험
0-1 손실의 기댓값은 “틀릴 확률”이다. 이를 일반 손실로 확장한 것이 위험(risk) 이다.
\[\text{Risk} = \mathbb{E}_{x \sim p(x),\, y \sim p(y \mid x)} [\mathcal{L}(x, y, \theta)]\]학습 중에는 \(x \sim p(x)\)를 새로 뽑을 수 없고 \(\mathcal{D}\)만 있으므로, 표본 평균인 경험적 위험(empirical risk) 으로 근사한다.
\[\text{Empirical risk} = \frac{1}{n} \sum_{i=1}^{n} \mathcal{L}(x_i, y_i, \theta) \approx \mathbb{E}_{x \sim p(x),\, y \sim p(y \mid x)} [\mathcal{L}(x, y, \theta)]\]경험적 위험 최소화와 그 함정
지도학습은 보통 경험적 위험 최소화(empirical risk minimization, ERM) 다. 그런데 이 근사가 항상 좋은 것은 아니다.
- 과적합(overfitting): 경험적 위험은 낮은데 실제 위험이 높은 경우. 데이터셋이 너무 작거나 모델이 너무 강력할 때(매개변수나 용량이 너무 많을 때) 생긴다.
- 과소적합(underfitting): 경험적 위험도 실제 위험도 높은 경우. 모델이 너무 약하거나, 학습률이 잘못되는 등 최적화기가 잘 설정되지 않았을 때 생긴다.
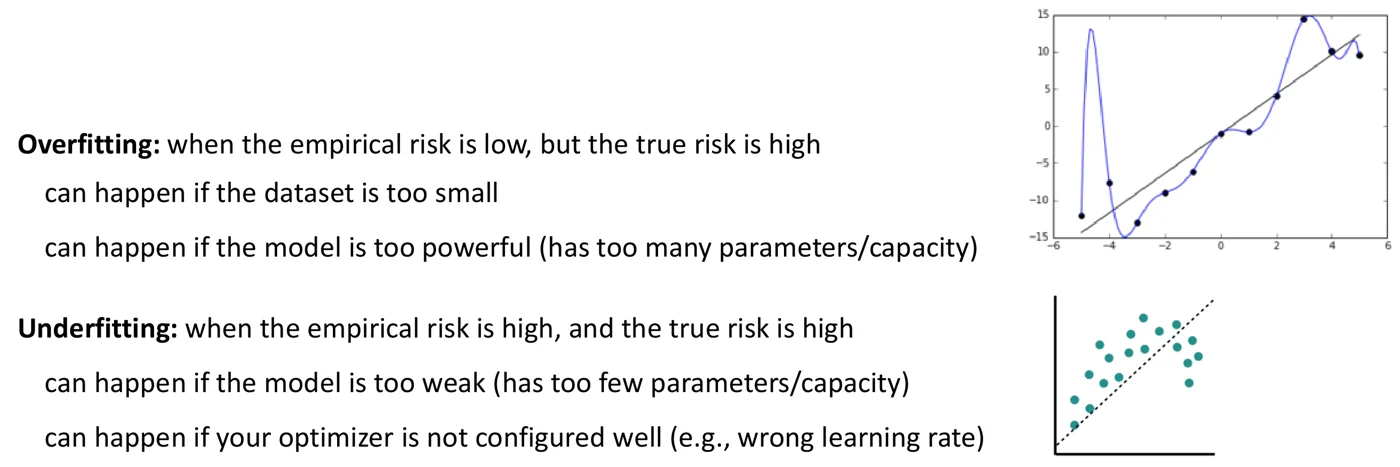 과적합과 과소적합. 오른쪽 위는 고차 다항식이 학습 점을 모두 지나가지만 점 사이에서 크게 출렁이는 과적합, 오른쪽 아래는 직선이 데이터의 경향을 따라가지 못하는 과소적합의 예다. 출처: CS 182 Lecture 2 slides.
위 그래프에서 파란 곡선은 모든 검은 점을 정확히 지나므로 경험적 위험은 거의 0이다. 그러나 \(x \approx -4.5\) 부근처럼 점과 점 사이에서는 엉뚱한 값을 내므로, 같은 분포에서 새 점을 뽑으면 오차가 크다. 즉 실제 위험이 높다. 회색 직선은 학습 점에서 오차가 조금 있지만 새 점에서도 비슷한 정도로 맞힌다. 아래 그래프의 점선은 반대로 학습 데이터에서조차 오차가 커서, 경험적 위험과 실제 위험이 모두 높다.
이 주제는 3강에서 자세히 다룬다.
정리
- 학습 문제는 지도학습, 비지도학습, 강화학습으로 나뉘며, 산업에서는 지도학습이 압도적이다.
- 이산 레이블 대신 확률 \(p_\theta(y \mid x)\)를 예측하면 목적함수가 매끄러워진다. 소프트맥스는 실수 출력을 양수이고 합이 1인 확률로 바꾸며, max의 매끄러운 버전이다.
- 머신러닝의 일반적 방법은 모델 집합, 손실 함수, 최적화기를 차례로 정하는 것이다.
- 데이터가 독립으로 생성된다고 보면 최대우도 추정은 음의 로그우도 최소화와 같고, 이는 교차 엔트로피의 표본 추정이다. MSE는 가우시안 출력의 NLL이다.
- 경사하강법은 \(\theta \leftarrow \theta - \alpha \nabla_\theta \mathcal{L}(\theta)\)를 반복한다. 선형 모델 + 소프트맥스 + NLL + 경사하강법이 로지스틱 회귀이고, 두 클래스면 시그모이드가 된다.
- 학습은 실제 위험 대신 경험적 위험을 최소화하며, 그 차이에서 과적합과 과소적합이 생긴다.