- UC Berkeley CS 182 (Spring 2021) 3강 정리
- 강의: Sergey Levine
- 관련 Discussion: Discussion 2
편향-분산 트레이드오프
출발점: 경험적 위험과 실제 위험
지난 강의에서 학습은 실제 위험 \(\mathbb{E}_{x, y}[\mathcal{L}(x, y, \theta)]\) 대신 경험적 위험 \(\frac{1}{n}\sum_i \mathcal{L}(x_i, y_i, \theta)\)를 최소화한다고 했다. 경험적 위험이 낮은데 실제 위험이 높으면 과적합, 둘 다 높으면 과소적합이다. 이번 강의는 이 현상을 더 정식으로 분석한다.
회귀로 분석하기
분석을 단순하게 하려고 분류 대신 회귀(regression) 를 다룬다. 내용은 분류에도 그대로 적용되며, 회귀가 유도하기 더 쉬울 뿐이다. 회귀에서는 출력이 연속값이므로 출력 분포를 정규(가우시안) 분포로 둔다.
\[p_\theta(y \mid x) = \mathcal{N}(f_\theta(x), \Sigma)\]\(\Sigma\)를 고정하면 로그우도는 상수와 배율을 빼고 \(-\frac{1}{2}\lVert f_\theta(x) - y \rVert^2\)이 된다. 즉 NLL 최소화는 평균제곱오차(MSE) 최소화와 같다.
데이터셋이 바뀌면 오차는 어떻게 바뀌는가
같은 분포에서 뽑은 서로 다른 학습 집합으로 여러 번 학습한다고 하자.
- 과적합의 경우, 학습 데이터에는 잘 맞지만 실제 함수에는 잘 맞지 않고, 학습된 함수가 매번 다르게 생겼다.
- 과소적합의 경우, 학습 데이터에도 실제 함수에도 잘 맞지 않지만, 학습된 함수는 매번 비슷하다. 데이터셋을 모두 합쳐 학습해도 비슷한 모양이다.
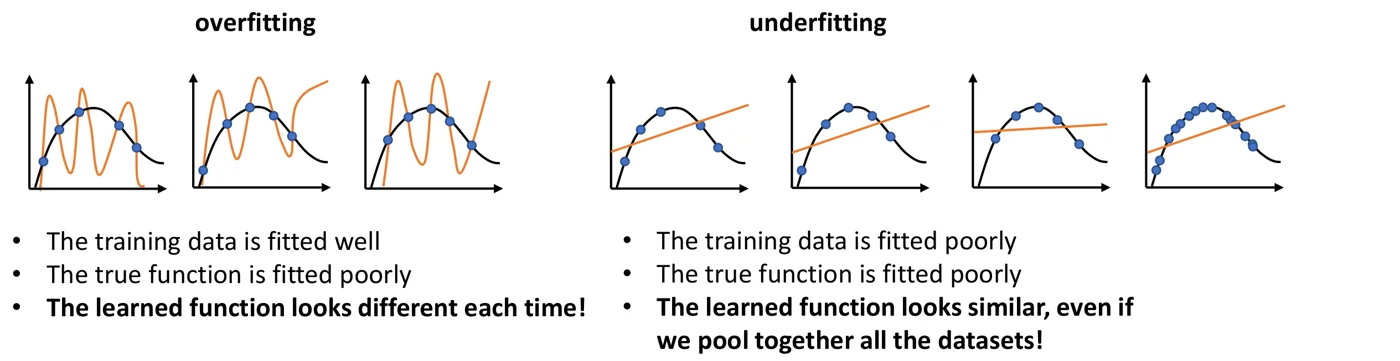 검은 곡선은 실제 함수, 파란 점은 매번 새로 뽑은 학습 데이터, 주황 곡선은 그 데이터로 학습한 함수다. 왼쪽 세 그림은 과적합, 오른쪽 네 그림은 과소적합의 예다. 출처: CS 182 Lecture 3 slides.
왼쪽 세 그림에서 주황 곡선은 파란 점을 모두 정확히 지나지만, 점과 점 사이에서 크게 출렁이고 그 출렁임의 모양이 데이터셋마다 완전히 다르다. 오른쪽 그림에서는 주황색 직선이 데이터를 잘 따라가지 못하지만, 어느 데이터셋으로 학습해도 비슷한 기울기의 직선이 나온다. 맨 오른쪽 그림은 모든 데이터셋을 합쳐 점을 훨씬 많이 준 경우인데, 그래도 직선은 곡선을 따라가지 못한다. 직선이라는 모델 집합 자체의 한계이기 때문이다. 이 두 종류의 차이가 아래에서 각각 분산과 편향으로 정식화된다.
이 차이를 수식으로 잡으려면, 특정 데이터셋이 아니라 데이터셋의 분포에 대한 기대 오차를 봐야 한다. 이는 알고리즘이 무작위로 주어진 데이터셋과 무관하게 얼마나 잘 작동하는지를 알려 주며, 알고리즘을 개선하는 데 중요하다.
데이터셋 \(\mathcal{D} = \{(x_i, y_i)\}_{i=1}^N\)은 \(p(\mathcal{D}) = \prod_{i=1}^N p(x_i)\, p(y_i \mid x_i)\)에서 나온다. \(\mathcal{D}\)로 학습한 함수를 \(f_\mathcal{D}\), 실제 함수를 \(f\)라 하면, 고정된 \(x\)에서의 기대 오차는 다음과 같다.
\[\mathbb{E}_{\mathcal{D} \sim p(\mathcal{D})} \left[ \lVert f_\mathcal{D}(x) - f(x) \rVert^2 \right] = \sum_\mathcal{D} p(\mathcal{D}) \lVert f_\mathcal{D}(x) - f(x) \rVert^2\]분해
평균 예측 \(\bar{f}(x) = \mathbb{E}_{\mathcal{D} \sim p(\mathcal{D})}[f_\mathcal{D}(x)]\)를 정의하고 더했다 뺀다.
\[\begin{aligned} \mathbb{E}_\mathcal{D}\left[\lVert f_\mathcal{D}(x) - f(x) \rVert^2\right] &= \mathbb{E}_\mathcal{D}\left[\lVert (f_\mathcal{D}(x) - \bar{f}(x)) + (\bar{f}(x) - f(x)) \rVert^2\right] \\ &= \mathbb{E}_\mathcal{D}\left[\lVert f_\mathcal{D}(x) - \bar{f}(x) \rVert^2\right] + \lVert \bar{f}(x) - f(x) \rVert^2 \\ &\quad + 2\, \mathbb{E}_\mathcal{D}\left[f_\mathcal{D}(x) - \bar{f}(x)\right]^T (\bar{f}(x) - f(x)) \end{aligned}\]\(\bar{f}(x) - f(x)\)는 \(\mathcal{D}\)와 무관하므로 기댓값 밖으로 나오고, \(\mathbb{E}_\mathcal{D}[f_\mathcal{D}(x) - \bar{f}(x)] = 0\)이므로 교차항이 사라진다. 결과는 다음과 같다.
\[\mathbb{E}_\mathcal{D}\left[\lVert f_\mathcal{D}(x) - f(x) \rVert^2\right] = \underbrace{\mathbb{E}_\mathcal{D}\left[\lVert f_\mathcal{D}(x) - \bar{f}(x) \rVert^2\right]}_{\text{Variance}} + \underbrace{\lVert \bar{f}(x) - f(x) \rVert^2}_{\text{Bias}^2}\]- 분산(variance): 실제 함수가 무엇이든, 데이터셋에 따라 예측이 얼마나 바뀌는가.
- 편향(bias)의 제곱: 평균 예측이 실제 함수와 얼마나 다른가. 이 오차는 데이터를 아무리 많이 모아도 사라지지 않는다. 예를 들어 곡선을 직선으로 맞추면 생기는 오차다.
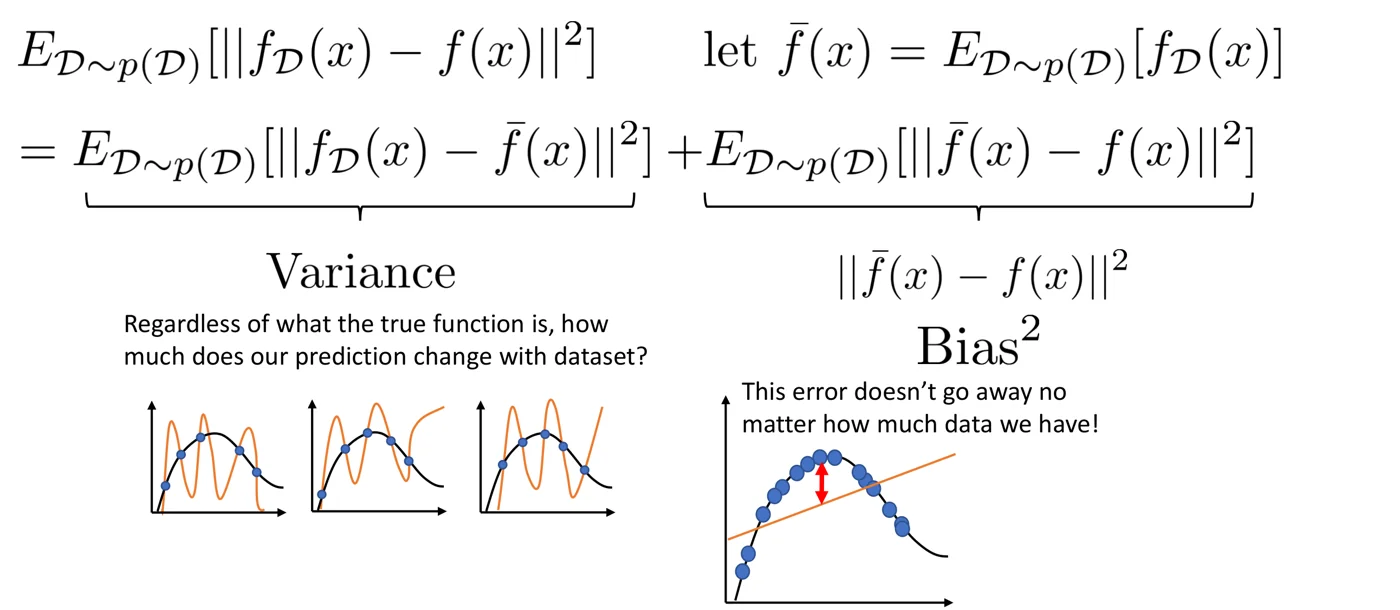 편향-분산 분해. 왼쪽 항(분산)은 데이터셋에 따라 예측이 얼마나 흔들리는지, 오른쪽 항(편향 제곱)은 평균 예측 \(\bar{f}(x)\)와 실제 함수 사이의 거리다. 출처: CS 182 Lecture 3 slides.
그림의 아래 예시가 두 항을 직관적으로 보여 준다. 분산 아래의 세 그림은 앞의 과적합 그림과 같다. 주황 곡선들의 평균 \(\bar{f}\)를 그리면 실제 함수와 꽤 가까울 수 있지만, 개별 \(f_\mathcal{D}\)가 그 평균 주위로 크게 흩어져 있으므로 분산이 크다. 편향 아래의 그림에서는 점이 아주 많아도 직선과 곡선 사이에 빨간 화살표만큼의 간격이 남는다. 이 간격은 데이터셋이 바뀌어도 거의 변하지 않으므로 분산은 작지만, \(\lVert \bar{f}(x) - f(x) \rVert^2\)이 크다. 오른쪽 항에서 기댓값 기호가 사라지는 것은 \(\bar{f}(x) - f(x)\)가 \(\mathcal{D}\)에 의존하지 않기 때문이다.
(관측 잡음까지 포함한 분해는 Discussion 2에서 다룬다.)
과적합과 과소적합의 재해석
- 분산이 너무 크면 데이터가 너무 적거나 함수 집합이 너무 복잡한 것이다. 이것이 과적합이다.
- 편향이 너무 크면 함수 집합이 충분히 복잡하지 않은 것이다. 이것이 과소적합이다.
그렇다면 편향과 분산 사이의 균형은 어떻게 조절하는가?
정규화
편향과 분산을 조절하는 방법
- 데이터를 더 모은다. 분산을 줄이지만 편향에는 영향이 없다.
- 모델 집합을 바꾼다. 예를 들어 12차 다항식 대신 선형 함수를 쓴다. 하지만 이는 거친 조정이다.
모델 집합을 “매끄럽게” 제한할 수는 없을까? 복잡도를 조절하는 연속적인 손잡이가 있으면 좋겠다.
정규화의 직관
정규화(regularization) 는 분산을 줄이기 위해 손실 함수에 더하는 항이다. 분산이 크다는 것은 데이터가 매개변수를 결정하기에 충분한 정보를 주지 못한다는 뜻이다. 그렇다면 손실 함수를 통해 정보를 더 줄 수 있다. 학습 오차가 모두 0인, 거의 똑같이 좋은 여러 해 가운데 어느 것이 더 나은지 가릴 정보를 주면 그중 최선을 고를 수 있다. 예를 들어 데이터 점을 모두 지나는 여러 곡선 중 매끄러운 곡선을 고르게 하는 것이다.
베이즈 관점
정규화는 매개변수에 대한 사전분포(prior) 로 해석할 수 있다(유일한 해석은 아니다). 데이터 \(\mathcal{D}\)가 주어졌을 때 가장 그럴듯한 \(\theta\)를 묻는다면 베이즈 정리를 쓴다.
\[p(\theta \mid \mathcal{D}) = \frac{p(\theta, \mathcal{D})}{p(\mathcal{D})} \propto p(\mathcal{D} \mid \theta)\, p(\theta)\]\(p(\mathcal{D} \mid \theta) = \prod_i p(x_i)\, p_\theta(y_i \mid x_i)\)는 이미 본 우도이고, \(p(\theta)\)는 \(\mathcal{D}\)를 보기 전에 \(\theta\)가 얼마나 그럴듯한지를 나타내는 사전분포다. 로그를 취하고 부호를 바꾸면 손실은 다음과 같다.
\[\mathcal{L}(\theta) = -\left( \sum_{i=1}^{N} \log p(y_i \mid x_i, \theta) \right) - \log p(\theta)\]앞부분은 기존 NLL이고, 뒷부분 \(-\log p(\theta)\)는 우리가 고르는 항이다. 매끄러운 함수를 더 그럴듯하게 만드는 사전분포를 고르면 된다.
예: 정규화된 선형 회귀
매우 구불구불한 함수를 표현하려면 보통 큰 계수가 필요하다. 작은 계수만 허용하면 최적 해가 더 매끄러워진다. 작은 수에 높은 확률을 주는 분포로 평균 0의 가우시안 \(p(\theta) = \mathcal{N}(0, \sigma^2 I)\)를 쓴다.
\[\log p(\theta) = \sum_{i=1}^{D} \left( -\frac{1}{2}\frac{\theta_i^2}{\sigma^2} - \log \sigma - \frac{1}{2}\log 2\pi \right) = -\lambda \lVert \theta \rVert^2 + \text{const}, \qquad \lambda = \frac{1}{2\sigma^2}\]뒤의 상수는 \(\theta\)에 영향을 주지 않는다. 출력 공분산을 단위행렬로 두면 손실은 다음과 같다.
\[\mathcal{L}(\theta) = \left( \sum_{i=1}^{N} \lVert f_\theta(x_i) - y_i \rVert^2 \right) + \lambda \lVert \theta \rVert^2\]\(\lambda\)는 하이퍼파라미터(hyperparameter) 다. \(\sigma\)로부터 유도할 수도 있지만 실제로는 \(\lambda\)를 직접 고른다.
예: 정규화된 로지스틱 회귀
분류에서도 정규화가 필요하다. 선형 분리 가능한 데이터에서 로지스틱 회귀는 모든 점을 맞히고 확률을 1에 가깝게 만들기 위해 \(\theta\)의 크기를 무한히 키우려 한다. 그 결과 기술적으로는 모든 점이 올바르게 분류되지만, 경계가 원하는 위치와 다르고 지나치게 확신하는 모델이 된다. 같은 가우시안 사전분포를 쓰면 다음과 같다.
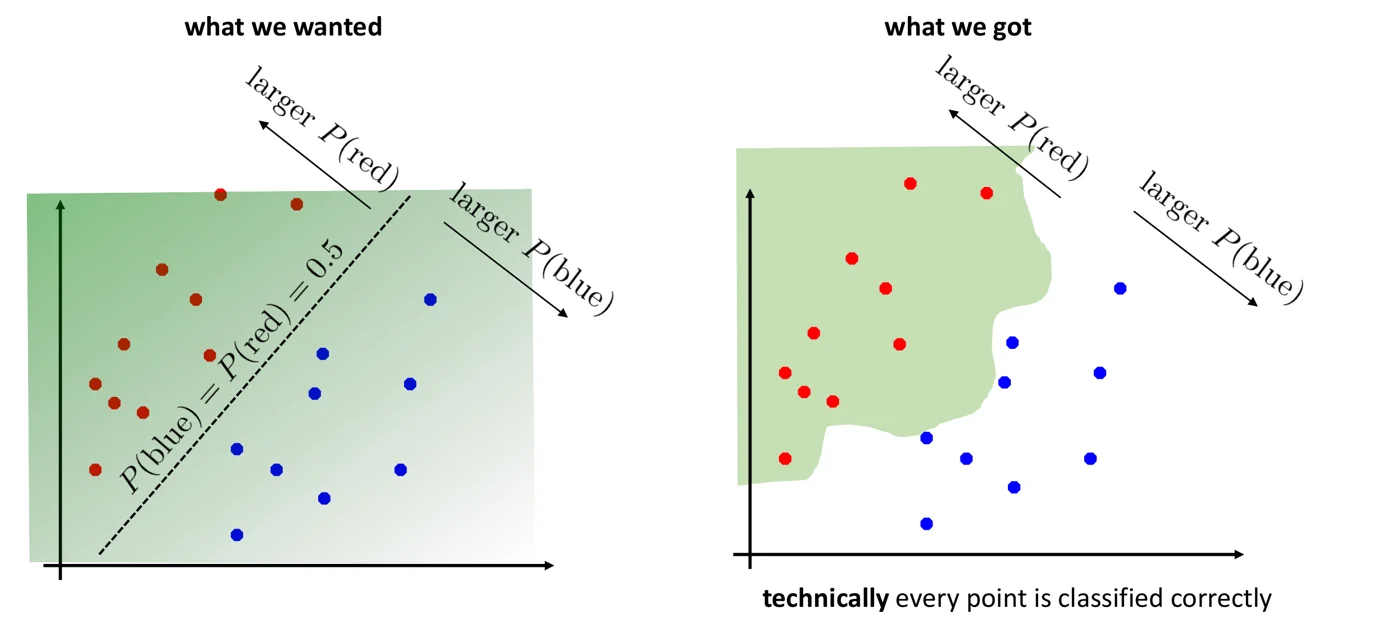 정규화 없는 로지스틱 회귀. 왼쪽은 원했던 결과(완만하게 변하는 확률과 대각선 결정 경계), 오른쪽은 실제로 얻을 수 있는 결과(모든 점을 맞히지만 경계가 데이터에 딱 붙은 모양)다. 출처: CS 182 Lecture 3 slides.
왼쪽 그림에서는 점선 \(P(\text{blue}) = P(\text{red}) = 0.5\)을 기준으로 위쪽은 빨강일 확률이, 아래쪽은 파랑일 확률이 점점 커지며, 색의 농도가 그 변화를 나타낸다. 오른쪽 그림에서는 녹색 영역의 경계가 빨간 점과 파란 점 사이를 비집고 지나간다. 엄밀히 말하면 학습 점은 모두 올바르게 분류되지만, 경계 모양이 현재 데이터에 과하게 맞춰져 있고 확률도 0 또는 1로 극단적이다. 새 점이 경계 근처에 오면 이 모델은 틀린 답을 매우 확신하며 내놓는다. \(\lambda \lVert \theta \rVert^2\) 항은 \(\theta\)의 크기를 억제해 확률 곡선을 완만하게 유지하므로 왼쪽 그림에 가까운 해를 고르게 한다.
\[\mathcal{L}(\theta) = -\left( \sum_{i=1}^{N} \log p(y_i \mid x_i, \theta) \right) + \lambda \lVert \theta \rVert^2\]이 항을 가중치 감쇠(weight decay) 라고도 한다.
다른 정규화 항
- L2 정규화: \(\lambda \sum_{i=1}^{D} \theta_i^2\). 위의 가우시안 사전분포에 해당한다.
- L1 정규화: \(\lambda \sum_{i=1}^{D} \lvert \theta_i \rvert\). 등고선이 마름모 모양이어서 일부 차원을 정확히 0으로 만드는 경향이 있다(희소성).
- 드롭아웃(dropout): 신경망을 위한 특별한 정규화 방법이다.
- 그래디언트 페널티(gradient penalty): GAN을 위한 특별한 정규화 방법이다.
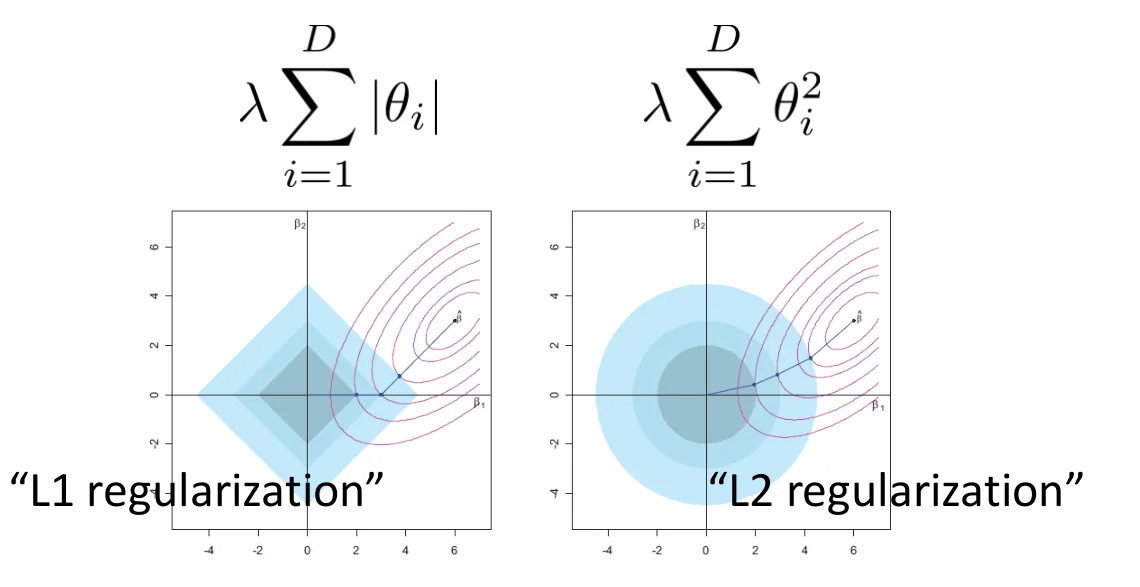 L1과 L2 정규화의 기하학적 비교. 하늘색 영역은 정규화 항의 등고선(L1은 마름모, L2는 원), 보라색 타원은 데이터 손실의 등고선, 파란 선은 정규화 세기에 따라 해가 움직이는 경로다. 출처: CS 182 Lecture 3 slides.
정규화된 손실의 최솟값은 데이터 손실의 등고선과 정규화 항의 등고선이 맞닿는 곳에서 생긴다. 왼쪽 L1 그림에서 마름모는 축 위에 뾰족한 꼭짓점이 있으므로, 타원이 마름모에 처음 닿는 지점이 꼭짓점, 즉 \(\beta_2 = 0\)인 점이 되기 쉽다. 그림의 파란 경로도 \(\lambda\)가 커지면 가로축 위로 내려앉아 \(\beta_2\)가 정확히 0이 된다. 오른쪽 L2 그림의 원에는 꼭짓점이 없으므로 접점이 축 위에 오는 일이 드물고, 경로는 두 좌표를 함께 줄이며 원점으로 다가간다. L1이 희소한 해를 주고 L2는 모든 계수를 고르게 줄이는 이유가 이것이다.
정규화를 보는 여러 관점
- 베이즈 관점: 정규화 항은 매개변수에 대한 사전 지식이다.
- 수치적 관점: 정규화 항은 해가 유일하지 않은(underdetermined) 문제를 해가 잘 정해지는 문제로 만든다.
- 최적화 관점: 정규화 항은 손실 지형을 탐색하기 쉽게 만든다. 그래서 역설적으로, 과소적합이 최적화 문제 때문이었다면 정규화가 과소적합을 줄이기도 한다. GAN에서 특히 흔하다.
머신러닝에서는 데이터에 의존하지 않고 손실에 더하는 “휴리스틱” 항을 일반적으로 정규화 항이라 부른다. 정규화 항은 잘 작동하도록 골라야 하는 하이퍼파라미터를 새로 도입한다.
학습 집합, 검증 집합, 테스트 집합
무엇을 기준으로 고르는가
과적합인지 과소적합인지 어떻게 아는가? 어떤 알고리즘과 하이퍼파라미터를 쓸지 어떻게 고르는가? 손실을 가장 낮게 만드는 것을 고르면 될 것 같지만, 학습 손실만 봐서는 과적합을 진단할 수 없다. 과적합이란 학습 손실은 낮은데 실제 위험이 높은 상태이기 때문이다.
검증 집합
데이터셋을 둘로 나눈다.
- 학습 집합(training set): 매개변수를 학습(최적화)하는 데 쓴다.
- 검증 집합(validation set): 학습에 쓰지 않고 따로 둔다. 하이퍼파라미터 선택, 특징 추가/제거, 모델 집합 조정에 쓴다.
검증 집합은 학습에 쓰이지 않았으므로 그 위의 손실은 실제 위험의 추정치가 된다.
학습 곡선
경사하강법 스텝 수에 따른 손실을 그린 것이 학습 곡선(learning curve) 이다.
- 학습 손실과 검증 손실이 모두 높은 수준에서 멈추면, 그 높이가 곧 편향이다. 과소적합이다.
- 학습 손실은 계속 내려가는데 검증 손실이 어느 시점부터 올라가면 과적합이다. 검증 손실이 최소인 지점에서 멈추는 것을 생각할 수 있으며, 언제 멈출지는 검증 손실로 정한다.
기말 시험: 테스트 집합
이 절차를 따라 최종 분류기를 얻었다고 하자. 성능을 무엇으로 보고하는가? 검증 집합은 안 된다. 이미 하이퍼파라미터를 고르는 데 썼으므로, 검증 손실은 낙관적으로 편향되어 있다. 그래서 일종의 “검증의 검증” 집합인 테스트 집합(test set) 을 하나 더 떼어 둔다. 테스트 집합은 최종 성능을 보고할 때만 쓴다.
정리하면 다음과 같다.
- 학습 집합: 매개변수 \(\theta\)를 고른다.
- 검증 집합: 하이퍼파라미터(예: \(\lambda\))와 모델 설계를 고른다.
- 테스트 집합: 최종 성능 보고에만 쓰고, 다른 어떤 선택에도 쓰지 않는다.
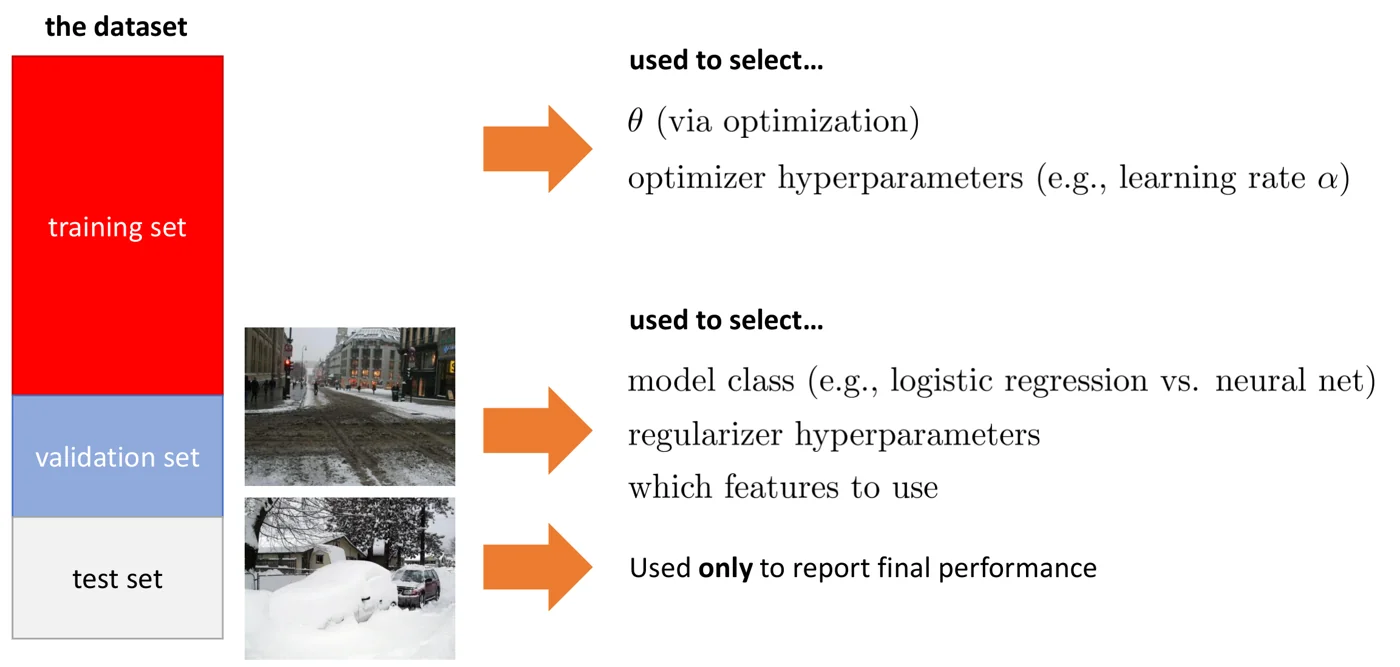 머신러닝 작업 흐름. 데이터셋을 학습, 검증, 테스트 집합으로 나누고, 각 집합이 어떤 선택에 쓰이는지 화살표로 표시했다. 출처: CS 182 Lecture 3 slides.
그림에서 가장 큰 빨간 부분인 학습 집합은 최적화로 \(\theta\)를 정하고, 학습률 같은 최적화기 하이퍼파라미터를 조정하는 데 쓴다. 파란 검증 집합은 모델 집합(예: 로지스틱 회귀 대 신경망), 정규화 하이퍼파라미터 \(\lambda\), 사용할 특징처럼 학습 손실로는 판단할 수 없는 선택에 쓴다. 맨 아래 회색 테스트 집합에서 나가는 화살표는 “최종 성능 보고”뿐이다. 테스트 집합을 보고 하나라도 결정을 바꾸면 그 집합도 검증 집합이 되어 버리고, 보고하는 성능이 낙관적으로 편향된다.
정리
- 데이터셋 분포에 대한 기대 제곱오차는 분산 \(\mathbb{E}_\mathcal{D}\lVert f_\mathcal{D}(x) - \bar{f}(x) \rVert^2\)과 편향 제곱 \(\lVert \bar{f}(x) - f(x) \rVert^2\)의 합이다.
- 분산이 크면 과적합(용량이 크고 데이터의 정보가 부족함), 편향이 크면 과소적합(표현력이 부족함)이다. 데이터를 늘리면 분산만 줄어든다.
- 정규화는 분산을 줄이기 위해 손실에 더하는 항이며, 베이즈 관점에서는 사전분포 \(-\log p(\theta)\)다. 가우시안 사전분포는 L2 정규화(가중치 감쇠) \(\lambda \lVert \theta \rVert^2\)을 준다.
- L1 정규화는 희소한 해를 선호하고, 드롭아웃과 그래디언트 페널티도 정규화의 일종이다. 정규화는 수치적, 최적화 관점에서도 해석된다.
- 학습 집합은 매개변수 학습에, 검증 집합은 하이퍼파라미터 선택에, 테스트 집합은 최종 성능 보고에만 쓴다.