- Stanford CS229 Machine Learning (Spring 2022) 1강 정리
- 강의: Tengyu Ma, Christopher Ré
- ▶ 강의 영상
- 참고: CS229 lecture notes, Part I 도입부와 목차
머신러닝이란
머신러닝(machine learning)은 프로그램이 규칙을 사람이 일일이 적어 주는 대신 데이터로부터 규칙을 학습하게 하는 방법이다. 학습 알고리즘(learning algorithm)은 데이터를 입력받아 예측이나 결정을 내리는 함수를 출력한다. 무엇을 데이터로 주고 무엇을 출력으로 원하는지에 따라 문제의 종류가 나뉜다. CS229는 이를 크게 지도 학습, 비지도 학습, 강화 학습의 세 갈래로 다룬다.
지도 학습
집값 예측 예제
강의 노트는 지도 학습(supervised learning)을 미국 포틀랜드의 주택 47채 데이터로 시작한다. 각 집의 거실 면적(제곱피트)과 가격(천 달러)이 주어진다.
| 거실 면적 (feet²) | 가격 (1000$) |
|---|---|
| 2104 | 400 |
| 1600 | 330 |
| 2400 | 369 |
| 1416 | 232 |
| 3000 | 540 |
표의 다섯 줄만 봐서는 경향이 잘 보이지 않으므로, 노트는 47채 전체를 좌표평면에 찍어 본다.
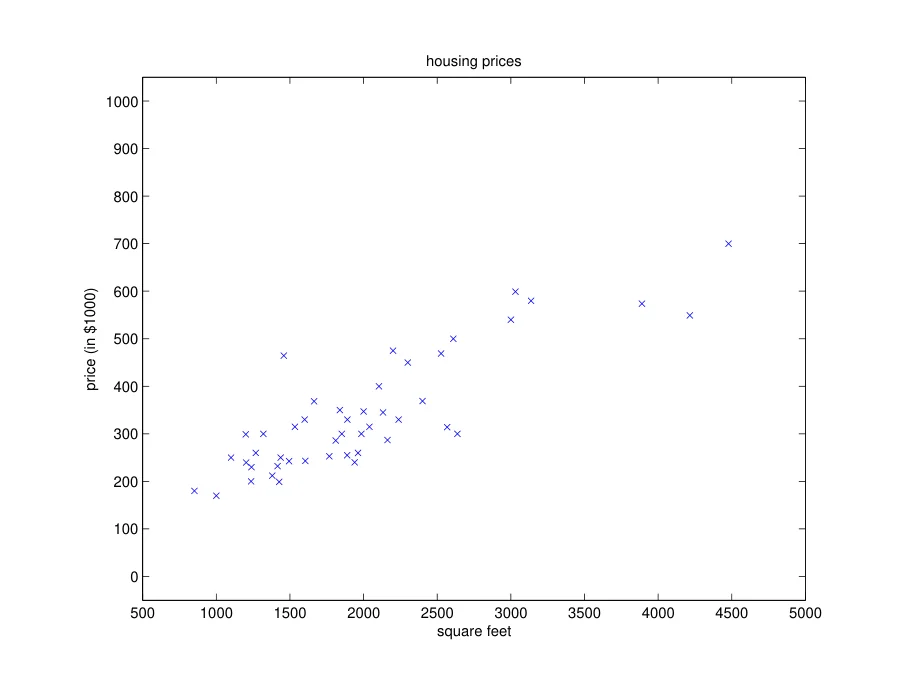 포틀랜드 주택 47채의 거실 면적(가로축, 제곱피트)과 가격(세로축, 천 달러)을 점으로 찍은 그림이다. 면적이 클수록 가격이 대체로 높지만 점들이 한 직선 위에 정확히 놓이지는 않는다. 출처: CS229 lecture notes.
그림에서 점 하나(×)가 집 한 채, 즉 학습 예제 하나다. 가로 좌표가 입력인 면적이고 세로 좌표가 정답 가격이다. 점들은 왼쪽 아래에서 오른쪽 위로 뻗은 띠 모양으로 모여 있으므로, “면적이 커지면 가격도 오른다”는 대략적인 규칙이 데이터에 들어 있다. 다만 같은 면적이라도 가격이 100~200천 달러씩 차이 나는 점들이 있다. 위치, 침실 수, 집의 상태처럼 면적에 담기지 않은 요인이 가격에 영향을 주기 때문이다. 따라서 학습의 목표는 모든 점을 정확히 통과하는 함수가 아니라, 이 띠의 경향을 잘 잡아 새 집의 가격을 그럴듯하게 맞히는 함수다.
이런 데이터가 있을 때, 면적만 보고 다른 집의 가격을 예측하는 함수를 배우는 것이 목표다. 데이터의 각 쌍에는 “정답” 가격이 붙어 있으므로 이를 지도(supervision) 로 삼는다는 뜻에서 지도 학습이라 한다.
기본 틀
입력을 \(x\), 예측하려는 출력(타깃)을 \(y\)라 하고, 정답이 붙은 예제 \((x, y)\)들의 모음인 학습 집합(training set)이 주어진다. 학습 알고리즘은 학습 집합을 받아 가설(hypothesis)이라 부르는 함수 \(h\)를 출력하고, 새 입력 \(x\)가 들어오면 \(h(x)\)로 \(y\)를 예측한다.
\[\text{학습 집합} \;\longrightarrow\; \text{학습 알고리즘} \;\longrightarrow\; h, \qquad x \;\longmapsto\; h(x) \approx y\]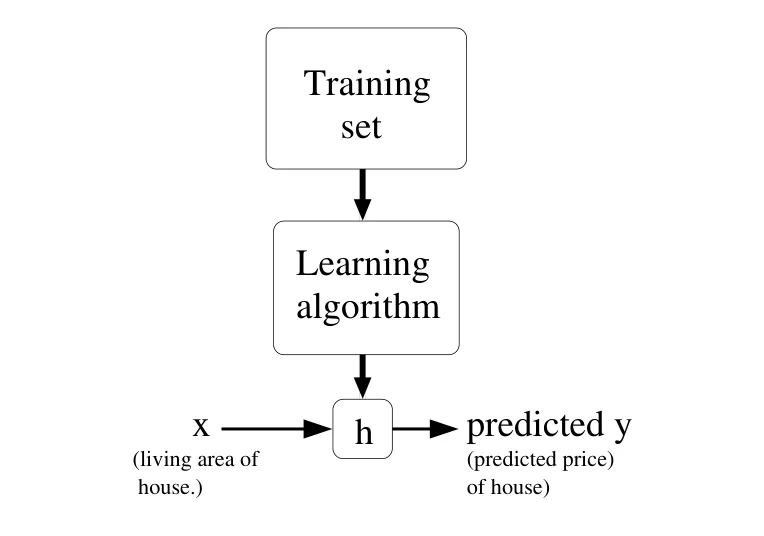 지도 학습의 흐름을 그린 그림이다. 학습 집합이 학습 알고리즘에 들어가 가설 \(h\)가 나오고, \(h\)는 새 집의 면적 \(x\)를 받아 예측 가격 \(y\)를 내놓는다. 출처: CS229 lecture notes.
그림은 위에서 아래로 두 단계를 보여 준다. 위쪽 두 상자는 학습 단계다. 정답이 붙은 예제 묶음(training set)이 학습 알고리즘에 들어가고, 알고리즘은 그 결과물로 함수 \(h\) 하나를 만든다. 아래쪽 가로 화살표는 예측 단계다. 학습이 끝난 뒤에는 학습 집합이 더 이상 필요 없고, 새 입력 \(x\)(거실 면적)를 \(h\)에 넣기만 하면 예측값 \(y\)(예상 가격)가 나온다.
이 구분은 이후 강의 전체에 그대로 쓰인다. 선형 회귀, 로지스틱 회귀, 신경망은 모두 “\(h\)를 어떤 함수 꼴로 정하고, 학습 알고리즘이 그 매개변수를 어떻게 고르는가”라는 같은 질문에 대한 서로 다른 답이다.
표기와 손실 함수 같은 형식적인 정의는 2강에서 선형 회귀와 함께 정리한다.
회귀와 분류
지도 학습은 출력 \(y\)의 종류에 따라 둘로 나뉜다.
- 회귀(regression): \(y\)가 연속값이다. 집값 예측이 대표적이다.
- 분류(classification): \(y\)가 소수의 이산값 중 하나다. 예를 들어 면적을 보고 그 건물이 단독주택인지 아파트인지 맞히는 문제, 이메일이 스팸인지 아닌지 판별하는 문제가 분류다.
입력도 하나의 숫자일 필요는 없다. 면적에 더해 침실 수, 욕실 수 등을 함께 쓰면 \(x\)는 여러 특성(feature)을 담은 벡터가 된다. 어떤 특성을 쓸지 고르는 일 자체가 학습 성능에 큰 영향을 준다. 이미지나 문장처럼 차원이 매우 높은 입력도 같은 틀에서 다룬다.
비지도 학습
비지도 학습(unsupervised learning)에서는 정답 \(y\) 없이 입력 \(x^{(1)}, \dots, x^{(n)}\)만 주어진다. 목표는 데이터 안의 구조를 찾는 것이다.
- 군집화(clustering): 비슷한 데이터끼리 묶는다(k-means, 가우시안 혼합 모델).
- 차원 축소: 데이터가 실제로 놓인 저차원 부분공간이나 성분을 찾는다(PCA, ICA).
- 표현 학습: 레이블 없는 대규모 데이터로 좋은 표현을 미리 학습하고(자기 지도 학습, self-supervised learning), 이를 여러 다운스트림 작업에 적응시킨다. 대규모 언어 모델 같은 파운데이션 모델(foundation model)이 이 흐름에 속한다.
강화 학습
강화 학습(reinforcement learning)은 한 번의 예측이 아니라 연속된 결정을 다룬다. 에이전트는 상태를 관찰하고 행동을 고르며, 그 결과로 보상을 받는다. 각 단계의 “정답 행동”은 주어지지 않고 보상 신호만 주어지므로, 장기적으로 받는 보상의 합이 커지도록 정책(policy)을 학습해야 한다. 로봇 제어나 게임 플레이가 대표적인 응용이다.
강의의 흐름
CS229 강의 노트는 다음 순서로 구성된다. 이 시리즈의 각 강의도 대체로 이 순서를 따른다.
| 부분 | 주요 내용 | 강의 |
|---|---|---|
| I. 지도 학습 | 선형 회귀, 로지스틱 회귀, GLM, 생성 학습(GDA, 나이브 베이즈), 커널 방법 | 2-7강 |
| II. 딥러닝 | 신경망, 역전파 | 8-9강 |
| III. 일반화와 정규화 | 편향-분산 트레이드오프, 정규화, 모델 선택 | 10-11강 |
| IV. 비지도 학습 | k-means, EM, 인자 분석, PCA, ICA | 12-15강 |
| V. 파운데이션 모델 | 자기 지도 학습, 사전학습과 적응 | 16강 |
| VI. 강화 학습과 제어 | MDP, 가치 반복, 정책 반복, 모델 기반 RL | 17강, 20강 |
지도 학습 부분은 가장 단순한 선형 모델에서 출발해, 같은 원리(확률 모델을 세우고 최대우도로 매개변수를 맞춘다)를 점점 넓은 모델로 확장하는 방식으로 전개된다.
정리
- 머신러닝은 규칙을 직접 코딩하는 대신 데이터로부터 예측 함수를 학습한다.
- 지도 학습은 입력-정답 쌍으로 이루어진 학습 집합에서 가설 \(h\)를 학습해, 새 입력의 출력을 \(h(x)\)로 예측한다.
- 출력이 연속값이면 회귀, 소수의 이산값이면 분류다.
- 비지도 학습은 레이블 없이 데이터의 구조(군집, 저차원 구조, 표현)를 찾는다.
- 강화 학습은 보상 신호만으로 연속된 결정을 내리는 정책을 학습한다.
- 강의는 지도 학습, 딥러닝, 일반화와 정규화, 비지도 학습, 파운데이션 모델, 강화 학습 순으로 진행된다.