- Stanford CS229 Machine Learning (Spring 2022) 10강 정리
- 강의: Tengyu Ma, Christopher Ré
- ▶ 강의 영상
- 참고: CS229 lecture notes Ch. 8 Generalization, Ch. 9 Regularization and model selection(9.1–9.2)
학습 오차와 테스트 오차
지도 학습에서는 학습 손실 \(J(\theta)\), 예컨대 \(\frac{1}{n} \sum_i (y^{(i)} - h_\theta(x^{(i)}))^2\)을 최소화한다. 그러나 학습 손실 최소화는 목표가 아니라 수단이다. 가장 중요한 평가 지표는 처음 보는 예제에서의 오차, 즉 테스트 오차(test error) 다. 테스트 분포 \(\mathcal{D}\)에서 뽑은 예제에 대한 기대 손실로 정의한다.
\[L(\theta) = \mathbb{E}_{(x,y) \sim \mathcal{D}}\left[ (y - h_\theta(x))^2 \right]\]실제로는 많은 테스트 예제의 평균으로 근사한다. 학습 분포를 경험적 분포(empirical distribution), \(\mathcal{D}\)를 모집단 분포(population distribution)라고 하여, 학습 손실을 경험적 위험(empirical risk), 테스트 손실을 모집단 위험(population risk)이라고도 한다.
핵심 차이는 테스트 예제가 학습 과정에서 보이지 않았다는 점이다. 같은 분포에서 뽑았더라도 테스트 오차는 학습 오차와 가깝다는 보장이 없다. 둘의 차이를 일반화 간극(generalization gap) 이라 한다.
- 과적합(overfitting): 학습 오차는 작지만 테스트 오차가 크다.
- 과소적합(underfitting): 학습 오차가 비교적 크다(이때 테스트 오차도 대개 크다).
편향-분산 트레이드오프
예제: 2차 함수 맞추기
학습 입력 \(x^{(i)}\)를 무작위로 뽑고 \(y^{(i)} = h^\star(x^{(i)}) + \xi^{(i)}\), \(\xi^{(i)} \sim \mathcal{N}(0, \sigma^2)\)로 출력을 만든다. \(h^\star\)는 2차 함수다. 노이즈 \(\xi\)는 예측할 수 없으므로 목표는 사실상 \(h^\star\)를 복원하는 것이다.
선형 모델. 최적의 선형 모델도 학습 데이터에서조차 \(y\)를 정확히 예측하지 못한다. 학습 예제를 무한히 늘려도, 노이즈를 없애도 마찬가지다. 병목은 데이터 부족이 아니라 선형 모델군이 2차 함수를 표현하지 못하는 것이다. 비형식적으로, 무한히 큰 학습 데이터에 맞추더라도 남는 테스트 오차를 편향(bias) 이라 한다. 선형 모델은 편향이 크고 과소적합한다.
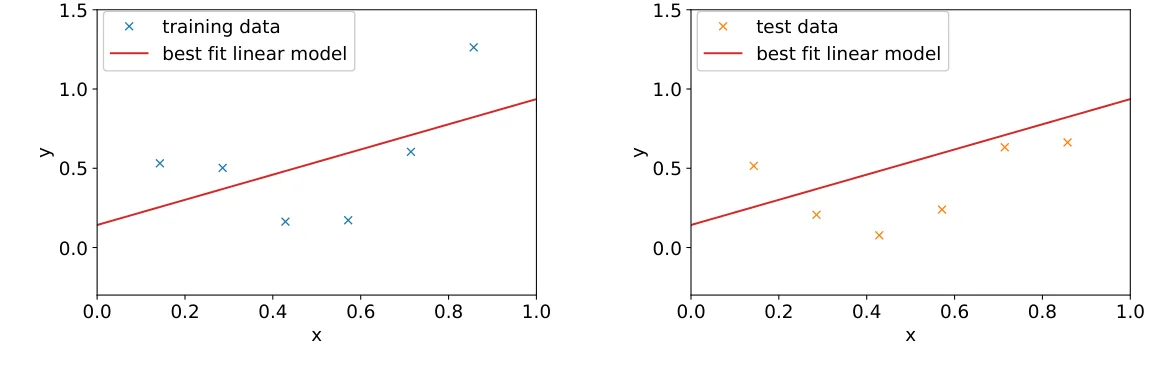 최적의 직선을 학습 데이터(왼쪽)와 테스트 데이터(오른쪽) 위에 그린 그림. 직선은 가운데가 오목한 데이터의 모양을 따라가지 못해 양쪽 모두에서 오차가 크다. 출처: CS229 lecture notes.
왼쪽 그림의 파란 점은 6개의 학습 예제이고, 빨간 직선은 이 점들에 대한 제곱 오차를 최소화한 직선이다. 점들은 \(x \approx 0.4\) 부근이 가장 낮고 양 끝이 높은 U자 모양인데, 직선은 이를 표현할 수 없으므로 가운데 점들 위로, 양 끝 점들 아래로 지나간다. 오른쪽의 주황색 테스트 점에서도 같은 방식으로 빗나간다. 학습 오차와 테스트 오차가 둘 다 크다는 것이 과소적합의 전형적인 모습이다.
5차 다항식. 학습 데이터는 거의 완벽히 맞추지만 테스트 예제에서는 성능이 나쁘다. 그런데 매우 큰 데이터셋에 맞추면 2차 함수에 가까운 정확한 모델을 얻는다. 5차 다항식은 2차 함수를 포함하므로(\(\theta_5 = \theta_4 = \theta_3 = 0\)) 편향이 작다. 문제는 작은 학습 집합에 우연히 존재하는, 주로 노이즈 때문에 생긴 가짜 패턴(spurious pattern) 까지 맞춘다는 것이다. 같은 분포에서 뽑은 서로 다른 데이터셋에 맞춘 5차 다항식들은 서로 매우 다르다. 이렇게 데이터셋의 무작위성에 따라 학습된 모델이 변하는 정도를 분산(variance) 이라 한다.
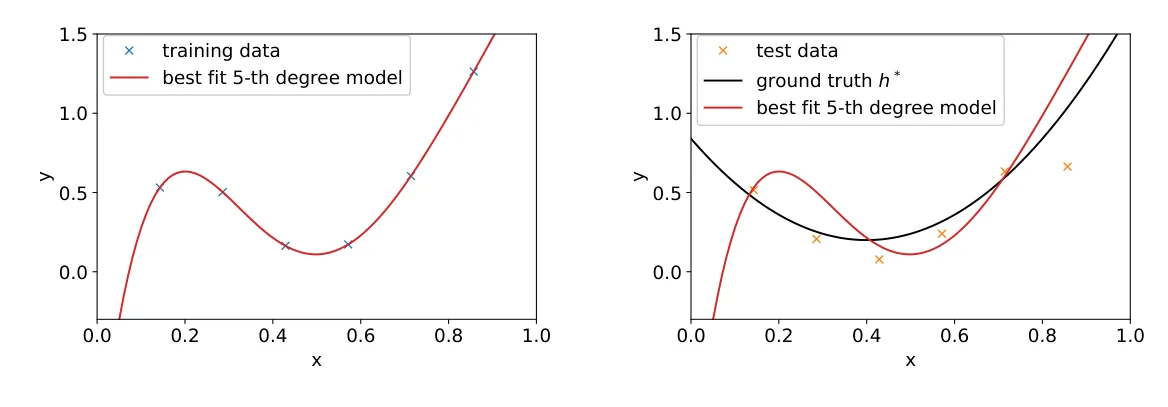 같은 데이터에 5차 다항식을 맞춘 결과. 학습 점은 모두 정확히 지나가지만(왼쪽), 참 함수 \(h^\star\)(검은 곡선)와는 모양이 달라 테스트 점에서 크게 빗나간다(오른쪽). 출처: CS229 lecture notes.
학습 예제가 6개이고 5차 다항식의 매개변수도 6개이므로, 모든 학습 점을 정확히 통과하는 곡선이 존재하고 학습 오차는 0이 된다. 그러나 오른쪽 그림에서 빨간 곡선은 \(x \approx 0.2\)에서 솟았다가 \(x \approx 0.5\)에서 꺼지는 굴곡을 갖는데, 이는 \(h^\star\)(검은 곡선)에는 없는 모양이다. 학습 점의 노이즈에 맞추느라 생긴 굴곡이며, 이 때문에 테스트 오차가 크다. 학습 오차는 작고 테스트 오차는 큰 과적합의 전형이다.
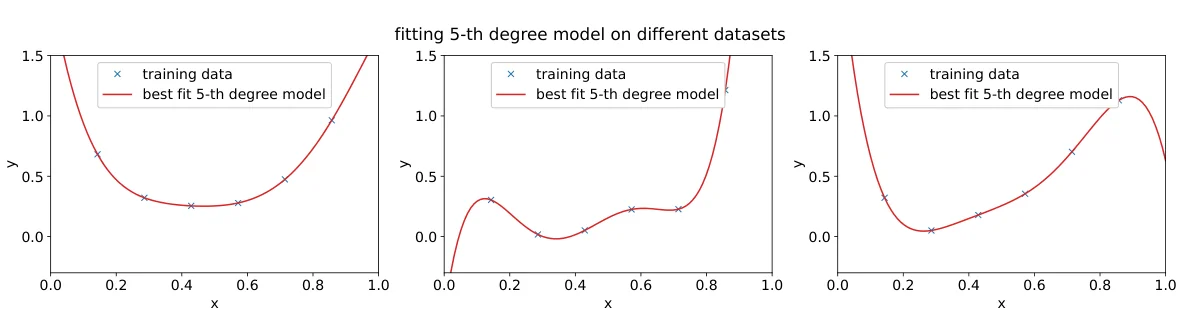 같은 분포에서 뽑은 세 개의 서로 다른 학습 데이터셋에 각각 5차 다항식을 맞춘 결과. 데이터셋마다 학습된 곡선의 모양이 크게 달라 분산이 크다는 것을 보여 준다. 출처: CS229 lecture notes.
세 그림의 데이터는 모두 같은 \(h^\star\)와 같은 노이즈 분포에서 나왔으므로, 이상적인 학습 방법이라면 셋 모두 비슷한 곡선을 내놓아야 한다. 그러나 5차 다항식은 왼쪽에서는 완만한 U자, 가운데에서는 물결 모양, 오른쪽에서는 끝이 꺾이는 모양이 된다. 각 데이터셋에 고유한 가짜 패턴을 따라갔기 때문이다. 분산은 바로 이 “데이터셋을 바꾸었을 때 모델이 얼마나 흔들리는가”를 잰 양이다.
일반적으로 모델이 너무 단순하면 편향이 크고(과소적합), 너무 복잡하면 분산이 크다(과적합). 테스트 오차는 모델 복잡도에 대해 U자 곡선을 그리므로 최적의 균형점을 찾아야 한다. 이 예제에서는 2차 모델이 1차나 5차보다 낫다.
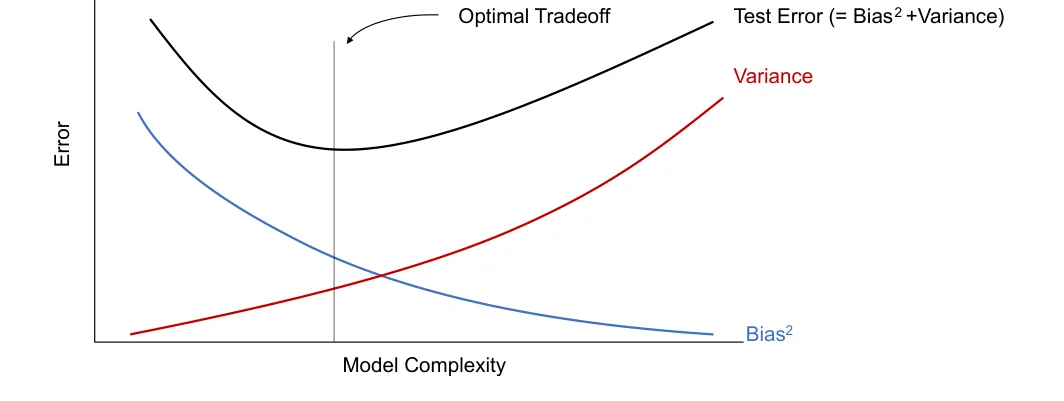 모델 복잡도에 따른 편향의 제곱(파랑), 분산(빨강), 테스트 오차(검정)의 전형적인 모양. 테스트 오차가 가장 작은 지점이 최적의 균형점이다. 출처: CS229 lecture notes.
가로축은 모델 복잡도(예: 다항식의 차수), 세로축은 오차다. 복잡도가 커질수록 모델군의 표현력이 커지므로 편향의 제곱은 단조 감소하고, 맞출 수 있는 가짜 패턴도 많아지므로 분산은 단조 증가한다. 테스트 오차는 이 둘(과 노이즈)의 합이므로 처음에는 편향 감소가 우세해 내려가다가, 어느 지점부터는 분산 증가가 우세해 다시 올라간다. 세로선으로 표시된 최저점이 “Optimal Tradeoff”이며, 이 왼쪽이 과소적합 영역, 오른쪽이 과적합 영역이다. 아래의 수학적 분해가 이 그림의 “테스트 오차 = 편향² + 분산”을 정확히 유도한다.
수학적 분해 (회귀)
다음 설정을 생각한다.
- 학습 데이터셋 \(S = \{(x^{(i)}, y^{(i)})\}_{i=1}^{n}\), \(y^{(i)} = h^\star(x^{(i)}) + \xi^{(i)}\), \(\xi^{(i)} \sim \mathcal{N}(0, \sigma^2)\)를 뽑는다.
- \(S\)로 학습한 모델을 \(\hat{h}_S\)라 한다.
- 고정된 테스트 입력 \(x\)에서 \(y = h^\star(x) + \xi\)를 뽑아 기대 오차를 잰다. \(\text{MSE}(x) = \mathbb{E}_{S, \xi}[(y - \hat{h}_S(x))^2]\)
보조 사실. \(A\)와 \(B\)가 독립이고 \(\mathbb{E}[A] = 0\)이면 \(\mathbb{E}[(A + B)^2] = \mathbb{E}[A^2] + \mathbb{E}[B^2]\)이다. 전개하면 교차항이 \(2\mathbb{E}[A]\mathbb{E}[B] = 0\)이기 때문이다. 특히 상수 \(c\)에 대해 \(\mathbb{E}[(A + c)^2] = \mathbb{E}[A^2] + c^2\)이다.
\(A = \xi\), \(B = h^\star(x) - \hat{h}_S(x)\)로 두면 다음을 얻는다.
\[\text{MSE}(x) = \mathbb{E}[(\xi + (h^\star(x) - \hat{h}_S(x)))^2] = \sigma^2 + \mathbb{E}[(h^\star(x) - \hat{h}_S(x))^2]\]이제 무한히 많은 데이터셋으로 학습해 예측을 평균한 가상의 평균 모델 \(h_{\text{avg}}(x) = \mathbb{E}_S[\hat{h}_S(x)]\)를 정의한다. 많은 경우 이는 무한한 표본을 가진 하나의 데이터셋으로 학습한 모델과 거의 같다. \(c = h^\star(x) - h_{\text{avg}}(x)\)(\(S\)와 무관한 상수), \(A = h_{\text{avg}}(x) - \hat{h}_S(x)\)(\(\mathbb{E}_S[A] = 0\))로 보조 사실을 한 번 더 쓰면 다음과 같다.
\[\text{MSE}(x) = \underbrace{\sigma^2}_{\text{unavoidable}} + \underbrace{(h^\star(x) - h_{\text{avg}}(x))^2}_{\triangleq \, \text{bias}^2} + \underbrace{\text{var}(\hat{h}_S(x))}_{\triangleq \, \text{variance}}\]- 편향의 제곱은 모델군의 표현력 부족에서 오는 오차다. 데이터가 무한해도 줄지 않는다.
- 분산은 유한한 데이터셋의 무작위성이 학습된 모델에 주는 영향이다. 대개 데이터셋이 커질수록 줄어든다.
- \(\sigma^2\)는 노이즈 자체여서 어떻게 해도 줄일 수 없다.
분류 문제의 편향-분산 분해는 회귀만큼 명확하지 않으며, 합의된 형식이 아직 없다.
이중 하강 현상
모델 크기에 따른 이중 하강
전통적 관점에서는 모델 복잡도가 커질수록 테스트 오차가 줄었다가 다시 는다. 그런데 선형 모델과 심층 신경망을 포함한 여러 모델에서 이중 하강(double descent) 이 관찰된다. 테스트 오차가 줄었다가, 모델이 학습 데이터를 거의 다 맞출 수 있는 크기 근처에서 정점을 찍은 뒤, 매개변수 수가 데이터 수보다 많은 과매개변수화(overparameterized) 영역에서 다시 줄어든다. 실용적 함의는 과매개변수화된 모델로 키우는 것을 주저하지 말라는 것이다. 테스트 오차가 이전 최저점보다 더 낮아질 수 있고, 많은 경우 모델이 클수록 계속 좋아진다.
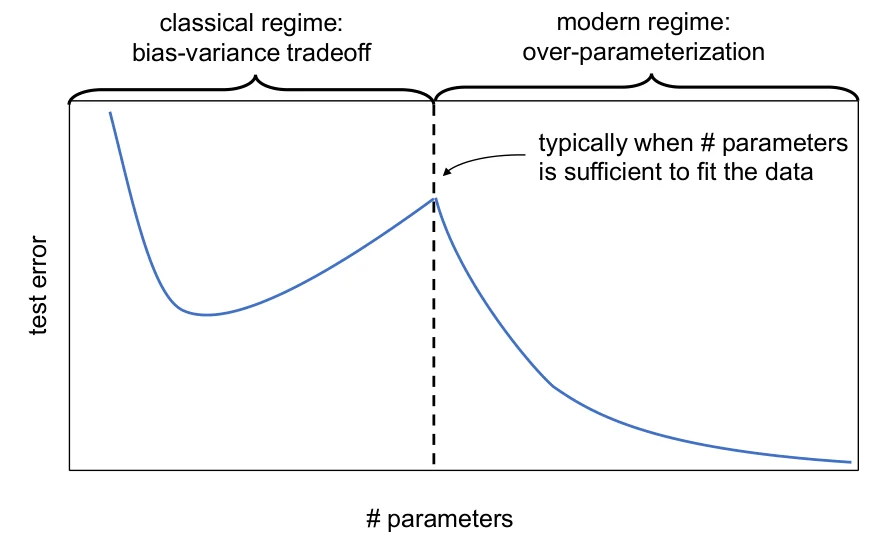 매개변수 수에 따른 테스트 오차의 전형적인 이중 하강 곡선. 점선 왼쪽은 고전적인 편향-분산 트레이드오프 영역, 오른쪽은 과매개변수화 영역이다. 출처: CS229 lecture notes.
그림의 왼쪽 절반은 앞의 U자 곡선과 같다. 매개변수가 늘면서 테스트 오차가 내려갔다가 다시 올라간다. 고전적 관점이라면 여기서 더 키우는 것은 손해다. 그러나 점선, 즉 매개변수 수가 학습 데이터를 정확히 맞추기에 막 충분해지는 지점에서 오차가 정점을 찍은 뒤, 그 오른쪽에서는 다시 꾸준히 내려가 왼쪽의 최저점보다도 낮아진다. 이것이 “두 번째 하강”이며, 큰 신경망이 데이터 수보다 매개변수가 훨씬 많은데도 잘 일반화되는 현상과 맞닿아 있다.
표본 수에 따른 이중 하강
표본이 많을수록 항상 좋을 것 같지만, 표본 수 \(n\)을 늘릴 때 테스트 오차가 줄었다가 \(n \approx d\)(매개변수 수) 근처에서 정점을 찍고 다시 줄어드는 현상도 관찰된다. 두 현상 모두 \(n \approx d\)에서 테스트 오차가 정점을 찍는다는 점에서 본질적으로 같은 현상을 기술한다.
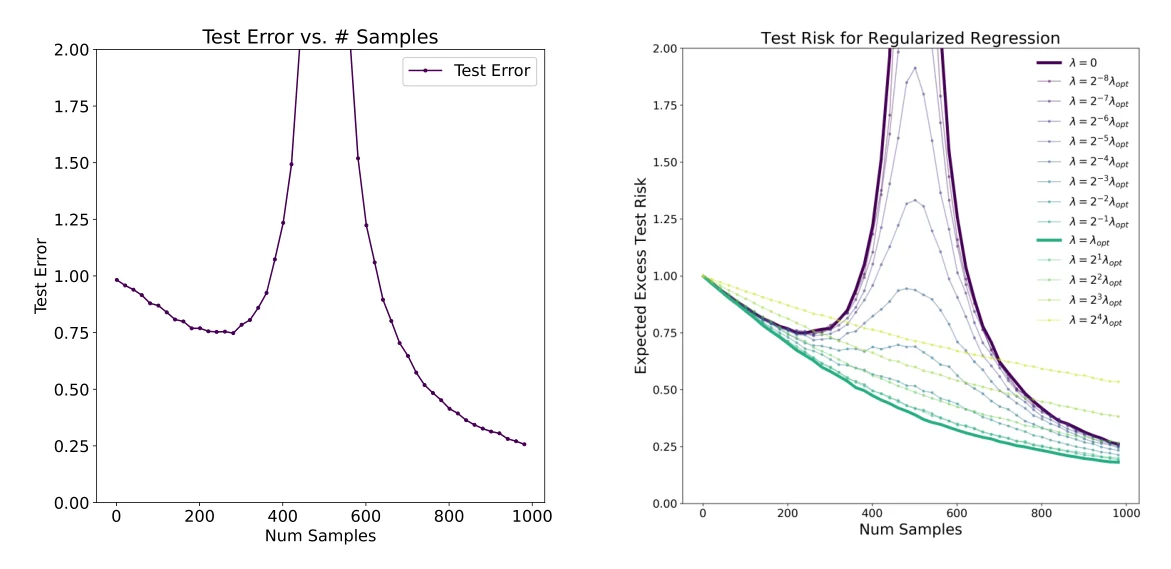 선형 회귀(\(d = 500\))에서 표본 수에 따른 테스트 오차. 왼쪽: 정규화가 없으면 \(n \approx 500\)에서 오차가 치솟는다. 오른쪽: 정규화 강도 \(\lambda\)별 곡선으로, 최적의 \(\lambda\)(진한 초록)에서는 정점이 사라진다. 출처: CS229 lecture notes.
실험 설정은 \(x \sim \mathcal{N}(0, I_d)\), \(y \sim x^\top \beta + \mathcal{N}(0, \sigma^2)\), \(d = 500\)이다. 왼쪽 그림에서 표본이 200~300개일 때까지는 오차가 줄다가, \(n\)이 \(d = 500\)에 가까워지면 급격히 커지고, 그 뒤로는 다시 줄어든다. 즉 표본을 400개에서 500개로 늘리면 오히려 성능이 나빠진다.
오른쪽 그림은 같은 실험을 릿지 정규화 강도 \(\lambda\)를 바꿔 가며 반복한 것이다. \(\lambda = 0\)(가장 진한 보라)은 왼쪽과 같은 뾰족한 정점을 보이고, \(\lambda\)를 키울수록 정점이 낮아진다. 각 \(n\)마다 최적으로 고른 \(\lambda_{opt}\)(굵은 초록)에서는 곡선이 단조 감소한다. 반대로 \(\lambda\)가 지나치게 크면(연한 노랑) 정점은 없지만 전체적으로 오차가 높다. 이는 아래 설명, 즉 정점이 학습 알고리즘의 정규화 부족에서 온다는 해석을 뒷받침한다.
설명과 완화
\(n \approx d\)의 정점은 실험에 쓰인 학습 알고리즘이 그 영역에서 최적과 거리가 멀다는 뜻이다. 일부 예제를 버리고 학습하는 편이 나을 정도이기 때문이다. 실제로 정규화 강도를 최적으로 조정하면 \(n \approx d\)에서의 테스트 오차가 크게 개선되고 두 종류의 이중 하강이 모두 완화된다.
이는 정점을 설명할 뿐, 과매개변수화 영역의 두 번째 하강은 설명하지 못한다. 대표적인 설명은 경사하강법 같은 옵티마이저의 암묵적 정규화(implicit regularization) 다(아래 참고). 예를 들어 \(n \ll d\)인 선형 모델에서 0으로 초기화한 경사하강법은 데이터를 맞추는 임의의 해가 아니라 최소 노름 해(minimum norm solution) 를 찾는다. 최소 노름은 과매개변수화 영역에서는 충분히 좋은 정규화지만 \(n \approx d\)에서는 그렇지 않아 정점이 생긴다.
또 이중 하강은 주로 매개변수 수를 복잡도로 잴 때 관찰된다. 학습된 모델의 노름도 \(n \approx d\) 근처에서 정점을 찍기 때문에, 테스트 오차를 노름에 대해 그리면 이중 하강이 사라지고 전통적 관점에 더 가까운 모습이 된다. 심층 신경망의 올바른 복잡도 척도는 아직 활발히 연구 중이다.
표본 복잡도 상한
학습 집합에서 잘하는 것이 왜 일반화 오차에 대해 무언가를 말해 주는지를 학습 이론(learning theory)으로 따져 본다.
준비
- 합집합 상한(union bound). \(P(A_1 \cup \cdots \cup A_k) \leq P(A_1) + \cdots + P(A_k)\)
- Hoeffding 부등식. \(Z_1, \ldots, Z_n\)이 iid \(\text{Bernoulli}(\phi)\)이고 \(\hat{\phi} = \frac{1}{n} \sum_i Z_i\)이면, 임의의 \(\gamma > 0\)에 대해 \(P(\lvert \phi - \hat{\phi} \rvert > \gamma) \leq 2\exp(-2\gamma^2 n)\)이다.
이진 분류 \(y \in \{0, 1\}\)에서 학습 오차(경험적 위험)와 일반화 오차를 다음과 같이 정의한다.
\[\hat{\varepsilon}(h) = \frac{1}{n} \sum_{i=1}^{n} 1\{h(x^{(i)}) \neq y^{(i)}\}, \qquad \varepsilon(h) = P_{(x,y) \sim \mathcal{D}}(h(x) \neq y)\]학습 데이터가 같은 분포 \(\mathcal{D}\)에서 iid로 뽑혔다고 가정한다(PAC 가정). 가설 집합(hypothesis class) \(\mathcal{H}\)에서 학습 오차를 최소화하는 \(\hat{h} = \arg\min_{h \in \mathcal{H}} \hat{\varepsilon}(h)\)를 고르는 것을 경험적 위험 최소화(empirical risk minimization, ERM) 라 한다.
유한한 가설 집합
\(\mathcal{H} = \{h_1, \ldots, h_k\}\)라 하자. 고정된 \(h_i\)에 대해 \(Z_j = 1\{h_i(x^{(j)}) \neq y^{(j)}\}\)는 평균이 \(\varepsilon(h_i)\)인 iid 베르누이이고 \(\hat{\varepsilon}(h_i)\)는 그 표본 평균이다. Hoeffding 부등식으로 \(P(\lvert \varepsilon(h_i) - \hat{\varepsilon}(h_i) \rvert > \gamma) \leq 2\exp(-2\gamma^2 n)\)이고, 합집합 상한으로 모든 \(h\)에 대해 동시에 성립하게 만들면 다음을 얻는다.
\[P\left( \forall h \in \mathcal{H}, \; \lvert \varepsilon(h) - \hat{\varepsilon}(h) \rvert \leq \gamma \right) \geq 1 - 2k \exp(-2\gamma^2 n)\]이를 균등 수렴(uniform convergence) 이라 한다. \(\delta = 2k\exp(-2\gamma^2 n)\)을 풀면, 확률 \(1 - \delta\) 이상으로 균등 수렴하기 위해 \(n \geq \frac{1}{2\gamma^2} \log \frac{2k}{\delta}\)이면 충분하다. 필요한 예제 수(표본 복잡도, sample complexity)는 가설 수 \(k\)에 대해 로그적으로만 증가한다.
균등 수렴이 성립할 때 \(h^* = \arg\min_{h \in \mathcal{H}} \varepsilon(h)\)와 비교하면 다음과 같다.
\[\varepsilon(\hat{h}) \leq \hat{\varepsilon}(\hat{h}) + \gamma \leq \hat{\varepsilon}(h^*) + \gamma \leq \varepsilon(h^*) + 2\gamma\]두 번째 부등식은 \(\hat{h}\)가 학습 오차를 최소화한다는 사실에서 나온다. 따라서 확률 \(1 - \delta\) 이상으로 다음이 성립한다.
\[\varepsilon(\hat{h}) \leq \left( \min_{h \in \mathcal{H}} \varepsilon(h) \right) + 2\sqrt{\frac{1}{2n} \log \frac{2k}{\delta}}\]이 식은 편향-분산 트레이드오프를 정량화한다. 더 큰 가설 집합 \(\mathcal{H}' \supseteq \mathcal{H}\)로 바꾸면 첫 항(편향)은 줄어들 수밖에 없지만, \(k\)가 커지므로 둘째 항(분산)은 커진다.
무한한 가설 집합
\(d\)개의 실수로 매개변수화된 \(\mathcal{H}\)도 64비트 부동소수로 표현하면 최대 \(2^{64d}\)개의 가설이므로, 위 결과에서 \(n = O\left( \frac{d}{\gamma^2} \log \frac{1}{\delta} \right)\)이면 충분하다. 즉 필요한 예제 수는 매개변수 수에 대략 선형이다.
매개변수화에 의존하지 않는 더 나은 논증은 VC 차원(Vapnik-Chervonenkis dimension) 을 쓴다. \(\mathcal{H}\)가 점 집합 \(S\)의 모든 레이블링을 실현할 수 있으면 \(\mathcal{H}\)가 \(S\)를 산산조각낸다(shatter) 고 하며, 산산조각낼 수 있는 가장 큰 집합의 크기가 \(\text{VC}(\mathcal{H})\)다. 예를 들어 2차원 선형 분류기는 일반 위치의 세 점은 산산조각내지만 어떤 네 점도 그러지 못하므로 VC 차원이 3이다. Vapnik의 정리에 따르면 \(D = \text{VC}(\mathcal{H})\)일 때 확률 \(1 - \delta\) 이상으로 다음이 성립한다.
\[\varepsilon(\hat{h}) \leq \varepsilon(h^*) + O\left( \sqrt{\frac{D}{n} \log \frac{n}{D} + \frac{1}{n} \log \frac{1}{\delta}} \right)\]따라서 필요한 예제 수는 VC 차원에 선형이며, 대부분의 합리적인 가설 집합에서 VC 차원은 매개변수 수에 대략 선형이다.
정규화
과적합은 보통 너무 복잡한 모델에서 생긴다. 복잡도를 매개변수 수로 잰다면 모델 크기를 바꾸면 되지만, 올바른 복잡도 척도는 매개변수의 함수(예: \(\ell_2\) 노름)일 수도 있다. 이때 정규화(regularization) 로 모델 복잡도를 조절한다. 학습 손실에 정규화항(regularizer) \(R(\theta) \geq 0\)을 더한다.
\[J_\lambda(\theta) = J(\theta) + \lambda R(\theta)\]\(\lambda \geq 0\)은 정규화 매개변수다. \(\lambda = 0\)이면 원래 손실과 같고, 작은 양수이면 정규화항이 사실상 동점 처리 규칙(tie-breaker) 역할을 하며, 매우 크면 원래 손실이 무력해져 편향이 커진다.
L2 정규화와 가중치 감쇠
가장 흔한 것은 \(R(\theta) = \frac{1}{2}\lVert \theta \rVert_2^2\)이다. 딥러닝에서는 가중치 감쇠(weight decay) 라고 부르는데, 학습률 \(\eta\)로 정규화된 손실에 경사하강법을 적용하면 다음과 같이 \(\theta\)를 \(1 - \eta\lambda\)배로 줄인 뒤 원래 그래디언트 스텝을 밟는 것과 같기 때문이다.
\[\theta \leftarrow \theta - \eta \nabla J_\lambda(\theta) = \theta - \eta\lambda\theta - \eta \nabla J(\theta) = \underbrace{(1 - \lambda\eta)\theta}_{\text{decaying weights}} - \eta \nabla J(\theta)\]희소성과 L1 정규화
정규화는 단순한 모델을 선호하게 할 뿐 아니라 귀납적 편향(inductive bias) 이나 구조를 부여할 수도 있다. 참 매개변수에서 0이 아닌 성분이 적다는 믿음(희소성, sparsity)이 있다면 0이 아닌 성분의 수 \(\lVert \theta \rVert_0\)를 정규화할 수 있다. 구조를 부여하면 탐색 공간과 모델군의 복잡도가 줄어 일반화가 나아지는 경향이 있지만, 맞는 희소 모델이 없다면 편향이 커질 위험도 있다.
\(\lVert \theta \rVert_0\)는 연속이 아니라 경사하강법으로 최적화할 수 없으므로, 흔히 연속 대리 함수 \(R(\theta) = \lVert \theta \rVert_1\)(LASSO)을 쓴다. 단위 구 위에서 \(\ell_1\) 노름이 가장 작은 점은 성분이 하나뿐인 가장 희소한 점이라는 직관이 있다. 선형 모델에서는 \(\ell_1\)과 \(\ell_2\)가 가장 많이 쓰인다. 커널 방법에는 \(\ell_2\)가 훨씬 흔한데, \(\ell_1\) 정규화의 최적해는 피처 내적의 함수로 쓸 수 없어 커널 트릭과 잘 맞지 않기 때문이다.
딥러닝에서는 가중치 감쇠가 가장 흔하며, 드롭아웃(dropout), 데이터 증강(data augmentation), 가중치 행렬의 스펙트럼 노름 정규화, 모델의 립시츠(Lipschitz) 상수 정규화 등도 쓰인다.
암묵적 정규화
암묵적 정규화(implicit regularization), 또는 암묵적 편향(implicit bias)은 딥러닝 시대에 새로 관찰된 현상으로, 옵티마이저가 정규화된 손실이 부여한 것 이상의 구조를 매개변수에 암묵적으로 부여하는 것을 말한다.
고전적 설정에서는 손실의 전역 최소점이 유일하므로 합리적인 옵티마이저는 모두 같은 점에 수렴한다. 그러나 딥러닝에서는 (근사적) 전역 최소점이 여러 개이고, 옵티마이저에 따라 다른 최소점에 수렴할 수 있다. 이 최소점들은 학습 손실은 같아도 일반화 성능은 크게 다를 수 있다. 예를 들어 CIFAR-10에서 학습률 스케줄만 다르게 한 두 신경망은 같은 정규화 손실로 학습 데이터를 완벽히 맞추지만 테스트 성능이 크게 다르다. 따라서 옵티마이저의 선택은 학습 손실 최소화뿐 아니라 일반화에도 영향을 준다. 학습 오차가 이미 충분히 작아도 일반화를 위해 옵티마이저를 조정해야 할 수 있다.
어떤 요소가 어떤 최소점을 선호하는지는 열린 문제이지만, 많은 경우 큰 초기 학습률, 작은 초기화, 작은 배치 크기, 모멘텀이 더 잘 일반화되는 해로 이끄는 것으로 보인다. 한 가지 추측(단순화된 경우에는 증명됨)은 최적화의 확률성이 곡률이 작은 평탄한 최소점(flat minima) 을 찾게 돕고, 평탄한 최소점은 립시츠 상수가 작은 모델과 더 나은 일반화로 이어진다는 것이다.
정리
- 목표는 학습 오차가 아니라 처음 보는 예제에서의 테스트 오차다. 과적합은 학습 오차가 작고 테스트 오차가 큰 것, 과소적합은 학습 오차부터 큰 것이다.
- 회귀의 기대 테스트 오차는 \(\sigma^2 + \text{bias}^2 + \text{variance}\)로 분해된다. 편향은 모델군의 표현력 부족, 분산은 유한한 데이터의 무작위성에서 온다.
- 단순한 모델은 편향이 크고 복잡한 모델은 분산이 커서 전통적으로 U자 곡선이 나타나지만, 이중 하강에서는 \(n \approx d\)에서 정점을 찍은 뒤 과매개변수화 영역에서 다시 줄어든다. 최적의 정규화는 정점을 완화한다.
- 유한한 \(\mathcal{H}\)에서 ERM은 확률 \(1 - \delta\)로 \(\varepsilon(\hat{h}) \leq \min_h \varepsilon(h) + 2\sqrt{\frac{1}{2n}\log\frac{2k}{\delta}}\)를 만족하며, 필요한 표본 수는 \(\log k\), 무한한 경우 VC 차원에 비례한다.
- 정규화 \(J + \lambda R\)은 복잡도를 조절한다. \(\ell_2\)는 가중치 감쇠 \((1 - \lambda\eta)\theta\)와 같고, \(\ell_1\)(LASSO)은 희소성을 유도한다.
- 옵티마이저는 여러 전역 최소점 중 무엇을 고를지 결정해 암묵적 정규화 효과를 내며, 일반화에 영향을 준다.