- Stanford CS229 Machine Learning (Spring 2022) 15강 정리
- 강의: Tengyu Ma, Christopher Ré
- ▶ 강의 영상
- 참고: CS229 lecture notes 12장 Principal components analysis, 13장 Independent components analysis
PCA 다시 보기
복습
14강에서 PCA는 평균 0, 분산 1로 정규화한 데이터의 경험 공분산 \(\Sigma = \frac{1}{n} \sum_i x^{(i)} x^{(i)T}\)에 대해, 사영 분산 \(u^T \Sigma u\)를 최대화하는 단위벡터를 찾았다. 해는 \(\Sigma\)의 고유벡터이고, \(k\)차원으로 줄일 때는 상위 \(k\)개 고유벡터 \(u_1, \dots, u_k\)를 쓰며 \(y^{(i)} = (u_1^T x^{(i)}, \dots, u_k^T x^{(i)}) \in \mathbb{R}^k\)가 새 표현이다.
재구성 오차 최소화로서의 PCA
PCA는 데이터를 \(k\)차원 부분공간에 사영했을 때 생기는 근사 오차를 최소화하는 기저를 고르는 것으로도 유도할 수 있다. 정규직교 벡터 \(u_1, \dots, u_k\)가 생성하는 부분공간으로 \(x\)를 사영하면 \(\hat{x} = \sum_{j=1}^k (u_j^T x) u_j\)이다. 피타고라스 정리에 의해 다음이 성립한다.
\[\lVert x^{(i)} - \hat{x}^{(i)} \rVert_2^2 = \lVert x^{(i)} \rVert_2^2 - \sum_{j=1}^k \left( u_j^T x^{(i)} \right)^2 = \lVert x^{(i)} \rVert_2^2 - \lVert y^{(i)} \rVert_2^2\]\(\sum_i \lVert x^{(i)} \rVert_2^2\)는 기저와 무관한 상수이므로, 재구성 오차의 합을 최소화하는 것은 \(\sum_i \lVert y^{(i)} \rVert_2^2\), 즉 사영 분산을 최대화하는 것과 같다. 두 관점은 같은 답, 상위 \(k\)개 고유벡터를 준다.
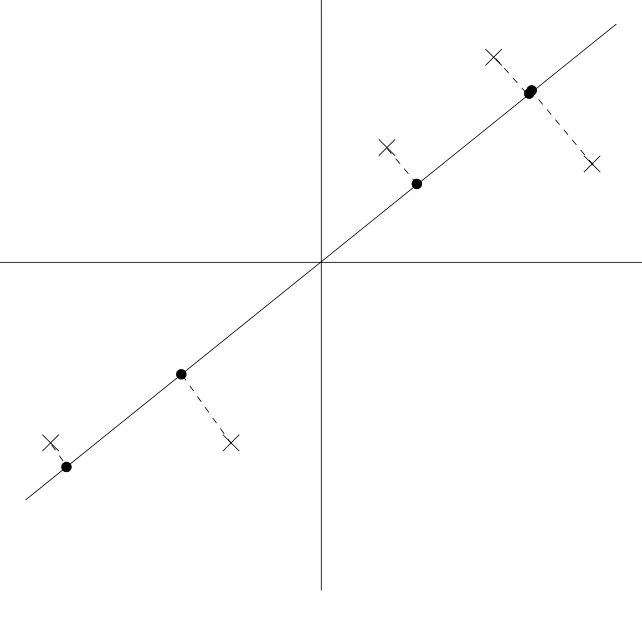 2차원 데이터(×)를 원점을 지나는 직선에 사영한 모습. 검은 점이 재구성 \(\hat{x}^{(i)}\)이고, 점선의 길이가 재구성 오차 \(\lVert x^{(i)} - \hat{x}^{(i)} \rVert_2\)다. 출처: CS229 lecture notes.
이 그림은 위 식을 \(k = 1\), \(d = 2\)인 경우로 보여 준다. 각 ×에서 원점까지의 거리가 \(\lVert x^{(i)} \rVert_2\)이고, 원점에서 검은 점까지의 거리가 사영 좌표의 크기 \(\lvert y^{(i)} \rvert = \lvert u^T x^{(i)} \rvert\), ×에서 검은 점까지의 점선이 재구성 오차다. 점선은 직선에 수직이므로 세 변은 직각삼각형을 이루고, 피타고라스 정리로 (원점까지 거리)² = (사영 길이)² + (점선 길이)²가 된다.
데이터 점의 위치는 고정되어 있으므로 빗변 길이의 합은 직선의 방향과 무관하다. 따라서 직선을 돌려 점선을 짧게 만들수록 사영 길이는 길어지고, 그 반대도 마찬가지다. 그림의 직선은 데이터가 늘어선 방향에 가까워 점선이 짧고 검은 점들이 넓게 퍼져 있다. 즉 “재구성 오차가 작은 방향”과 “사영 분산이 큰 방향”은 같은 방향이다.
응용
- 압축. \(x^{(i)}\)를 더 낮은 차원의 \(y^{(i)}\)로 표현한다.
- 시각화. \(k = 2\)나 \(3\)으로 줄여 그리면, 예를 들어 어떤 자동차 종류끼리 비슷한지, 어떤 군집이 있는지 볼 수 있다.
- 지도 학습 전처리. 입력의 차원을 줄이면 계산이 줄어들 뿐 아니라 가설 집합의 복잡도도 줄어 과적합을 막는 데 도움이 된다. 예를 들어 저차원 입력 위의 선형 분류기는 VC 차원이 더 작다.
- 잡음 제거. 헬리콥터 조종사 예에서 PCA는 잡음 섞인 두 측정값(실력, 즐기는 정도)에서 본질적인 “적성”을 추정한다.
고유얼굴(eigenfaces). 잡음 제거 관점의 대표적인 예다. \(100 \times 100\) 얼굴 이미지 하나를 10000차원 벡터 \(x^{(i)}\)로 보고 PCA로 훨씬 낮은 차원의 \(y^{(i)}\)로 표현한다. 주성분이 사람의 생김새를 결정하는 체계적인 변동은 담고, 미세한 조명 변화나 촬영 조건 같은 “잡음”은 버리기를 기대하는 것이다. 두 얼굴의 거리를 축소된 공간에서 \(\lVert y^{(i)} - y^{(j)} \rVert_2\)로 재면 놀랄 만큼 좋은 얼굴 매칭과 검색 알고리즘이 된다.
독립 성분 분석(ICA)
칵테일 파티 문제
독립 성분 분석(independent components analysis, ICA) 도 PCA처럼 데이터를 표현할 새 기저를 찾지만, 목표가 전혀 다르다. 동기는 칵테일 파티 문제(cocktail party problem) 다. 파티에서 \(d\)명이 동시에 말하고 있고, 방 안의 마이크 \(d\)개는 각각 화자들의 목소리가 서로 다른 비율로 섞인 소리를 녹음한다. 마이크마다 화자와의 거리가 다르기 때문이다. 녹음만으로 원래의 \(d\)개 음성을 분리할 수 있을까?
이를 형식화하면, \(d\)개의 독립된 원천(source)에서 생성된 \(s \in \mathbb{R}^d\)가 있고 관측은 다음과 같다.
\[x = As\]\(A\)는 알려지지 않은 정사각 혼합 행렬(mixing matrix) 이다. 관측 데이터 \(\{x^{(i)}; i = 1, \dots, n\}\)로부터 \(x^{(i)} = A s^{(i)}\)를 만든 원천 \(s^{(i)}\)를 복원하는 것이 목표다. 칵테일 파티 예에서 \(s_j^{(i)}\)는 시각 \(i\)에 화자 \(j\)가 낸 소리이고, \(x_j^{(i)}\)는 시각 \(i\)에 마이크 \(j\)가 기록한 값이다.
\(W = A^{-1}\)을 분리 행렬(unmixing matrix) 이라 하자. \(W\)를 찾으면 \(s^{(i)} = W x^{(i)}\)로 원천을 복원한다. \(W\)의 \(i\)번째 행을 \(w_i^T\)로 쓰면 \(j\)번째 원천은 \(s_j^{(i)} = w_j^T x^{(i)}\)이다.
ICA의 모호성
원천과 혼합 행렬에 대한 사전 지식이 없으면, \(x^{(i)}\)만으로는 원리적으로 복원할 수 없는 부분이 있다.
순서. \(P\)를 \(d \times d\) 치환 행렬(permutation matrix, 각 행과 열에 1이 정확히 하나)이라 하면, \(x^{(i)}\)만으로는 \(W\)와 \(PW\)를 구별할 수 없다. 원천의 순서는 정할 수 없지만 대부분의 응용에서 문제가 되지 않는다.
크기와 부호. \(A\)를 \(2A\)로, 모든 \(s^{(i)}\)를 \(0.5 s^{(i)}\)로 바꿔도 \(x^{(i)} = 2A \cdot (0.5) s^{(i)}\)는 같다. 더 일반적으로 \(A\)의 한 열을 \(\alpha\)배 하고 대응하는 원천을 \(1/\alpha\)배 하면 구별할 수 없다. 칵테일 파티 문제에서는 이것도 문제가 아니다. 크기는 음량만 바꾸고, \(s_j^{(i)}\)와 \(-s_j^{(i)}\)는 스피커로 재생하면 똑같이 들린다.
가우시안 원천. 원천이 가우시안이 아니라면 모호성은 위의 두 가지뿐이다. 가우시안이면 무엇이 문제인지 보자. \(s \sim \mathcal{N}(0, I)\)라 하면 \(x = As\)의 분포는 다음과 같다.
\[\mathbb{E}[x] = A \mathbb{E}[s] = 0, \qquad \mathrm{Cov}[x] = \mathbb{E}[A s s^T A^T] = A \, \mathrm{Cov}[s] \, A^T = A A^T\]즉 \(x \sim \mathcal{N}(0, A A^T)\)이다. 이제 임의의 직교 행렬 \(R\)(\(R R^T = R^T R = I\), 회전이나 반사)에 대해 \(A' = AR\)로 섞었다면 \(x' = A' s\)의 공분산은 다음과 같다.
\[\mathbb{E}[x' x'^T] = \mathbb{E}[A R s s^T (AR)^T] = A R R^T A^T = A A^T\]혼합 행렬이 \(A\)든 \(A'\)든 관측 분포는 \(\mathcal{N}(0, A A^T)\)로 같다. 표준 정규분포는 회전 대칭이므로 혼합 행렬의 회전 성분을 데이터로 정할 수 없고, 원천을 복원할 수 없다. 반대로 데이터가 가우시안이 아니면, 데이터가 충분할 때 \(d\)개의 독립 원천을 복원할 수 있다.
선형 변환과 밀도
ICA 알고리즘을 유도하기 전에 선형 변환이 밀도를 어떻게 바꾸는지 알아야 한다. 실수 확률변수 \(s\)의 밀도가 \(p_s\)이고 \(x = As\)(\(A \in \mathbb{R}\)), \(W = A^{-1}\)이라 하자. \(p_x(x) = p_s(Wx)\)라고 쓰고 싶지만 틀렸다. 예를 들어 \(s \sim \mathrm{Uniform}[0, 1]\)이면 \(p_s(s) = 1\{0 \le s \le 1\}\)이다. \(A = 2\)이면 \(x = 2s\)는 \([0, 2]\) 위의 균등분포이므로 \(p_x(x) = 0.5 \cdot 1\{0 \le x \le 2\}\)이고, 이는 \(p_s(Wx)\)와 다르다. 올바른 공식은 \(p_x(x) = p_s(Wx) \lvert W \rvert\)이다.
일반적으로 \(s\)가 밀도 \(p_s\)를 갖는 벡터이고 \(A\)가 정칙 정사각 행렬일 때 \(x = As\)의 밀도는 다음과 같다.
\[p_x(x) = p_s(Wx) \cdot \lvert W \rvert, \qquad W = A^{-1}\]여기서 \(\lvert W \rvert\)는 행렬식(의 절댓값)이다. 기억하는 방법은 부피를 생각하는 것이다. \(A\)는 단위 초입방체 \(C_1 = [0, 1]^d\)를 부피 \(\lvert A \rvert\)인 집합 \(C_2\)로 보낸다. \(s\)가 \(C_1\) 위에서 균등하면 \(x\)는 \(C_2\) 위에서 균등하므로 밀도는 \(1 / \mathrm{vol}(C_2) = 1 / \lvert A \rvert = \lvert A^{-1} \rvert = \lvert W \rvert\)이다.
최대우도 ICA
Bell과 Sejnowski의 알고리즘을 최대우도 추정으로 해석해 유도한다. 각 원천 \(s_j\)의 밀도를 \(p_s\)라 하고, 원천들이 독립이라는 가정을 결합분포가 주변분포의 곱이라는 것으로 표현한다.
\[p(s) = \prod_{j=1}^d p_s(s_j)\]앞 절의 공식을 쓰면 \(x = As = W^{-1} s\)의 밀도는 다음과 같다.
\[p(x) = \prod_{j=1}^d p_s(w_j^T x) \cdot \lvert W \rvert\]남은 것은 원천의 밀도 \(p_s\)를 정하는 것이다. 밀도는 누적분포함수(cdf)의 도함수이므로, 0에서 1로 단조 증가하는 cdf를 하나 고르면 된다. 가우시안 cdf는 앞서 본 대로 쓸 수 없다. 합리적인 기본값으로 시그모이드 함수 \(g(s) = 1 / (1 + e^{-s})\)를 cdf로 고르면 \(p_s(s) = g'(s)\)이다. 원천 밀도에 대한 사전 지식이 있으면 그것을 대신 쓰는 것이 좋다.
\(g'\)은 대칭 함수이므로 이 가정은 \(\mathbb{E}[s] = 0\), 따라서 \(\mathbb{E}[x] = 0\)을 함의한다. 그러므로 데이터를 미리 평균 0으로 전처리하거나, 음향 신호처럼 원래 평균이 0이라고 기대할 수 있어야 한다.
매개변수는 정사각 행렬 \(W\)이고, 로그 우도는 다음과 같다.
\[\ell(W) = \sum_{i=1}^n \left( \sum_{j=1}^d \log g'(w_j^T x^{(i)}) + \log \lvert W \rvert \right)\]학습 규칙 유도
\(g' = g(1 - g)\)이므로 \(\log g'(s) = \log g(s) + \log(1 - g(s))\)이고, 이를 미분하면 다음과 같다.
\[\frac{d}{ds} \log g'(s) = \frac{g'(s)}{g(s)} - \frac{g'(s)}{1 - g(s)} = (1 - g(s)) - g(s) = 1 - 2 g(s)\]따라서 첫째 항의 \(W\)에 대한 그래디언트는 \(j\)번째 행이 \((1 - 2 g(w_j^T x^{(i)})) x^{(i)T}\)인 행렬이다. 둘째 항은 \(\nabla_W \lvert W \rvert = \lvert W \rvert (W^{-1})^T\)를 쓰면 \(\nabla_W \log \lvert W \rvert = (W^T)^{-1}\)이다. 데이터 하나 \(x^{(i)}\)에 대한 확률적 경사 상승 규칙은 다음과 같다.
\[W := W + \alpha \left( \begin{bmatrix} 1 - 2 g(w_1^T x^{(i)}) \\ 1 - 2 g(w_2^T x^{(i)}) \\ \vdots \\ 1 - 2 g(w_d^T x^{(i)}) \end{bmatrix} x^{(i)T} + (W^T)^{-1} \right)\]\(\alpha\)는 학습률이다. 수렴한 뒤 \(s^{(i)} = W x^{(i)}\)로 원천을 복원한다.
독립성 가정에 대한 주의
우도를 \(\prod_i p(x^{(i)}; W)\)로 쓸 때 데이터 \(x^{(i)}\)들이 서로 독립이라고 암묵적으로 가정했다. 이는 한 \(x^{(i)}\) 안의 좌표들이 독립인지와는 다른 문제다. 음성 같은 시계열에서는 분명히 틀린 가정이지만, 데이터가 충분하면 상관된 학습 데이터가 성능을 해치지 않음을 보일 수 있다. 다만 연속한 데이터가 상관된 경우, 학습 데이터를 무작위로 섞어서 확률적 경사 상승을 돌리면 수렴이 빨라지기도 한다.
정리
- PCA는 사영 분산 최대화뿐 아니라 \(k\)차원 부분공간으로의 재구성 오차 최소화로도 유도되며, 둘은 \(\lVert x - \hat{x} \rVert^2 = \lVert x \rVert^2 - \lVert y \rVert^2\) 때문에 같은 해를 준다.
- PCA는 압축, 시각화, 지도 학습 전처리, 잡음 제거(고유얼굴)에 쓰인다.
- ICA는 \(x = As\)에서 독립 원천 \(s\)를 복원하는 분리 행렬 \(W = A^{-1}\)을 찾는다. 칵테일 파티 문제가 대표적인 예다.
- 원천의 순서와 크기(부호 포함)는 복원할 수 없지만 대개 문제가 되지 않는다. 원천이 가우시안이면 회전 대칭 때문에 혼합 행렬의 회전을 정할 수 없어 ICA가 불가능하다.
- 선형 변환 \(x = As\)의 밀도는 \(p_x(x) = p_s(Wx) \lvert W \rvert\)이다.
- 원천 cdf를 시그모이드로 두면 로그 우도는 \(\sum_i (\sum_j \log g'(w_j^T x^{(i)}) + \log \lvert W \rvert)\)이고, 확률적 경사 상승 규칙은 \(W := W + \alpha ([1 - 2 g(w_j^T x^{(i)})]_j \, x^{(i)T} + (W^T)^{-1})\)이다.