- Stanford CS229 Machine Learning (Spring 2022) 4강 정리
- 강의: Tengyu Ma, Christopher Ré
- ▶ 강의 영상
- 참고: CS229 lecture notes Chapter 3 (Generalized linear models), Chapter 2.3 (Multi-class classification)
두 모델의 공통점
지금까지 회귀에서는 \(y \mid x; \theta \sim \mathcal{N}(\mu, \sigma^2)\)를, 분류에서는 \(y \mid x; \theta \sim \text{Bernoulli}(\phi)\)를 가정했다. 여기서 \(\mu\)와 \(\phi\)는 \(x\)와 \(\theta\)의 함수다. 두 방법은 일반화 선형 모델(generalized linear model, GLM) 이라는 더 넓은 모델 족의 특수한 경우이며, 같은 틀로 다른 분류와 회귀 문제를 위한 모델도 유도할 수 있다.
지수족
정의
분포의 집합이 다음 형태로 쓰일 수 있으면 지수족(exponential family) 에 속한다고 한다.
\[p(y; \eta) = b(y) \exp\left( \eta^T T(y) - a(\eta) \right)\]- \(\eta\): 자연 매개변수(natural parameter), 또는 정준 매개변수(canonical parameter).
- \(T(y)\): 충분 통계량(sufficient statistic). 여기서 다루는 분포에서는 대부분 \(T(y) = y\)다.
- \(a(\eta)\): 로그 분배 함수(log partition function). \(e^{-a(\eta)}\)는 \(p(y; \eta)\)의 합(또는 적분)이 1이 되도록 하는 정규화 상수 역할을 한다.
\(T\), \(a\), \(b\)를 하나로 고정하면 \(\eta\)로 매개변수화된 분포의 족이 정해지고, \(\eta\)를 바꾸면 그 족 안의 다른 분포를 얻는다.
베르누이 분포
평균이 \(\phi\)인 베르누이 분포 \(\text{Bernoulli}(\phi)\)는 \(y \in \{0, 1\}\) 위의 분포로 \(p(y = 1; \phi) = \phi\), \(p(y = 0; \phi) = 1 - \phi\)다. 이를 다시 쓰면 다음과 같다.
\[\begin{aligned} p(y; \phi) &= \phi^y (1 - \phi)^{1-y} \\ &= \exp\left( y \log \phi + (1 - y) \log(1 - \phi) \right) \\ &= \exp\left( \left( \log \frac{\phi}{1 - \phi} \right) y + \log(1 - \phi) \right) \end{aligned}\]따라서 자연 매개변수는 \(\eta = \log(\phi / (1 - \phi))\)다. 이 식을 \(\phi\)에 대해 풀면 \(\phi = 1/(1 + e^{-\eta})\), 즉 익숙한 시그모이드 함수가 나온다. 나머지는 다음과 같다.
\[T(y) = y, \qquad a(\eta) = -\log(1 - \phi) = \log(1 + e^\eta), \qquad b(y) = 1\]가우시안 분포
선형 회귀를 유도할 때 \(\sigma^2\)는 최종 \(\theta\)와 \(h_\theta(x)\)에 영향을 주지 않았다(3강). 그러므로 유도를 단순하게 하기 위해 \(\sigma^2 = 1\)로 둔다.
\[p(y; \mu) = \frac{1}{\sqrt{2\pi}} \exp\left( -\frac{1}{2} (y - \mu)^2 \right) = \frac{1}{\sqrt{2\pi}} \exp\left( -\frac{1}{2} y^2 \right) \cdot \exp\left( \mu y - \frac{1}{2} \mu^2 \right)\]따라서 가우시안도 지수족이며 다음과 같다.
\[\eta = \mu, \qquad T(y) = y, \qquad a(\eta) = \mu^2 / 2 = \eta^2 / 2, \qquad b(y) = \frac{1}{\sqrt{2\pi}} \exp(-y^2 / 2)\]\(\sigma^2\)를 변수로 남겨 두면 \(\eta\)가 \(\mu\)와 \(\sigma\)에 의존하는 2차원 벡터가 되며, 이때도 가우시안은 지수족이다.
그 밖의 지수족
다항 분포(multinomial), 개수 데이터를 위한 포아송 분포(Poisson), 시간 간격처럼 음이 아닌 연속값을 위한 감마 분포와 지수 분포, 확률 위의 분포인 베타 분포와 디리클레 분포(Dirichlet) 등이 모두 지수족이다.
GLM 구성하기
세 가지 가정
예를 들어 매장 프로모션, 최근 광고, 날씨, 요일 같은 특성 \(x\)로 한 시간 동안 매장에 오는 손님 수 \(y\)를 예측하고 싶다고 하자. 방문자 수는 보통 포아송 분포로 잘 모델링되고, 포아송은 지수족이므로 GLM을 적용할 수 있다.
일반적으로 \(x\)의 함수로 확률 변수 \(y\)를 예측하는 GLM은 다음 세 가지 가정(설계 선택)으로 만든다.
- \(y \mid x; \theta \sim \text{ExponentialFamily}(\eta)\). 즉 \(x\)와 \(\theta\)가 주어지면 \(y\)는 매개변수 \(\eta\)인 어떤 지수족 분포를 따른다.
- \(x\)가 주어졌을 때 \(T(y)\)의 기댓값을 예측하는 것이 목표다. 대부분 \(T(y) = y\)이므로 가설이 \(h(x) = \mathbb{E}[y \mid x]\)를 만족하기를 원한다.
- 자연 매개변수와 입력이 선형 관계다. \(\eta = \theta^T x\) (\(\eta\)가 벡터이면 \(\eta_i = \theta_i^T x\)).
세 번째 가정은 가장 덜 정당화된 것처럼 보이므로, 가정이라기보다 GLM을 만드는 “레시피”의 설계 선택으로 보는 편이 낫다. 이 세 가정으로부터 학습이 쉬운 등 바람직한 성질을 가진 우아한 학습 알고리즘들이 나온다.
최소제곱
타깃 \(y\)(GLM 용어로 반응 변수, response variable)가 연속값이고 \(y \mid x \sim \mathcal{N}(\mu, \sigma^2)\)로 모델링한다고 하자. 가우시안의 지수족 표현에서 \(\mu = \eta\)였으므로 다음이 성립한다.
\[h_\theta(x) = \mathbb{E}[y \mid x; \theta] = \mu = \eta = \theta^T x\]첫 등호는 가정 2, 둘째는 가우시안의 평균이 \(\mu\)라는 사실, 셋째는 가정 1과 \(\mu = \eta\), 넷째는 가정 3에서 나온다. 최소제곱 선형 회귀가 GLM으로 유도되었다.
로지스틱 회귀
\(y \in \{0, 1\}\)이므로 베르누이 족을 고르는 것이 자연스럽다. 베르누이의 지수족 표현에서 \(\phi = 1/(1 + e^{-\eta})\)였고, \(y \mid x; \theta \sim \text{Bernoulli}(\phi)\)이면 \(\mathbb{E}[y \mid x; \theta] = \phi\)이므로 다음과 같다.
\[h_\theta(x) = \mathbb{E}[y \mid x; \theta] = \phi = \frac{1}{1 + e^{-\eta}} = \frac{1}{1 + e^{-\theta^T x}}\]이것이 로지스틱 함수 \(1/(1 + e^{-z})\)가 어디서 왔는지에 대한 한 가지 답이다. \(y \mid x\)를 베르누이로 가정하는 순간, GLM과 지수족의 정의로부터 로지스틱 함수가 자연스럽게 나온다.
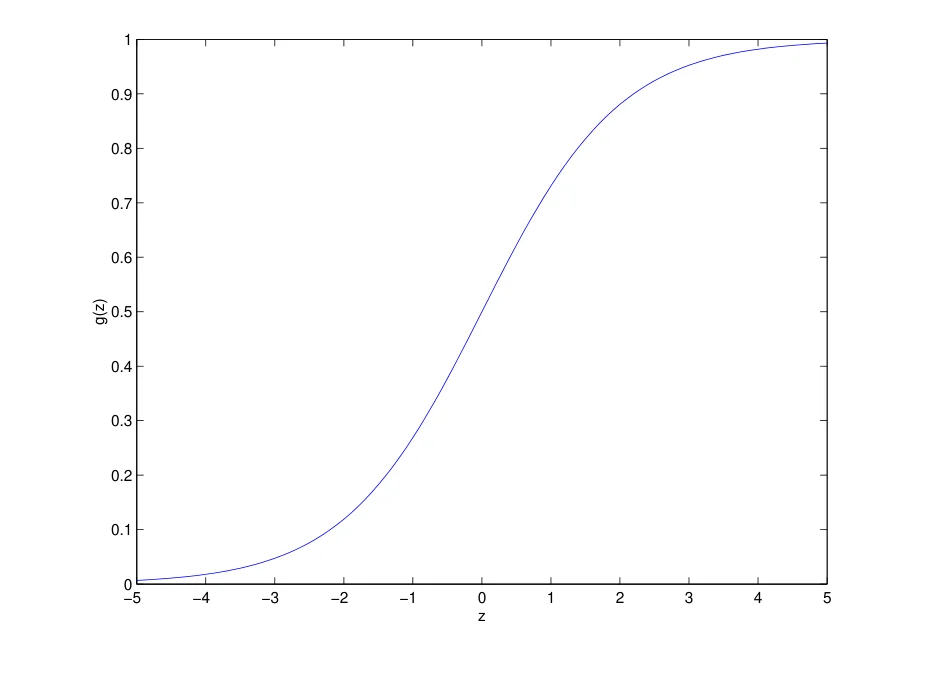 로지스틱 함수 \(g(\eta) = 1/(1+e^{-\eta})\)의 그래프다. GLM의 관점에서 가로축은 자연 매개변수 \(\eta = \theta^T x\), 세로축은 베르누이 분포의 평균 \(\phi = p(y = 1 \mid x; \theta)\)다. 출처: CS229 lecture notes.
3강에서는 이 곡선을 “0과 1 사이로 매끄럽게 증가하는 함수” 중 하나로 골랐지만, GLM에서는 그래프의 두 축이 분명한 의미를 갖는다. 가로축의 \(\eta\)는 실수 전체를 자유롭게 움직일 수 있는 자연 매개변수이고, GLM의 세 번째 가정에 따라 \(\eta = \theta^T x\)로 입력에 선형으로 연결된다. 세로축의 \(\phi\)는 확률이므로 반드시 (0, 1) 안에 있어야 한다. 이 곡선은 제약 없는 \(\eta\)를 제약 있는 \(\phi\)로 옮기는 다리이며, 그 모양은 베르누이 분포를 지수족 꼴로 썼을 때 정해진다. 예를 들어 \(\eta = 0\)이면 \(\phi = 0.5\)이고, 이는 로그 오즈(log-odds) \(\log(\phi/(1-\phi))\)가 0이라는 뜻이다.
정준 반응 함수와 정준 연결 함수
자연 매개변수의 함수로 분포의 평균을 주는 함수 \(g(\eta) = \mathbb{E}[T(y); \eta]\)를 정준 반응 함수(canonical response function) 라 하고, 그 역함수 \(g^{-1}\)을 정준 연결 함수(canonical link function) 라 한다. 가우시안의 정준 반응 함수는 항등 함수이고, 베르누이의 정준 반응 함수는 로지스틱 함수다. 많은 교재는 반대로 \(g\)를 연결 함수, \(g^{-1}\)을 반응 함수로 쓰지만, CS229 노트는 초기 머신러닝 문헌의 표기를 따른다.
같은 갱신 규칙이 나오는 이유
3강에서 LMS와 로지스틱 회귀의 갱신 규칙이 같은 모양이라는 점을 보았다. GLM의 형태에서 그 이유를 바로 확인할 수 있다. \(T(y) = y\)이고 \(\eta = \theta^T x\)인 GLM에서 예제 하나의 로그우도는 다음과 같다.
\[\log p(y \mid x; \theta) = \log b(y) + \theta^T x \, y - a(\theta^T x)\]\(\theta\)로 미분하면 \(\nabla_\theta \log p(y \mid x; \theta) = (y - a'(\eta)) x\)다. 지수족에서 \(a'(\eta) = \mathbb{E}[y; \eta]\)가 성립하므로(로그 분배 함수의 미분은 평균이다), \(a'(\eta) = h_\theta(x)\)다. 위의 두 예로 확인하면, 가우시안은 \(a(\eta) = \eta^2/2\)에서 \(a'(\eta) = \eta = \mu\), 베르누이는 \(a(\eta) = \log(1 + e^\eta)\)에서 \(a'(\eta) = 1/(1 + e^{-\eta}) = \phi\)다. 따라서 모든 경우에 확률적 경사상승 규칙은 같은 모양이 된다.
\[\theta := \theta + \alpha \left( y^{(i)} - h_\theta(x^{(i)}) \right) x^{(i)}\]소프트맥스 회귀
다중 클래스 분류
이제 반응 변수가 \(k\)개 값 중 하나, 즉 \(y \in \{1, 2, \dots, k\}\)인 분류를 생각한다. 예를 들어 이메일을 스팸과 스팸 아님 두 가지가 아니라 스팸, 개인 메일, 업무 메일 세 가지로 분류하는 경우다. 이때 \(p(y \mid x; \theta)\)는 \(k\)개의 이산 결과 위의 분포이므로 다항 분포(multinomial distribution)로 모델링한다. 다항 분포는 각 결과의 확률 \(\phi_1, \dots, \phi_k\)로 정해지며 \(\sum_{i=1}^{k} \phi_i = 1\)을 만족해야 한다. 다항 분포도 지수족에 속하므로, 이 모델은 다항 분포를 고른 GLM으로 볼 수 있다.
소프트맥스 함수
\(k\)개의 매개변수 묶음 \(\theta_1, \dots, \theta_k \in \mathbb{R}^d\)를 두고, \(\theta_1^T x, \dots, \theta_k^T x\)로 \(\phi_1, \dots, \phi_k\)를 표현하고 싶다. 그런데 \(\theta_j^T x\)는 \([0, 1]\) 안에 있다는 보장이 없고, 합이 1이라는 보장도 없다. 그래서 소프트맥스 함수(softmax function) 로 이를 확률 벡터로 바꾼다.
\[\text{softmax}(t_1, \dots, t_k) = \begin{bmatrix} \frac{\exp(t_1)}{\sum_{j=1}^{k} \exp(t_j)} \\ \vdots \\ \frac{\exp(t_k)}{\sum_{j=1}^{k} \exp(t_j)} \end{bmatrix}\]소프트맥스의 입력 \(t\)를 로짓(logit) 이라 부른다. 출력은 정의상 항상 성분이 음이 아니고 합이 1인 확률 벡터다. \((t_1, \dots, t_k) = (\theta_1^T x, \dots, \theta_k^T x)\)로 두면 확률 모델은 다음과 같다.
\[P(y = i \mid x; \theta) = \phi_i = \frac{\exp(t_i)}{\sum_{j=1}^{k} \exp(t_j)} = \frac{\exp(\theta_i^T x)}{\sum_{j=1}^{k} \exp(\theta_j^T x)}\]교차 엔트로피 손실
예제 하나 \((x, y)\)의 음의 로그우도는 다음과 같고, 학습 데이터 전체의 손실은 이를 합한 것이다.
\[-\log p(y \mid x; \theta) = -\log \left( \frac{\exp(\theta_y^T x)}{\sum_{j=1}^{k} \exp(\theta_j^T x)} \right), \qquad \ell(\theta) = \sum_{i=1}^{n} -\log \left( \frac{\exp(\theta_{y^{(i)}}^T x^{(i)})}{\sum_{j=1}^{k} \exp(\theta_j^T x^{(i)})} \right)\]이를 모듈화하기 위해 교차 엔트로피 손실(cross-entropy loss) \(\ell_{\text{ce}} : \mathbb{R}^k \times \{1, \dots, k\} \to \mathbb{R}_{\ge 0}\)을 정의한다.
\[\ell_{\text{ce}}((t_1, \dots, t_k), y) = -\log \left( \frac{\exp(t_y)}{\sum_{j=1}^{k} \exp(t_j)} \right), \qquad \ell(\theta) = \sum_{i=1}^{n} \ell_{\text{ce}}((\theta_1^T x^{(i)}, \dots, \theta_k^T x^{(i)}), y^{(i)})\]이름에는 약간의 모호함이 있다. 확률 벡터 \(\phi\)와 레이블을 받는 함수를 교차 엔트로피라 하고 이 버전을 소프트맥스-교차 엔트로피라 부르는 경우도 있다. CS229 노트는 PyTorch, Jax 같은 현대 딥러닝 라이브러리의 명명을 따른다.
그래디언트
\(\ell_{\text{ce}}(t, y) = -t_y + \log \sum_{j} \exp(t_j)\)이므로 \(t_i\)로 미분하면 다음을 얻는다.
\[\frac{\partial \ell_{\text{ce}}(t, y)}{\partial t_i} = \phi_i - 1\{y = i\}, \qquad \frac{\partial \ell_{\text{ce}}(t, y)}{\partial t} = \phi - e_y\]\(1\{\cdot\}\)은 지시 함수(indicator function)이고, \(e_y \in \mathbb{R}^k\)는 \(y\)번째 성분만 1인 표준 기저 벡터다. \(t_i = \theta_i^T x\)이므로 연쇄 법칙으로 다음을 얻는다.
\[\frac{\partial \ell(\theta)}{\partial \theta_i} = \sum_{j=1}^{n} \left( \phi_i^{(j)} - 1\{y^{(j)} = i\} \right) x^{(j)}, \qquad \phi_i^{(j)} = \frac{\exp(\theta_i^T x^{(j)})}{\sum_{s=1}^{k} \exp(\theta_s^T x^{(j)})}\]\(\phi_i^{(j)}\)는 모델이 예제 \(x^{(j)}\)에 대해 클래스 \(i\)를 예측하는 확률이다. 여기서도 “예측 확률 - 정답”에 입력을 곱한 꼴이 나온다. 이 그래디언트로 (확률적) 경사하강법을 돌려 \(\ell(\theta)\)를 최소화한다. \(k = 2\)이면 소프트맥스 회귀는 로지스틱 회귀와 같은 모델이 된다.
정리
- 지수족은 \(p(y; \eta) = b(y) \exp(\eta^T T(y) - a(\eta))\) 꼴의 분포로, 자연 매개변수 \(\eta\), 충분 통계량 \(T(y)\), 로그 분배 함수 \(a(\eta)\)로 정해진다.
- 베르누이는 \(\eta = \log(\phi / (1 - \phi))\)로 지수족이며, 이를 뒤집으면 시그모이드가 나온다. 가우시안(\(\sigma^2 = 1\))은 \(\eta = \mu\)다.
- GLM은 (1) \(y \mid x\)가 지수족, (2) \(h(x) = \mathbb{E}[T(y) \mid x]\), (3) \(\eta = \theta^T x\)라는 세 가정으로 만든다.
- 가우시안을 고르면 최소제곱 선형 회귀, 베르누이를 고르면 로지스틱 회귀가 나온다. 정준 반응 함수는 각각 항등 함수와 로지스틱 함수다.
- \(a'(\eta) = \mathbb{E}[y]\)이므로 GLM의 확률적 경사상승 규칙은 항상 \(\theta := \theta + \alpha (y - h_\theta(x)) x\) 꼴이다.
- 다중 클래스 분류는 소프트맥스로 확률을 만들고 교차 엔트로피 손실을 최소화한다. 로짓에 대한 그래디언트는 \(\phi - e_y\)다.