- Stanford CS229 Machine Learning (Spring 2022) 8강 정리
- 강의: Tengyu Ma, Christopher Ré
- ▶ 강의 영상
- 참고: CS229 lecture notes Ch. 7 Deep learning(7.1–7.3, 7.5)
비선형 모델을 쓰는 지도 학습
지금까지의 모델 \(h_\theta(x) = \theta^T x\)와 \(h_\theta(x) = \theta^T \phi(x)\)는 모두 매개변수 \(\theta\)에 대해 선형이었다. 이제 매개변수와 입력 모두에 대해 비선형인 일반적인 모델군을 다룬다. 가장 흔한 예가 신경망(neural network)이지만, 이 절에서는 \(h_\theta(x)\)를 추상적인 비선형 모델로 보면 충분하다. 학습 데이터는 \(\{(x^{(i)}, y^{(i)})\}_{i=1}^{n}\)이다.
회귀
\(y^{(i)} \in \mathbb{R}\)이고 모델도 실수를 출력한다. 예제별 최소제곱 비용과 전체 평균 비용은 다음과 같다.
\[J^{(i)}(\theta) = \frac{1}{2} \left( h_\theta(x^{(i)}) - y^{(i)} \right)^2, \qquad J(\theta) = \frac{1}{n} \sum_{i=1}^{n} J^{(i)}(\theta)\]선형 회귀와 같은 꼴이지만 앞에 \(1/n\)을 붙였다. 상수배는 최소점을 바꾸지 않는다. 형태는 같아도 \(h_\theta\)의 매개변수화가 다르다는 점이 핵심이다.
이진 분류
매개변수화된 모델 \(\bar{h}_\theta : \mathbb{R}^d \to \mathbb{R}\)의 출력을 로짓(logit) 이라 한다. 로지스틱 회귀의 \(\theta^T x\)에 해당한다. 로지스틱 함수로 확률을 만든다.
\[h_\theta(x) = g(\bar{h}_\theta(x)) = \frac{1}{1 + \exp(-\bar{h}_\theta(x))}, \qquad P(y = 1 \mid x; \theta) = h_\theta(x)\]손실은 음의 로그우도 \(J^{(i)}(\theta) = -\log p(y^{(i)} \mid x^{(i)}; \theta) = \ell_{\text{logistic}}(\bar{h}_\theta(x^{(i)}), y^{(i)})\)이고, 전체 손실은 이를 평균한 것이다.
다중 클래스 분류
\(y \in \{1, \ldots, k\}\)일 때 \(\bar{h}_\theta : \mathbb{R}^d \to \mathbb{R}^k\)가 클래스마다 로짓을 하나씩 출력하고, 소프트맥스(softmax)로 확률 벡터를 만든다.
\[P(y = j \mid x; \theta) = \frac{\exp(\bar{h}_\theta(x)_j)}{\sum_{s=1}^{k} \exp(\bar{h}_\theta(x)_s)}\]손실은 교차 엔트로피(cross-entropy) \(J^{(i)}(\theta) = -\log p(y^{(i)} \mid x^{(i)}; \theta) = \ell_{\text{ce}}(\bar{h}_\theta(x^{(i)}), y^{(i)})\)다. 더 일반적으로 \(\eta = \bar{h}_\theta(x)\)인 임의의 지수족 분포로 확장할 수 있지만(GLM 참고), 실제로는 위 세 경우가 가장 널리 쓰인다.
최적화: SGD와 미니배치 SGD
경사하강법(gradient descent)은 \(\theta := \theta - \alpha \nabla_\theta J(\theta)\)이다. 확률적 경사하강법(stochastic gradient descent, SGD) 은 매 반복마다 \(j\)를 \(\{1, \ldots, n\}\)에서 균등하게 뽑아 \(\theta := \theta - \alpha \nabla_\theta J^{(j)}(\theta)\)로 갱신한다.
하드웨어 병렬화 덕분에 \(B\)개 예제의 그래디언트를 한꺼번에 계산하는 편이 따로 \(B\)번 계산하는 것보다 빠른 경우가 많다. 그래서 딥러닝에서는 미니배치 SGD(mini-batch SGD) 가 가장 흔하다. 매 반복마다 \(j_1, \ldots, j_B\)를 비복원 추출해 다음과 같이 갱신한다.
\[\theta := \theta - \frac{\alpha}{B} \sum_{k=1}^{B} \nabla_\theta J^{(j_k)}(\theta)\]딥러닝 모델의 학습은 결국 세 단계다. (1) 신경망 매개변수화 \(h_\theta(x)\)를 정의하고, (2) 손실의 그래디언트를 효율적으로 계산하는 역전파를 작성하고(9강), (3) SGD나 그 변형으로 \(J(\theta)\)를 최적화한다.
신경망
신경망은 행렬 곱과 성분별 비선형 연산을 조합한 넓은 비선형 모델군이다. 회귀에서는 최종 예측이 \(h_\theta(x) = \bar{h}_\theta(x)\)이고, 분류에서는 \(\bar{h}_\theta(x)\)가 로짓이 된다.
뉴런 하나짜리 신경망
집값 예측에서 직선 대신, 가격이 음수가 되지 않도록 0에서 꺾이는 함수를 쓰고 싶다고 하자. 가장 단순한 매개변수화는 다음과 같다.
\[\bar{h}_\theta(x) = \max(wx + b, 0), \qquad \theta = (w, b) \in \mathbb{R}^2\]\(\max\{t, 0\}\)을 ReLU(rectified linear unit) 라 한다. 이처럼 \(\mathbb{R} \to \mathbb{R}\)인 비선형 함수를 활성화 함수(activation function) 라 하고, 비선형 활성화가 하나뿐이므로 이 모델은 뉴런이 하나다. 입력이 \(x \in \mathbb{R}^d\)이면 \(\bar{h}_\theta(x) = \text{ReLU}(w^T x + b)\)이고, \(b\)를 편향(bias), \(w\)를 가중치 벡터(weight vector)라 한다.
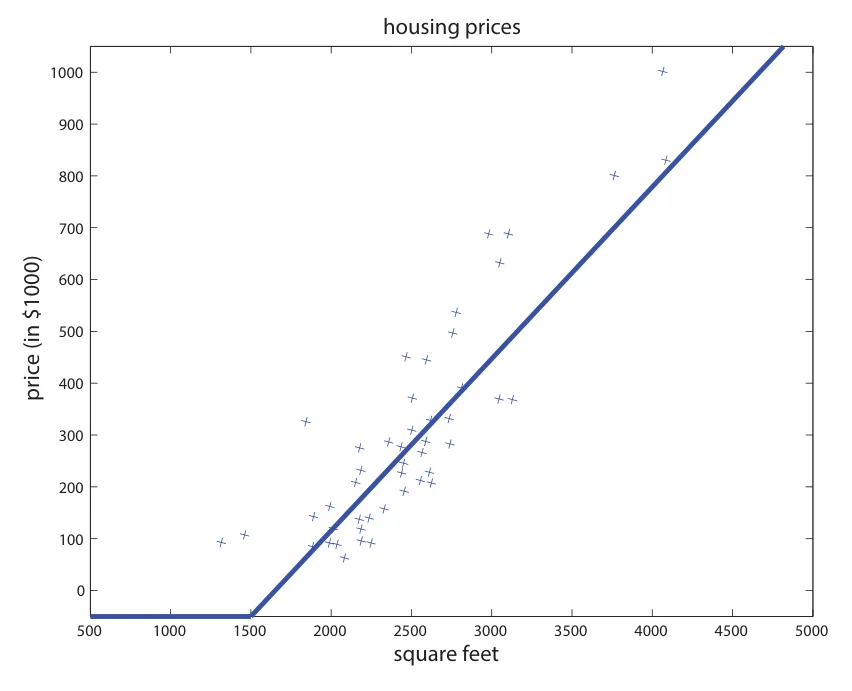 집값 데이터에 뉴런 하나, \(\max(wx + b, 0)\)을 맞춘 그림이다. 면적이 작은 구간에서는 예측이 바닥에 평평하게 머물다가, 꺾이는 점(kink)을 지나면 직선으로 증가한다. 출처: CS229 lecture notes.
그림의 굵은 선이 \(\bar{h}_\theta(x)\)다. 가로축의 약 1500제곱피트에서 \(wx + b = 0\)이 되고, 그보다 작은 면적에서는 \(wx + b < 0\)이어서 ReLU가 출력을 0으로 자른다. 그보다 큰 면적에서는 ReLU가 아무것도 하지 않으므로 기울기 \(w\)인 직선이 된다. 즉 매개변수 두 개로 “꺾이는 위치”(\(-b/w\))와 “꺾인 뒤의 기울기”(\(w\))를 함께 정한다.
직선 하나로 맞추면 면적이 작은 집에 음수 가격을 예측할 수 있지만, 이 함수는 그런 일이 없다. 대신 모델이 꺾인 직선 하나로 고정되어 있어 표현력이 여전히 작다. 아래에서는 이런 뉴런을 여러 개 쌓아 더 복잡한 함수를 만든다.
뉴런 쌓기
넓이, 침실 수, 우편번호, 동네의 부유함이라는 네 입력 \(x_1, \ldots, x_4\)가 있다고 하자. 가격은 수용 가능한 가족 규모(넓이와 침실 수로 결정), 도보 편의성(우편번호), 학교의 질(우편번호와 부유함)에 달려 있다고 가정하면, 이 세 중간 변수를 은닉 유닛(hidden unit) \(a_1, a_2, a_3\)로 둘 수 있다.
\[a_1 = \text{ReLU}(\theta_1 x_1 + \theta_2 x_2 + \theta_3), \quad a_2 = \text{ReLU}(\theta_4 x_3 + \theta_5), \quad a_3 = \text{ReLU}(\theta_6 x_3 + \theta_7 x_4 + \theta_8)\] \[\bar{h}_\theta(x) = \theta_9 a_1 + \theta_{10} a_2 + \theta_{11} a_3 + \theta_{12}\]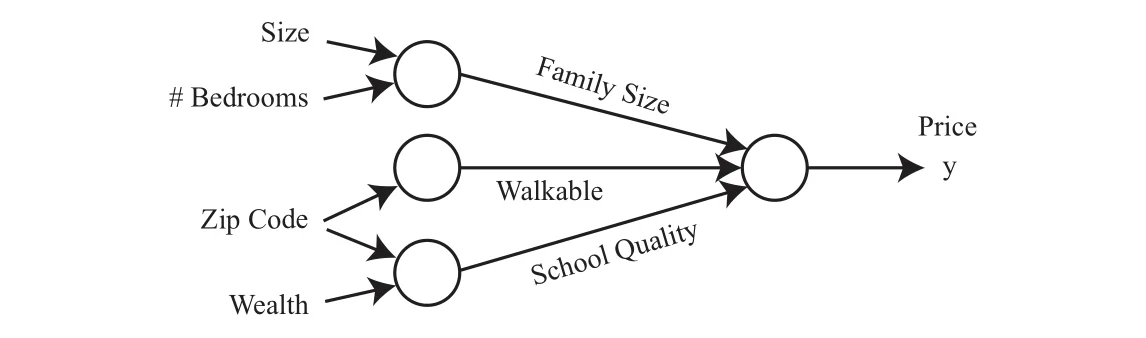 집값 예측을 위한 작은 신경망이다. 네 입력이 세 은닉 유닛(가족 규모, 도보 편의성, 학교의 질)으로 모이고, 세 은닉 유닛이 다시 출력 뉴런 하나로 모여 가격 \(y\)를 낸다. 출처: CS229 lecture notes.
그림의 동그라미 하나가 뉴런 하나이고, 화살표는 어떤 값이 어떤 뉴런의 입력이 되는지를 나타낸다. 왼쪽 위의 뉴런은 Size와 # Bedrooms만 받으므로 \(a_1\)이 \(x_1, x_2\)에만 의존하는 위 식과 대응하고, Zip Code는 두 은닉 유닛으로 갈라져 들어가므로 \(a_2\)와 \(a_3\) 모두에 쓰인다. 각 화살표 하나에 매개변수 하나(가중치)가 붙고, 뉴런마다 편향이 하나씩 더 있어 \(\theta_1, \ldots, \theta_{12}\)의 12개가 된다.
은닉 유닛에 붙은 이름(Family Size, Walkable, School Quality)은 설명을 위한 것일 뿐, 학습 과정이 이 의미를 보장하지는 않는다. 학습 알고리즘은 최종 예측 오차를 줄이도록 \(\theta\)를 고를 뿐이고, 중간 유닛이 무엇을 표현하게 될지는 데이터가 정한다.
레고 블록처럼 뉴런을 쌓아 복잡한 함수를 만든 것이다. 출력 근처의 마지막 층에는 보통 ReLU를 적용하지 않는다(출력이 양수일 필요가 없으므로).
인공 신경망은 생물학적 신경망에서 영감을 받았다. 은닉 유닛은 뉴런, 매개변수는 시냅스에 대응한다. 다만 현대의 깊은 인공 신경망이 실제 뇌와 얼마나 비슷한지는 불분명하다. 1000층짜리 생물학적 신경망을 상상하는 신경과학자는 많지 않을 것이고, 뇌가 역전파와 비슷한 방식으로 학습하는지도 열린 문제다.
2층 완전연결 신경망
위 모델은 “가족 규모가 넓이와 침실 수로만 정해진다” 같은 사전 지식을 많이 썼다. 이런 지식이 없는 경우를 위해 각 은닉 유닛이 모든 입력에 의존하게 하면 더 일반적이다. 이를 완전연결(fully-connected) 신경망이라 한다. \(m\)개의 은닉 유닛과 \(d\)차원 입력을 갖는 2층 완전연결 신경망은 다음과 같다.
\[z_j = w_j^{[1]T} x + b_j^{[1]}, \quad a_j = \text{ReLU}(z_j) \quad (j = 1, \ldots, m), \qquad \bar{h}_\theta(x) = w^{[2]T} a + b^{[2]}\]여기서 \(w_j^{[1]} \in \mathbb{R}^d\), \(b_j^{[1]} \in \mathbb{R}\), \(a = [a_1, \ldots, a_m]^T \in \mathbb{R}^m\), \(w^{[2]} \in \mathbb{R}^m\), \(b^{[2]} \in \mathbb{R}\)이다. 위첨자 \([1], [2]\)는 층 번호다.
벡터화
왜 벡터화하는가
식을 간결하게 쓰기 위해서이기도 하지만, 속도가 더 큰 이유다. 위 식을 for 루프로 구현하면 입력과 은닉 유닛 차원이 클 때 매우 느리다. 벡터화(vectorization)는 행렬 연산과 고도로 최적화된 선형대수 패키지(BLAS 등), 그리고 GPU의 병렬성을 활용한다. 이는 딥러닝 발전에 결정적이었다.
2층 신경망의 행렬 표기
\(w_j^{[1]T}\)를 행으로 쌓아 가중치 행렬 \(W^{[1]} \in \mathbb{R}^{m \times d}\)를 만들면 다음과 같다.
\[z = W^{[1]} x + b^{[1]}, \qquad a = \text{ReLU}(z), \qquad \bar{h}_\theta(x) = W^{[2]} a + b^{[2]}\]ReLU는 성분별로 적용하며, \(W^{[2]} = w^{[2]T} \in \mathbb{R}^{1 \times m}\)이다. 벡터는 기본적으로 열벡터다(numpy의 브로드캐스팅에서 벡터를 행벡터로 보는 것과 다르다). \(W^{[1]}, b^{[1]}\)을 첫 번째 층, \(W^{[2]}, b^{[2]}\)를 두 번째 층, \(a\)를 은닉층(hidden layer)이라 한다. 2층 신경망은 은닉층이 하나인 신경망이라고도 한다.
다층 완전연결 신경망
층 수(가중치 행렬 수)가 \(r\)이면 다음과 같다.
\[\begin{aligned} a^{[1]} &= \text{ReLU}(W^{[1]} x + b^{[1]}) \\ a^{[2]} &= \text{ReLU}(W^{[2]} a^{[1]} + b^{[2]}) \\ &\;\;\vdots \\ a^{[r-1]} &= \text{ReLU}(W^{[r-1]} a^{[r-2]} + b^{[r-1]}) \\ \bar{h}_\theta(x) &= W^{[r]} a^{[r-1]} + b^{[r]} \end{aligned}\]\(a^{[k]}\)의 차원이 \(m_k\)이면 \(W^{[k]} \in \mathbb{R}^{m_k \times m_{k-1}}\), \(b^{[k]} \in \mathbb{R}^{m_k}\)이고, \(W^{[1]} \in \mathbb{R}^{m_1 \times d}\), \(W^{[r]} \in \mathbb{R}^{1 \times m_{r-1}}\)이다. 뉴런 수는 \(m_1 + \cdots + m_r\), 매개변수 수는 \((d+1)m_1 + (m_1+1)m_2 + \cdots + (m_{r-1}+1)m_r\)이다. \(a^{[0]} = x\)로 두면 \(a^{[k]} = \text{ReLU}(W^{[k]} a^{[k-1]} + b^{[k]})\)라는 간단한 재귀식을 얻는다. 마지막 층은 보통 ReLU 없이 선형으로 두어 음수 출력을 허용하고, 마지막 층을 선형 모델로 해석하기 쉽게 한다.
다른 활성화 함수
ReLU 대신 여러 비선형 함수 \(\sigma\)를 쓸 수 있다.
| 이름 | \(\sigma(z)\) |
|---|---|
| sigmoid | \(\frac{1}{1 + e^{-z}}\) |
| tanh | \(\frac{e^z - e^{-z}}{e^z + e^{-z}}\) |
| leaky ReLU | \(\max\{z, \gamma z\}, \; \gamma \in (0, 1)\) |
| GELU | \(\frac{z}{2}\left(1 + \text{erf}(z / \sqrt{2})\right)\) |
| Softplus | \(\frac{1}{\beta} \log(1 + \exp(\beta z)), \; \beta > 0\) |
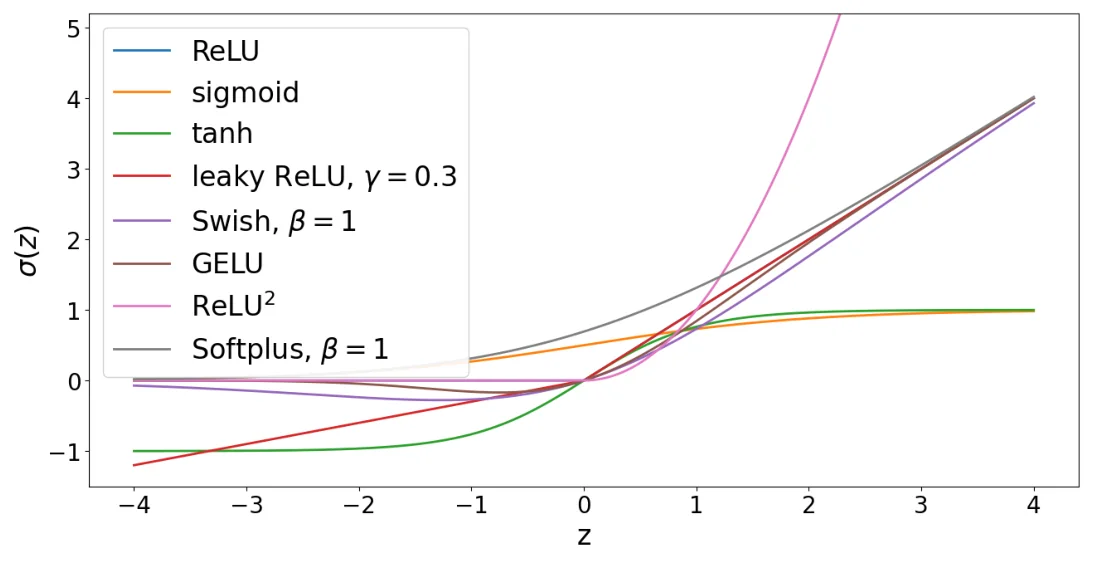 딥러닝에서 쓰이는 활성화 함수들을 한 좌표에 그린 그림이다. 세로축은 5에서 잘라 표시했다. 출처: CS229 lecture notes.
그래프를 보면 활성화 함수들이 크게 두 무리로 나뉜다. sigmoid(주황)와 tanh(초록)는 \(z\)가 커지면 각각 1에 붙고, \(z\)가 작아지면 0과 \(-1\)에 붙어 평평해진다. 평평한 구간에서는 기울기가 거의 0이므로 그래디언트가 사라진다. 반면 ReLU 계열은 \(z > 0\) 쪽에서 기울기 1의 직선이라 포화되지 않는다. 그림에서 ReLU(파랑)는 다른 곡선들과 겹쳐 잘 보이지 않는다.
ReLU의 변형들은 \(z < 0\) 쪽과 \(z = 0\) 근처의 모양이 다르다. leaky ReLU(빨강)는 음수 쪽에서 0 대신 기울기 \(\gamma = 0.3\)의 직선이고, GELU(갈색)와 Swish(보라)는 0 근처에서 매끄럽게 휘며 음수 쪽에서 살짝 0 아래로 내려갔다가 다시 0으로 돌아온다. Softplus(회색)는 ReLU를 매끄럽게 만든 곡선이라 항상 ReLU보다 위에 있고 \(z = 0\)에서 \(\log 2 \approx 0.69\)를 지난다. ReLU²(분홍)는 양수 쪽에서 \(z^2\)로 빠르게 커진다.
sigmoid와 tanh는 양쪽이 유계라서 \(z \to \pm\infty\)에서 그래디언트가 사라지므로, 요즘은 은닉층 활성화로는 덜 쓰인다. Softplus는 2계 도함수가 존재하도록 ReLU를 매끄럽게 만든 것이다. GELU는 BERT 같은 트랜스포머 언어 모델에서 널리 쓰인다.
왜 항등 함수를 쓰지 않는가
\(\sigma(z) = z\)이고 편향이 0이라면 2층 신경망은
\[\bar{h}_\theta(x) = W^{[2]} a^{[1]} = W^{[2]} z^{[1]} = W^{[2]} W^{[1]} x = \tilde{W} x, \qquad \tilde{W} = W^{[2]} W^{[1]}\]이 되어 하나의 선형 함수로 붕괴한다. 선형 함수의 합성은 선형이므로, 비선형 활성화가 없으면 신경망은 선형 회귀와 다를 바 없다.
커널 방법과의 연결
7강의 피처 맵 \(\phi(x)\)는 사람이 설계했다. 좋은 피처 맵을 고르는 과정을 피처 엔지니어링(feature engineering) 이라 하며, 성능이 그 선택에 크게 좌우된다.
딥러닝은 올바른 피처 맵(표현, representation)을 자동으로 학습하는 방법으로 볼 수 있다. 마지막 층을 제외한 매개변수를 \(\beta\)로 묶으면 \(a^{[r-1]} = \phi_\beta(x)\)이고, 모델은 다음과 같다.
\[\bar{h}_\theta(x) = W^{[r]} \phi_\beta(x) + b^{[r]}\]\(\beta\)가 고정되면 이는 피처 \(\phi_\beta(x)\) 위의 선형 모델이다. 학습 중에는 \(\beta\)와 \(W^{[r]}, b^{[r]}\)을 모두 최적화하므로, 선형 모델뿐 아니라 그 위에서 선형 예측이 잘 되도록 하는 피처 맵 자체를 학습한다. 그래서 딥러닝은 도메인 지식에 덜 의존한다. 집값 예제에서도 “가족 규모” 같은 중간 변수를 지정하지 않아도 마지막 은닉층에서 유용한 피처를 스스로 찾을 수 있다. 한 데이터셋에서 얻은 표현이 다른 데이터셋에도 유용한 경우가 많다. 반면 학습된 피처는 사람이 해석하기 어려워 신경망을 블랙박스라 부르기도 한다.
현대 신경망의 모듈
위의 다층 신경망은 요즘 다층 퍼셉트론(multi-layer perceptron, MLP) 이라 불린다. 실제 신경망은 여러 구성 블록(module)을 조합한다. 행렬 곱 모듈을 \(\text{MM}_{W,b}(z) = Wz + b\)로 쓰면 MLP는 다음과 같다.
\[\text{MLP}(x) = \text{MM}_{W^{[r]}, b^{[r]}}(\sigma(\text{MM}_{W^{[r-1]}, b^{[r-1]}}(\sigma(\cdots \text{MM}_{W^{[1]}, b^{[1]}}(x)))))\]잔차 연결(residual connection). ResNet에서 시작해 오늘날 거의 모든 대규모 구조에 쓰인다. 단순화한 잔차 블록과 ResNet은 다음과 같다.
\[\text{Res}(z) = z + \sigma(\text{MM}(\sigma(\text{MM}(z)))), \qquad \text{ResNet-S}(x) = \text{MM}(\text{Res}(\text{Res}(\cdots \text{Res}(x))))\]실제 ResNet은 행렬 곱 대신 합성곱을 쓰고 배치 정규화를 넣는다.
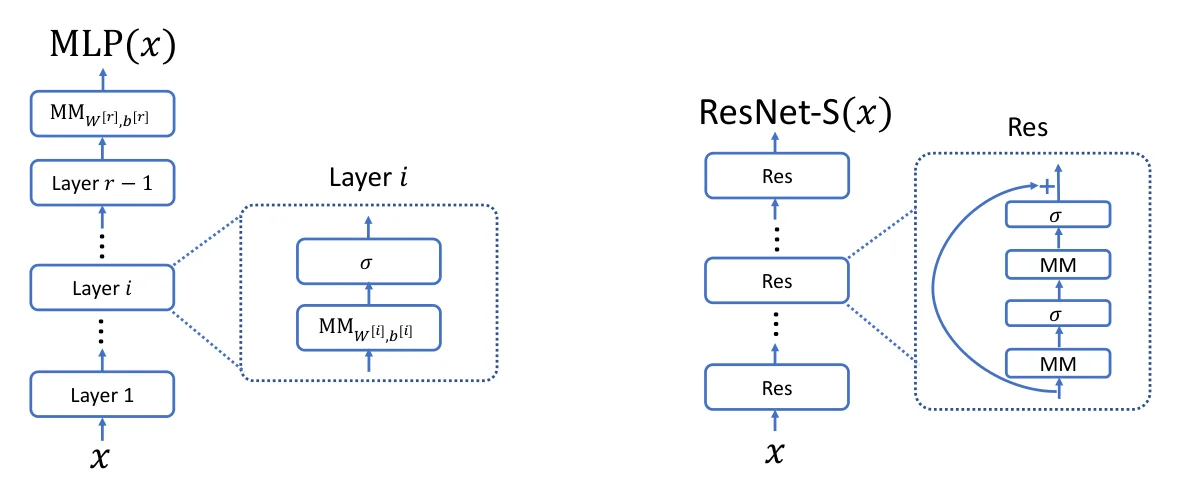 왼쪽은 \(r\)층 MLP, 오른쪽은 단순화한 ResNet을 모듈 단위로 그린 그림이다. 점선 상자는 한 층(Layer \(i\))과 한 잔차 블록(Res)의 내부를 펼쳐 보인 것이다. 출처: CS229 lecture notes.
두 그림 모두 아래에서 위로 읽는다. 왼쪽에서 입력 \(x\)는 Layer 1부터 Layer \(r-1\)까지 차례로 통과하고, 마지막에 활성화 없는 \(\text{MM}_{W^{[r]}, b^{[r]}}\)을 거쳐 출력이 된다. 펼쳐 본 Layer \(i\)는 \(\text{MM}_{W^{[i]}, b^{[i]}}\) 다음에 \(\sigma\)를 적용하는 두 모듈의 묶음이며, 위의 MLP 식에서 괄호 한 겹에 해당한다.
오른쪽의 Res 블록 안에는 MM, \(\sigma\), MM, \(\sigma\)가 쌓여 있고, 블록의 입력에서 출발해 이들을 건너뛰고 맨 위의 \(+\)로 들어가는 곡선 화살표가 있다. 이 곡선이 잔차 연결이며, 식 \(\text{Res}(z) = z + \sigma(\text{MM}(\sigma(\text{MM}(z))))\)의 첫 항 \(z\)에 해당한다. 블록이 입력을 그대로 다음 블록에 넘겨주는 경로가 항상 있으므로, 블록 안의 모듈들은 입력 전체가 아니라 입력에 더할 “보정”만 학습하면 된다.
층 정규화(layer normalization). 벡터 \(z \in \mathbb{R}^m\)의 경험적 평균 \(\hat{\mu}\)와 표준편차 \(\hat{\sigma}\)로 정규화한 뒤, 학습 가능한 스칼라 \(\beta, \gamma\)로 원하는 평균과 표준편차를 준다.
\[\text{LN-S}(z)_i = \frac{z_i - \hat{\mu}}{\hat{\sigma}}, \qquad \text{LN}(z) = \beta + \gamma \cdot \text{LN-S}(z)\]\(\hat{\mu}, \hat{\sigma}\)도 \(z\)의 함수이므로 미분할 때 상수로 취급하면 안 된다. 중요한 성질은 스케일 불변성이다. \(\text{LN-S}(\alpha z) = \text{LN-S}(z)\)이므로 임의의 \(\alpha > 0\)에 대해 \(\text{LN}(\text{MM}_{\alpha W, \alpha b}(z)) = \text{LN}(\text{MM}_{W,b}(z))\)이다. 그래서 현대 구조의 대부분은 마지막 층을 제외한 모든 가중치의 스케일에 대해 출력이 변하지 않는다. 비전에서는 배치 정규화(batch normalization)나 그룹 정규화(group normalization)가, 언어에서는 층 정규화가 더 많이 쓰인다.
합성곱 층(convolutional layer). 1차원 단순 합성곱은 필터 \(w \in \mathbb{R}^k\)(\(k = 2\ell + 1\))로 각 출력을 이웃한 입력의 선형 결합으로 만든다(양 끝은 0으로 패딩).
\[\text{Conv1D-S}(z)_i = \sum_{j=1}^{2\ell+1} w_j z_{i - \ell + (j-1)}\]이는 \(Q_{i,j} = Q_{i-1,j-1}\)인 행렬 \(Q\)를 곱하는 것, 즉 매개변수를 공유하는 행렬 곱이다. 일반 행렬 곱은 매개변수 \(m^2\)개와 시간 \(O(m^2)\)이 들지만 합성곱은 매개변수 \(k\)개와 시간 \(O(km)\)이면 된다. 입력 채널 \(C\), 출력 채널 \(C'\)인 Conv1D는 각 출력 채널이 모든 입력 채널에 대한 단순 합성곱의 합이며 매개변수는 \(kCC'\)개다. 이미지에 쓰는 2차원 합성곱은 \(k \times k\) 필터를 쓰며 매개변수는 \(CC'k^2\)개다. 이 필터를 “커널”이라고도 부르지만 커널 방법의 커널과는 관계가 없다.
학습 예제에 대한 벡터화
여러 예제에 대한 계산도 병렬화한다. 예제 \(x^{(1)}, x^{(2)}, x^{(3)}\)의 첫 층 계산 \(z^{[1](i)} = W^{[1]} x^{(i)} + b^{[1]}\)을 루프로 돌리는 대신, 예제를 열로 쌓은 \(X = [x^{(1)} \; x^{(2)} \; x^{(3)}] \in \mathbb{R}^{d \times 3}\)을 만든다(대괄호는 층, 괄호는 예제 번호).
\[Z^{[1]} = [z^{[1](1)} \; z^{[1](2)} \; z^{[1](3)}] = W^{[1]} X + b^{[1]}\]엄밀히는 \(b^{[1]} \in \mathbb{R}^{m \times 1}\)을 \(W^{[1]} X \in \mathbb{R}^{m \times 3}\)에 더할 수 없지만, 실제로는 \(b^{[1]}\)을 열마다 복사하는 브로드캐스팅(broadcasting) 으로 처리한다.
구현상 주의점이 있다. 딥러닝 패키지는 모두 데이터를 데이터 행렬의 행에 두지만, 논문은 대개 이 노트처럼 열벡터 표기를 쓴다. 변환은 간단하다. 열벡터는 행벡터로, 행렬은 전치로 바꾸고 곱의 순서를 뒤집는다. 행 우선 규약에서는 \(X \in \mathbb{R}^{3 \times d}\), \(W^{[1]} \in \mathbb{R}^{d \times m}\), \(b^{[1]} \in \mathbb{R}^{1 \times m}\)이고 \(Z^{[1]} = X W^{[1]} + b^{[1]} \in \mathbb{R}^{3 \times m}\)이다.
정리
- 회귀(제곱 손실), 이진 분류(로짓 + 로지스틱 손실), 다중 분류(로짓 + 소프트맥스 교차 엔트로피)는 모두 비선형 모델 \(\bar{h}_\theta\)로 일반화되며, 미니배치 SGD로 최적화한다.
- 뉴런은 \(\text{ReLU}(w^T x + b)\)이고, 뉴런을 쌓으면 신경망이 된다. 완전연결 층은 모든 은닉 유닛이 모든 입력에 의존한다.
- 다층 신경망은 \(a^{[k]} = \text{ReLU}(W^{[k]} a^{[k-1]} + b^{[k]})\)의 재귀로 쓰이며, 마지막 층은 보통 선형이다. 벡터화는 GPU와 선형대수 라이브러리를 활용하기 위해 필수다.
- 비선형 활성화가 없으면 층을 아무리 쌓아도 선형 모델로 붕괴한다.
- 신경망은 마지막 은닉층 \(\phi_\beta(x)\)라는 피처 맵을 데이터로부터 학습하는 모델로 볼 수 있어 피처 엔지니어링 부담이 줄어든다.
- 잔차 연결, 층 정규화(스케일 불변성), 합성곱(매개변수 공유)이 현대 구조의 주요 모듈이다.
- 여러 예제는 열로 쌓아 \(Z = WX + b\)(브로드캐스팅)로 한 번에 계산하며, 구현에서는 행 우선 규약 \(Z = XW + b\)를 쓴다.