- Stanford CS229 Machine Learning (Spring 2022) 11강 정리
- 강의: Tengyu Ma, Christopher Ré
- ▶ 강의 영상
- 참고: CS229 lecture notes Ch. 9 Regularization and model selection(9.3–9.4)
모델 선택 문제
10강에서 본 편향과 분산 사이의 균형을 자동으로 찾고 싶다. 예를 들어 다항식 회귀 \(h_\theta(x) = g(\theta_0 + \theta_1 x + \cdots + \theta_k x^k)\)에서 차수 \(k\)를 0부터 10 중 무엇으로 할지, 국소 가중 회귀의 대역폭 \(\tau\)나 \(\ell_1\) 정규화 SVM의 \(C\)를 얼마로 할지를 정해야 한다. SVM, 신경망, 로지스틱 회귀 중 하나를 고르는 것도 같은 문제다.
유한한 모델 집합 \(\mathcal{M} = \{M_1, \ldots, M_d\}\)에서 고른다고 하자. 무한 집합(예: \(\tau \in \mathbb{R}^+\))은 이산화하면 된다.
교차 검증
학습 오차로 고르면 안 되는 이유
가장 먼저 떠오르는 방법은 각 모델 \(M_i\)를 학습 집합 \(S\)로 학습해 가설 \(h_i\)를 얻고, 학습 오차가 가장 작은 것을 고르는 것이다. 이 방법은 작동하지 않는다. 다항식 차수가 높을수록 학습 집합을 더 잘 맞추므로 항상 분산이 큰 고차 다항식을 고르게 된다.
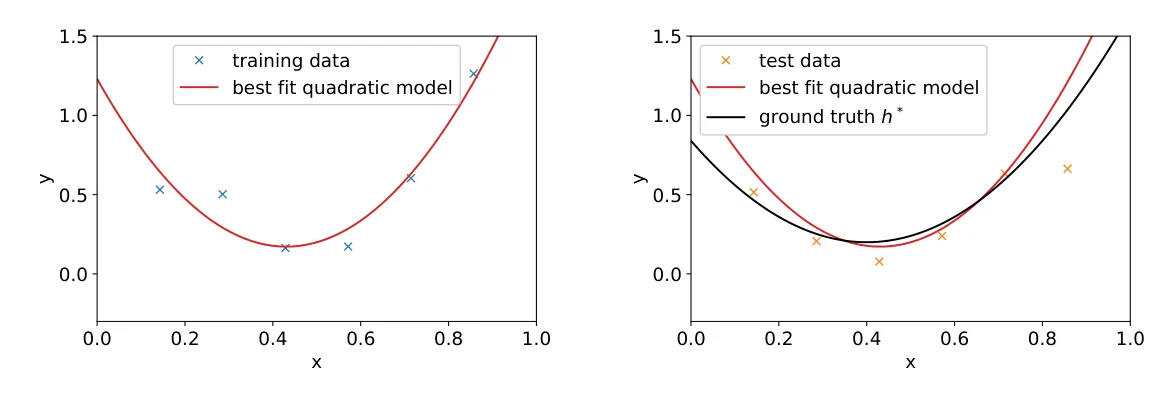 10강의 예제에 2차 다항식을 맞춘 결과. 학습 점을 정확히 지나지는 않지만(왼쪽), 참 함수 \(h^\star\)(검은 곡선)에 가까워 테스트 오차도 작다(오른쪽). 출처: CS229 lecture notes.
같은 6개의 학습 점에 1차, 2차, 5차 다항식을 각각 맞추면 학습 오차는 차수가 높을수록 작아져 5차에서 0이 된다. 학습 오차만 보면 5차가 이긴다. 그러나 그림처럼 2차 모델은 학습 점에서 약간의 오차를 남기는 대신 데이터의 전체 모양을 따라가므로, 처음 보는 테스트 점(주황색)에서도 오차가 작다. 직선은 편향 때문에, 5차 다항식은 분산 때문에 테스트 오차가 큰 반면 2차가 그 사이의 균형점에 있다. 모델 선택이란 이 2차 같은 선택을, 참 함수를 모르는 상태에서 데이터만으로 찾아내는 일이다. 그러려면 학습에 쓰지 않은 데이터로 테스트 오차를 추정해야 하며, 이것이 교차 검증의 출발점이다.
홀드아웃 교차 검증
홀드아웃 교차 검증(hold-out cross validation), 또는 단순 교차 검증은 다음과 같다.
- \(S\)를 무작위로 \(S_{\text{train}}\)(예: 70%)과 \(S_{\text{cv}}\)(나머지 30%)로 나눈다. \(S_{\text{cv}}\)를 홀드아웃 검증 집합이라 한다.
- 각 \(M_i\)를 \(S_{\text{train}}\)으로만 학습해 \(h_i\)를 얻는다.
- 검증 집합에서의 오차 \(\hat{\varepsilon}_{S_{\text{cv}}}(h_i)\)(검증 오차, validation error)가 가장 작은 \(h_i\)를 고른다.
학습에 쓰지 않은 예제로 평가하므로 각 가설의 일반화 오차를 더 잘 추정하고, 추정된 일반화 오차가 가장 작은 모델을 고르는 셈이다. 보통 데이터의 1/4에서 1/3, 흔히 30%를 검증에 쓴다. 데이터가 매우 많으면 절대 개수만 충분하면 비율은 작아도 된다. 예컨대 약 100만 장인 ImageNet에서는 5% 정도인 5만 장을 검증 집합으로 쓰기도 한다.
3단계 대신 \(\arg\min_i \hat{\varepsilon}_{S_{\text{cv}}}(h_i)\)로 모델 \(M_i\)를 고른 뒤 전체 \(S\)로 다시 학습하는 것도 대개 좋은 선택이다. 다만 초기 조건이나 데이터의 작은 변화에 매우 민감한 알고리즘이라면 재학습을 생략하는 편이 나을 수 있다.
단점은 약 30%의 데이터를 “낭비”한다는 것이다. 재학습을 하더라도 모델 비교 자체는 \(0.7n\)개로 학습한 모델로 이루어진다. 데이터가 많거나 싸면 괜찮지만, \(n = 20\)처럼 데이터가 귀하면 더 나은 방법이 필요하다.
k겹 교차 검증
k겹 교차 검증(k-fold cross validation) 은 매번 더 적은 데이터를 떼어 놓는다.
- \(S\)를 \(n/k\)개씩의 서로소인 부분집합 \(S_1, \ldots, S_k\)로 무작위로 나눈다.
- 각 모델 \(M_i\)에 대해 \(j = 1, \ldots, k\)마다 \(S_j\)를 뺀 나머지로 학습해 \(h_{ij}\)를 얻고, \(S_j\)에서 \(\hat{\varepsilon}_{S_j}(h_{ij})\)를 잰다. 이들의 평균을 \(M_i\)의 추정 일반화 오차로 삼는다.
- 추정 일반화 오차가 가장 작은 \(M_i\)를 골라 전체 \(S\)로 다시 학습한다.
흔히 \(k = 10\)을 쓴다. 떼어 놓는 비율은 \(1/k\)로 줄지만 각 모델을 \(k\)번 학습해야 하므로 계산 비용이 크다.
LOOCV
데이터가 정말 부족하면 극단적으로 \(k = n\)을 쓴다. 매번 예제 하나만 빼고 학습한 뒤 그 예제로 평가하고, \(n\)개의 오차를 평균한다. 이를 LOOCV(leave-one-out cross validation) 라 한다.
교차 검증은 모델 선택뿐 아니라 단일 모델이나 알고리즘의 성능을 평가하는 데에도 쓸 수 있다. 새 알고리즘의 성능을 논문에 보고할 때도 합리적인 방법이다.
피처 선택
이 절은 현재 판 main notes에는 없고, 이전 판 CS229 노트(“Regularization and model selection”)의 피처 선택 내용을 바탕으로 정리했다.
모델 선택의 특별하고 중요한 경우가 피처 선택(feature selection) 이다. 피처 수 \(d\)가 학습 예제 수보다 훨씬 많은 문제(텍스트 분류 등)에서, 실제로 관련 있는 피처는 일부뿐이라고 의심된다면 피처 수를 줄여 과적합 위험을 낮출 수 있다. \(d\)개 피처의 부분집합은 \(2^d\)개이므로 모두 시도할 수는 없고, 휴리스틱 탐색을 쓴다.
래퍼 방식: 전진 탐색과 후진 탐색
전진 탐색(forward search) 은 다음과 같다.
- \(\mathcal{F} = \emptyset\)으로 시작한다.
- 반복한다. 각 \(i \notin \mathcal{F}\)에 대해 \(\mathcal{F}_i = \mathcal{F} \cup \{i\}\)를 만들고, \(\mathcal{F}_i\)의 피처만 쓰는 모델을 교차 검증으로 평가한다. 가장 좋은 \(\mathcal{F}_i\)를 새 \(\mathcal{F}\)로 삼는다.
- 모든 피처를 다 넣었거나 \(\lvert \mathcal{F} \rvert\)가 미리 정한 상한에 도달하면 멈추고, 그동안 평가한 부분집합 중 가장 좋은 것을 고른다.
후진 탐색(backward search) 은 반대로 \(\mathcal{F} = \{1, \ldots, d\}\)에서 시작해 피처를 하나씩 제거한다. 학습 알고리즘을 감싸서 반복 호출하므로 이런 방법을 래퍼 모델 피처 선택(wrapper model feature selection) 이라 한다. 성능은 좋은 편이지만, 전진 탐색을 끝까지 하면 학습 알고리즘을 \(O(d^2)\)번 호출해야 해서 비용이 크다.
필터 방식
필터 피처 선택(filter feature selection) 은 계산이 훨씬 싸다. 각 피처 \(x_i\)가 레이블 \(y\)에 대해 얼마나 정보를 주는지 점수 \(S(i)\)를 매기고, 점수가 높은 \(k\)개를 고른다. 점수로는 \(x_i\)와 \(y\)의 상관계수의 절댓값이나, 이산 피처라면 상호 정보량(mutual information) 을 쓴다.
\[\text{MI}(x_i, y) = \sum_{x_i} \sum_{y} p(x_i, y) \log \frac{p(x_i, y)}{p(x_i) p(y)}\]확률은 학습 데이터의 경험적 분포로 추정한다. 이는 KL 발산 \(\text{KL}\left( p(x_i, y) \,\Vert\, p(x_i) p(y) \right)\)과 같으므로, \(x_i\)와 \(y\)가 독립에 가까울수록 0에 가깝고, 서로 많은 정보를 줄수록 커진다. 몇 개의 피처를 남길지는 교차 검증으로 정한다.
베이즈 통계와 정규화
빈도주의와 베이즈 관점
지금까지는 최대우도 추정(maximum likelihood estimation, MLE)으로 매개변수를 골랐다.
\[\theta_{\text{MLE}} = \arg\max_\theta \prod_{i=1}^{n} p(y^{(i)} \mid x^{(i)}; \theta)\]여기서 \(\theta\)는 무작위가 아니라 값을 모를 뿐인 상수다. 이것이 빈도주의 통계(frequentist statistics) 의 관점이다.
베이즈 관점(Bayesian view) 에서는 \(\theta\)를 값을 모르는 확률 변수로 보고, 사전 믿음을 나타내는 사전 분포(prior distribution) \(p(\theta)\)를 둔다. 학습 집합 \(S\)가 주어지면 사후 분포(posterior distribution) 는 다음과 같다.
\[p(\theta \mid S) = \frac{p(S \mid \theta) p(\theta)}{p(S)} = \frac{\left( \prod_{i=1}^{n} p(y^{(i)} \mid x^{(i)}, \theta) \right) p(\theta)}{\int_\theta \left( \prod_{i=1}^{n} p(y^{(i)} \mid x^{(i)}, \theta) \right) p(\theta) \, d\theta}\]\(p(y^{(i)} \mid x^{(i)}, \theta)\)는 사용하는 모델에서 온다. 베이즈 로지스틱 회귀라면 \(h_\theta(x^{(i)})^{y^{(i)}} (1 - h_\theta(x^{(i)}))^{1 - y^{(i)}}\)이다. \(\theta\)가 확률 변수이므로 세미콜론 대신 조건부 기호를 쓴다.
새 입력 \(x\)에 대한 예측은 사후 분포로 평균한다.
\[p(y \mid x, S) = \int_\theta p(y \mid x, \theta) \, p(\theta \mid S) \, d\theta\]예컨대 기댓값 \(\mathbb{E}[y \mid x, S] = \int_y y \, p(y \mid x, S) \, dy\)를 출력한다. 이를 “완전한 베이즈(fully Bayesian)” 예측이라 한다.
MAP 추정
문제는 고차원 \(\theta\)에 대한 적분이라 사후 분포를 닫힌 꼴로 계산하기 어렵다는 것이다. 그래서 사후 분포를 하나의 점 추정으로 근사한다. MAP(maximum a posteriori) 추정은 다음과 같다.
\[\theta_{\text{MAP}} = \arg\max_\theta \prod_{i=1}^{n} p(y^{(i)} \mid x^{(i)}, \theta) \, p(\theta)\]MLE와 같고 끝에 사전 분포 \(p(\theta)\)만 붙었다. 흔한 선택은 \(\theta \sim \mathcal{N}(0, \tau^2 I)\)이다. 로그를 취하면 \(\log p(\theta) = -\frac{1}{2\tau^2} \lVert \theta \rVert_2^2 + \text{const}\)이므로 다음과 같다.
\[\theta_{\text{MAP}} = \arg\min_\theta \left( -\sum_{i=1}^{n} \log p(y^{(i)} \mid x^{(i)}, \theta) + \frac{1}{2\tau^2} \lVert \theta \rVert_2^2 \right)\]즉 가우시안 사전 분포를 둔 MAP 추정은 \(\lambda = 1/\tau^2\)인 \(\ell_2\) 정규화(10강)와 같다. MAP 추정값은 MLE보다 노름이 작고 과적합에 덜 민감하다. 예를 들어 베이즈 로지스틱 회귀는 보통 \(d \gg n\)인 텍스트 분류에서도 효과적이다.
머신러닝 실전 조언
이 절은 main notes에 없는 내용으로, CS229에서 오래 다뤄 온 “Advice for applying machine learning” 계열의 일반적인 지침을 정리했다.
학습 알고리즘이 기대만큼 성능을 내지 못할 때, 데이터를 더 모으거나 피처를 바꾸는 등 손에 잡히는 대로 시도하기보다 먼저 원인을 진단하는 것이 시간을 아낀다.
편향인가 분산인가
학습 오차와 검증(또는 테스트) 오차를 비교한다.
- 분산이 큰 경우: 학습 오차는 목표보다 훨씬 작은데 검증 오차가 크다. 둘 사이 간극이 크다. 학습 예제 수를 늘려 가며 오차를 그린 학습 곡선(learning curve) 에서 검증 오차가 계속 내려가는 중이라면 데이터를 더 모으는 것이 도움이 된다.
- 편향이 큰 경우: 학습 오차부터 목표보다 크다. 학습 오차와 검증 오차가 모두 높고 서로 가깝다. 이때는 데이터를 더 모아도 거의 도움이 되지 않는다.
진단에 따라 처방이 달라진다.
| 처방 | 주로 고치는 것 |
|---|---|
| 학습 예제를 더 모은다 | 분산 |
| 피처 수를 줄인다 | 분산 |
| 정규화를 강하게 한다(\(\lambda\) 증가) | 분산 |
| 피처를 더 넣거나 더 표현력 있는 모델을 쓴다 | 편향 |
| 정규화를 약하게 한다(\(\lambda\) 감소) | 편향 |
최적화 문제인가 목적함수 문제인가
성능이 나쁜 원인이 (1) 알고리즘이 목적함수를 제대로 최적화하지 못해서인지, (2) 목적함수 자체가 잘못되어서인지도 구분할 수 있다. 다른 방법으로 얻은, 실제로 더 나은 해 \(\theta'\)와 현재 해 \(\theta\)를 비교해 목적함수 \(J\)(최대화 기준)에서 \(J(\theta') > J(\theta)\)라면 최적화가 부족한 것이고, \(J(\theta') \leq J(\theta)\)인데도 \(\theta'\)가 더 좋다면 목적함수가 진짜 목표를 제대로 반영하지 못하는 것이다.
오류 분석과 절제 분석
여러 구성 요소로 이루어진 파이프라인에서는 다음 두 분석이 유용하다.
- 오류 분석(error analysis): 파이프라인의 각 구성 요소를 하나씩 정답(ground truth)으로 바꿔 끼우며 전체 성능이 얼마나 오르는지 본다. 개선 여지가 가장 큰 구성 요소에 노력을 집중한다.
- 절제 분석(ablative analysis): 반대로 최종 시스템에서 구성 요소를 하나씩 제거하며 성능이 얼마나 떨어지는지 보고, 어떤 요소가 실제로 기여하는지 확인한다.
정리
- 학습 오차로 모델을 고르면 항상 가장 복잡한 모델을 고르게 되므로, 학습에 쓰지 않은 데이터로 일반화 오차를 추정해야 한다.
- 홀드아웃 교차 검증은 간단하지만 데이터 일부를 낭비하고, k겹 교차 검증(\(k = 10\)이 흔함)과 LOOCV는 데이터를 아끼는 대신 계산이 많다.
- 피처 선택은 모델 선택의 특수한 경우다. 래퍼 방식(전진, 후진 탐색)은 정확하지만 비싸고, 필터 방식(상관계수, 상호 정보량)은 싸다.
- 베이즈 관점은 \(\theta\)에 사전 분포를 두고 사후 분포로 예측한다. 계산이 어려워 MAP 점 추정으로 근사한다.
- 가우시안 사전 분포 \(\mathcal{N}(0, \tau^2 I)\)를 둔 MAP 추정은 \(\ell_2\) 정규화와 같다.
- 성능이 나쁠 때는 먼저 편향과 분산 중 무엇이 문제인지, 최적화와 목적함수 중 무엇이 문제인지 진단하고, 그에 맞는 처방을 고른다.