- Stanford CS229 Machine Learning (Spring 2022) 14강 정리
- 강의: Tengyu Ma, Christopher Ré
- ▶ 강의 영상
- 참고: CS229 인자 분석 노트(Factor analysis), CS229 lecture notes 12장 Principal components analysis
인자 분석(factor analysis)은 현재 판의 main notes에는 실려 있지 않아, 같은 강의의 기존 인자 분석 노트의 전개와 표기를 따른다.
문제: 데이터보다 차원이 클 때
공분산 행렬이 특이해진다
13강까지는 데이터 수 \(n\)이 차원 \(d\)보다 충분히 크다고 가정했다. 이제 \(d \gg n\)인 경우를 생각한다. 데이터 하나의 가우시안 \(\mathcal{N}(\mu, \Sigma)\)로 모델링하면 최대우도 추정은 다음과 같다.
\[\mu = \frac{1}{n} \sum_{i=1}^n x^{(i)}, \qquad \Sigma = \frac{1}{n} \sum_{i=1}^n (x^{(i)} - \mu)(x^{(i)} - \mu)^T\]\(n \le d\)이면 \(\Sigma\)는 특이(singular) 행렬이 된다. \(x^{(i)} - \mu\)들이 \(\mathbb{R}^d\)보다 작은 부분공간만 생성하기 때문이다. 그러면 가우시안 밀도의 \(1 / \lvert \Sigma \rvert^{1/2}\)와 \(\Sigma^{-1}\)를 계산할 수 없다. 직관적으로 보면, 최대우도 가우시안은 데이터가 생성하는 아핀 부분공간 위에 모든 확률 질량을 몰아넣는다. \(n\)이 \(d\)보다 약간 큰 정도여도 추정은 불안정하다. GMM 같은 모델을 쓰려면 이 문제를 해결해야 한다.
공분산에 제약 걸기
간단한 해결책은 \(\Sigma\)의 형태를 제한하는 것이다. 대각 행렬로 제한하면 최대우도 추정은 각 좌표의 표본 분산이 된다.
\[\Sigma_{jj} = \frac{1}{n} \sum_{i=1}^n \left( x_j^{(i)} - \mu_j \right)^2\]더 강하게 \(\Sigma = \sigma^2 I\)로 제한하면 \(\sigma^2 = \frac{1}{nd} \sum_{j=1}^d \sum_{i=1}^n (x_j^{(i)} - \mu_j)^2\)이다. 이 경우 \(n \ge 2\)이기만 하면 \(\Sigma\)가 정칙(non-singular)이다. 그러나 이 제약은 각 좌표가 서로 무상관이라고 가정하므로, 데이터의 흥미로운 상관 구조를 전혀 잡지 못한다. 인자 분석은 그 중간을 노린다. 공분산을 전부 추정하지 않으면서도 상관 구조를 일부 잡는다.
가우시안의 주변분포와 조건부분포
인자 분석의 E-step에 필요한 사실을 먼저 정리한다. 확률벡터를 두 부분으로 나누자. \(x_1 \in \mathbb{R}^r\), \(x_2 \in \mathbb{R}^s\)이고 \(x = [x_1; x_2] \sim \mathcal{N}(\mu, \Sigma)\)이다.
\[\mu = \begin{bmatrix} \mu_1 \\ \mu_2 \end{bmatrix}, \qquad \Sigma = \begin{bmatrix} \Sigma_{11} & \Sigma_{12} \\ \Sigma_{21} & \Sigma_{22} \end{bmatrix}\]여기서 \(\Sigma_{12} = \Sigma_{21}^T\)이다. 주변분포는 해당 블록을 그대로 읽으면 된다. \(\mathbb{E}[x_1] = \mu_1\), \(\mathrm{Cov}(x_1) = \mathbb{E}[(x_1 - \mu_1)(x_1 - \mu_1)^T] = \Sigma_{11}\)이고, 가우시안의 주변분포는 가우시안이므로 \(x_1 \sim \mathcal{N}(\mu_1, \Sigma_{11})\)이다.
조건부분포도 가우시안이며, \(x_1 \mid x_2 \sim \mathcal{N}(\mu_{1 \mid 2}, \Sigma_{1 \mid 2})\)이다.
\[\mu_{1 \mid 2} = \mu_1 + \Sigma_{12} \Sigma_{22}^{-1} (x_2 - \mu_2), \qquad \Sigma_{1 \mid 2} = \Sigma_{11} - \Sigma_{12} \Sigma_{22}^{-1} \Sigma_{21}\]인자 분석 모델
모델
인자 분석은 \(k\)차원 잠재 변수 \(z\)(\(k < d\))로부터 데이터가 생성된다고 가정한다.
\[z \sim \mathcal{N}(0, I), \qquad x \mid z \sim \mathcal{N}(\mu + \Lambda z, \Psi)\]매개변수는 \(\mu \in \mathbb{R}^d\), \(\Lambda \in \mathbb{R}^{d \times k}\), 그리고 대각 행렬 \(\Psi \in \mathbb{R}^{d \times d}\)이다. \(k\)는 보통 \(d\)보다 작게 고른다. 같은 모델을 다음처럼 쓸 수도 있다.
\[x = \mu + \Lambda z + \epsilon, \qquad z \sim \mathcal{N}(0, I), \quad \epsilon \sim \mathcal{N}(0, \Psi)\]여기서 \(z\)와 \(\epsilon\)은 독립이다. 생성 과정을 말로 하면, 먼저 \(k\)차원 가우시안에서 \(z\)를 뽑고, \(\mu + \Lambda z\)로 \(\mathbb{R}^d\)의 \(k\)차원 아핀 부분공간에 올린 뒤, 각 좌표에 독립인 잡음 \(\Psi\)를 더한다.
결합분포
\(z\)와 \(x\)는 결합 가우시안이다. 평균은 \(\mathbb{E}[z] = 0\), \(\mathbb{E}[x] = \mu + \Lambda \mathbb{E}[z] + \mathbb{E}[\epsilon] = \mu\)이다. 공분산 블록은 다음처럼 계산된다.
\[\begin{aligned} \Sigma_{zz} &= \mathrm{Cov}(z) = I \\ \Sigma_{zx} &= \mathbb{E}[(z - 0)(x - \mu)^T] = \mathbb{E}[z (\Lambda z + \epsilon)^T] = \mathbb{E}[z z^T] \Lambda^T + \mathbb{E}[z \epsilon^T] = \Lambda^T \\ \Sigma_{xx} &= \mathbb{E}[(\Lambda z + \epsilon)(\Lambda z + \epsilon)^T] = \Lambda \mathbb{E}[z z^T] \Lambda^T + \mathbb{E}[\epsilon \epsilon^T] = \Lambda \Lambda^T + \Psi \end{aligned}\]\(z\)와 \(\epsilon\)이 독립이어서 교차항 \(\mathbb{E}[z \epsilon^T] = 0\)이 사라진다. 정리하면 다음과 같다.
\[\begin{bmatrix} z \\ x \end{bmatrix} \sim \mathcal{N}\left( \begin{bmatrix} 0 \\ \mu \end{bmatrix}, \begin{bmatrix} I & \Lambda^T \\ \Lambda & \Lambda \Lambda^T + \Psi \end{bmatrix} \right)\]따라서 \(x\)의 주변분포는 \(x \sim \mathcal{N}(\mu, \Lambda \Lambda^T + \Psi)\)이다. 공분산이 “저랭크 행렬 + 대각 행렬”의 형태이므로 \(n\)이 작아도 정칙이고, 동시에 \(\Lambda \Lambda^T\) 부분이 좌표 사이의 상관을 표현한다.
로그 우도
주변분포로부터 로그 우도를 쓸 수 있다.
\[\ell(\mu, \Lambda, \Psi) = \log \prod_{i=1}^n \frac{1}{(2\pi)^{d/2} \lvert \Lambda \Lambda^T + \Psi \rvert^{1/2}} \exp\left( -\frac{1}{2} (x^{(i)} - \mu)^T (\Lambda \Lambda^T + \Psi)^{-1} (x^{(i)} - \mu) \right)\]이를 직접 최대화해 닫힌 형태의 해를 얻는 방법은 알려져 있지 않다. 그래서 EM을 쓴다.
인자 분석을 위한 EM
E-step
E-step은 \(Q_i(z^{(i)}) = p(z^{(i)} \mid x^{(i)}; \mu, \Lambda, \Psi)\)를 계산하는 것이다. 위의 결합분포에 가우시안 조건부 공식을 적용하면 \(z^{(i)} \mid x^{(i)} \sim \mathcal{N}(\mu_{z^{(i)} \mid x^{(i)}}, \Sigma_{z^{(i)} \mid x^{(i)}})\)이다.
\[\begin{aligned} \mu_{z^{(i)} \mid x^{(i)}} &= \Lambda^T (\Lambda \Lambda^T + \Psi)^{-1} (x^{(i)} - \mu) \\ \Sigma_{z^{(i)} \mid x^{(i)}} &= I - \Lambda^T (\Lambda \Lambda^T + \Psi)^{-1} \Lambda \end{aligned}\]\(Q_i\)는 이 평균과 공분산을 갖는 가우시안 밀도다. \(z\)가 연속이므로 13강의 합은 적분이 된다.
M-step의 목적 함수
M-step에서는 다음을 \(\mu, \Lambda, \Psi\)에 대해 최대화한다.
\[\sum_{i=1}^n \int_{z^{(i)}} Q_i(z^{(i)}) \log \frac{p(x^{(i)}, z^{(i)}; \mu, \Lambda, \Psi)}{Q_i(z^{(i)})} \, dz^{(i)}\]\(p(x, z) = p(x \mid z) p(z)\)로 나누면 이는 \(\sum_i \mathbb{E}_{z^{(i)} \sim Q_i}[\log p(x^{(i)} \mid z^{(i)}; \mu, \Lambda, \Psi) + \log p(z^{(i)}) - \log Q_i(z^{(i)})]\)이다. 매개변수에 의존하는 것은 첫째 항뿐이다.
Λ의 갱신
\(\Lambda\)와 무관한 항을 빼면 최대화할 것은 다음과 같다.
\[\sum_{i=1}^n \mathbb{E}\left[ -\frac{1}{2} \log \lvert \Psi \rvert - \frac{1}{2} (x^{(i)} - \mu - \Lambda z^{(i)})^T \Psi^{-1} (x^{(i)} - \mu - \Lambda z^{(i)}) \right]\]기댓값은 \(z^{(i)} \sim Q_i\)에 대한 것이다. 이차형식을 전개하고 대각합(trace) 항등식으로 \(\Lambda\)에 대해 미분하면 다음과 같다.
\[\nabla_\Lambda = \sum_{i=1}^n \left( -\Psi^{-1} \Lambda \, \mathbb{E}\left[ z^{(i)} z^{(i)T} \right] + \Psi^{-1} (x^{(i)} - \mu) \, \mathbb{E}\left[ z^{(i)T} \right] \right)\]0으로 두고 풀면 갱신식을 얻는다.
\[\Lambda = \left( \sum_{i=1}^n (x^{(i)} - \mu) \, \mathbb{E}_{z^{(i)} \sim Q_i}\left[ z^{(i)T} \right] \right) \left( \sum_{i=1}^n \mathbb{E}_{z^{(i)} \sim Q_i}\left[ z^{(i)} z^{(i)T} \right] \right)^{-1}\]필요한 기댓값은 E-step의 결과에서 바로 나온다.
\[\mathbb{E}[z^{(i)T}] = \mu_{z^{(i)} \mid x^{(i)}}^T, \qquad \mathbb{E}[z^{(i)} z^{(i)T}] = \mu_{z^{(i)} \mid x^{(i)}} \mu_{z^{(i)} \mid x^{(i)}}^T + \Sigma_{z^{(i)} \mid x^{(i)}}\]둘째 식은 \(\mathrm{Cov}(Y) = \mathbb{E}[YY^T] - \mathbb{E}[Y]\mathbb{E}[Y]^T\)에서 나온다. 이 갱신식은 최소제곱 회귀의 정규 방정식 \(\theta^T = (y^T X)(X^T X)^{-1}\)과 모양이 같다. \(x\)를 \(z\)의 선형 함수로 회귀하는데, \(z\)를 모르므로 그 기댓값을 대신 쓰는 셈이다. 중요한 차이는 \(\mathbb{E}[z z^T]\)에 사후 공분산 \(\Sigma_{z \mid x}\) 항이 들어간다는 점이다. 이를 빠뜨리고 \(\mathbb{E}[z]\mathbb{E}[z]^T\)만 쓰면 잘못된 갱신이 된다.
μ와 Ψ의 갱신
\(\mu\)의 최대화 해는 표본 평균이다.
\[\mu = \frac{1}{n} \sum_{i=1}^n x^{(i)}\]이 값은 매개변수가 변해도 그대로이므로 처음에 한 번만 계산하면 된다. \(\Psi\)는 먼저 다음 행렬을 계산한다.
\[\Phi = \frac{1}{n} \sum_{i=1}^n \left( \tilde{x}^{(i)} \tilde{x}^{(i)T} - \tilde{x}^{(i)} \mu_{z^{(i)} \mid x^{(i)}}^T \Lambda^T - \Lambda \mu_{z^{(i)} \mid x^{(i)}} \tilde{x}^{(i)T} + \Lambda \left( \mu_{z^{(i)} \mid x^{(i)}} \mu_{z^{(i)} \mid x^{(i)}}^T + \Sigma_{z^{(i)} \mid x^{(i)}} \right) \Lambda^T \right)\]여기서 \(\tilde{x}^{(i)} = x^{(i)} - \mu\)이다. 이는 \(\mathbb{E}[(\tilde{x}^{(i)} - \Lambda z^{(i)})(\tilde{x}^{(i)} - \Lambda z^{(i)})^T]\)의 평균, 즉 잔차의 기대 공분산이다. \(\Psi\)는 대각 행렬로 제한되어 있으므로 \(\Phi\)의 대각 성분만 취한다. \(\Psi_{ii} = \Phi_{ii}\)이다.
주성분 분석(PCA)
동기
인자 분석은 데이터가 대략 \(k\)차원 부분공간 근처에 있다는 생각을 확률 모델과 EM으로 표현했다. 주성분 분석(principal components analysis, PCA) 은 같은 목표를 더 직접적으로 달성한다. 데이터가 근사적으로 놓인 부분공간을 고유벡터 계산 한 번으로 찾는다.
노트의 예시는 두 가지다. 자동차 데이터에 최고 속도가 mph와 km/h로 두 번 들어 있다면, 두 속성은 반올림 오차를 빼면 선형 종속이므로 데이터는 사실상 한 차원 낮은 부분공간에 있다. 또 무선조종 헬리콥터 조종사 설문에서 \(x_1\)이 조종 실력, \(x_2\)가 비행을 즐기는 정도라면, 비행을 정말 즐기는 사람만 실력이 늘므로 두 속성은 강하게 상관된다. 데이터는 조종사의 본질적인 “적성”을 나타내는 대각선 방향 \(u_1\) 근처에 모여 있고, 그 축에서 벗어난 성분은 작은 잡음이다. 이런 \(u_1\)을 자동으로 찾는 것이 목표다.
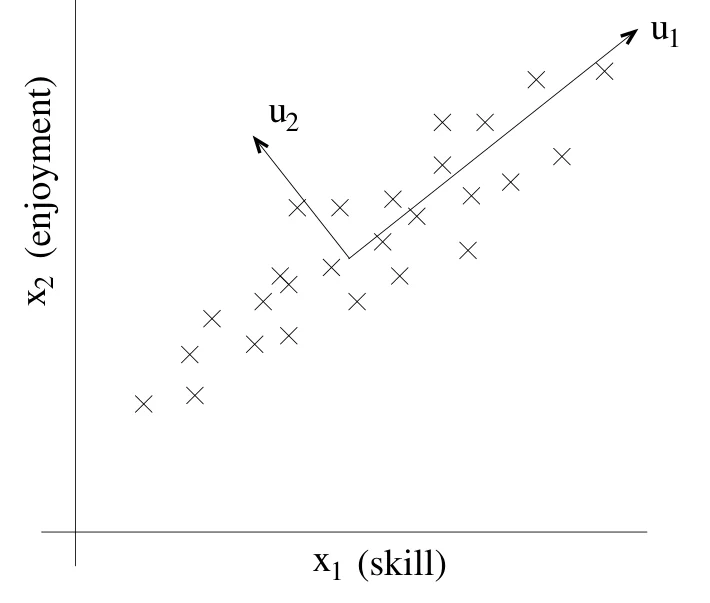 헬리콥터 조종사 설문 데이터. 가로축은 조종 실력 \(x_1\), 세로축은 비행을 즐기는 정도 \(x_2\)이며, 데이터는 대각선 방향 \(u_1\)을 따라 길게 퍼져 있고 수직 방향 \(u_2\)로는 조금만 흩어져 있다. 출처: CS229 lecture notes.
그림의 각 ×는 조종사 한 명이다. 실력이 높은 사람일수록 즐기는 정도도 높으므로 점들이 왼쪽 아래에서 오른쪽 위로 비스듬히 늘어서 있다. 데이터 중심에서 뻗은 두 화살표 중 \(u_1\)은 점들이 가장 길게 퍼진 방향이고, \(u_2\)는 그에 수직인 방향이다. 각 조종사를 \(u_1\) 위의 좌표 하나로 요약하면 2차원 데이터의 거의 모든 변동을 1차원으로 담을 수 있고, \(u_2\) 방향의 작은 흩어짐은 잡음으로 보고 버린다. PCA는 이 \(u_1\), \(u_2\)를 데이터에서 계산해 내는 방법이다.
전처리
PCA 전에 보통 각 특성을 평균 0, 분산 1로 정규화한다.
\[x_j^{(i)} \leftarrow \frac{x_j^{(i)} - \mu_j}{\sigma_j}, \qquad \mu_j = \frac{1}{n} \sum_{i=1}^n x_j^{(i)}, \quad \sigma_j^2 = \frac{1}{n} \sum_{i=1}^n \left( x_j^{(i)} - \mu_j \right)^2\]평균을 빼는 것은 원래 평균이 0인 데이터(음성 같은 시계열)라면 생략할 수 있다. 표준편차로 나누는 것은 단위가 다른 속성(예: 최고 속도와 좌석 수)을 같은 척도에 놓기 위함이며, 모든 속성의 척도가 같다고 알려진 경우(예: 0–255 픽셀 밝기)에는 생략할 수 있다.
분산을 최대로 보존하는 방향
“주된 변동 축” \(u\)는 데이터를 \(u\) 방향으로 사영했을 때 사영된 데이터의 분산이 최대가 되는 단위벡터로 정의한다. 데이터가 원래 가진 분산(정보)을 최대한 보존하는 방향을 고르는 것이다. 사영된 점들이 원점에서 멀리 퍼져 있으면 좋은 방향이고, 원점 근처에 몰려 있으면 나쁜 방향이다.
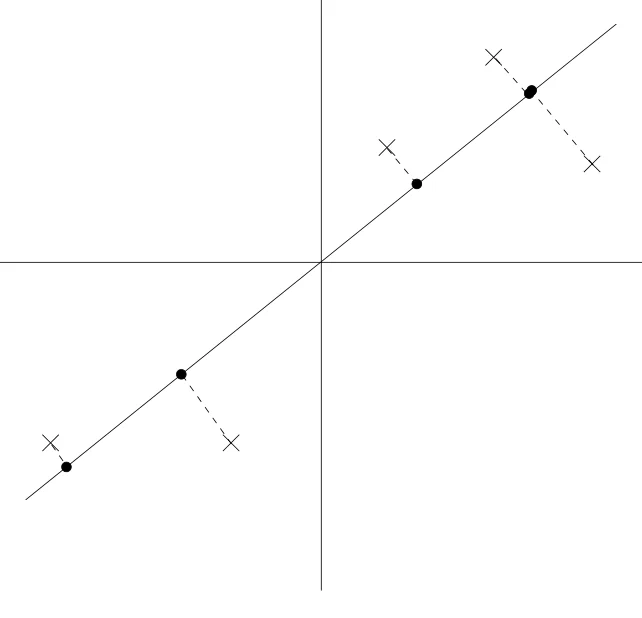 정규화된 데이터(×)를 데이터가 길게 퍼진 방향의 직선에 사영한 모습. 검은 점이 사영된 위치이며, 사영된 점들이 원점에서 멀리 퍼져 있어 분산이 크다. 출처: CS229 lecture notes.
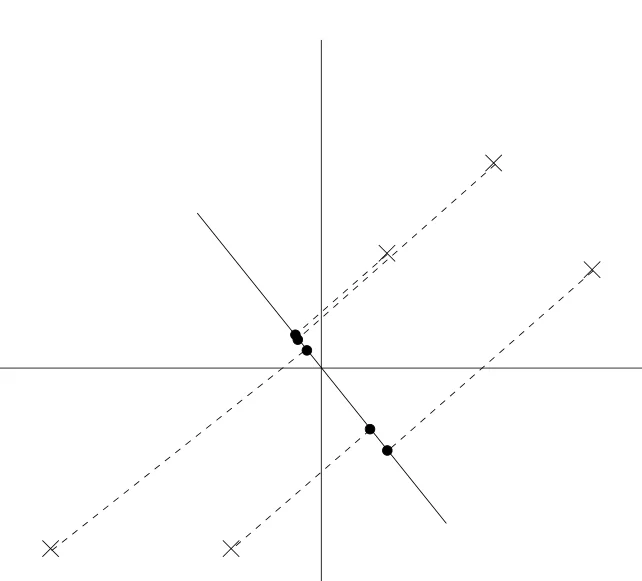 같은 데이터를 앞의 방향에 수직에 가까운 방향으로 사영한 모습. 사영된 점들이 원점 근처에 몰려 분산이 작고, 원래 데이터의 차이가 대부분 사라진다. 출처: CS229 lecture notes.
두 그림은 같은 5개의 점(평균 0, 분산 1로 정규화됨)을 서로 다른 단위벡터 \(u\) 방향의 직선에 사영한 것이다. 점선은 각 점에서 직선으로 내린 수선이고, 직선 위의 검은 점이 사영 결과다. 첫 그림에서는 직선이 데이터가 늘어선 방향과 거의 일치하므로 수선이 짧고, 사영된 점들은 원래 점들과 비슷하게 원점 양쪽으로 넓게 흩어진다. 원래 점들 사이의 차이가 사영 후에도 대부분 남아 있다는 뜻이다.
두 번째 그림에서는 직선이 데이터의 흐름을 가로지르므로 수선이 길고, 서로 멀리 떨어져 있던 점들이 원점 근처의 비슷한 위치로 모인다. 이 방향의 1차원 좌표만 보면 점들을 거의 구분할 수 없다. PCA는 첫 번째처럼 사영된 점들의 분산이 가장 큰 방향을 고르며, 아래 계산은 그 방향이 공분산 행렬의 주 고유벡터임을 보인다.
단위벡터 \(u\)에 대해 점 \(x\)의 사영 길이는 \(x^T u\)이다. 따라서 최대화할 양은 다음과 같다.
\[\frac{1}{n} \sum_{i=1}^n \left( x^{(i)T} u \right)^2 = \frac{1}{n} \sum_{i=1}^n u^T x^{(i)} x^{(i)T} u = u^T \left( \frac{1}{n} \sum_{i=1}^n x^{(i)} x^{(i)T} \right) u\]괄호 안은 (평균이 0인 데이터의) 경험 공분산 행렬 \(\Sigma\)이다. \(\lVert u \rVert_2 = 1\) 제약 아래 \(u^T \Sigma u\)를 최대화하기 위해 라그랑지안 \(\mathcal{L}(u, \lambda) = u^T \Sigma u - \lambda (u^T u - 1)\)을 세우고 미분하면 다음을 얻는다.
\[\nabla_u \mathcal{L} = 2 \Sigma u - 2 \lambda u = 0 \quad \Longrightarrow \quad \Sigma u = \lambda u\]즉 \(u\)는 \(\Sigma\)의 고유벡터이고, 그때 목적 함수 값은 \(u^T \Sigma u = \lambda u^T u = \lambda\)이다. 따라서 최적의 \(u\)는 가장 큰 고유값에 대응하는 주 고유벡터(principal eigenvector) 다.
k차원으로 확장
일반적으로 \(k\)차원 부분공간(\(k < d\))으로 사영하려면 \(\Sigma\)의 상위 \(k\)개 고유벡터 \(u_1, \dots, u_k\)를 고른다. \(\Sigma\)는 대칭이므로 이 고유벡터들은 서로 직교하게 고를 수 있고, 데이터의 새 직교 기저가 된다. 이 기저에서 \(x^{(i)}\)의 좌표는 다음과 같다.
\[y^{(i)} = \begin{bmatrix} u_1^T x^{(i)} \\ u_2^T x^{(i)} \\ \vdots \\ u_k^T x^{(i)} \end{bmatrix} \in \mathbb{R}^k\]\(x^{(i)} \in \mathbb{R}^d\)를 \(k\)차원 표현 \(y^{(i)}\)로 근사하므로 PCA를 차원 축소(dimensionality reduction) 알고리즘이라고도 한다. \(u_1, \dots, u_k\)를 데이터의 첫 \(k\)개 주성분(principal components) 이라 부른다. 고유벡터의 성질을 이용하면, 가능한 모든 직교 기저 \(u_1, \dots, u_k\) 중 이 선택이 \(\sum_i \lVert y^{(i)} \rVert_2^2\)를 최대화한다는 것도 보일 수 있다. PCA의 다른 유도와 응용은 15강에서 이어진다.
인자 분석과 PCA
두 방법 모두 데이터가 저차원 부분공간 근처에 있다고 본다. 인자 분석은 잠재 변수 \(z\)와 좌표별 잡음 \(\Psi\)를 가진 확률 모델을 세우고 EM으로 최대우도 추정을 한다. 반면 PCA는 확률 모델 없이 공분산 행렬의 고유벡터만으로 부분공간을 찾는다.
정리
- \(d \gg n\)이면 최대우도 공분산 \(\Sigma\)가 특이해져 가우시안 밀도를 계산할 수 없다. 대각 또는 \(\sigma^2 I\) 제약은 이를 피하지만 상관 구조를 잃는다.
- 가우시안을 블록으로 나누면 주변분포는 블록을 그대로 읽고, 조건부분포는 \(\mu_{1 \mid 2} = \mu_1 + \Sigma_{12} \Sigma_{22}^{-1} (x_2 - \mu_2)\), \(\Sigma_{1 \mid 2} = \Sigma_{11} - \Sigma_{12} \Sigma_{22}^{-1} \Sigma_{21}\)이다.
- 인자 분석은 \(x = \mu + \Lambda z + \epsilon\), \(z \sim \mathcal{N}(0, I)\), \(\epsilon \sim \mathcal{N}(0, \Psi)\)(대각)로 가정하며, \(x \sim \mathcal{N}(\mu, \Lambda \Lambda^T + \Psi)\)가 된다.
- E-step은 조건부 공식으로 \(z \mid x\)의 평균 \(\Lambda^T (\Lambda \Lambda^T + \Psi)^{-1} (x - \mu)\)와 공분산 \(I - \Lambda^T (\Lambda \Lambda^T + \Psi)^{-1} \Lambda\)를 구한다.
- M-step의 \(\Lambda\) 갱신은 정규 방정식과 닮았지만, \(\mathbb{E}[z z^T]\)에 사후 공분산을 포함해야 한다. \(\mu\)는 표본 평균, \(\Psi\)는 잔차 기대 공분산의 대각 성분이다.
- PCA는 정규화한 데이터의 사영 분산 \(u^T \Sigma u\)를 \(\lVert u \rVert = 1\) 아래 최대화하며, 해는 공분산 행렬의 상위 고유벡터다.
- 상위 \(k\)개 주성분으로 \(y^{(i)} = (u_1^T x^{(i)}, \dots, u_k^T x^{(i)})\)를 만들어 차원을 축소한다.