- Stanford CS229 Machine Learning (Spring 2022) 7강 정리
- 강의: Tengyu Ma, Christopher Ré
- ▶ 강의 영상
- 참고: CS229 lecture notes Ch. 5 Kernel methods, Ch. 6 Support vector machines(6.6–6.7)
피처 맵
집값 \(y\)를 넓이 \(x\)로 예측할 때, 관계가 직선이 아니라면 더 표현력이 큰 모델이 필요하다. 예를 들어 3차 함수 \(y = \theta_3 x^3 + \theta_2 x^2 + \theta_1 x + \theta_0\)를 맞추고 싶다고 하자. 다음 함수 \(\phi : \mathbb{R} \to \mathbb{R}^4\)를 정의한다.
\[\phi(x) = \begin{bmatrix} 1 \\ x \\ x^2 \\ x^3 \end{bmatrix} \in \mathbb{R}^4\]\(\theta = (\theta_0, \theta_1, \theta_2, \theta_3)\)로 두면 3차 함수는 \(\theta^T \phi(x)\)로 쓸 수 있다. 즉 \(x\)에 대한 3차 함수는 새 변수 \(\phi(x)\)에 대한 선형 함수다.
커널 방법에서는 원래 입력 \(x\)를 입력 속성(input attributes), 변환된 \(\phi(x)\)를 피처 변수(feature variables) 라 부르고, \(\phi\)를 피처 맵(feature map) 이라 한다.
피처를 쓰는 LMS
\(\phi : \mathbb{R}^d \to \mathbb{R}^p\)이고 모델이 \(\theta^T \phi(x)\)(\(\theta \in \mathbb{R}^p\))라면, 일반 최소제곱의 배치 경사하강법에서 \(x^{(i)}\)를 모두 \(\phi(x^{(i)})\)로 바꾸면 된다.
\[\theta := \theta + \alpha \sum_{i=1}^{n} \left( y^{(i)} - \theta^T \phi(x^{(i)}) \right) \phi(x^{(i)})\]확률적 경사하강법은 합 대신 한 예제 \(i\)만 쓴다.
\[\theta := \theta + \alpha \left( y^{(i)} - \theta^T \phi(x^{(i)}) \right) \phi(x^{(i)})\]커널 트릭을 쓰는 LMS
문제: 고차원 피처
\(x \in \mathbb{R}^d\)에서 차수 3 이하의 모든 단항식을 모은 피처 맵을 생각한다.
\[\phi(x) = \left( 1, x_1, x_2, \ldots, x_1^2, x_1 x_2, x_1 x_3, \ldots, x_2 x_1, \ldots, x_1^3, x_1^2 x_2, \ldots \right)^T\]중복을 허용하면 성분 수는 \(1 + d + d^2 + d^3\), 즉 \(O(d^3)\)이다. \(d = 1000\)이면 매 갱신마다 \(10^9\)차원 벡터를 계산하고 저장해야 한다. \(\theta\) 자체가 \(p \approx d^3\) 차원이므로 이 비용은 피할 수 없어 보이지만, 커널 트릭(kernel trick) 을 쓰면 \(\theta\)를 명시적으로 저장하지 않아도 된다.
θ는 항상 피처 벡터의 선형 결합이다
\(\theta = 0\)에서 시작한다고 하자. 귀납적으로 \(\theta\)는 언제나 다음 꼴로 쓸 수 있다.
\[\theta = \sum_{i=1}^{n} \beta_i \phi(x^{(i)})\]초기에는 모든 \(\beta_i = 0\)이다. 어떤 시점에 위 꼴이라면, 한 번 갱신한 뒤에도
\[\theta := \sum_{i=1}^{n} \beta_i \phi(x^{(i)}) + \alpha \sum_{i=1}^{n} \left( y^{(i)} - \theta^T \phi(x^{(i)}) \right) \phi(x^{(i)}) = \sum_{i=1}^{n} \underbrace{\left( \beta_i + \alpha \left( y^{(i)} - \theta^T \phi(x^{(i)}) \right) \right)}_{\text{new } \beta_i} \phi(x^{(i)})\]이므로 여전히 선형 결합이다. 따라서 \(p\)차원 벡터 \(\theta\)를 \(n\)개의 계수 \(\beta_1, \ldots, \beta_n\)으로 암묵적으로 표현할 수 있다. 우변의 \(\theta\)에 \(\sum_j \beta_j \phi(x^{(j)})\)를 대입하면 \(\beta\)의 갱신 규칙을 얻는다.
\[\forall i \in \{1, \ldots, n\}, \quad \beta_i := \beta_i + \alpha \left( y^{(i)} - \sum_{j=1}^{n} \beta_j \phi(x^{(j)})^T \phi(x^{(i)}) \right)\]내적은 싸게 계산된다
이제 필요한 것은 피처 벡터 사이의 내적 \(\langle \phi(x^{(j)}), \phi(x^{(i)}) \rangle\)뿐이다. 두 가지 사실이 이를 효율적으로 만든다.
- 모든 쌍 \((i, j)\)의 내적을 반복문 시작 전에 한 번 미리 계산해 둘 수 있다.
- 위 3차 피처 맵의 내적은 \(\phi\)를 직접 만들지 않고 계산할 수 있다.
\(\langle x, z \rangle\)는 \(O(d)\)에 계산되고, 나머지는 상수 번의 연산이다.
커널과 최종 알고리즘
피처 맵 \(\phi\)에 대응하는 커널(kernel) 을 다음 함수 \(K : \mathcal{X} \times \mathcal{X} \to \mathbb{R}\)로 정의한다.
\[K(x, z) \triangleq \langle \phi(x), \phi(z) \rangle\]알고리즘은 다음과 같다.
- 모든 \(i, j\)에 대해 \(K(x^{(i)}, x^{(j)})\)를 계산하고 \(\beta := 0\)으로 둔다.
- 반복한다. \(\forall i, \; \beta_i := \beta_i + \alpha \left( y^{(i)} - \sum_{j=1}^{n} \beta_j K(x^{(i)}, x^{(j)}) \right)\)
\(K_{ij} = K(x^{(i)}, x^{(j)})\)인 \(n \times n\) 행렬 \(K\)를 쓰면 벡터 꼴로 \(\beta := \beta + \alpha (\vec{y} - K\beta)\)이다. 각 \(\beta_i\)의 갱신은 \(O(n)\)이다.
예측에도 \(\theta\)가 필요 없다.
\[\theta^T \phi(x) = \sum_{i=1}^{n} \beta_i \phi(x^{(i)})^T \phi(x) = \sum_{i=1}^{n} \beta_i K(x^{(i)}, x)\]결국 피처 맵 \(\phi\)에 대해 알아야 할 모든 것은 커널 함수 \(K\)에 담겨 있다.
커널의 성질
커널을 직접 고르기
학습과 예측이 모두 커널만으로 쓰이므로, \(\phi\) 대신 \(K\)를 직접 정의하고 싶어진다. 이때 필요한 것은 \(K(x, z) = \phi(x)^T \phi(z)\)를 만족하는 \(\phi\)가 존재한다는 사실뿐이고, \(\phi\)를 명시적으로 적을 필요는 없다. 그렇다면 어떤 \(K\)가 어떤 피처 맵에 대응하는가?
예: 다항식 커널
\(x, z \in \mathbb{R}^d\)에 대해 \(K(x, z) = (x^T z)^2\)을 전개하면 다음과 같다.
\[K(x, z) = \left( \sum_{i=1}^{d} x_i z_i \right) \left( \sum_{j=1}^{d} x_j z_j \right) = \sum_{i,j=1}^{d} (x_i x_j)(z_i z_j)\]따라서 \(\phi(x)\)가 모든 쌍 \(x_i x_j\)를 나열한 \(d^2\)차원 벡터일 때 \(K(x, z) = \langle \phi(x), \phi(z) \rangle\)이다. \(\phi(x)\) 계산은 \(O(d^2)\)이지만 \(K(x, z)\)는 \(O(d)\)에 계산된다.
상수항을 더한 \(K(x, z) = (x^T z + c)^2\)은
\[(x^T z + c)^2 = \sum_{i,j=1}^{d} (x_i x_j)(z_i z_j) + \sum_{i=1}^{d} (\sqrt{2c}\, x_i)(\sqrt{2c}\, z_i) + c^2\]이므로 \(\phi(x)\)에 \(x_i x_j\)들, \(\sqrt{2c}\, x_i\)들, 그리고 \(c\)를 모은 피처 맵에 대응한다. \(c\)는 1차 항과 2차 항의 상대적 가중치를 조절한다. 더 일반적으로 \(K(x, z) = (x^T z + c)^k\)는 차수 \(k\) 이하의 모든 단항식으로 이루어진 \(\binom{d+k}{k}\)차원 피처 공간에 대응한다. 피처 공간은 \(O(d^k)\)차원이지만 커널 계산은 여전히 \(O(d)\)다.
유사도로서의 커널
직관적으로 \(\phi(x)\)와 \(\phi(z)\)가 가까우면 \(K(x, z)\)가 크고, 거의 직교하면 작다. 그래서 \(K(x, z)\)를 \(x\)와 \(z\)가 얼마나 비슷한지 재는 척도로 볼 수 있다(엄밀하지는 않은 직관이다). 이런 관점에서 다음을 생각할 수 있다.
\[K(x, z) = \exp\left( -\frac{\lVert x - z \rVert^2}{2\sigma^2} \right)\]\(x\)와 \(z\)가 가까우면 1에 가깝고, 멀면 0에 가깝다. 이 함수는 실제로 유효한 커널이며 가우시안 커널(Gaussian kernel) 이라 부른다. 대응하는 피처 맵은 무한 차원이다.
필요조건: 커널 행렬은 대칭 양의 준정부호
\(K\)가 어떤 \(\phi\)에 대응하는 유효한 커널이라고 하자. 임의의 유한한 점 집합 \(\{x^{(1)}, \ldots, x^{(n)}\}\)(학습 집합일 필요는 없다)에 대해 \(K_{ij} = K(x^{(i)}, x^{(j)})\)인 \(n \times n\) 행렬을 커널 행렬(kernel matrix) 이라 한다.
- 대칭성. \(K_{ij} = \phi(x^{(i)})^T \phi(x^{(j)}) = \phi(x^{(j)})^T \phi(x^{(i)}) = K_{ji}\)이다.
- 양의 준정부호. \(\phi_k(x)\)를 \(\phi(x)\)의 \(k\)번째 성분이라 하면, 임의의 벡터 \(z\)에 대해 다음이 성립한다.
따라서 유효한 커널의 커널 행렬은 대칭 양의 준정부호(symmetric positive semi-definite)다.
충분조건: Mercer 정리
이 조건은 필요조건일 뿐 아니라 충분조건이기도 하다.
정리 (Mercer). \(K : \mathbb{R}^d \times \mathbb{R}^d \to \mathbb{R}\)가 주어졌을 때, \(K\)가 유효한 (Mercer) 커널일 필요충분조건은 임의의 유한 점 집합 \(\{x^{(1)}, \ldots, x^{(n)}\}\)에 대해 대응하는 커널 행렬이 대칭 양의 준정부호인 것이다.
이로써 피처 맵을 찾지 않고도 함수 \(K\)가 유효한 커널인지 판정할 수 있다.
응용 예
- 손글씨 숫자 인식. 16×16 픽셀 이미지를 256차원 벡터로 넣고 다항식 커널 \((x^T z)^k\)나 가우시안 커널을 쓴 SVM이 매우 좋은 성능을 냈다. 픽셀의 인접 관계 같은 시각적 사전 지식이 전혀 없었다는 점에서 놀라운 결과다.
- 문자열. 아미노산 서열처럼 길이가 제각각인 문자열은 작은 피처 집합을 만들기 어렵다. 길이 \(k\)인 부분 문자열 각각의 등장 횟수를 센 \(\phi(x)\)는 \(26^k\)차원이라 직접 다루기 어렵다(\(26^4 \approx 460000\)). 하지만 동적 계획법 기반 문자열 매칭으로 \(K(x, z) = \phi(x)^T \phi(z)\)를 효율적으로 계산할 수 있어, 이 고차원 공간에서 암묵적으로 학습할 수 있다.
커널 트릭의 적용과 SVM
커널의 아이디어는 선형 회귀와 SVM보다 훨씬 넓게 쓰인다. 입력 벡터 사이의 내적 \(\langle x, z \rangle\)만으로 쓸 수 있는 학습 알고리즘이라면, 내적을 \(K(x, z)\)로 바꾸기만 해도 대응하는 고차원 피처 공간에서 효율적으로 동작한다. 예를 들어 퍼셉트론에 적용하면 커널 퍼셉트론(kernel perceptron)을 얻는다.
서포트 벡터 머신(support vector machine, SVM) 이 대표적인 예다. SVM의 출발점은 “마진(margin)”이라는 직관이다.
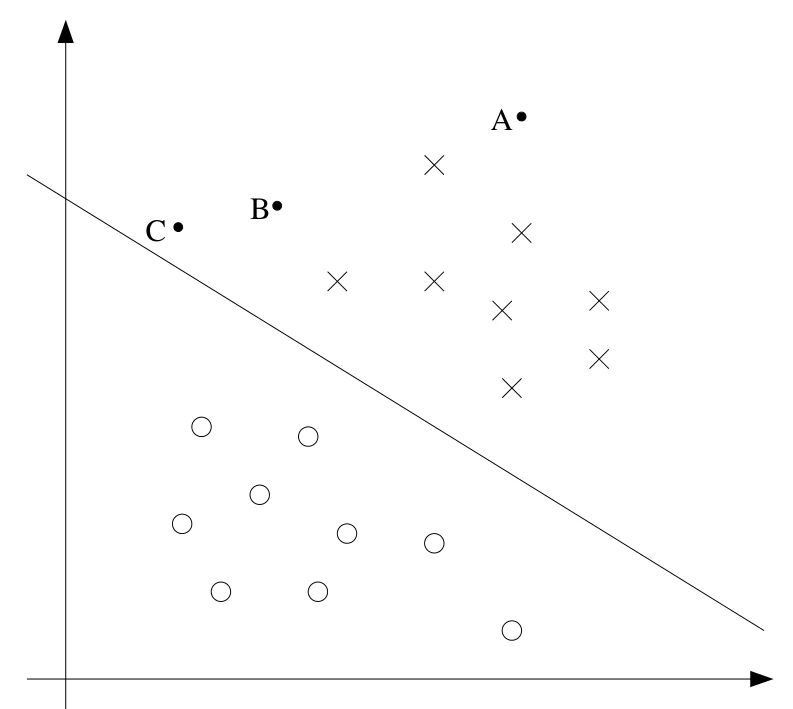 ×는 양성, ○는 음성 학습 예제이고 직선은 결정 경계 \(\theta^T x = 0\), 즉 분리 초평면(separating hyperplane)이다. 점 A는 경계에서 멀고, C는 경계에 아주 가깝다. 출처: CS229 lecture notes.
그림의 세 점은 모두 경계의 × 쪽에 있으므로 셋 다 \(y = 1\)로 예측된다. 그러나 확신의 정도는 다르다. A는 경계에서 멀리 떨어져 있어 경계가 조금 움직여도 예측이 바뀌지 않지만, C는 경계에 거의 붙어 있어 경계가 살짝만 기울어도 \(y = 0\)으로 바뀔 수 있다. B는 그 중간이다. 따라서 모든 학습 예제를 맞힐 뿐 아니라 모든 예제가 경계에서 멀리 떨어지도록 경계를 고르는 것이 바람직하다.
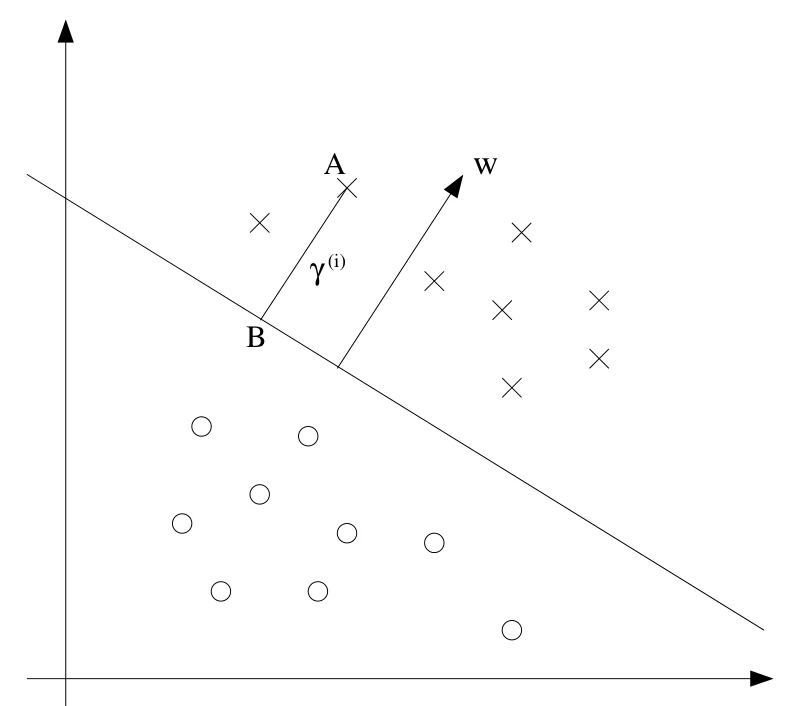 기하 마진(geometric margin)을 보여 주는 그림이다. 벡터 \(w\)는 경계 \(w^T x + b = 0\)에 수직이고, 양성 예제 A에서 경계 위의 점 B까지의 선분 길이가 A의 기하 마진 \(\gamma^{(i)}\)다. 출처: CS229 lecture notes.
이 거리를 식으로 구해 보자. \(w / \lVert w \rVert\)는 경계에 수직인 단위 벡터이므로, A의 위치 \(x^{(i)}\)에서 그 방향으로 \(\gamma^{(i)}\)만큼 거슬러 내려간 점 \(B = x^{(i)} - \gamma^{(i)} w / \lVert w \rVert\)는 경계 위에 있다. 이를 \(w^T B + b = 0\)에 대입해 풀면 \(\gamma^{(i)} = (w^T x^{(i)} + b) / \lVert w \rVert\)이고, 음성 예제까지 포함하면 \(\gamma^{(i)} = y^{(i)} \left( (w/\lVert w \rVert)^T x^{(i)} + b/\lVert w \rVert \right)\)이다. \(w\)와 \(b\)를 같은 배수로 키워도 이 값은 변하지 않는다. 최적 마진 분류기는 학습 집합에서 가장 작은 기하 마진을 최대화하는 경계를 고르며, 이는 \(\lVert w \rVert = 1\) 대신 함수 마진을 1로 고정하는 정규화를 거쳐 \(\min \frac{1}{2} \lVert w \rVert^2\) s.t. \(y^{(i)}(w^T x^{(i)} + b) \geq 1\)이라는 볼록 최적화 문제가 된다.
최적 마진 분류기(optimal margin classifier)의 라그랑주 쌍대 문제(Lagrange dual)는 다음과 같다.
\[\max_{\alpha} \; W(\alpha) = \sum_{i=1}^{n} \alpha_i - \frac{1}{2} \sum_{i,j=1}^{n} y^{(i)} y^{(j)} \alpha_i \alpha_j \langle x^{(i)}, x^{(j)} \rangle \quad \text{s.t. } \alpha_i \geq 0, \; \sum_{i=1}^{n} \alpha_i y^{(i)} = 0\]여기서 \(y \in \{-1, 1\}\)이다. 최적해에서 \(w = \sum_i \alpha_i y^{(i)} x^{(i)}\)이므로 예측도 내적만으로 쓰인다.
\[w^T x + b = \sum_{i=1}^{n} \alpha_i y^{(i)} \langle x^{(i)}, x \rangle + b\]대부분의 \(\alpha_i\)는 0이고, 0이 아닌 것은 서포트 벡터(support vector)뿐이므로 소수의 내적만 계산하면 된다. 목적함수와 예측 모두에서 \(\langle x^{(i)}, x^{(j)} \rangle\)를 \(K(x^{(i)}, x^{(j)})\)로 바꾸면 커널 SVM이 되어, 가우시안 커널처럼 무한 차원인 피처 공간에서도 학습할 수 있다.
데이터가 선형 분리 가능하지 않거나 이상치에 민감한 경우를 위해 \(\ell_1\) 정규화를 더한 소프트 마진(soft margin) 형태 \(\min \frac{1}{2}\lVert w \rVert^2 + C \sum_i \xi_i\)도 있다. 이때 쌍대 문제에서 바뀌는 것은 제약 \(\alpha_i \geq 0\)이 \(0 \leq \alpha_i \leq C\)로 바뀌는 것뿐이며, 여전히 내적만으로 표현되므로 커널을 그대로 쓸 수 있다.
정리
- 피처 맵 \(\phi\)를 쓰면 \(\theta^T \phi(x)\)는 매개변수에 대해서는 선형이면서 입력에 대해서는 비선형인 모델이 된다.
- \(\theta = 0\)에서 시작한 경사하강법에서 \(\theta\)는 항상 \(\sum_i \beta_i \phi(x^{(i)})\) 꼴이므로, \(\theta\) 대신 \(\beta \in \mathbb{R}^n\)을 \(\beta := \beta + \alpha(\vec{y} - K\beta)\)로 갱신하면 된다.
- 커널 \(K(x, z) = \langle \phi(x), \phi(z) \rangle\)는 고차원 피처를 만들지 않고 계산할 수 있다. 예: \((x^T z + c)^k\)는 \(O(d^k)\)차원 피처에 대응하지만 계산은 \(O(d)\)다.
- 가우시안 커널 \(\exp(-\lVert x - z \rVert^2 / 2\sigma^2)\)는 무한 차원 피처 맵에 대응하는 유사도 척도다.
- Mercer 정리: \(K\)가 유효한 커널일 필요충분조건은 모든 유한 점 집합의 커널 행렬이 대칭 양의 준정부호인 것이다.
- 내적만으로 쓸 수 있는 알고리즘(퍼셉트론, SVM 쌍대 문제 등)은 내적을 커널로 바꿔 고차원 피처 공간에서 효율적으로 학습할 수 있다.