- Stanford CS229 Machine Learning (Spring 2022) 20강 정리
- 강의: Tengyu Ma, Christopher Ré
- ▶ 강의 영상
- 참고: CS229 lecture notes 19장 Reinforcement learning (19.3–19.4)
연속 상태 MDP
17강에서는 상태가 유한한 MDP를 가치 반복과 정책 반복으로 풀었고, 전이 확률을 모를 때는 시행 경험의 횟수로 \(P_{sa}\)를 추정했다. 이번에는 상태가 무한히 많은 MDP를 다룬다.
예를 들어 자동차의 상태는 위치 \((x, y)\), 방향 \(\theta\), 속도 \(\dot{x}, \dot{y}\), 각속도 \(\dot{\theta}\)로 이루어진 \((x, y, \theta, \dot{x}, \dot{y}, \dot{\theta})\)이고, 상태 공간은 \(S = \mathbb{R}^6\)이다. 역진자는 \((x, \theta, \dot{x}, \dot{\theta})\), 3차원 공간을 나는 헬리콥터는 위치, 자세(롤 \(\phi\), 피치 \(\theta\), 요 \(\psi\))와 그 미분을 합친 12차원 상태를 갖는다. 이 강의에서는 \(S = \mathbb{R}^d\)인 경우를 다룬다.
이산화
방법
가장 단순한 방법은 상태 공간을 이산화(discretization) 한 뒤 가치 반복이나 정책 반복을 쓰는 것이다. 2차원 상태 \((s_1, s_2)\)라면 격자로 나누고 각 격자 칸을 하나의 이산 상태 \(\bar{s}\)로 본다. 그러면 연속 MDP를 이산 MDP \((\bar{S}, A, \{P_{\bar{s} a}\}, \gamma, R)\)로 근사하고, 이를 풀어 \(V^*(\bar{s})\)와 \(\pi^*(\bar{s})\)를 얻는다. 실제 시스템이 연속 상태 \(s\)에 있을 때는 대응하는 이산 상태 \(\bar{s}\)를 계산해 \(\pi^*(\bar{s})\)를 실행한다.
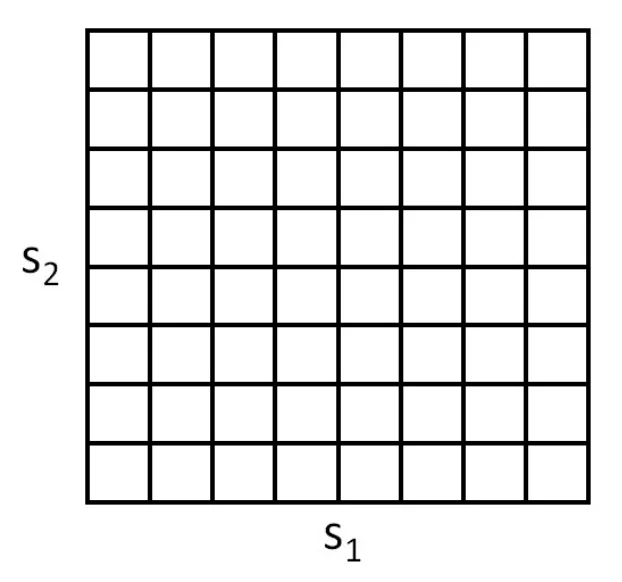 2차원 연속 상태 공간 \((s_1, s_2)\)를 \(8 \times 8\) 격자로 나눈 모습. 각 칸 하나가 이산 상태 \(\bar{s}\) 하나가 된다. 출처: CS229 lecture notes.
그림에서 가로축은 \(s_1\), 세로축은 \(s_2\)이고 상태 공간 전체가 64개의 칸으로 나뉜다. 같은 칸에 속한 연속 상태들은 모두 같은 이산 상태로 취급되므로, 칸 안의 어느 위치에 있든 같은 가치 \(V^*(\bar{s})\)와 같은 행동 \(\pi^*(\bar{s})\)를 갖는다. 이산 MDP의 전이 확률 \(P_{\bar{s} a}\)는 “칸 \(\bar{s}\)에서 행동 \(a\)를 하면 어느 칸으로 옮겨 가는가”의 확률이 된다. 아래의 두 단점은 모두 이 그림에서 출발한다. 칸 안에서 값이 상수라는 점이 첫째 단점이고, 축이 늘어날 때마다 칸 수가 곱절로 늘어난다는 점이 둘째 단점이다.
첫째 단점: 조각별 상수 표현
이산화는 많은 문제에서 잘 작동하지만 두 가지 단점이 있다. 첫째, \(V^*\)(와 \(\pi^*\))를 각 격자 칸 안에서 상수인 조각별 상수(piecewise constant) 함수로 표현한다는 점이다.
이 한계는 지도 학습 문제로 비유하면 잘 보인다. 거의 직선 위에 놓인 데이터에는 선형 회귀가 잘 맞는다. 그런데 \(x\)축을 구간으로 나누고 구간마다 상수인 함수로 맞추면 계단 모양이 된다. 조각별 상수 표현은 매끄러운 함수를 잘 표현하지 못한다. 입력에 대한 평활화가 거의 없고 서로 다른 격자 칸 사이에 일반화가 일어나지 않는다. 좋은 근사를 얻으려면 격자를 매우 촘촘하게 해야 한다.
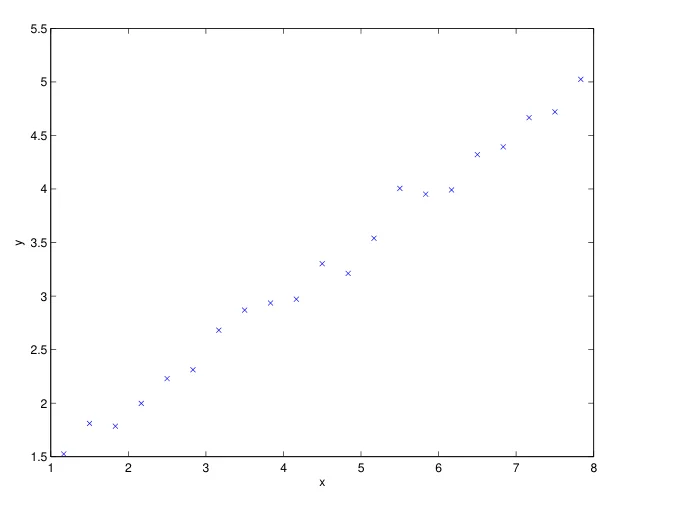 거의 직선 위에 놓인 1차원 회귀 데이터. 선형 회귀라면 이 데이터를 잘 맞춘다. 출처: CS229 lecture notes.
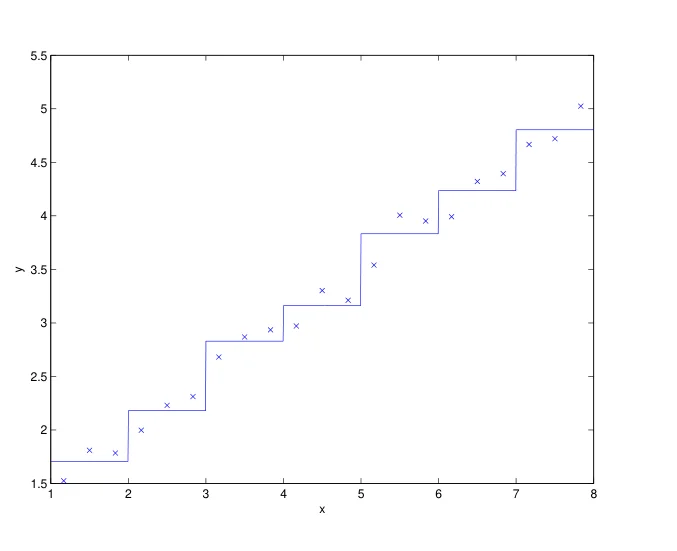 같은 데이터에서 \(x\)축을 길이 1인 구간으로 나누고 구간마다 상수로 맞춘 결과. 매끄러운 추세가 계단 모양으로 근사된다. 출처: CS229 lecture notes.
첫 그림의 점들은 \(x\)가 1에서 8로 갈 때 \(y\)가 약 1.5에서 5로 꾸준히 증가한다. 직선 하나, 즉 매개변수 두 개로 이 추세를 거의 완벽히 표현할 수 있다. 두 번째 그림은 이산화한 표현으로 같은 데이터를 맞춘 것이다. 구간 \([1, 2)\), \([2, 3)\), … 마다 그 안의 점들의 평균 높이를 하나의 값으로 쓰므로, 구간 안에서는 기울기가 0이고 경계에서 값이 갑자기 뛴다.
이 그림에서 두 가지를 읽을 수 있다. 첫째, 같은 구간 안의 왼쪽 끝과 오른쪽 끝 점은 실제로 \(y\) 값이 꽤 다른데도 같은 예측을 받는다. 둘째, 한 구간의 데이터는 이웃 구간의 예측에 전혀 영향을 주지 않는다. 데이터가 없는 구간이 있다면 그 구간의 값은 아무것도 알 수 없다. 가치 함수를 격자로 표현할 때도 똑같은 일이 일어나며, 이를 줄이려면 구간(격자 칸)을 잘게 나눠야 하는데 그만큼 필요한 상태 수와 데이터가 늘어난다.
둘째 단점: 차원의 저주
둘째 단점은 차원의 저주(curse of dimensionality) 다. \(S = \mathbb{R}^d\)의 각 차원을 \(k\)개 값으로 이산화하면 이산 상태는 \(k^d\)개다. 이는 상태 차원 \(d\)에 대해 지수적으로 늘어난다. 예를 들어 10차원 상태의 각 변수를 100개 값으로 나누면 \(100^{10} = 10^{20}\)개의 상태가 생겨 현대 컴퓨터로도 표현할 수 없다.
경험적으로 이산화는 1–2차원 문제에서 매우 잘 작동하고 구현도 간단하다. 이산화 방법을 조금 신경 써서 고르면 4차원까지는 대개 잘 되고, 아주 영리하고 운이 좋으면 6차원 문제에서도 될 수 있다. 그보다 높은 차원에서는 거의 작동하지 않는다.
가치 함수 근사
이산화 대신 \(V^*\)를 직접 근사하는 방법이 가치 함수 근사(value function approximation) 다. 여러 강화 학습 문제에 성공적으로 쓰였다.
모델 또는 시뮬레이터
가치 함수 근사 알고리즘을 위해 MDP의 모델(model) 또는 시뮬레이터(simulator) 가 있다고 가정한다. 시뮬레이터는 임의의 (연속) 상태 \(s_t\)와 행동 \(a_t\)를 받아, 전이 확률 \(P_{s_t a_t}\)에 따라 샘플링한 다음 상태 \(s_{t+1}\)을 내놓는 블랙박스다.
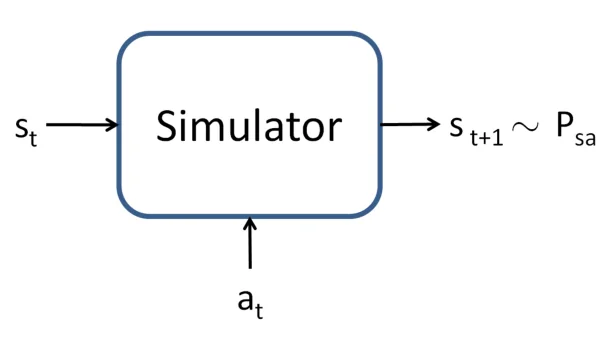 시뮬레이터의 입출력. 현재 상태 \(s_t\)와 행동 \(a_t\)를 넣으면 다음 상태 \(s_{t+1} \sim P_{s_t a_t}\)를 내놓는다. 출처: CS229 lecture notes.
그림에서 왼쪽 화살표는 현재 상태, 아래 화살표는 그 상태에서 취한 행동, 오른쪽 화살표는 출력인 다음 상태다. 출력 옆의 \(\sim P_{sa}\)는 다음 상태가 하나로 정해진 값이 아니라 전이 확률에서 뽑은 샘플일 수 있다는 뜻이다. 가치 함수 근사 알고리즘은 시뮬레이터 내부가 어떻게 생겼는지 알 필요가 없고, 이 상자에 원하는 \((s, a)\)를 넣어 다음 상태를 얻을 수만 있으면 된다. 이 점이 실제 시스템과 다르다. 실제 로봇에서는 지금 놓인 상태에서만 행동해 볼 수 있지만, 시뮬레이터에는 상태 공간의 임의의 점을 넣어 볼 수 있다. 뒤의 적합 가치 반복은 바로 이 성질을 이용해 무작위로 고른 상태들에서 시뮬레이터를 호출한다.
모델을 얻는 방법은 여러 가지다.
물리 시뮬레이션. 역진자라면 막대의 길이와 질량 같은 시스템의 매개변수를 모두 안다고 할 때, 물리 법칙으로 현재 상태와 행동에서 다음 시각의 수레와 막대의 위치와 자세를 계산할 수 있다. 시스템의 물리적 기술을 입력받아 짧은 시간 뒤의 상태를 계산해 주는 기성 물리 시뮬레이션 소프트웨어를 쓸 수도 있다.
데이터로부터 학습. MDP에서 \(n\)번의 시행을 각각 \(T\)스텝 동안 실행한다. 행동은 무작위로 고르거나, 특정 정책을 따르거나, 다른 방법으로 고를 수 있다. 그러면 다음과 같은 상태열을 관측한다.
\[s_0^{(i)} \xrightarrow{a_0^{(i)}} s_1^{(i)} \xrightarrow{a_1^{(i)}} s_2^{(i)} \xrightarrow{a_2^{(i)}} \cdots \xrightarrow{a_{T-1}^{(i)}} s_T^{(i)}, \qquad i = 1, \dots, n\]이제 학습 알고리즘으로 \(s_{t+1}\)을 \(s_t\)와 \(a_t\)의 함수로 예측한다. 예를 들어 선형 모델 \(s_{t+1} = A s_t + B a_t\)를 선형 회귀와 비슷하게 추정할 수 있다.
\[\arg\min_{A, B} \sum_{i=1}^n \sum_{t=0}^{T-1} \left\lVert s_{t+1}^{(i)} - \left( A s_t^{(i)} + B a_t^{(i)} \right) \right\rVert_2^2\]다른 손실 함수도 가능하다. 예를 들어 제곱하지 않은 \(\lVert \cdot \rVert_2\) 노름이 어떤 경우에 도움이 된다는 연구 결과(Luo et al., 2018)도 있다.
결정론적 모델과 확률적 모델
\(A\), \(B\)를 학습한 뒤에는 두 가지 선택이 있다. 결정론적 모델(deterministic model) 은 \(s_t\)와 \(a_t\)가 주어지면 \(s_{t+1} = A s_t + B a_t\)로 다음 상태를 정확히 정한다. 확률적 모델(stochastic model) 은 잡음 항을 더한다.
\[s_{t+1} = A s_t + B a_t + \epsilon_t, \qquad \epsilon_t \sim \mathcal{N}(0, \Sigma)\]공분산 \(\Sigma\)도 데이터로부터 간단히 추정할 수 있다. 다음 상태를 상태와 행동의 선형 함수로 썼지만 비선형도 가능하다. 비선형 특성 사상 \(\phi_s\), \(\phi_a\)로 \(s_{t+1} = A \phi_s(s_t) + B \phi_a(a_t)\)를 학습하거나, 국소 가중 선형 회귀(locally weighted linear regression) 같은 비선형 학습 알고리즘을 쓸 수도 있다. 이 방법들로 결정론적 시뮬레이터와 확률적 시뮬레이터를 모두 만들 수 있다.
적합 가치 반복
아이디어
이제 연속 상태 MDP의 가치 함수를 근사하는 적합 가치 반복(fitted value iteration) 을 설명한다. 상태 공간은 연속 \(S = \mathbb{R}^d\)이지만 행동 공간 \(A\)는 작고 이산적이라고 가정한다. 실제로 대부분의 MDP는 행동 공간이 상태 공간보다 훨씬 작다. 자동차는 6차원 상태에 2차원 행동(조향과 속도), 역진자는 4차원 상태에 1차원 행동, 헬리콥터는 12차원 상태에 4차원 행동을 가지므로, 행동 공간을 이산화하는 것은 상태 공간을 이산화하는 것보다 훨씬 덜 문제가 된다.
연속 상태에서 가치 반복의 갱신은 합 대신 적분으로 쓴다.
\[V(s) := R(s) + \gamma \max_a \int_{s'} P_{sa}(s') V(s') \, ds' = R(s) + \gamma \max_a \mathbb{E}_{s' \sim P_{sa}}[V(s')]\]적합 가치 반복의 핵심은 이 갱신을 유한한 표본 상태 \(s^{(1)}, \dots, s^{(n)}\)에서만 근사적으로 수행하고, 지도 학습(여기서는 선형 회귀)으로 가치 함수를 상태의 함수로 근사하는 것이다.
\[V(s) = \theta^T \phi(s)\]\(\phi\)는 상태의 적절한 특성 사상이다. 각 표본 상태에서 우변 \(R(s) + \gamma \max_a \mathbb{E}_{s' \sim P_{sa}}[V(s')]\)의 근사치 \(y^{(i)}\)를 계산한 뒤, \(V(s^{(i)})\)가 \(y^{(i)}\)에 가까워지도록 회귀한다.
알고리즘
- 상태 \(s^{(1)}, s^{(2)}, \dots, s^{(n)} \in S\)를 무작위로 샘플링한다.
- \(\theta := 0\)으로 초기화한다.
- 반복한다.
- 각 \(i = 1, \dots, n\)에 대해:
- 각 행동 \(a \in A\)에 대해 모델로 \(s'_1, \dots, s'_k \sim P_{s^{(i)} a}\)를 샘플링하고 \(q(a) = \frac{1}{k} \sum_{j=1}^k \left( R(s^{(i)}) + \gamma V(s'_j) \right)\)로 둔다. \(q(a)\)는 \(R(s^{(i)}) + \gamma \mathbb{E}_{s' \sim P_{s^{(i)} a}}[V(s')]\)의 추정치다.
- \(y^{(i)} = \max_a q(a)\)로 둔다. 이는 \(R(s^{(i)}) + \gamma \max_a \mathbb{E}_{s' \sim P_{s^{(i)} a}}[V(s')]\)의 추정치다.
- 회귀로 \(\theta\)를 갱신한다.
- 각 \(i = 1, \dots, n\)에 대해:
이산 상태의 가치 반복은 \(V(s^{(i)}) := y^{(i)}\)로 직접 갱신했다. 여기서는 \(V(s^{(i)}) \approx y^{(i)}\)가 되도록 지도 학습을 한다. 이는 학습 데이터 \((x^{(1)}, y^{(1)}), \dots, (x^{(n)}, y^{(n)})\)으로 \(x\)에서 \(y\)로의 함수를 배우는 표준 회귀 문제와 똑같고, 다른 점은 \(s\)가 \(x\)의 역할을 한다는 것뿐이다. 따라서 선형 회귀 대신 국소 가중 선형 회귀 같은 다른 회귀 알고리즘도 쓸 수 있다.
성질
이산 상태의 가치 반복과 달리 적합 가치 반복은 항상 수렴한다고 증명할 수 없다. 그러나 실제로는 (근사적으로) 수렴하는 경우가 많고 많은 문제에서 잘 작동한다.
결정론적 시뮬레이터를 쓰면 \(k = 1\)로 단순화할 수 있다. 기댓값이 결정론적 분포에 대한 것이 되어 표본 하나로 정확히 계산되기 때문이다. 확률적 시뮬레이터라면 \(k\)개를 뽑아 평균해 기댓값을 근사해야 한다.
정책 얻기
적합 가치 반복은 \(V^*\)의 근사 \(V\)를 출력하며, 이것이 정책을 암묵적으로 정한다. 상태 \(s\)에서 행동을 골라야 할 때 다음 행동을 고른다.
\[\arg\max_a \mathbb{E}_{s' \sim P_{sa}}[V(s')]\]이를 계산하는 과정은 적합 가치 반복의 내부 루프와 비슷하다. 각 행동마다 \(s'_1, \dots, s'_k \sim P_{sa}\)를 뽑아 기댓값을 근사한다(결정론적 시뮬레이터면 \(k = 1\)).
다른 근사도 흔히 쓴다. 시뮬레이터가 \(s_{t+1} = f(s_t, a_t) + \epsilon_t\) 꼴이고(\(f\)는 예를 들어 \(f(s_t, a_t) = A s_t + B a_t\) 같은 결정론적 함수), \(\epsilon_t\)가 평균 0인 가우시안 잡음이라면 다음처럼 행동을 고를 수 있다.
\[\arg\max_a V(f(s, a))\]잡음을 무시하고(\(\epsilon_t = 0\)) \(k = 1\)로 두는 셈이다. 이는 다음 근사로부터 유도된다.
\[\mathbb{E}_{s'}[V(s')] \approx V(\mathbb{E}_{s'}[s']) = V(f(s, a))\]잡음이 작다면 대개 합리적인 근사다. 이런 근사가 맞지 않는 문제에서는 행동을 하나 고를 때마다 모델로 \(k \lvert A \rvert\)개의 상태를 샘플링해야 하므로 계산 비용이 클 수 있다.
정리
- 자동차, 역진자, 헬리콥터 같은 문제는 상태가 연속(\(S = \mathbb{R}^d\))이어서 유한 MDP 알고리즘을 그대로 쓸 수 없다.
- 이산화는 격자 칸을 이산 상태로 보고 가치/정책 반복을 쓴다. 저차원(1–4차원 정도)에서는 잘 작동하지만, 조각별 상수 표현이라 일반화가 약하고 상태 수가 \(k^d\)로 늘어나는 차원의 저주가 있다.
- 가치 함수 근사는 시뮬레이터를 가정한다. 시뮬레이터는 물리 법칙으로 만들거나, 시행 데이터로 \(s_{t+1} = A s_t + B a_t (+ \epsilon_t)\) 같은 모델을 회귀로 학습해 만든다.
- 적합 가치 반복은 표본 상태마다 \(y^{(i)} = \max_a \frac{1}{k} \sum_j (R(s^{(i)}) + \gamma V(s'_j))\)를 계산하고, \(V(s) = \theta^T \phi(s)\)가 \(y^{(i)}\)에 맞도록 회귀하는 과정을 반복한다.
- 적합 가치 반복은 수렴이 보장되지 않지만 실제로는 잘 작동하는 경우가 많다. 결정론적 모델이면 \(k = 1\)로 충분하다.
- 학습된 \(V\)로부터 정책은 \(\arg\max_a \mathbb{E}_{s' \sim P_{sa}}[V(s')]\)이며, 잡음이 작으면 \(\arg\max_a V(f(s, a))\)로 근사한다.