- Stanford CS229 Machine Learning (Spring 2022) 9강 정리
- 강의: Tengyu Ma, Christopher Ré
- ▶ 강의 영상
- 참고: CS229 lecture notes Ch. 7 Deep learning(7.4 Backpropagation)
역전파란
8강에서 신경망을 정의하고 SGD로 학습한다고 했다. 남은 문제는 손실의 그래디언트 \(\nabla J(\theta)\)를 효율적으로 계산하는 것이다. 이를 해결하는 방법이 역전파(backpropagation), 또는 자동 미분(auto-differentiation) 이다.
미분 가능한 회로(differentiable circuit) 란 덧셈, 뺄셈, 곱셈, 나눗셈 같은 미분 가능한 산술 연산과 ReLU, exp, log, sin 같은 기본 미분 가능 함수를 차례로 합성한 것이다. 회로의 크기는 이런 연산의 총 개수이며, 각 연산과 그 (편)도함수는 \(O(1)\) 시간에 계산된다고 가정한다.
정리 (역전파, 비형식적). 크기 \(N\)인 미분 가능한 회로가 실수값 함수 \(f : \mathbb{R}^\ell \to \mathbb{R}\)를 계산한다면, 그래디언트 \(\nabla f\)는 크기 \(O(N)\)인 회로로 \(O(N)\) 시간에 계산할 수 있다.
예제 하나의 손실 \(J^{(j)}(\theta)\)는 덧셈, 곱셈, 비선형 활성화의 연쇄로 계산되므로, 그 그래디언트도 손실 자체를 계산하는 것과 비슷한 시간에 구할 수 있다. 이는 완전연결 신경망뿐 아니라 더 복잡한 모듈을 쓰는 신경망에도 성립한다. TensorFlow, PyTorch 같은 패키지에 이미 구현되어 있어 직접 작성할 일은 드물지만, 원리를 이해하면 딥러닝의 작동을 이해하는 데 큰 도움이 된다.
이 정리에서 따라 나오는 유용한 결과가 있다. 그래디언트의 스칼라 함수 \(s(\nabla f(x))\)도 효율적으로 미분할 수 있다. 예를 들어 \(\ell(\theta - \eta \nabla \ell(\theta))\)의 \(\theta\)에 대한 그래디언트를 구할 수 있다. 또 임의의 \(v\)에 대해 헤시안-벡터 곱 \(\nabla^2 f(x) v\)를 \(O(N + \ell)\) 시간에 계산할 수 있다. \(g(x) = \langle \nabla f(x), v \rangle\)가 \(O(N + \ell)\) 크기 회로로 계산되므로, 정리를 한 번 더 적용하면 \(\nabla g(x) = \nabla^2 f(x) v\)를 얻는다.
편미분과 연쇄 법칙
표기 규약
스칼라 \(J\)가 변수 \(z\)(스칼라, 행렬, 텐서 무엇이든)에 의존할 때, \(\frac{\partial J}{\partial z}\)는 \(z\)와 정확히 같은 모양을 갖는다. 예를 들어 \(z \in \mathbb{R}^{m \times n}\)이면 \(\frac{\partial J}{\partial z} \in \mathbb{R}^{m \times n}\)이고 \((i, j)\) 성분은 \(\frac{\partial J}{\partial z_{ij}}\)이다. 출력이 스칼라가 아닌 함수의 도함수(야코비안 등)는 표기도 까다롭고 계산과 저장도 비싸서 실제로는 거의 명시적으로 만들지 않는다. 따라서 스칼라 함수의 벡터, 행렬, 텐서에 대한 도함수만 생각하는 것이 생산적이다.
연쇄 법칙
\(z \in \mathbb{R}^m\), \(u = g(z) \in \mathbb{R}^n\), \(J = f(u) \in \mathbb{R}\)이라 하자. 연쇄 법칙(chain rule)은 다음과 같다.
\[\frac{\partial J}{\partial z_i} = \sum_{j=1}^{n} \frac{\partial J}{\partial u_j} \cdot \frac{\partial g_j}{\partial z_i}, \qquad i = 1, \ldots, m\]벡터로 쓰면 다음과 같다. 우변의 행렬은 \(g\)의 야코비안의 전치다.
\[\frac{\partial J}{\partial z} = \begin{bmatrix} \frac{\partial g_1}{\partial z_1} & \cdots & \frac{\partial g_n}{\partial z_1} \\ \vdots & \ddots & \vdots \\ \frac{\partial g_1}{\partial z_m} & \cdots & \frac{\partial g_n}{\partial z_m} \end{bmatrix} \frac{\partial J}{\partial u}\]\(z\)가 행렬이면 성분 꼴이 더 편하다. \(z \in \mathbb{R}^{r \times s}\)이면 \(\frac{\partial J}{\partial z_{ik}} = \sum_j \frac{\partial J}{\partial u_j} \frac{\partial g_j}{\partial z_{ik}}\)이다.
핵심 해석: 역방향 함수
이 공식은 \(\frac{\partial J}{\partial u}\)로부터 \(\frac{\partial J}{\partial z}\)를 계산하는 방법이다. 중요한 점은 \(f\)에 대한 정보가 전혀 필요 없고 \(g\)와 \(z\)만 알면 된다는 것이다. \(f\)가 아무리 복잡해도 \(\frac{\partial J}{\partial u}\)만 주어지면 된다.
이 사상을 역방향 함수(backward function) \(\mathcal{B}[g, z]\)로 정의한다.
\[\frac{\partial J}{\partial z} = \mathcal{B}[g, z]\left( \frac{\partial J}{\partial u} \right), \qquad \left( \mathcal{B}[g, z](v) \right)_i = \sum_{j=1}^{n} \frac{\partial g_j}{\partial z_i} v_j\]\(z\)가 고정되면 \(\mathcal{B}[g, z]\)는 \(\mathbb{R}^n \to \mathbb{R}^m\)인 선형 사상이다. 하지만 실제로는 \(z\)가 계속 바뀌므로, 역방향 함수는 \(z\)(= \(g\)의 입력)와 \(v\)(= \(g\)의 출력에 대한 어떤 \(J\)의 그래디언트)를 받아 \(J\)의 \(z\)에 대한 그래디언트를 내놓는 함수로 본다.
역전파의 일반 전략
신경망과 손실을 작은 모듈의 합성으로 본다. 손실(제곱 손실, 교차 엔트로피 등)도 하나의 모듈이다.
\[J = M_k(M_{k-1}(\cdots M_1(x)))\]예를 들어 MLP 이진 분류에서는 \(M_1 = \text{MM}_{W^{[1]}, b^{[1]}}\), \(M_2 = \sigma\), \(M_3 = \text{MM}_{W^{[2]}, b^{[2]}}\), \(\ldots\), \(M_{k-1} = \text{MM}_{W^{[r]}, b^{[r]}}\), \(M_k = \ell_{\text{logistic}}\)이다. 레이블 \(y\)는 미분에서 상수이므로 \(M_k\)에 포함된 것으로 본다. 각 모듈 \(M_i\)는 매개변수 \(\theta^{[i]}\)를 가질 수 있다(활성화처럼 비어 있을 수도 있다). 중간 변수를 다음과 같이 둔다.
\[u^{[0]} = x, \quad u^{[1]} = M_1(u^{[0]}), \quad \ldots, \quad J = u^{[k]} = M_k(u^{[k-1]})\]역전파는 두 단계다.
순방향 패스(forward pass). \(u^{[1]}, \ldots, u^{[k]}\)를 차례로 계산하고 모든 중간 변수를 메모리에 저장한다.
역방향 패스(backward pass). 중간 변수에 대한 도함수 \(\frac{\partial J}{\partial u^{[k]}}, \ldots, \frac{\partial J}{\partial u^{[1]}}\)를 역순으로 계산하고, 이로부터 매개변수에 대한 도함수를 계산한다. 앞 절의 연쇄 법칙에서 \(u = u^{[i]}\), \(z = u^{[i-1]}\), \(g = M_i\), \(f = M_k \circ \cdots \circ M_{i+1}\)로 두면 다음을 얻는다.
\[\frac{\partial J}{\partial u^{[i-1]}} = \mathcal{B}[M_i, u^{[i-1]}]\left( \frac{\partial J}{\partial u^{[i]}} \right) \tag{B1}\] \[\frac{\partial J}{\partial \theta^{[i]}} = \mathcal{B}[M_i, \theta^{[i]}]\left( \frac{\partial J}{\partial u^{[i]}} \right) \tag{B2}\](B2)는 \(\frac{\partial J}{\partial u^{[i]}}\)와 \(u^{[i-1]}\)에만 의존하므로 (B1)의 계산과 섞어서 진행해도 된다. 시작점은 \(\frac{\partial J}{\partial J} = 1\)이다.
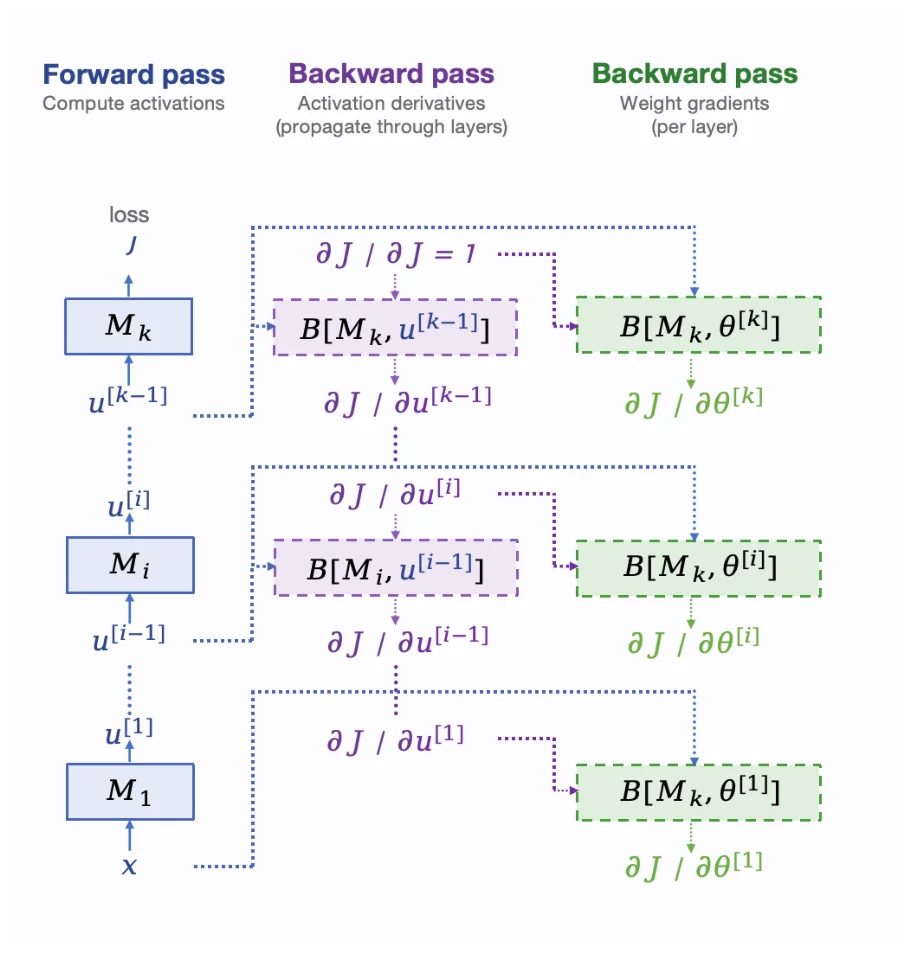 모듈 \(M_1, \ldots, M_k\)의 합성에서 순방향 패스(왼쪽, 파랑), 활성화에 대한 역방향 패스(가운데, 보라), 매개변수 그래디언트 계산(오른쪽, 초록)을 나란히 그린 그림이다. 출처: CS229 lecture notes.
왼쪽 열은 순방향 패스다. 입력 \(x = u^{[0]}\)이 \(M_1\)을 지나 \(u^{[1]}\)이 되고, 같은 방식으로 \(u^{[i-1]}\)이 \(M_i\)를 지나 \(u^{[i]}\)가 되며, 마지막 \(M_k\)의 출력이 손실 \(J\)다. 각 \(u^{[i-1]}\)에서 오른쪽으로 뻗은 점선은 이 값이 메모리에 저장되었다가 역방향 패스에서 다시 쓰인다는 뜻이다.
가운데 열은 위에서 아래로 읽는다. 맨 위의 \(\partial J / \partial J = 1\)에서 출발해 보라색 상자 \(\mathcal{B}[M_k, u^{[k-1]}]\)을 적용하면 \(\partial J / \partial u^{[k-1]}\)이 나오고, 이를 다시 \(\mathcal{B}[M_{k-1}, u^{[k-2]}]\)에 넣는 식으로 한 층씩 내려가며 \(\partial J / \partial u^{[1]}\)까지 구한다. 이것이 식 (B1)의 반복이다. 각 보라색 상자는 위에서 내려온 도함수와 왼쪽 열에서 저장해 둔 \(u^{[i-1]}\)만 있으면 계산된다.
오른쪽 열은 식 (B2)다. 가운데 열에서 \(\partial J / \partial u^{[i]}\)가 구해지는 즉시 오른쪽으로 화살표가 뻗어 초록색 상자 \(\mathcal{B}[M_i, \theta^{[i]}]\)에 들어가고, 이 상자가 그 층의 매개변수 그래디언트 \(\partial J / \partial \theta^{[i]}\)를 낸다(그림의 초록색 상자에는 모두 \(M_k\)로 적혀 있지만 \(i\)번째 줄의 상자는 \(M_i\)의 역방향 함수다). 초록색 상자의 출력은 다른 층의 계산에 다시 쓰이지 않으므로, 매개변수 그래디언트는 층마다 독립적으로 구할 수 있다.
복잡한 신경망을 작은 모듈로 나누는 이유는 작은 모듈일수록 역방향 함수를 효율적으로 구현할 수 있기 때문이다. 덧셈, 곱셈, ReLU 같은 원자적 연산의 역방향 함수는 순방향 계산과 같은 차수의 비용이 들며, 이 사실로 역전파 정리를 증명할 수 있다. 실제로는 행렬 곱, 층 정규화 수준의 모듈로 나누는 편이 편리하고, 이들의 역방향 함수도 순방향과 같은 차수의 시간에 계산된다.
기본 모듈의 역방향 함수
행렬 곱
\(\text{MM}_{W,b}(z) = Wz + b\), \(z \in \mathbb{R}^m\), \(W \in \mathbb{R}^{n \times m}\)이라 하자. \(\frac{\partial (Wz + b)_j}{\partial z_i} = W_{ji}\)이므로 입력에 대한 역방향 함수는 다음과 같다.
\[\mathcal{B}[\text{MM}, z](v) = W^T v \in \mathbb{R}^m\]\(W\)에 대해서는 벡터 꼴로 쓰면 4차 텐서가 필요하므로 성분 꼴을 쓴다.
\[\left( \mathcal{B}[\text{MM}, W](v) \right)_{ij} = \sum_{k} \frac{\partial (Wz + b)_k}{\partial W_{ij}} v_k = v_i z_j \quad \Longrightarrow \quad \mathcal{B}[\text{MM}, W](v) = v z^T \in \mathbb{R}^{n \times m}\]\(b\)에 대해서는 \(\frac{\partial (Wz+b)_j}{\partial b_i}\)가 \(i = j\)일 때만 1이므로 \(\mathcal{B}[\text{MM}, b](v) = v\)이다. 계산 비용은 모두 \(O(mn)\)으로, 행렬 곱을 계산하는 비용과 같은 차수다.
활성화 함수
\(M(z) = \sigma(z)\)가 성분별 활성화이면 \(j \neq i\)일 때 \(\frac{\partial \sigma(z_j)}{\partial z_i} = 0\)이므로 다음과 같다.
\[\mathcal{B}[\sigma, z](v) = \text{diag}(\sigma'(z_1), \ldots, \sigma'(z_m))\, v = \sigma'(z) \odot v \in \mathbb{R}^m\]\(\odot\)은 성분별 곱이다. 행렬 꼴만 보면 \(O(m^2)\)처럼 보이지만 실제로는 \(O(m)\), 즉 순방향과 같은 시간이다. 벡터 활성화를 스칼라 활성화 \(m\)개로 보면 당연한 결과다.
손실 함수
벡터 \(z\)를 받아 스칼라를 내는 모듈의 역방향 함수는 스칼라 \(v\)를 받아 \(\mathcal{B}[M, z](v) = \frac{\partial M}{\partial z} \cdot v\)를 낸다.
| 손실 | 역방향 함수 |
|---|---|
| 제곱 손실 \(\ell_{\text{MSE}}(z, y) = \frac{1}{2}(z - y)^2\) | \((z - y) \cdot v\) |
| 로지스틱 손실 \(\ell_{\text{logistic}}(t, y)\) | \(\left( \frac{1}{1 + \exp(-t)} - y \right) \cdot v\) |
| 교차 엔트로피 \(\ell_{\text{ce}}(t, y)\) | \((\text{softmax}(t) - e_y) \cdot v\) |
\(e_y\)는 \(y\)번째 성분만 1인 원-핫 벡터다. 로지스틱 손실과 교차 엔트로피의 도함수는 3강과 4강에서 유도한 것과 같다.
MLP의 역전파
로지스틱 손실을 쓰는 \(r\)층 MLP를 생각한다. 순방향 패스는 다음과 같다.
\[\begin{aligned} z^{[1]} &= \text{MM}_{W^{[1]}, b^{[1]}}(x), & a^{[1]} &= \sigma(z^{[1]}) \\ z^{[2]} &= \text{MM}_{W^{[2]}, b^{[2]}}(a^{[1]}), & a^{[2]} &= \sigma(z^{[2]}) \\ &\;\;\vdots \\ z^{[r]} &= \text{MM}_{W^{[r]}, b^{[r]}}(a^{[r-1]}), & J &= \ell_{\text{logistic}}(z^{[r]}, y) \end{aligned}\]역방향으로는 \(\frac{\partial J}{\partial z^{[r]}} = \mathcal{B}[\ell_{\text{logistic}}, z^{[r]}](1)\)에서 시작해 MM과 \(\sigma\)의 역방향 함수를 번갈아 적용한다.
\[\frac{\partial J}{\partial a^{[r-1]}} = \mathcal{B}[\text{MM}, a^{[r-1]}]\left( \frac{\partial J}{\partial z^{[r]}} \right), \quad \frac{\partial J}{\partial z^{[r-1]}} = \mathcal{B}[\sigma, z^{[r-1]}]\left( \frac{\partial J}{\partial a^{[r-1]}} \right), \quad \ldots\]이 계산에 순방향의 \(a^{[i]}\)와 \(z^{[i]}\)가 쓰이므로 순방향 패스 후 메모리에 저장해 두어야 한다. 매개변수의 그래디언트는 \(\frac{\partial J}{\partial z^{[i]}}\)가 구해지는 즉시 MM의 역방향 함수로 계산할 수 있다. 정리하면 다음 알고리즘이 된다.
알고리즘 (다층 신경망의 역전파)
- 순방향 패스. 모든 \(z^{[k]}\), \(a^{[k]}\), \(J\)를 계산해 저장한다.
-
역방향 패스. 출력층의 그래디언트를 계산한다.
\[\frac{\partial J}{\partial z^{[r]}} = \frac{1}{1 + \exp(-z^{[r]})} - y\] - \(k = r-1\)부터 \(0\)까지 반복한다(\(a^{[0]} = x\)).
-
매개변수의 그래디언트:
\[\frac{\partial J}{\partial W^{[k+1]}} = \frac{\partial J}{\partial z^{[k+1]}} a^{[k]T}, \qquad \frac{\partial J}{\partial b^{[k+1]}} = \frac{\partial J}{\partial z^{[k+1]}}\] -
\(k \geq 1\)이면 은닉층의 그래디언트:
\[\frac{\partial J}{\partial a^{[k]}} = W^{[k+1]T} \frac{\partial J}{\partial z^{[k+1]}}, \qquad \frac{\partial J}{\partial z^{[k]}} = \sigma'(z^{[k]}) \odot \frac{\partial J}{\partial a^{[k]}}\]
-
각 층에서 하는 일은 행렬-벡터 곱과 성분별 곱뿐이므로, 역방향 패스 전체의 비용은 순방향 패스와 같은 차수다.
정리
- 역전파 정리: 크기 \(N\)인 미분 가능한 회로로 계산되는 스칼라 함수의 그래디언트는 \(O(N)\) 시간에 계산된다. 헤시안-벡터 곱도 같은 차수로 계산할 수 있다.
- \(\frac{\partial J}{\partial z}\)는 \(z\)와 같은 모양이며, 스칼라 함수의 도함수만 다룬다.
- 연쇄 법칙은 역방향 함수 \(\mathcal{B}[g, z]\)로 모듈화된다. \(\frac{\partial J}{\partial u}\)에서 \(\frac{\partial J}{\partial z}\)를 구하는 데 \(g\)와 \(z\)만 필요하다.
- 순방향 패스에서 중간 값을 저장하고, 역방향 패스에서 (B1)로 중간 변수, (B2)로 매개변수의 그래디언트를 구한다.
- 행렬 곱: \(\mathcal{B}[\text{MM}, z](v) = W^T v\), \(\mathcal{B}[\text{MM}, W](v) = v z^T\), \(\mathcal{B}[\text{MM}, b](v) = v\). 활성화: \(\sigma'(z) \odot v\).
- 손실의 역방향 함수는 각각 \(z - y\), \(\text{sigmoid}(t) - y\), \(\text{softmax}(t) - e_y\)이다.
- MLP의 역전파는 출력층에서 시작해 \(W^T\) 곱과 \(\sigma'\) 곱을 번갈아 적용하며, 비용은 순방향과 같은 차수다.