- Stanford CS229 Machine Learning (Spring 2022) 6강 정리
- 강의: Tengyu Ma, Christopher Ré
- ▶ 강의 영상
- 참고: CS229 lecture notes Chapter 4.2 (Naive Bayes, 4.2.1 Laplace smoothing, 4.2.2 Event models for text classification)
나이브 베이즈 복습
5강에서 이메일을 이진 특성 벡터 \(x \in \{0, 1\}^d\)로 표현했다. \(x_j = 1\)이면 어휘의 \(j\)번째 단어가 이메일에 등장한다는 뜻이다. 나이브 베이즈 가정은 \(y\)가 주어지면 \(x_j\)들이 조건부 독립이라는 것이고, 이로부터 \(p(x \mid y) = \prod_{j=1}^{d} p(x_j \mid y)\)를 얻는다.
매개변수 \(\phi_{j \mid y=1} = p(x_j = 1 \mid y = 1)\), \(\phi_{j \mid y=0} = p(x_j = 1 \mid y = 0)\), \(\phi_y = p(y = 1)\)의 최대우도 추정값은 개수의 비율이다.
\[\phi_{j \mid y=1} = \frac{\sum_{i=1}^{n} 1\{x_j^{(i)} = 1 \wedge y^{(i)} = 1\}}{\sum_{i=1}^{n} 1\{y^{(i)} = 1\}}, \qquad \phi_{j \mid y=0} = \frac{\sum_{i=1}^{n} 1\{x_j^{(i)} = 1 \wedge y^{(i)} = 0\}}{\sum_{i=1}^{n} 1\{y^{(i)} = 0\}}, \qquad \phi_y = \frac{1}{n} \sum_{i=1}^{n} 1\{y^{(i)} = 1\}\]예측은 베이즈 규칙으로 한다.
\[p(y = 1 \mid x) = \frac{\prod_{j=1}^{d} p(x_j \mid y = 1) \, p(y = 1)}{\prod_{j=1}^{d} p(x_j \mid y = 1) \, p(y = 1) + \prod_{j=1}^{d} p(x_j \mid y = 0) \, p(y = 0)}\]라플라스 스무딩
확률 0 문제
이 형태의 나이브 베이즈는 많은 문제에서 꽤 잘 작동하지만, 간단한 수정 하나로 특히 텍스트 분류에서 훨씬 좋아진다. 먼저 문제를 보자.
CS229를 마치고 프로젝트 결과를 머신러닝 학회 NeurIPS에 투고하기로 했다고 하자. 그러면 이메일에서 학회 이야기를 하게 되고, “neurips”라는 단어가 든 메일을 받기 시작한다. 하지만 첫 NeurIPS 논문이라 그전까지는 이 단어가 든 메일을 본 적이 없고, 스팸과 스팸 아닌 메일로 이루어진 학습 집합에도 “neurips”가 한 번도 나오지 않았다. “neurips”가 사전의 35000번째 단어라면, 최대우도 추정값은 다음과 같다.
\[\phi_{35000 \mid y=1} = \frac{\sum_{i=1}^{n} 1\{x_{35000}^{(i)} = 1 \wedge y^{(i)} = 1\}}{\sum_{i=1}^{n} 1\{y^{(i)} = 1\}} = 0, \qquad \phi_{35000 \mid y=0} = \frac{\sum_{i=1}^{n} 1\{x_{35000}^{(i)} = 1 \wedge y^{(i)} = 0\}}{\sum_{i=1}^{n} 1\{y^{(i)} = 0\}} = 0\]스팸에서도, 스팸 아닌 메일에서도 본 적이 없으므로 어느 쪽에서든 이 단어가 나올 확률을 0으로 생각한다. 그러면 “neurips”가 든 메일의 사후 확률을 계산할 때 분자와 분모의 곱 \(\prod_{j} p(x_j \mid y)\)에 모두 \(p(x_{35000} \mid y) = 0\)이 곱해진다.
\[p(y = 1 \mid x) = \frac{\prod_{j=1}^{d} p(x_j \mid y = 1) \, p(y = 1)}{\prod_{j=1}^{d} p(x_j \mid y = 1) \, p(y = 1) + \prod_{j=1}^{d} p(x_j \mid y = 0) \, p(y = 0)} = \frac{0}{0}\]알고리즘은 \(0/0\)을 얻고 예측을 할 수 없다.
스무딩된 추정량
더 넓게 말하면, 유한한 학습 집합에서 본 적이 없다는 이유만으로 어떤 사건의 확률을 0으로 추정하는 것은 통계적으로 나쁜 생각이다. \(\{1, \dots, k\}\) 값을 갖는 다항 확률 변수 \(z\)의 평균을 추정하는 문제를 생각한다. \(\phi_j = p(z = j)\)로 매개변수화하고, 독립 관측 \(\{z^{(1)}, \dots, z^{(n)}\}\)이 주어지면 최대우도 추정값은 다음과 같다.
\[\phi_j = \frac{\sum_{i=1}^{n} 1\{z^{(i)} = j\}}{n}\]이 추정값으로는 일부 \(\phi_j\)가 0이 될 수 있다. 라플라스 스무딩(Laplace smoothing) 은 이를 다음으로 바꾼다.
\[\phi_j = \frac{1 + \sum_{i=1}^{n} 1\{z^{(i)} = j\}}{k + n}\]분자에 1을, 분모에 \(k\)를 더했다. 각 값을 한 번씩 “미리 관측했다”고 치는 셈이다. 이렇게 해도 확률의 합은 여전히 1이다.
\[\sum_{j=1}^{k} \phi_j = \frac{k + \sum_{j=1}^{k} \sum_{i=1}^{n} 1\{z^{(i)} = j\}}{k + n} = \frac{k + n}{k + n} = 1\]그리고 모든 \(j\)에 대해 \(\phi_j \neq 0\)이므로 확률이 0으로 추정되는 문제가 사라진다. (꽤 강한) 특정 조건 아래에서는 라플라스 스무딩이 \(\phi_j\)의 최적 추정량이라는 것도 보일 수 있다.
나이브 베이즈에 적용
나이브 베이즈의 \(x_j\)는 이진값이므로 \(k = 2\)다. 라플라스 스무딩을 적용한 추정값은 다음과 같다.
\[\phi_{j \mid y=1} = \frac{1 + \sum_{i=1}^{n} 1\{x_j^{(i)} = 1 \wedge y^{(i)} = 1\}}{2 + \sum_{i=1}^{n} 1\{y^{(i)} = 1\}}, \qquad \phi_{j \mid y=0} = \frac{1 + \sum_{i=1}^{n} 1\{x_j^{(i)} = 1 \wedge y^{(i)} = 0\}}{2 + \sum_{i=1}^{n} 1\{y^{(i)} = 0\}}\]\(\phi_y\)에 스무딩을 적용할지는 실제로 크게 중요하지 않다. 보통 스팸과 스팸 아닌 메일이 둘 다 적당한 비율로 있으므로 \(\phi_y\)는 0에서 충분히 멀리 떨어진 합리적인 추정값이 된다.
텍스트 분류의 사건 모델
생성 학습 알고리즘을 마무리하며, 텍스트 분류에 특화된 모델 하나를 더 본다. 지금까지의 나이브 베이즈도 많은 분류 문제에서 잘 작동하지만, 텍스트 분류에서는 이와 관련된 모델이 더 좋다.
베르누이 사건 모델
지금까지의 나이브 베이즈는 베르누이 사건 모델(Bernoulli event model), 또는 다변량 베르누이 사건 모델을 쓴 것이다. 이 모델에서 이메일은 다음과 같이 생성된다고 가정한다.
- 클래스 사전 확률 \(p(y)\)에 따라 다음 메일을 스팸 발송자가 보낼지 일반 발송자가 보낼지 무작위로 정한다.
- 발송자는 사전을 처음부터 끝까지 훑으며, 각 단어 \(j\)를 메일에 넣을지 확률 \(p(x_j = 1 \mid y) = \phi_{j \mid y}\)에 따라 독립적으로 결정한다.
따라서 메일의 확률은 \(p(y) \prod_{j=1}^{d} p(x_j \mid y)\)다. 이 모델은 단어가 등장했는지 여부만 보며, 몇 번 등장했는지는 보지 않는다.
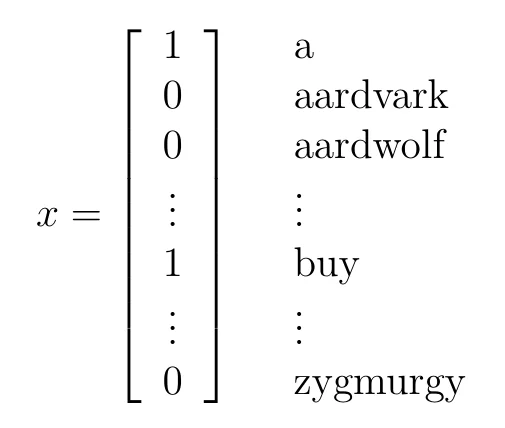 베르누이 사건 모델에서 이메일 하나를 나타내는 특성 벡터다. 각 성분은 사전의 단어 하나(오른쪽)에 대응하고, 그 단어가 메일에 있으면 1, 없으면 0이다. 출처: CS229 lecture notes.
그림의 벡터는 “a”와 “buy”를 포함하고 “aardvark”, “aardwolf”, “zygmurgy”는 포함하지 않는 이메일이다. 벡터의 길이는 메일의 길이와 상관없이 항상 어휘 크기 \(\lvert V \rvert\)로 고정되고, 대부분의 성분은 0이다. 메일에 “buy”가 한 번 나오든 열 번 나오든 해당 성분은 똑같이 1이며, 단어의 순서도 사라진다. 위의 생성 과정에서 발송자가 사전을 훑으며 단어마다 동전을 던진다는 설명은 바로 이 벡터의 성분을 하나씩 정하는 과정이다.
다음의 다항 사건 모델은 이 표현을 바꾼다. 사전 크기의 0/1 벡터 대신 메일에 실제로 등장한 단어를 순서대로 나열하므로, 벡터의 길이가 메일의 길이가 되고 같은 단어가 여러 번 나오면 그 횟수가 모델에 반영된다.
다항 사건 모델
다항 사건 모델(multinomial event model) 은 다른 표기와 특성을 쓴다. \(x_j\)를 이메일의 \(j\)번째 단어의 정체(identity) 로 둔다. 즉 \(x_j \in \{1, \dots, \lvert V \rvert\}\)이고, \(\lvert V \rvert\)는 어휘(사전)의 크기다. 단어가 \(d\)개인 이메일은 길이 \(d\)인 벡터 \((x_1, x_2, \dots, x_d)\)로 표현되며, \(d\)는 문서마다 다를 수 있다. 예를 들어 이메일이 “A NeurIPS …“로 시작하면 \(x_1 = 1\)(“a”가 사전의 첫 단어), \(x_2 = 35000\)이다.
이 모델에서 이메일은 다음과 같이 생성된다고 가정한다.
- 앞과 같이 \(p(y)\)에 따라 스팸 여부를 정한다.
- 발송자는 첫 단어 \(x_1\)을 단어 위의 다항 분포 \(p(x_1 \mid y)\)에서 뽑는다.
- 둘째 단어 \(x_2\)는 \(x_1\)과 독립으로 같은 다항 분포에서 뽑고, \(x_3, x_4, \dots\)도 마찬가지로 \(d\)개 단어를 모두 뽑을 때까지 반복한다.
전체 메일의 확률은 역시 \(p(y) \prod_{j=1}^{d} p(x_j \mid y)\)다. 식은 베르누이 사건 모델과 같아 보이지만 각 항의 의미가 완전히 다르다. 특히 \(x_j \mid y\)는 이제 베르누이가 아니라 다항 분포다.
| 베르누이 사건 모델 | 다항 사건 모델 | |
|---|---|---|
| \(x_j\)의 의미 | 사전의 \(j\)번째 단어가 등장했는가 | 메일의 \(j\)번째 단어가 무엇인가 |
| \(x_j\)의 값 | \(\{0, 1\}\) | \(\{1, \dots, \lvert V \rvert\}\) |
| \(x\)의 길이 | 어휘 크기로 고정 | 메일 길이, 문서마다 다르다 |
| \(p(x_j \mid y)\) | 베르누이 | 다항 분포 (모든 위치에서 공유) |
| 단어 반복 | 반영하지 않는다 | 등장 횟수가 확률에 반영된다 |
매개변수와 최대우도 추정
매개변수는 \(\phi_y = p(y)\)와, 임의의 위치 \(j\)에 대해 \(\phi_{k \mid y=1} = p(x_j = k \mid y = 1)\), \(\phi_{k \mid y=0} = p(x_j = k \mid y = 0)\)이다. 단어를 생성하는 분포가 메일 안의 위치 \(j\)에 의존하지 않는다고 가정한 것이다.
학습 집합 \(\{(x^{(i)}, y^{(i)}); i = 1, \dots, n\}\)에서 \(x^{(i)} = (x_1^{(i)}, \dots, x_{d_i}^{(i)})\)이고 \(d_i\)는 \(i\)번째 메일의 단어 수다. 우도는 다음과 같다.
\[L(\phi_y, \phi_{k \mid y=0}, \phi_{k \mid y=1}) = \prod_{i=1}^{n} p(x^{(i)}, y^{(i)}) = \prod_{i=1}^{n} \left( \prod_{j=1}^{d_i} p(x_j^{(i)} \mid y; \phi_{k \mid y=0}, \phi_{k \mid y=1}) \right) p(y^{(i)}; \phi_y)\]이를 최대화하면 다음 추정값을 얻는다.
\[\phi_{k \mid y=1} = \frac{\sum_{i=1}^{n} \sum_{j=1}^{d_i} 1\{x_j^{(i)} = k \wedge y^{(i)} = 1\}}{\sum_{i=1}^{n} 1\{y^{(i)} = 1\} d_i}, \qquad \phi_{k \mid y=0} = \frac{\sum_{i=1}^{n} \sum_{j=1}^{d_i} 1\{x_j^{(i)} = k \wedge y^{(i)} = 0\}}{\sum_{i=1}^{n} 1\{y^{(i)} = 0\} d_i}, \qquad \phi_y = \frac{\sum_{i=1}^{n} 1\{y^{(i)} = 1\}}{n}\]\(\phi_{k \mid y=1}\)은 스팸 메일 전체에 나온 단어 중 단어 \(k\)가 차지하는 비율이다. 분모는 스팸 메일들의 총 단어 수다.
라플라스 스무딩 적용
실제로 좋은 성능을 내려면 스무딩이 필요하다. \(\phi_{k \mid y}\)는 \(\lvert V \rvert\)개 값 위의 다항 분포이므로, 분자에 1을, 분모에 \(\lvert V \rvert\)를 더한다.
\[\phi_{k \mid y=1} = \frac{1 + \sum_{i=1}^{n} \sum_{j=1}^{d_i} 1\{x_j^{(i)} = k \wedge y^{(i)} = 1\}}{\lvert V \rvert + \sum_{i=1}^{n} 1\{y^{(i)} = 1\} d_i}, \qquad \phi_{k \mid y=0} = \frac{1 + \sum_{i=1}^{n} \sum_{j=1}^{d_i} 1\{x_j^{(i)} = k \wedge y^{(i)} = 0\}}{\lvert V \rvert + \sum_{i=1}^{n} 1\{y^{(i)} = 0\} d_i}\]나이브 베이즈 분류기가 최고의 분류 알고리즘은 아닐 수 있지만, 놀라울 만큼 잘 작동하는 경우가 많다. 단순하고 구현하기 쉬워서 “가장 먼저 시도해 볼 것”으로도 매우 좋다.
정리
- 나이브 베이즈는 \(p(x \mid y) = \prod_j p(x_j \mid y)\)로 모델링하고, 매개변수는 개수의 비율로 추정한다.
- 학습 집합에 없던 단어는 최대우도로 확률이 0이 되어, 사후 확률 계산에서 \(0/0\)이 생긴다.
- 라플라스 스무딩은 \(k\)개 값의 다항 분포 추정에서 분자에 1, 분모에 \(k\)를 더한다. 합은 여전히 1이고 0인 추정값이 사라진다.
- 이진 특성의 나이브 베이즈에서는 분자에 1, 분모에 2를 더한다. \(\phi_y\)에는 보통 스무딩이 크게 중요하지 않다.
- 베르누이 사건 모델은 사전의 각 단어가 등장했는지를 보고, 다항 사건 모델은 메일의 각 위치의 단어를 같은 다항 분포에서 독립적으로 뽑는다고 본다.
- 다항 사건 모델의 추정값은 클래스별 전체 단어 중 단어 \(k\)의 비율이며, 스무딩 시 분모에 \(\lvert V \rvert\)를 더한다. 텍스트 분류에서는 대개 다항 사건 모델이 더 좋다.