- Stanford CS229 Machine Learning (Spring 2022) 12강 정리
- 강의: Tengyu Ma, Christopher Ré
- ▶ 강의 영상
- 참고: CS229 lecture notes Ch. 10 Clustering and the k-means algorithm, Ch. 11 EM algorithms(11.1)
군집화
군집화(clustering) 문제에서는 학습 집합 \(\{x^{(1)}, \ldots, x^{(n)}\}\), \(x^{(i)} \in \mathbb{R}^d\)가 주어지고, 이를 몇 개의 응집된 “군집(cluster)”으로 묶고 싶다. 레이블 \(y^{(i)}\)가 없으므로 비지도 학습(unsupervised learning) 문제다.
k-means 알고리즘
알고리즘
- 군집 중심(cluster centroid) \(\mu_1, \ldots, \mu_k \in \mathbb{R}^d\)를 무작위로 초기화한다.
- 수렴할 때까지 반복한다.
-
각 \(i\)에 대해 가장 가까운 중심에 배정한다.
\[c^{(i)} := \arg\min_j \lVert x^{(i)} - \mu_j \rVert^2\] -
각 \(j\)에 대해 배정된 점들의 평균으로 중심을 옮긴다.
\[\mu_j := \frac{\sum_{i=1}^{n} 1\{c^{(i)} = j\} x^{(i)}}{\sum_{i=1}^{n} 1\{c^{(i)} = j\}}\]
-
\(k\)는 찾고자 하는 군집 수로, 알고리즘의 매개변수다. 중심 \(\mu_j\)는 군집 중심 위치에 대한 현재의 추측이다. 초기화는 학습 예제 \(k\)개를 무작위로 골라 그 값으로 두는 방법이 흔하다(다른 방법도 가능하다). 내부 반복은 (i) 각 예제를 가장 가까운 중심에 배정하고, (ii) 각 중심을 배정된 점들의 평균으로 이동하는 두 단계로 이루어진다.
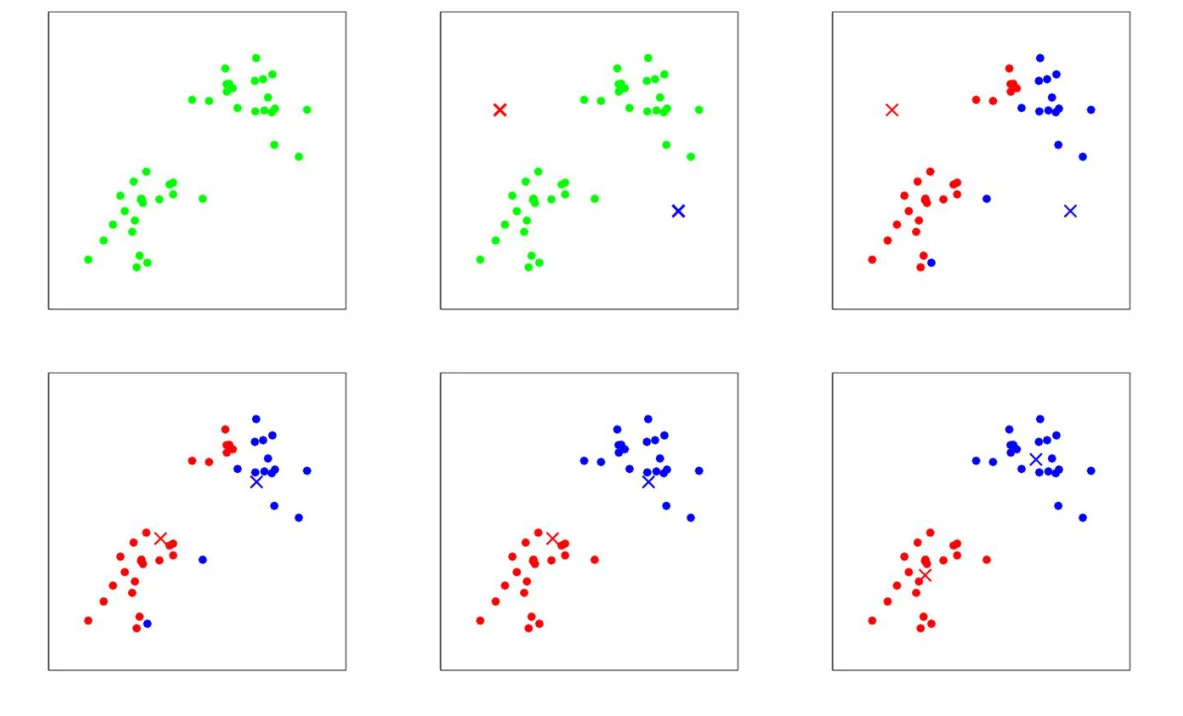 k-means의 진행 과정(\(k = 2\)). 점은 학습 예제, ×는 군집 중심이다. 왼쪽 위부터 차례로 (a) 원래 데이터, (b) 무작위 초기 중심, (c)–(f) 배정과 이동을 두 번 반복한 모습이다. 출처: CS229 lecture notes.
그림은 위 행 왼쪽에서 오른쪽, 이어서 아래 행 왼쪽에서 오른쪽 순서로 읽는다. (a)는 레이블 없는 원래 데이터로, 왼쪽 아래와 오른쪽 위에 두 무리가 보인다. (b)에서는 빨간 중심과 파란 중심을 무작위 위치에 놓는다. 이 예에서는 일부러 학습 예제와 다른 위치를 골랐으며, 두 중심 모두 실제 무리에서 꽤 떨어져 있다.
(c)는 첫 배정 단계다. 각 점을 더 가까운 중심의 색으로 칠하므로, 오른쪽 위 무리의 왼쪽 일부는 빨간 중심에 더 가까워 빨간색이 된다. (d)는 첫 이동 단계로, 각 중심이 자기 색 점들의 평균으로 옮겨 가 두 무리 쪽으로 크게 다가선다. (e)에서 다시 배정하면 중심이 무리 안에 있으므로 점들이 거의 올바른 무리로 나뉘고, (f)에서 중심이 각 무리의 평균으로 이동한다. 이후에는 배정이 더 바뀌지 않으므로 알고리즘이 수렴한다. 배정과 이동을 번갈아 할 때마다 점과 중심 사이의 거리가 줄어드는 것이 보이는데, 이것이 바로 아래에서 정의할 왜곡 함수의 단조 감소다.
왜곡 함수와 수렴
다음 왜곡 함수(distortion function) 를 정의한다.
\[J(c, \mu) = \sum_{i=1}^{n} \lVert x^{(i)} - \mu_{c^{(i)}} \rVert^2\]각 예제와 그것이 배정된 중심 사이의 제곱 거리의 합이다. k-means는 \(J\)에 대한 좌표 하강(coordinate descent) 과 정확히 같다.
- \(\mu\)를 고정하면 \(J\)는 \(i\)마다 독립인 항 \(\lVert x^{(i)} - \mu_{c^{(i)}} \rVert^2\)의 합이므로, 각 \(c^{(i)}\)를 가장 가까운 중심으로 고르는 것이 최소화다. 이것이 배정 단계다.
- \(c\)를 고정하면 \(J\)는 \(\mu_j\)마다 \(\sum_{i : c^{(i)} = j} \lVert x^{(i)} - \mu_j \rVert^2\)로 분리된다. \(\mu_j\)로 미분해 0으로 두면 \(\sum_{i : c^{(i)} = j} 2(\mu_j - x^{(i)}) = 0\), 즉 \(\mu_j\)는 배정된 점들의 평균이다. 이것이 이동 단계다.
각 단계가 \(J\)를 증가시키지 않으므로 \(J\)는 단조 감소하고 수렴한다. 대개 이는 \(c\)와 \(\mu\)도 수렴한다는 뜻이다. 이론적으로는 \(J\) 값이 정확히 같은 몇 개의 군집화 사이를 진동할 수도 있지만 실제로는 거의 일어나지 않는다.
국소 최적점
\(J\)는 비볼록(non-convex) 함수이므로 좌표 하강이 전역 최소점에 수렴한다는 보장이 없다. 즉 k-means는 국소 최적점(local optima)에 빠질 수 있다. 실제로는 대개 좋은 군집화를 찾지만, 걱정된다면 서로 다른 무작위 초기화로 k-means를 여러 번 돌리고 그중 왜곡 \(J(c, \mu)\)가 가장 작은 결과를 고른다.
가우시안 혼합 모델
모델
이제 군집화를 확률 모델로 다루어 밀도 추정(density estimation) 문제로 본다. 결합 분포를 \(p(x^{(i)}, z^{(i)}) = p(x^{(i)} \mid z^{(i)}) p(z^{(i)})\)로 두고 다음과 같이 모델링한다.
\[z^{(i)} \sim \text{Multinomial}(\phi), \qquad x^{(i)} \mid z^{(i)} = j \sim \mathcal{N}(\mu_j, \Sigma_j)\]여기서 \(\phi_j \geq 0\), \(\sum_{j=1}^{k} \phi_j = 1\)이고 \(\phi_j = p(z^{(i)} = j)\)다. 즉 각 \(x^{(i)}\)는 먼저 \(\{1, \ldots, k\}\)에서 \(z^{(i)}\)를 무작위로 뽑고, 그에 해당하는 가우시안에서 생성된다. 이를 가우시안 혼합(mixture of Gaussians) 모델이라 한다. \(z^{(i)}\)는 관측되지 않는 잠재 확률 변수(latent random variable) 이며, 이것이 추정을 어렵게 만든다.
최대우도 추정이 어려운 이유
매개변수 \(\phi, \mu, \Sigma\)의 로그우도는 다음과 같다.
\[\ell(\phi, \mu, \Sigma) = \sum_{i=1}^{n} \log p(x^{(i)}; \phi, \mu, \Sigma) = \sum_{i=1}^{n} \log \sum_{z^{(i)}=1}^{k} p(x^{(i)} \mid z^{(i)}; \mu, \Sigma) \, p(z^{(i)}; \phi)\]로그 안에 합이 있어서, 미분해 0으로 두고 풀어도 닫힌 꼴의 최대우도 해가 나오지 않는다.
z를 안다면
만약 각 \(x^{(i)}\)가 어느 가우시안에서 왔는지(\(z^{(i)}\))를 안다면 로그우도는
\[\ell(\phi, \mu, \Sigma) = \sum_{i=1}^{n} \left( \log p(x^{(i)} \mid z^{(i)}; \mu, \Sigma) + \log p(z^{(i)}; \phi) \right)\]가 되고, 최대화하면 다음을 얻는다.
\[\phi_j = \frac{1}{n} \sum_{i=1}^{n} 1\{z^{(i)} = j\}, \qquad \mu_j = \frac{\sum_{i=1}^{n} 1\{z^{(i)} = j\} x^{(i)}}{\sum_{i=1}^{n} 1\{z^{(i)} = j\}}, \qquad \Sigma_j = \frac{\sum_{i=1}^{n} 1\{z^{(i)} = j\} (x^{(i)} - \mu_j)(x^{(i)} - \mu_j)^T}{\sum_{i=1}^{n} 1\{z^{(i)} = j\}}\]이는 \(z^{(i)}\)가 클래스 레이블 역할을 한다는 점만 빼면 GDA의 최대우도 추정과 거의 같다. 차이는 \(z^{(i)}\)가 베르누이가 아니라 다항 분포이고, 가우시안마다 다른 공분산 \(\Sigma_j\)를 쓴다는 것뿐이다.
EM 알고리즘
E-step과 M-step
실제로는 \(z^{(i)}\)를 모른다. EM(Expectation-Maximization) 알고리즘은 두 단계를 반복한다. E-step에서는 \(z^{(i)}\)의 값을 “추측”하고, M-step에서는 그 추측이 맞다고 가정하고 매개변수를 갱신한다. 추측이 맞다고 치므로 최대화는 쉬워진다.
수렴할 때까지 반복한다.
(E-step) 각 \(i, j\)에 대해 다음을 계산한다.
\[w_j^{(i)} := p(z^{(i)} = j \mid x^{(i)}; \phi, \mu, \Sigma)\](M-step) 매개변수를 갱신한다.
\[\phi_j := \frac{1}{n} \sum_{i=1}^{n} w_j^{(i)}, \qquad \mu_j := \frac{\sum_{i=1}^{n} w_j^{(i)} x^{(i)}}{\sum_{i=1}^{n} w_j^{(i)}}, \qquad \Sigma_j := \frac{\sum_{i=1}^{n} w_j^{(i)} (x^{(i)} - \mu_j)(x^{(i)} - \mu_j)^T}{\sum_{i=1}^{n} w_j^{(i)}}\]E-step은 현재 매개변수에서 \(x^{(i)}\)가 주어졌을 때 \(z^{(i)}\)의 사후 확률을 베이즈 규칙으로 계산한다.
\[p(z^{(i)} = j \mid x^{(i)}; \phi, \mu, \Sigma) = \frac{p(x^{(i)} \mid z^{(i)} = j; \mu, \Sigma) \, p(z^{(i)} = j; \phi)}{\sum_{l=1}^{k} p(x^{(i)} \mid z^{(i)} = l; \mu, \Sigma) \, p(z^{(i)} = l; \phi)}\]분자의 첫 인자는 평균 \(\mu_j\), 공분산 \(\Sigma_j\)인 가우시안 밀도를 \(x^{(i)}\)에서 계산한 값이고, 둘째 인자는 \(\phi_j\)다.
해석
- \(w_j^{(i)}\)는 \(z^{(i)}\)에 대한 “소프트(soft)” 추측이다. 하나의 값으로 정하는 “하드(hard)” 추측과 달리 \([0, 1]\)의 확률값이다.
- M-step의 갱신식은 \(z^{(i)}\)를 알 때의 공식에서 지시 함수 \(1\{z^{(i)} = j\}\)를 \(w_j^{(i)}\)로 바꾼 것과 정확히 같다.
- k-means와 비교하면, k-means의 하드 배정 \(c^{(i)}\) 대신 소프트 배정 \(w_j^{(i)}\)를 쓰는 셈이다. 각 점이 군집에 “부분적으로” 속하고, 중심(평균)은 그 가중치로 계산한 가중 평균이 된다.
- k-means처럼 EM도 국소 최적점에 빠질 수 있으므로, 여러 초기값으로 다시 시작해 보는 것이 좋다.
EM은 \(z^{(i)}\)를 반복해서 추측한다는 자연스러운 해석을 갖는다. 그렇다면 이 알고리즘은 어디서 나왔으며, 수렴을 보장할 수 있는가? Jensen 부등식으로 로그우도의 하한(ELBO)을 만들고 이를 번갈아 최적화하는 일반적인 EM 관점과 수렴 보장은 13강에서 다룬다.
정리
- 군집화는 레이블 없는 데이터를 응집된 군집으로 묶는 비지도 학습 문제다.
- k-means는 가장 가까운 중심에 배정하는 단계와 중심을 배정된 점의 평균으로 옮기는 단계를 반복한다.
- k-means는 왜곡 함수 \(J(c, \mu) = \sum_i \lVert x^{(i)} - \mu_{c^{(i)}} \rVert^2\)에 대한 좌표 하강이므로 \(J\)가 단조 감소해 수렴하지만, \(J\)가 비볼록이라 국소 최적점에 빠질 수 있어 여러 번 초기화한다.
- 가우시안 혼합 모델은 잠재 변수 \(z^{(i)} \sim \text{Multinomial}(\phi)\)와 \(x^{(i)} \mid z^{(i)} = j \sim \mathcal{N}(\mu_j, \Sigma_j)\)로 데이터를 모델링하며, 로그 안의 합 때문에 최대우도 해가 닫힌 꼴로 나오지 않는다.
- \(z^{(i)}\)를 알면 추정은 GDA와 거의 같다. EM은 E-step에서 사후 확률 \(w_j^{(i)}\)로 \(z^{(i)}\)를 소프트하게 추측하고, M-step에서 이를 가중치로 쓴 최대우도 추정을 한다.
- EM은 하드 배정 대신 소프트 배정을 쓰는 k-means로 볼 수 있으며, 역시 국소 최적점에 민감하다.