- Stanford CS229 Machine Learning (Spring 2022) 16강 정리
- 강의: Tengyu Ma, Christopher Ré
- ▶ 강의 영상
- 참고: CS229 lecture notes 15장 Foundation models overview, 16장 Representation learning
파운데이션 모델
배경
지도 학습으로 훈련한 신경망은 큰 성공을 거두었지만, 꽤 큰 라벨 데이터셋에 의존하고 라벨을 모으는 데는 비용이 든다. 2018년 무렵부터 BERT, GPT-3 같은 모델이 등장하면서 패러다임이 바뀌었다. 넓은 데이터로 대규모 사전학습(pretraining) 을 한 뒤, 다양한 다운스트림(downstream) 과제에 적응(adaptation) 시키는 방식이다. Bommasani et al. (2021)은 이런 모델을 파운데이션 모델(foundation model) 이라 불렀다.
파운데이션 모델은 대개 막대한 비라벨 데이터를 활용해서, 많은 다운스트림 과제를 적은 라벨 데이터로, 또는 라벨 없이 풀 수 있게 한다. 여전히 신경망 기반이지만 규모가 커지면서 새로운 능력이 창발(emergent)하기도 한다. 이 모델들은 보통 자기지도 학습(self-supervised learning) 으로 훈련한다. 자기지도 학습은 입력의 일부로부터 감독 신호를 만들어 낸다. 직관은 다양한 데이터로 사전학습하면 여러 다운스트림 과제로 전이되는 넓은 구조를 배울 수 있다는 것이다.
사전학습
사전학습 데이터셋은 보통 대규모 비라벨 데이터 \(\{x^{(1)}, \dots, x^{(n)}\}\)이다. 모달리티에 따라 \(x^{(i)}\)는 이미지, 단어 시퀀스, 또는 단어·이미지·소리·영상의 혼합일 수 있다. ImageNet처럼 라벨이 있는 대규모 데이터로 사전학습하는 경우도 있다. 모델 매개변수를 \(\theta\), 데이터 하나에 대한 손실을 \(\ell_{\text{pre}}\)라 하면 사전학습 손실은 다음과 같다.
\[L_{\text{pre}}(\theta) = \frac{1}{n} \sum_{i=1}^n \ell_{\text{pre}}(x^{(i)}, \theta)\]\(\ell_{\text{pre}}\)는 데이터 자신으로부터 “감독”을 만들어 내는 자기지도 손실이다. 이를 SGD나 Adam으로 최소화해 사전학습된 모델 \(\hat{\theta}\)를 얻는다. 손실이 정확히 데이터별 합의 형태가 아닐 수도 있는데, 뒤에서 볼 대조 학습이 그런 예다.
적응
전형적인 지도 다운스트림 과제에는 라벨 데이터셋 \(\{(x_{\text{task}}^{(1)}, y_{\text{task}}^{(1)}), \dots, (x_{\text{task}}^{(n_{\text{task}})}, y_{\text{task}}^{(n_{\text{task}})})\}\)이 있고, 보통 \(n_{\text{task}}\)는 사전학습 데이터보다 훨씬 작다. 라벨 데이터가 5–10개 정도뿐이면 퓨샷 학습(few-shot learning), 하나도 없으면 제로샷 학습(zero-shot learning) 이라 한다. 제로샷에서 현대 언어 모델은 과제를 자연어로 설명받기만 하기도 한다.
표현 학습과 적응 방법
표현
표현 학습(representation learning) 은 사전학습 방법의 한 종류다. \(\theta\)로 매개변수화한 모델 \(\phi_\theta\)가 입력 \(x\)를 벡터 \(\phi_\theta(x) \in \mathbb{R}^m\)으로 보내며, 이를 특성 벡터(feature vector), 임베딩(embedding), 또는 표현(representation) 이라 한다. 좋은 표현은 여러 다운스트림 과제에 유용한 의미 정보를 담아야 한다. 사전학습으로 \(\phi_{\hat{\theta}}\)를 얻은 뒤, 적응 단계에서는 다운스트림 데이터로 이 표현에서 과제에 필요한 정보를 어떻게 꺼낼지 정한다.
선형 탐사
선형 탐사(linear probing) 는 \(\phi_{\hat{\theta}}\)를 고정하고 그 위의 선형 예측 헤드만 학습한다. 예측 모델은 \(w^T \phi_{\hat{\theta}}(x)\)이고 \(w \in \mathbb{R}^m\)만 학습한다. 회귀 과제라면 다음을 푼다.
\[\min_{w \in \mathbb{R}^m} \frac{1}{n_{\text{task}}} \sum_{i=1}^{n_{\text{task}}} \left( y_{\text{task}}^{(i)} - w^T \phi_{\hat{\theta}}(x_{\text{task}}^{(i)}) \right)^2\]일반적으로는 제곱 손실 대신 과제 손실 \(\ell_{\text{task}}\)를 쓴다.
미세조정
미세조정(finetuning) 은 같은 예측 모델 \(w^T \phi_\theta(x)\)를 쓰되 표현의 매개변수 \(\theta\)도 함께 학습한다. \(\theta\)는 사전학습 모델 \(\hat{\theta}\)에서, \(w\)는 보통 무작위로 초기화한다.
\[\min_{w, \theta} \frac{1}{n_{\text{task}}} \sum_{i=1}^{n_{\text{task}}} \ell_{\text{task}}\left( y_{\text{task}}^{(i)}, w^T \phi_\theta(x_{\text{task}}^{(i)}) \right), \qquad w \leftarrow \text{random}, \quad \theta \leftarrow \hat{\theta}\]관련된 경우로 지속 사전학습(continued pretraining) 이 있다. \(\hat{\theta}\)에서 시작해 다른 비라벨 데이터로 사전학습과 같은 형태의 손실을 계속 최소화한다. 새 데이터 분포가 원래 사전학습 데이터보다 다운스트림 도메인에 가까울 때 유용하다.
LP-FT(linear probing then finetuning) 는 두 단계 방법이다. 먼저 표현을 고정한 채 선형 탐사로 헤드 \(w\)를 학습하고, 그 \(w\)와 \(\theta = \hat{\theta}\)에서 시작해 전체를 미세조정한다. 첫 단계는 사전학습 표현의 과제별 읽기 방식을 찾고, 둘째 단계는 표현 자체가 다운스트림 데이터에 맞춰 조정되게 한다. 무작위 헤드로 미세조정할 때 생기는 나쁜 특성 왜곡을 줄이려는 방법이며, 일부 설정에서 분포 밖(out-of-distribution) 성능을 높인다(Kumar et al., 2022).
LoRA
다운스트림 과제가 사전학습과 아주 다르지 않다면, 미세조정된 모델은 사전학습 모델에서 멀지 않을 것이고 모든 자유도를 쓸 필요가 없을 수 있다. LoRA(low-rank adaptation) 는 사전학습 가중치를 고정하고 가중치 행렬의 저랭크 갱신만 학습하는, 매개변수 효율적인 미세조정 방법이다.
선형층 \(h = W_0 x\)(\(W_0 \in \mathbb{R}^{d_{\text{out}} \times d_{\text{in}}}\))를 생각하자. 전체 미세조정은 제약 없는 갱신 \(\Delta W\)로 \(h = (W_0 + \Delta W) x\)를 쓰는 것과 같다. LoRA는 랭크 \(r \ll \min(d_{\text{out}}, d_{\text{in}})\)에 대해 갱신을 저랭크로 제한한다.
\[\Delta W = BA, \quad B \in \mathbb{R}^{d_{\text{out}} \times r}, \ A \in \mathbb{R}^{r \times d_{\text{in}}}, \qquad h = W_0 x + \frac{\alpha}{r} B A x\]\(W_0\)는 고정하고 \(A\), \(B\)만 학습하므로, 학습할 매개변수가 \(d_{\text{out}} d_{\text{in}}\)개에서 \(r(d_{\text{out}} + d_{\text{in}})\)개로 준다. 흔히 \(B = 0\)으로 초기화해 처음에는 사전학습 모델과 같은 함수를 계산하게 한다. 저랭크인 것은 갱신뿐이며 최종 가중치 \(W_0 + (\alpha / r) BA\)가 저랭크라는 뜻은 아니다.
LoRA는 그래디언트와 옵티마이저 상태의 메모리를 줄이지만, 고정된 \(W_0\)와 역전파용 활성값은 그대로 필요하므로 계산량과 학습 메모리 절감은 제한적일 수 있다. 가장 큰 장점은 어댑터가 작아서 같은 기반 모델에 대한 과제별 어댑터를 많이 저장해 두고 빠르게 바꿔 끼울 수 있다는 점이다. 반면 갱신을 저랭크 집합으로 제한하므로, 분포 변화가 크거나 큰 용량의 적응이 필요할 때는 전체 매개변수 학습이 나을 수 있다.
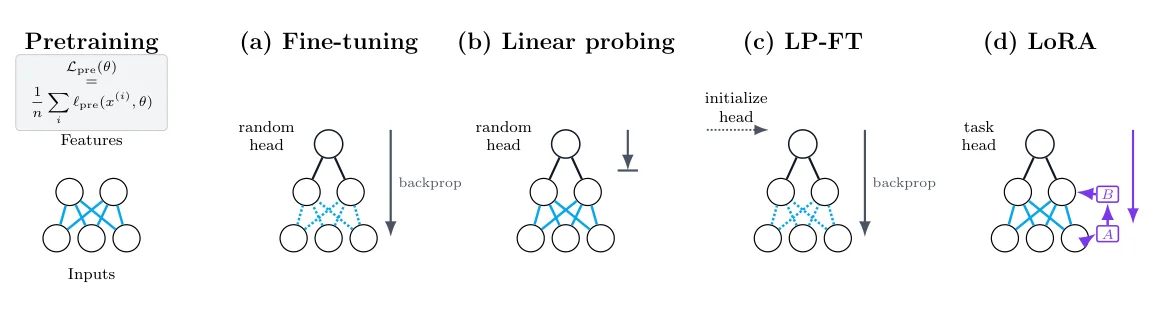 사전학습과 네 가지 적응 방법의 비교. 맨 왼쪽은 사전학습 손실 \(\mathcal{L}_{\text{pre}}(\theta)\)로 학습한 표현이고, (a) 미세조정, (b) 선형 탐사, (c) LP-FT, (d) LoRA는 그 위에 헤드를 얹어 다운스트림 과제에 맞춘다. 출처: CS229 lecture notes.
그림의 각 네트워크에서 아래 세 원은 입력, 가운데 두 원은 사전학습된 표현 \(\phi_{\hat{\theta}}\), 맨 위 원은 과제용 헤드 \(w\)다. 파란 선은 사전학습에서 가져온 가중치, 오른쪽의 세로 화살표는 역전파(backprop)가 어디까지 내려가는지를 나타낸다. 이 두 가지를 보면 방법들의 차이가 한눈에 드러난다.
- (a) 미세조정: 헤드를 무작위로 초기화하고, 역전파 화살표가 맨 아래까지 내려간다. 표현 쪽 가중치(점선)도 함께 바뀐다.
- (b) 선형 탐사: 화살표가 헤드 바로 아래에서 막힌다. 표현은 고정되고 헤드만 학습한다.
- (c) LP-FT: 선형 탐사로 얻은 헤드로 초기화(점선 화살표)한 뒤 전체를 미세조정한다. 모양은 (a)와 같지만 출발점의 헤드가 다르다.
- (d) LoRA: 사전학습 가중치는 실선 그대로 고정되고, 옆에 붙은 작은 행렬 \(A\), \(B\)(보라색)만 학습된다.
표현 학습 방법
지도 사전학습
지도 사전학습(supervised pretraining) 은 ImageNet 같은 대규모 라벨 데이터로 평범한 지도 학습을 한 뒤 마지막 층을 떼어 내는 방법이다. 학습된 네트워크를 \(U \phi_{\hat{\theta}}(x)\)로 쓰자. \(U\)는 마지막 완전연결층의 매개변수이고, \(\hat{\theta}\)는 나머지 층의 매개변수이며, \(\phi_{\hat{\theta}}(x)\)는 끝에서 두 번째 층의 활성값이다. \(U\)를 버리고 \(\phi_{\hat{\theta}}(x)\)를 사전학습된 표현으로 쓴다.
대조 학습의 아이디어
대조 학습(contrastive learning) 은 비라벨 데이터만 쓰는 자기지도 사전학습 방법이다. 핵심 직관은 좋은 표현 함수 \(\phi_\theta\)가 의미적으로 비슷한 이미지(또는 텍스트)를 비슷한 표현으로 보내고, 무작위로 고른 두 이미지에는 대체로 서로 다른 표현을 주어야 한다는 것이다. 예를 들어 허스키 이미지 두 장은 비슷한 표현으로, 허스키와 코끼리는 다른 표현으로 가야 한다.
문제는 비슷한 쌍을 어떻게 얻느냐다. 같은 클래스의 이미지를 비슷하다고 정의하면 라벨이 있을 때 쓰는 지도 대조(supervised contrastive) 방법이 된다. 라벨이 없으면 데이터 증강(data augmentation) 을 쓴다. 원본 이미지 \(x\)에 무작위 자르기, 뒤집기, 색 변환 등을 적용해 두 변형 \(\hat{x}\), \(\tilde{x}\)를 만들고, 이를 양성 쌍(positive pair) 이라 한다. 같은 이미지에서 나왔으므로 의미적으로 관련되어 있을 가능성이 높다. 반대로 데이터셋의 다른 이미지 \(z\)에서 증강 \(\hat{z}\)를 만들면 \((\hat{x}, \hat{z})\)는 대체로 관련이 없으므로 음성 쌍(negative pair), 더 정확히는 무작위 쌍(random pair)이라 한다. 양성 쌍의 표현은 가깝게, 무작위 쌍의 표현은 멀게 만드는 손실을 설계한다.
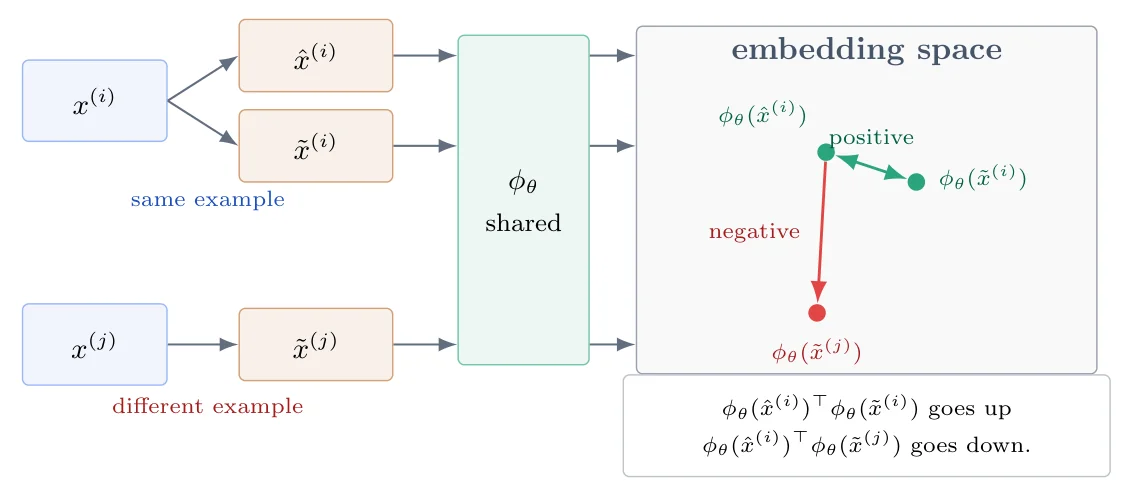 대조 학습의 구조. 같은 예제 \(x^{(i)}\)에서 나온 두 증강은 양성 쌍, 다른 예제 \(x^{(j)}\)의 증강과는 음성(무작위) 쌍을 이룬다. 출처: CS229 lecture notes.
그림은 왼쪽에서 오른쪽으로 흐른다. 맨 왼쪽의 \(x^{(i)}\)에 서로 다른 무작위 증강을 두 번 적용해 \(\hat{x}^{(i)}\)와 \(\tilde{x}^{(i)}\)를 만들고, 다른 예제 \(x^{(j)}\)에서도 증강 \(\tilde{x}^{(j)}\)를 만든다. 세 증강은 모두 같은 가중치를 공유하는 하나의 인코더 \(\phi_\theta\)를 거쳐 임베딩 공간의 점이 된다.
오른쪽 임베딩 공간에서 초록 점 두 개(\(\phi_\theta(\hat{x}^{(i)})\), \(\phi_\theta(\tilde{x}^{(i)})\))는 양성 쌍이므로 서로 끌어당기고, 빨간 점 \(\phi_\theta(\tilde{x}^{(j)})\)는 음성 쌍이므로 밀어낸다. 아래 상자의 두 줄이 이를 내적으로 표현한 것이다. 양성 쌍의 내적은 커지고 음성 쌍의 내적은 작아지도록 학습하며, 아래의 SimCLR 손실이 바로 이 두 방향의 힘을 하나의 식으로 묶는다.
SimCLR
SimCLR (Chen et al., 2020)을 구체적인 예로 본다. 크기 \(B\)인 배치 \((x^{(1)}, \dots, x^{(B)})\)의 각 데이터에 무작위 증강을 두 번 적용해 \(\hat{x}^{(i)}\), \(\tilde{x}^{(i)}\)를 만들어 \(2B\)개의 증강 배치를 얻는다. 손실은 다음과 같다(원래 손실을 본질은 유지한 채 단순화한 형태).
\[L_{\text{pre}}(\theta) = -\sum_{i=1}^B \log \frac{\exp\left( \phi_\theta(\hat{x}^{(i)})^T \phi_\theta(\tilde{x}^{(i)}) \right)}{\exp\left( \phi_\theta(\hat{x}^{(i)})^T \phi_\theta(\tilde{x}^{(i)}) \right) + \sum_{j \ne i} \exp\left( \phi_\theta(\hat{x}^{(i)})^T \phi_\theta(\tilde{x}^{(j)}) \right)}\]이 손실은 소프트맥스 분류의 형태다. \(\hat{x}^{(i)}\)의 짝을 배치 안의 \(\tilde{x}^{(1)}, \dots, \tilde{x}^{(B)}\) 중에서 맞히는 문제로 볼 수 있다.
직관. \(p, q > 0\)일 때 \(-\log \frac{p}{p + q}\)는 \(p\)에 대해 감소하고 \(q\)에 대해 증가한다. 손실은 무작위 쌍의 내적 \(\phi_\theta(\hat{x}^{(i)})^T \phi_\theta(\tilde{x}^{(j)})\)에 대해 증가하므로, 손실을 줄이면 이 내적이 작아져 \(\phi_\theta(\hat{x}^{(i)})\)와 \(\phi_\theta(\tilde{x}^{(j)})\)가 멀어진다. 반대로 양성 쌍의 내적 \(\phi_\theta(\hat{x}^{(i)})^T \phi_\theta(\tilde{x}^{(i)})\)에 대해서는 감소하므로, 손실을 줄이면 이 내적이 커져 두 표현이 가까워진다.
이 손실은 데이터별 손실의 단순 합이 아니라 배치 안의 다른 데이터에 의존한다는 점도 눈여겨볼 만하다. 사전학습 손실이 꼭 \(\frac{1}{n} \sum_i \ell_{\text{pre}}(x^{(i)}, \theta)\) 형태일 필요는 없다.
표현의 활용: 의미 검색
학습된 임베딩은 다운스트림 분류의 입력으로만 쓰이는 것이 아니다. 노트는 질의와 관련된 문서를 단어가 겹치지 않아도 찾아내는 의미 검색(semantic retrieval) 을 예로 든다. 질의 \(q\)와 문서 \(d\)의 임베딩을 단위 노름으로 정규화하면 내적 \(\phi_\theta(q)^T \phi_\theta(d)\)가 코사인 유사도가 되고, 이를 관련도 점수로 쓴다. 문서 임베딩을 미리 계산해 두면 검색은 내적이 큰 벡터를 찾는 문제가 된다.
정리
- 파운데이션 모델은 대규모(주로 비라벨) 데이터로 사전학습한 뒤 다운스트림 과제에 적응시키며, 사전학습은 입력 자신으로부터 감독 신호를 만드는 자기지도 학습으로 한다.
- 사전학습 손실은 \(L_{\text{pre}}(\theta) = \frac{1}{n} \sum_i \ell_{\text{pre}}(x^{(i)}, \theta)\)로 쓰고, 다운스트림 라벨이 몇 개뿐이면 퓨샷, 없으면 제로샷이라 한다.
- 선형 탐사는 표현 \(\phi_{\hat{\theta}}\)를 고정하고 헤드 \(w\)만, 미세조정은 \(\theta = \hat{\theta}\)에서 시작해 \(w\)와 \(\theta\)를 함께 학습한다. LP-FT는 선형 탐사 헤드로 미세조정을 초기화한다.
- LoRA는 \(W_0\)를 고정하고 저랭크 갱신 \(BA\)만 학습해 학습 매개변수를 \(r(d_{\text{out}} + d_{\text{in}})\)개로 줄인다.
- 지도 사전학습은 라벨 데이터로 학습한 네트워크의 끝에서 두 번째 층을 표현으로 쓴다.
- 대조 학습은 같은 이미지의 두 증강(양성 쌍)의 표현은 가깝게, 다른 이미지의 증강(무작위 쌍)의 표현은 멀게 한다. SimCLR 손실은 양성 쌍의 내적을 키우고 무작위 쌍의 내적을 줄이는 소프트맥스 형태다.