- Stanford CS229 Machine Learning (Spring 2022) 2강 정리
- 강의: Tengyu Ma, Christopher Ré
- ▶ 강의 영상
- 참고: CS229 lecture notes Part I 도입부, Chapter 1 (1.1 LMS algorithm, 1.2 The normal equations)
지도 학습의 표기법
입력 변수(입력 특성, input feature)를 \(x^{(i)}\), 예측하려는 출력 또는 타깃 변수(target variable)를 \(y^{(i)}\)로 쓴다. 한 쌍 \((x^{(i)}, y^{(i)})\)를 학습 예제(training example)라 하고, \(n\)개의 예제 목록 \(\{(x^{(i)}, y^{(i)}); i = 1, \dots, n\}\)을 학습 집합(training set)이라 한다. 위첨자 \((i)\)는 학습 집합의 인덱스일 뿐 거듭제곱이 아니다. 입력 공간을 \(\mathcal{X}\), 출력 공간을 \(\mathcal{Y}\)로 쓰며, 집값 예제에서는 \(\mathcal{X} = \mathcal{Y} = \mathbb{R}\)이다.
지도 학습의 목표는 학습 집합이 주어졌을 때 \(h(x)\)가 대응하는 \(y\)를 잘 예측하도록 함수 \(h : \mathcal{X} \to \mathcal{Y}\)를 학습하는 것이다. 역사적인 이유로 이 \(h\)를 가설(hypothesis)이라 부른다. \(y\)가 연속값이면 회귀(regression), 소수의 이산값이면 분류(classification) 문제다.
선형 회귀
가설
집값 데이터에 침실 수를 추가해 입력이 2차원 벡터 \(x \in \mathbb{R}^2\)라 하자. \(x_1^{(i)}\)은 \(i\)번째 집의 면적, \(x_2^{(i)}\)는 침실 수다. 가장 먼저 시도할 수 있는 가설은 \(y\)를 \(x\)의 선형 함수로 근사하는 것이다.
\[h_\theta(x) = \theta_0 + \theta_1 x_1 + \theta_2 x_2\]\(\theta_j\)는 매개변수(parameter) 또는 가중치(weight)다. 절편항(intercept term)을 위해 \(x_0 = 1\)로 두면 다음처럼 간단히 쓸 수 있다. 여기서 \(d\)는 \(x_0\)를 제외한 입력 변수의 개수다.
\[h(x) = \sum_{j=0}^{d} \theta_j x_j = \theta^T x\]비용 함수
학습 예제에서 \(h(x^{(i)})\)가 \(y^{(i)}\)에 가까워지도록 \(\theta\)를 고르고 싶다. 이를 측정하는 비용 함수(cost function)를 다음과 같이 정의한다.
\[J(\theta) = \frac{1}{2} \sum_{i=1}^{n} \left( h_\theta(x^{(i)}) - y^{(i)} \right)^2\]이는 보통 최소제곱(ordinary least squares) 회귀의 최소제곱 비용 함수다. 왜 하필 제곱 오차를 쓰는지는 3강에서 확률적 해석으로 정당화한다.
LMS 알고리즘
경사하강법
\(J(\theta)\)를 최소화하기 위해, 초기 추정값에서 출발해 \(J\)가 작아지는 방향으로 \(\theta\)를 반복해서 바꾸는 탐색 알고리즘을 쓴다. 경사하강법(gradient descent) 은 다음 갱신을 반복한다.
\[\theta_j := \theta_j - \alpha \frac{\partial}{\partial \theta_j} J(\theta)\]이 갱신은 모든 \(j = 0, \dots, d\)에 대해 동시에 수행한다. \(\alpha\)는 학습률(learning rate)이다. \(J\)가 가장 가파르게 감소하는 방향으로 한 걸음씩 움직이는 자연스러운 알고리즘이다. 표기 \(a := b\)는 변수 \(a\)의 값을 \(b\)로 덮어쓰는 연산이고, \(a = b\)는 두 값이 같다는 사실의 진술이다.
편미분 유도
먼저 학습 예제가 하나 \((x, y)\)뿐이라고 하고 합을 무시한다.
\[\begin{aligned} \frac{\partial}{\partial \theta_j} J(\theta) &= \frac{\partial}{\partial \theta_j} \frac{1}{2} \left( h_\theta(x) - y \right)^2 \\ &= 2 \cdot \frac{1}{2} \left( h_\theta(x) - y \right) \cdot \frac{\partial}{\partial \theta_j} \left( h_\theta(x) - y \right) \\ &= \left( h_\theta(x) - y \right) \cdot \frac{\partial}{\partial \theta_j} \left( \sum_{i=0}^{d} \theta_i x_i - y \right) \\ &= \left( h_\theta(x) - y \right) x_j \end{aligned}\]따라서 예제 하나에 대한 갱신 규칙은 다음과 같다.
\[\theta_j := \theta_j + \alpha \left( y^{(i)} - h_\theta(x^{(i)}) \right) x_j^{(i)}\]이를 LMS 갱신 규칙(least mean squares)이라 하며, Widrow-Hoff 학습 규칙이라고도 한다. 갱신의 크기가 오차 \(y^{(i)} - h_\theta(x^{(i)})\)에 비례한다는 점이 직관적이다. 예측이 정답과 거의 일치하는 예제에서는 매개변수를 거의 바꿀 필요가 없고, 예측이 크게 틀린 예제에서는 매개변수를 크게 바꾼다.
배치 경사하강법
예제가 여러 개일 때 LMS를 확장하는 첫 번째 방법은 모든 예제의 기여를 합해서 한 번에 갱신하는 것이다. 수렴할 때까지 다음을 반복한다.
\[\theta := \theta + \alpha \sum_{i=1}^{n} \left( y^{(i)} - h_\theta(x^{(i)}) \right) x^{(i)}\]합 안의 양은 원래 비용 함수 \(J\)의 편미분 \(\partial J(\theta) / \partial \theta_j\)에 정확히 대응하므로, 이는 \(J\)에 대한 경사하강법 그 자체다. 매 스텝마다 학습 집합 전체를 보므로 배치 경사하강법(batch gradient descent) 이라 한다.
경사하강법은 일반적으로 국소 최솟값(local minimum)에 빠질 수 있지만, 선형 회귀의 \(J\)는 볼록 이차 함수(convex quadratic function) 여서 전역 최솟값 하나만 있고 다른 국소 최솟값이 없다. 따라서 학습률이 너무 크지 않다면 경사하강법은 항상 전역 최솟값으로 수렴한다. 이차 함수의 등고선은 타원이고, 경사하강법의 궤적은 등고선에 수직인 방향으로 꺾이며 중심으로 다가간다.
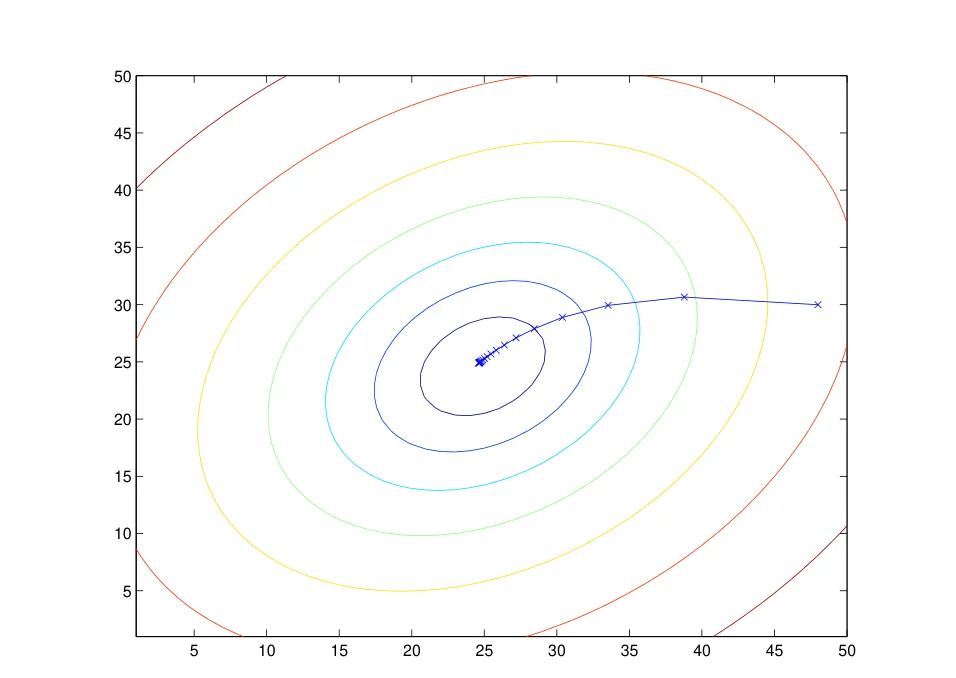 이차 함수의 등고선(타원) 위에서 경사하강법이 움직인 궤적이다. (48, 30)에서 출발한 \(\theta\)가 ×로 표시된 점들을 거쳐 타원의 중심인 최솟값으로 다가간다. 출처: CS229 lecture notes.
그림의 가로축과 세로축은 매개변수 \(\theta\)의 두 성분이고, 각 타원은 \(J(\theta)\)의 값이 같은 점들을 이은 등고선이다. 바깥쪽(빨간색) 타원일수록 \(J\)가 크고, 안쪽(짙은 파란색) 타원으로 갈수록 작아진다. 경사하강법은 오른쪽의 초기값 (48, 30)에서 출발하며, ×는 매 스텝이 끝난 뒤의 \(\theta\), 그 사이의 직선은 한 번의 갱신을 나타낸다.
궤적을 따라가 보면 두 가지가 보인다. 첫째, 각 스텝은 그 지점에서 등고선에 수직인 방향, 즉 \(-\nabla J(\theta)\) 방향으로 움직인다. 그래서 경로가 곧장 중심을 향하지 않고 타원의 모양을 따라 휘어진다. 둘째, 처음 몇 스텝은 길고 중심에 가까워질수록 ×의 간격이 촘촘해진다. 학습률 \(\alpha\)는 고정되어 있지만 그래디언트의 크기가 최솟값 근처에서 0에 가까워지므로 한 스텝의 이동 거리도 자연스럽게 줄어든다. \(J\)가 볼록하므로 어디서 출발하든 같은 중심에 도착한다.
노트의 예에서는 면적만으로 집값을 예측할 때 배치 경사하강법이 \(\theta_0 = 71.27\), \(\theta_1 = 0.1345\)를 찾고, 침실 수까지 넣으면 \(\theta_0 = 89.60\), \(\theta_1 = 0.1392\), \(\theta_2 = -8.738\)을 찾는다.
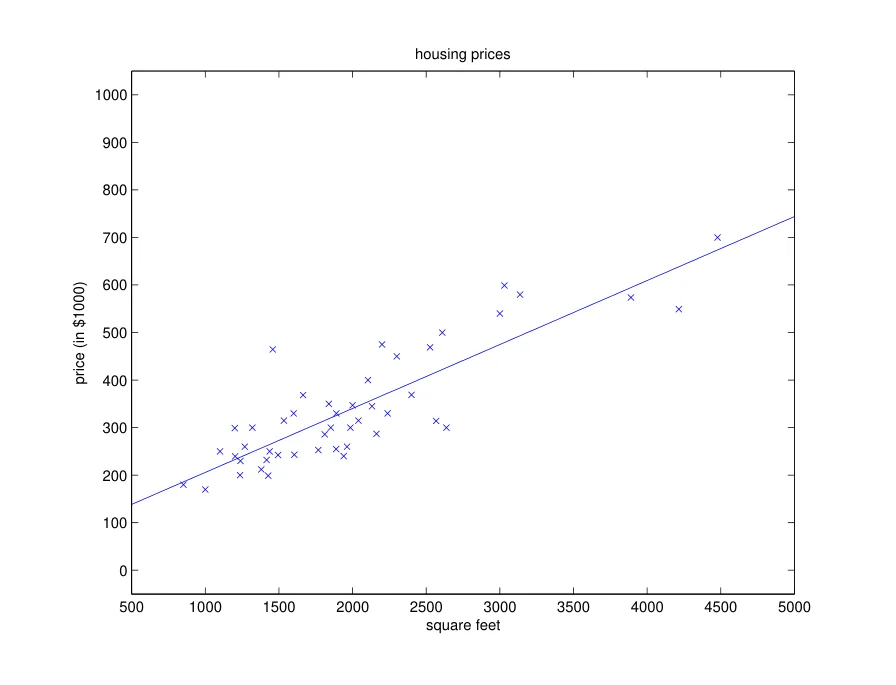 배치 경사하강법으로 찾은 \(h_\theta(x) = 71.27 + 0.1345\,x\)를 학습 데이터 위에 그린 그림이다. 직선이 점들의 띠 한가운데를 지난다. 출처: CS229 lecture notes.
그림에서 직선의 기울기 \(\theta_1 = 0.1345\)는 면적이 1제곱피트 늘 때 예측 가격이 0.1345천 달러, 즉 약 134달러 오른다는 뜻이고, 절편 \(\theta_0 = 71.27\)은 면적 0에 외삽한 값이다. 직선 위아래로 흩어진 점들까지의 세로 거리가 각 예제의 오차 \(h_\theta(x^{(i)}) - y^{(i)}\)이며, 이 직선은 그 제곱의 합 \(J(\theta)\)를 가장 작게 만드는 직선이다. 1500제곱피트 근처에서 가격이 465천 달러로 찍힌 점처럼 직선에서 멀리 떨어진 예제는 제곱 때문에 비용에 크게 반영된다.
확률적 경사하강법
두 번째 방법은 학습 집합을 차례로 훑으면서, 예제 하나를 만날 때마다 그 예제 하나의 오차 그래디언트로 바로 갱신하는 것이다.
\[\text{Loop: for } i = 1 \text{ to } n, \quad \theta := \theta + \alpha \left( y^{(i)} - h_\theta(x^{(i)}) \right) x^{(i)}\]이를 확률적 경사하강법(stochastic gradient descent, SGD) 또는 점진적 경사하강법(incremental gradient descent)이라 한다.
| 배치 경사하강법 | 확률적 경사하강법 | |
|---|---|---|
| 한 스텝에 보는 데이터 | 학습 집합 전체 | 예제 하나 |
| 스텝 하나의 비용 | \(n\)에 비례해 비싸다 | 싸다, 바로 진행을 시작한다 |
| 수렴 | 최솟값으로 수렴 | 최솟값 근처에서 진동할 수 있다 |
SGD는 최솟값으로 정확히 “수렴”하지 않고 \(J(\theta)\)의 최솟값 주변을 맴돌 수 있지만, 실제로는 최솟값 근처의 값들도 충분히 좋은 근사다. 또 학습률 \(\alpha\)를 서서히 0으로 줄이면 진동 대신 전역 최솟값으로 수렴하게 만들 수 있다. SGD는 대개 배치 경사하강법보다 훨씬 빨리 \(\theta\)를 최솟값 “근처”로 데려가므로, 학습 집합이 클 때 특히 선호된다.
정규 방정식
경사하강법은 반복 알고리즘이다. 선형 회귀에서는 미분을 직접 0으로 놓아 \(J\)의 최솟값을 닫힌 형태(closed form) 로 구할 수도 있다. 이를 위해 행렬 미분 표기를 도입한다.
행렬 미분
\(n \times d\) 행렬을 실수로 보내는 함수 \(f : \mathbb{R}^{n \times d} \to \mathbb{R}\)에 대해, \(A\)에 대한 그래디언트는 \((i, j)\) 성분이 \(\partial f / \partial A_{ij}\)인 \(n \times d\) 행렬이다.
\[\nabla_A f(A) = \begin{bmatrix} \frac{\partial f}{\partial A_{11}} & \cdots & \frac{\partial f}{\partial A_{1d}} \\ \vdots & \ddots & \vdots \\ \frac{\partial f}{\partial A_{n1}} & \cdots & \frac{\partial f}{\partial A_{nd}} \end{bmatrix}\]예를 들어 \(2 \times 2\) 행렬 \(A\)에 대해 \(f(A) = \frac{3}{2} A_{11} + 5 A_{12}^2 + A_{21} A_{22}\)이면 다음과 같다.
\[\nabla_A f(A) = \begin{bmatrix} \frac{3}{2} & 10 A_{12} \\ A_{22} & A_{21} \end{bmatrix}\]최소제곱을 행렬로 쓰기
학습 예제의 입력을 행으로 쌓은 설계 행렬(design matrix) \(X\)와 타깃 벡터 \(\vec{y}\)를 정의한다. 절편항을 포함하면 \(X\)는 \(n \times (d+1)\) 행렬이다.
\[X = \begin{bmatrix} \text{---} \; (x^{(1)})^T \; \text{---} \\ \text{---} \; (x^{(2)})^T \; \text{---} \\ \vdots \\ \text{---} \; (x^{(n)})^T \; \text{---} \end{bmatrix}, \qquad \vec{y} = \begin{bmatrix} y^{(1)} \\ y^{(2)} \\ \vdots \\ y^{(n)} \end{bmatrix}\]\(h_\theta(x^{(i)}) = (x^{(i)})^T \theta\)이므로 \(X\theta - \vec{y}\)의 \(i\)번째 성분은 \(h_\theta(x^{(i)}) - y^{(i)}\)다. 벡터 \(z\)에 대해 \(z^T z = \sum_i z_i^2\)이므로 비용 함수는 다음과 같이 쓸 수 있다.
\[J(\theta) = \frac{1}{2} (X\theta - \vec{y})^T (X\theta - \vec{y})\]그래디언트와 닫힌 해
\(a^T b = b^T a\), 그리고 대칭 행렬 \(A\)에 대해 \(\nabla_x b^T x = b\), \(\nabla_x x^T A x = 2Ax\)라는 사실을 쓰면 다음을 얻는다.
\[\begin{aligned} \nabla_\theta J(\theta) &= \frac{1}{2} \nabla_\theta \left( (X\theta)^T X\theta - (X\theta)^T \vec{y} - \vec{y}^T (X\theta) + \vec{y}^T \vec{y} \right) \\ &= \frac{1}{2} \nabla_\theta \left( \theta^T (X^T X) \theta - 2 (X^T \vec{y})^T \theta \right) \\ &= \frac{1}{2} \left( 2 X^T X \theta - 2 X^T \vec{y} \right) \\ &= X^T X \theta - X^T \vec{y} \end{aligned}\]\(\vec{y}^T \vec{y}\)는 \(\theta\)와 무관하므로 둘째 줄에서 사라진다. 그래디언트를 0으로 두면 정규 방정식(normal equations) 을 얻는다.
\[X^T X \theta = X^T \vec{y}\]따라서 \(J(\theta)\)를 최소화하는 \(\theta\)는 다음과 같다.
\[\theta = (X^T X)^{-1} X^T \vec{y}\]이 유도는 \(X^T X\)가 가역이라고 암묵적으로 가정한다. 선형 독립인 예제의 수가 특성 수보다 적거나 특성들이 선형 독립이 아니면 \(X^T X\)는 가역이 아니다. 이 경우에도 추가 기법으로 상황을 “고칠” 수 있지만 노트에서는 다루지 않는다.
정리
- 지도 학습은 학습 집합 \(\{(x^{(i)}, y^{(i)})\}_{i=1}^n\)으로부터 가설 \(h : \mathcal{X} \to \mathcal{Y}\)를 학습한다. 선형 회귀의 가설은 \(h_\theta(x) = \theta^T x\) (\(x_0 = 1\))이다.
- 비용 함수는 최소제곱 \(J(\theta) = \frac{1}{2} \sum_i (h_\theta(x^{(i)}) - y^{(i)})^2\)이다.
- 경사하강법으로 LMS 갱신 규칙 \(\theta_j := \theta_j + \alpha (y^{(i)} - h_\theta(x^{(i)})) x_j^{(i)}\)를 얻는다. 갱신 크기는 오차에 비례한다.
- 배치 경사하강법은 전체 데이터로 한 스텝을 가고, SGD는 예제 하나마다 갱신해 큰 데이터에서 더 빨리 진전한다.
- \(J\)는 볼록 이차 함수라 국소 최솟값이 없으며, 학습률이 적당하면 경사하강법이 전역 최솟값에 수렴한다.
- 그래디언트 \(X^T X\theta - X^T \vec{y}\)를 0으로 두면 정규 방정식을 얻고, 닫힌 해는 \(\theta = (X^T X)^{-1} X^T \vec{y}\)다.