- Stanford CS229 Machine Learning (Spring 2022) 13강 정리
- 강의: Tengyu Ma, Christopher Ré
- ▶ 강의 영상
- 참고: CS229 lecture notes 11장 EM algorithms (11.2–11.5)
출발점: 잠재 변수 모델
12강에서는 가우시안 혼합 모델(mixture of Gaussians, GMM)을 EM으로 학습했다. E-step에서 각 점이 어느 가우시안에서 왔는지를 사후확률 \(w_j^{(i)} = p(z^{(i)} = j \mid x^{(i)}; \phi, \mu, \Sigma)\)로 “부드럽게” 추측하고, M-step에서는 그 추측이 맞다고 보고 매개변수를 갱신했다. 이번 강의는 이 절차가 어디서 나오는지, 그리고 왜 수렴하는지를 일반적인 틀에서 설명한다.
일반적인 설정은 다음과 같다. 서로 독립인 학습 데이터 \(\{x^{(1)}, \dots, x^{(n)}\}\)이 있고, 잠재 변수(latent variable) \(z\)를 포함한 모델 \(p(x, z; \theta)\)를 가정한다. \(z\)는 편의상 유한한 값만 갖는다고 둔다. 관측 변수의 밀도는 \(z\)를 주변화해 얻는다.
\[p(x; \theta) = \sum_z p(x, z; \theta)\]최대화할 로그 우도는 다음과 같다.
\[\ell(\theta) = \sum_{i=1}^n \log p(x^{(i)}; \theta) = \sum_{i=1}^n \log \sum_{z^{(i)}} p(x^{(i)}, z^{(i)}; \theta)\]로그 안에 합이 있어서 이 식을 직접 최대화하면 어려운 비볼록 최적화 문제가 된다. 반면 \(z^{(i)}\)가 관측되었다면 최대우도 추정은 대개 쉽다. EM의 전략은 \(\ell\)의 하한을 반복해서 세우고(E-step), 그 하한을 최대화하는(M-step) 것이다.
젠슨 부등식
\(f\)가 실수 위의 함수일 때 모든 \(x\)에서 \(f''(x) \ge 0\)이면 볼록(convex) 함수다. 벡터 입력이면 헤시안 \(H\)가 양의 준정부호(\(H \succeq 0\))인 조건이 된다. \(f''(x) > 0\)(또는 \(H \succ 0\))이면 강볼록(strictly convex)이다.
젠슨 부등식(Jensen’s inequality). \(f\)가 볼록 함수이고 \(X\)가 확률변수이면 다음이 성립한다.
\[\mathbb{E}[f(X)] \ge f(\mathbb{E}[X])\]또한 \(f\)가 강볼록이면 등호는 \(X = \mathbb{E}[X]\)가 확률 1로 성립할 때, 즉 \(X\)가 상수일 때에만 성립한다.
\(X\)가 두 값 \(a\), \(b\)를 각각 확률 0.5로 갖는 경우를 그려 보면 기억하기 쉽다. \(\mathbb{E}[X]\)는 \(a\)와 \(b\)의 중점이고, \(\mathbb{E}[f(X)]\)는 \(f(a)\)와 \(f(b)\)의 중점이다. 볼록 함수의 현(chord)은 그래프 위에 있으므로 \(\mathbb{E}[f(X)]\)가 \(f(\mathbb{E}[X])\)보다 크다.
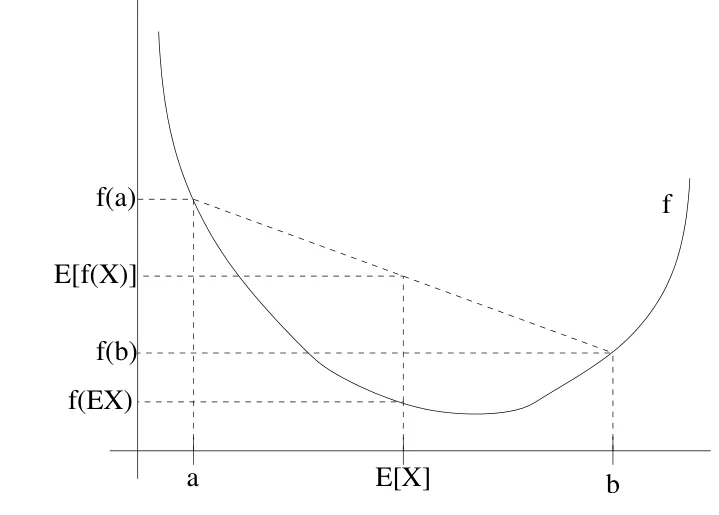 볼록 함수 \(f\)(실선)와 \(a\), \(b\)를 각각 확률 0.5로 갖는 \(X\)에 대한 젠슨 부등식. 현의 중점 높이 \(\mathbb{E}[f(X)]\)가 곡선 위의 값 \(f(\mathbb{E}X)\)보다 위에 있다. 출처: CS229 lecture notes.
그림을 가로축부터 읽는다. 가로축의 \(a\)와 \(b\)가 \(X\)가 가질 수 있는 두 값이고, 그 한가운데의 \(\mathbb{E}[X]\)가 평균이다. 세로축에는 네 높이가 표시되어 있다. \(f(a)\)와 \(f(b)\)는 두 점에서의 함수값이고, 이 두 점을 잇는 점선(현)의 한가운데 높이가 두 값의 평균 \(\mathbb{E}[f(X)]\)다. 한편 \(\mathbb{E}[X]\)에서 곡선까지 올라간 높이가 \(f(\mathbb{E}X)\)다.
\(f\)가 볼록이면 곡선은 두 점 사이에서 항상 현의 아래에 놓이므로, 같은 가로 위치 \(\mathbb{E}[X]\)에서 현의 높이 \(\mathbb{E}[f(X)]\)가 곡선의 높이 \(f(\mathbb{E}X)\)보다 크거나 같다. 두 높이의 차이는 \(a\)와 \(b\)가 멀수록, 곡선이 많이 휠수록 커진다. 반대로 \(a = b\)이면(즉 \(X\)가 상수이면) 현이 한 점으로 줄어 두 높이가 같아지는데, 이것이 등호 조건이다. EM에서는 이 등호 조건을 이용해 하한을 현재 매개변수에서 빈틈없이 만든다.
\(f\)가 오목(concave)이면, 즉 \(-f\)가 볼록이면 부등호 방향이 모두 뒤집힌다. EM에서 쓰는 것은 오목 함수 \(\log\)에 대한 \(\mathbb{E}[\log X] \le \log \mathbb{E}[X]\)이다.
일반적인 EM 알고리즘
데이터 하나에 대한 하한
합 \(\sum_i\)는 본질적이지 않으므로 먼저 데이터 하나 \(x\)에 대한 \(\log p(x; \theta)\)를 생각한다. \(Q\)를 \(z\) 위의 임의의 분포라 하자(\(\sum_z Q(z) = 1\), \(Q(z) \ge 0\)). 그러면 다음이 성립한다.
\[\log p(x; \theta) = \log \sum_z Q(z) \frac{p(x, z; \theta)}{Q(z)} \ge \sum_z Q(z) \log \frac{p(x, z; \theta)}{Q(z)}\]가운데 식의 합은 \(z \sim Q\)에 대한 \(p(x, z; \theta) / Q(z)\)의 기댓값이다. \(\log\)는 오목하므로(\(f''(x) = -1/x^2 < 0\)) 젠슨 부등식에 의해 \(\log \mathbb{E}_{z \sim Q}[\cdot] \ge \mathbb{E}_{z \sim Q}[\log (\cdot)]\)이고, 이것이 마지막 부등호다. 이 우변을 증거 하한(evidence lower bound, ELBO) 이라 부른다.
\[\mathrm{ELBO}(x; Q, \theta) = \sum_z Q(z) \log \frac{p(x, z; \theta)}{Q(z)}\]즉 모든 \(Q\), \(\theta\), \(x\)에 대해 \(\log p(x; \theta) \ge \mathrm{ELBO}(x; Q, \theta)\)이다.
하한을 빈틈없이 만드는 Q
\(Q\)를 어떻게 고를까? 현재 매개변수 \(\theta\)에서 하한이 등호로 성립하도록 고르는 것이 자연스럽다. 젠슨 부등식에서 등호가 성립하려면 기댓값을 취하는 대상이 상수이면 충분하다.
\[\frac{p(x, z; \theta)}{Q(z)} = c \quad (z\text{와 무관한 상수})\]즉 \(Q(z) \propto p(x, z; \theta)\)이고, \(\sum_z Q(z) = 1\)로 정규화하면 다음을 얻는다.
\[Q(z) = \frac{p(x, z; \theta)}{\sum_z p(x, z; \theta)} = \frac{p(x, z; \theta)}{p(x; \theta)} = p(z \mid x; \theta)\]\(Q\)를 현재 \(\theta\)에서의 \(z\)의 사후분포로 두면 된다. 실제로 대입해 보면 등호가 확인된다.
\[\sum_z p(z \mid x; \theta) \log \frac{p(z \mid x; \theta)\, p(x; \theta)}{p(z \mid x; \theta)} = \log p(x; \theta) \sum_z p(z \mid x; \theta) = \log p(x; \theta)\]여러 데이터와 알고리즘
최적의 \(Q\)는 데이터마다 다르므로 데이터마다 분포 \(Q_1, \dots, Q_n\)을 둔다. 각 데이터의 하한을 더하면 로그 우도 전체의 하한이 된다.
\[\ell(\theta) \ge \sum_{i=1}^n \mathrm{ELBO}(x^{(i)}; Q_i, \theta) = \sum_i \sum_{z^{(i)}} Q_i(z^{(i)}) \log \frac{p(x^{(i)}, z^{(i)}; \theta)}{Q_i(z^{(i)})}\]이 하한은 어떤 \(Q_i\)들에 대해서도 성립하고, \(Q_i(z^{(i)}) = p(z^{(i)} \mid x^{(i)}; \theta)\)일 때 등호가 된다. EM 알고리즘은 수렴할 때까지 다음을 반복한다.
- E-step. 각 \(i\)에 대해 \(Q_i(z^{(i)}) := p(z^{(i)} \mid x^{(i)}; \theta)\)로 둔다.
- M-step. 하한을 \(\theta\)에 대해 최대화한다.
단조 수렴
연속한 두 반복의 매개변수를 \(\theta^{(t)}\), \(\theta^{(t+1)}\)이라 하자. \(\theta^{(t)}\)에서 시작한 반복의 E-step은 \(Q_i^{(t)}(z^{(i)}) = p(z^{(i)} \mid x^{(i)}; \theta^{(t)})\)를 고르므로 하한이 빈틈없다.
\[\ell(\theta^{(t)}) = \sum_{i=1}^n \mathrm{ELBO}(x^{(i)}; Q_i^{(t)}, \theta^{(t)})\]그러면 다음 부등식이 이어진다.
\[\ell(\theta^{(t+1)}) \ge \sum_{i=1}^n \mathrm{ELBO}(x^{(i)}; Q_i^{(t)}, \theta^{(t+1)}) \ge \sum_{i=1}^n \mathrm{ELBO}(x^{(i)}; Q_i^{(t)}, \theta^{(t)}) = \ell(\theta^{(t)})\]첫 부등호는 하한이 모든 \(Q\)와 \(\theta\)에 대해 성립하기 때문이고, 둘째 부등호는 \(\theta^{(t+1)}\)이 바로 그 하한을 최대화하도록 골라졌기 때문이다. 따라서 EM은 로그 우도를 단조 증가시킨다. 실용적인 수렴 판정으로는 한 번의 반복에서 \(\ell(\theta)\)의 증가량이 허용치보다 작아지면 멈추는 방법이 있다.
단, 단조 증가가 전역 최적점으로의 수렴을 뜻하지는 않는다. GMM에서도 데이터에 따라 전역 최적점에 수렴하기도 하고 국소 해에 갇히기도 한다. 그래서 여러 초기값에서 다시 시작해 보는 것이 좋다.
좌표 상승으로 보기
\(\mathrm{ELBO}(Q, \theta) = \sum_i \mathrm{ELBO}(x^{(i)}; Q_i, \theta)\)로 정의하면 \(\ell(\theta) \ge \mathrm{ELBO}(Q, \theta)\)이다. EM은 이 함수를 번갈아 최대화하는 알고리즘으로 볼 수 있다. E-step은 \(Q\)에 대해, M-step은 \(\theta\)에 대해 \(\mathrm{ELBO}\)를 최대화한다.
ELBO의 다른 형태
ELBO는 두 가지 형태로 다시 쓸 수 있다. 첫째는 다음과 같다.
\[\mathrm{ELBO}(x; Q, \theta) = \mathbb{E}_{z \sim Q}[\log p(x \mid z; \theta)] - D_{KL}(Q \,\Vert\, p_z)\]여기서 \(p_z\)는 \(z\)의 주변분포이고, KL 발산은 \(D_{KL}(Q \,\Vert\, p_z) = \sum_z Q(z) \log \frac{Q(z)}{p(z)}\)이다. \(z\)의 주변분포가 \(\theta\)에 의존하지 않는 경우가 많은데, 이때 \(\theta\)에 대한 ELBO 최대화는 첫째 항, 즉 \(z\)가 주어졌을 때 \(x\)의 조건부 우도를 최대화하는 것과 같다. 이는 원래 문제보다 쉬운 경우가 많다.
둘째는 다음과 같다.
\[\mathrm{ELBO}(x; Q, \theta) = \log p(x) - D_{KL}(Q \,\Vert\, p_{z \mid x})\]KL 발산은 0 이상이고 두 분포가 같을 때만 0이므로, \(Q\)에 대한 최대화의 해가 \(Q = p_{z \mid x}\)라는 사실이 이 형태에서 바로 보인다. 하한과 로그 우도의 차이가 정확히 이 KL 발산이다.
GMM 다시 보기
일반 EM을 GMM에 적용해 12강의 갱신식을 유도한다. 모델은 \(z^{(i)} \sim \mathrm{Multinomial}(\phi)\), \(x^{(i)} \mid z^{(i)} = j \sim \mathcal{N}(\mu_j, \Sigma_j)\)이다.
E-step은 사후확률을 계산하는 것이다.
\[w_j^{(i)} = Q_i(z^{(i)} = j) = P(z^{(i)} = j \mid x^{(i)}; \phi, \mu, \Sigma)\]M-step에서 최대화할 양은 다음과 같다.
\[\sum_{i=1}^n \sum_{j=1}^k w_j^{(i)} \log \frac{\frac{1}{(2\pi)^{d/2} \lvert \Sigma_j \rvert^{1/2}} \exp\left( -\frac{1}{2} (x^{(i)} - \mu_j)^T \Sigma_j^{-1} (x^{(i)} - \mu_j) \right) \cdot \phi_j}{w_j^{(i)}}\]평균의 갱신
\(\mu_l\)에 대해 미분하면 \(\mu_l\)을 포함한 이차형식 항만 남는다.
\[\nabla_{\mu_l} \left( -\sum_{i=1}^n \sum_{j=1}^k w_j^{(i)} \frac{1}{2} (x^{(i)} - \mu_j)^T \Sigma_j^{-1} (x^{(i)} - \mu_j) \right) = \sum_{i=1}^n w_l^{(i)} \left( \Sigma_l^{-1} x^{(i)} - \Sigma_l^{-1} \mu_l \right)\]이를 0으로 두고 풀면 12강의 갱신식이 나온다.
\[\mu_l := \frac{\sum_{i=1}^n w_l^{(i)} x^{(i)}}{\sum_{i=1}^n w_l^{(i)}}\]혼합 비율의 갱신
\(\phi_j\)에 의존하는 항은 \(\sum_i \sum_j w_j^{(i)} \log \phi_j\)뿐이다. 그런데 \(\phi_j\)는 확률이므로 \(\sum_j \phi_j = 1\)이라는 제약이 있다. 라그랑지안(Lagrangian)을 세운다.
\[\mathcal{L}(\phi) = \sum_{i=1}^n \sum_{j=1}^k w_j^{(i)} \log \phi_j + \beta \left( \sum_{j=1}^k \phi_j - 1 \right)\]미분해서 0으로 두면 \(\sum_i w_j^{(i)} / \phi_j + \beta = 0\), 즉 \(\phi_j = \sum_i w_j^{(i)} / (-\beta)\)이다. 제약 \(\sum_j \phi_j = 1\)과 \(\sum_j w_j^{(i)} = 1\)을 쓰면 \(-\beta = \sum_i \sum_j w_j^{(i)} = n\)이므로 다음을 얻는다.
\[\phi_j := \frac{1}{n} \sum_{i=1}^n w_j^{(i)}\]\(\phi_j \ge 0\) 제약은 따로 다루지 않아도 이 해가 자동으로 만족한다. \(\Sigma_j\)의 갱신도 같은 방식으로 유도되며, 결과는 가중 표본 공분산 \(\Sigma_j := \sum_i w_j^{(i)} (x^{(i)} - \mu_j)(x^{(i)} - \mu_j)^T / \sum_i w_j^{(i)}\)이다.
확장: 변분 추론과 VAE
사후분포를 계산할 수 없을 때
GMM에서는 E-step의 사후분포 \(p(z \mid x; \theta)\)를 해석적으로 계산할 수 있었다. 더 복잡한 모델에서는 그렇지 않다. 예를 들어 신경망 \(g(z; \theta): \mathbb{R}^k \to \mathbb{R}^d\)로 다음 모델을 정의해 보자.
\[z \sim \mathcal{N}(0, I_{k \times k}), \qquad x \mid z \sim \mathcal{N}(g(z; \theta), \sigma^2 I_{d \times d})\]여기서 \(\sigma\)는 알려진 상수라 둔다. 이 모델의 정확한 사후분포는 계산할 수 없다. 그러나 ELBO는 어떤 \(Q\)에 대해서도 하한이므로, 다루기 쉬운 분포족 \(\mathcal{Q}\) 안에서 사후분포를 근사하는 \(Q\)를 찾으면 된다. 이것이 변분 추론(variational inference) 이다.
\[\max_{Q \in \mathcal{Q}} \max_\theta \mathrm{ELBO}(Q, \theta)\]\(z\)가 고차원 이산 변수일 때 흔한 가정은 좌표들이 서로 독립이라는 평균장 가정(mean field assumption), \(Q_i(z) = Q_i^1(z_1) \cdots Q_i^k(z_k)\)이다.
인코더로 Q를 매개변수화하기
\(z \in \mathbb{R}^k\)가 연속이면 \(Q_i\)를 간결하게 표현해야 한다. 변분 오토인코더(variational auto-encoder, VAE) 는 \(Q_i\)를 좌표가 독립인 가우시안으로 두고, 그 평균과 표준편차를 \(x^{(i)}\)의 함수로 만든다.
\[Q_i = \mathcal{N}\left( q(x^{(i)}; \phi),\ \mathrm{diag}(v(x^{(i)}; \psi))^2 \right)\]\(q\)와 \(v\)는 보통 신경망이며 인코더(encoder) 라 부르고, \(g(z; \theta)\)는 디코더(decoder) 라 부른다. 이런 \(Q_i\)는 참 사후분포와 거리가 멀 수 있지만, 밀도를 계산할 수 있고 표본을 뽑을 수 있어서 ELBO를 평가할 수 있다.
경사 상승과 재매개변수화
ELBO를 각 변수에 대해 정확히 최대화하는 대신 \(\phi, \psi, \theta\) 모두에 대해 경사 상승(gradient ascent)을 한다. \(\theta\)에 대한 그래디언트는 쉽다. 샘플링 분포 \(Q_i\)가 \(\theta\)에 의존하지 않으므로 기댓값 안으로 미분을 넣을 수 있다.
\[\nabla_\theta \mathrm{ELBO} = \sum_{i=1}^n \mathbb{E}_{z^{(i)} \sim Q_i}\left[ \nabla_\theta \log p(x^{(i)}, z^{(i)}; \theta) \right]\]반면 \(\phi\)와 \(\psi\)에 대해서는 샘플링 분포 자체가 이들에 의존하므로 미분을 기댓값 안으로 그냥 넣을 수 없다. 해결책이 재매개변수화 트릭(re-parameterization trick) 이다. \(x \sim \mathcal{N}(\mu, \sigma^2)\)가 \(x = \mu + \xi \sigma\), \(\xi \sim \mathcal{N}(0, 1)\)과 같다는 사실을 각 차원에 적용한다.
\[z^{(i)} = q(x^{(i)}; \phi) + v(x^{(i)}; \psi) \odot \xi^{(i)}, \qquad \xi^{(i)} \sim \mathcal{N}(0, I_{k \times k})\]이제 기댓값은 \(\phi, \psi\)와 무관한 \(\xi^{(i)}\)에 대한 것이 되므로 미분을 안으로 넣을 수 있고, \(\xi^{(i)}\)를 몇 개(실제로는 하나만 쓰기도 한다) 뽑아 그래디언트를 추정한다. 밀도를 해석적으로 계산할 수 있으면서 이렇게 재매개변수화할 수 있는 고차원 분포는 많지 않다.
정리
- 잠재 변수 모델의 로그 우도 \(\sum_i \log \sum_z p(x^{(i)}, z; \theta)\)는 직접 최대화하기 어렵다. EM은 하한을 세우고(E-step) 그 하한을 최대화하는(M-step) 과정을 반복한다.
- 오목 함수 \(\log\)에 젠슨 부등식을 적용하면 임의의 분포 \(Q\)에 대해 \(\log p(x; \theta) \ge \mathrm{ELBO}(x; Q, \theta) = \sum_z Q(z) \log \frac{p(x, z; \theta)}{Q(z)}\)를 얻는다.
- \(Q(z) = p(z \mid x; \theta)\)이면 하한이 등호가 된다. 이것이 E-step이다.
- 하한이 현재 \(\theta\)에서 빈틈없고 M-step이 하한을 키우므로 \(\ell(\theta^{(t+1)}) \ge \ell(\theta^{(t)})\), 즉 EM은 로그 우도를 단조 증가시킨다. 다만 전역 최적점은 보장하지 않는다.
- EM은 \(\mathrm{ELBO}(Q, \theta)\)에 대한 좌표 상승이며, \(\mathrm{ELBO} = \log p(x) - D_{KL}(Q \,\Vert\, p_{z \mid x})\)로 쓸 수 있다.
- GMM의 M-step을 유도하면 \(\mu_l\)은 가중 평균, \(\phi_j\)는 라그랑지안으로 얻는 \(\frac{1}{n} \sum_i w_j^{(i)}\)가 된다.
- 사후분포를 계산할 수 없으면 분포족 안에서 \(Q\)를 근사한다(변분 추론). VAE는 가우시안 \(Q\)를 인코더로 매개변수화하고 재매개변수화 트릭으로 ELBO를 경사 상승한다.