- Stanford CS229 Machine Learning (Spring 2022) 5강 정리
- 강의: Tengyu Ma, Christopher Ré
- ▶ 강의 영상
- 참고: CS229 lecture notes Chapter 4 (4.1 Gaussian discriminant analysis, 4.2 Naive Bayes)
판별 모델과 생성 모델
두 가지 접근
코끼리(\(y = 1\))와 개(\(y = 0\))를 동물의 특성으로 구분하는 문제를 생각한다. 로지스틱 회귀나 퍼셉트론은 학습 집합에서 코끼리와 개를 가르는 직선, 즉 결정 경계(decision boundary) 를 찾고, 새 동물이 경계의 어느 쪽에 있는지 보고 분류한다.
다른 접근도 있다. 먼저 코끼리들을 보고 코끼리가 어떻게 생겼는지에 대한 모델을 만들고, 개들을 보고 개에 대한 별도의 모델을 만든다. 새 동물이 오면 두 모델과 각각 비교해서 학습 집합의 코끼리와 개 중 어느 쪽과 더 닮았는지 판단한다.
- 판별 학습 알고리즘(discriminative learning algorithm): \(p(y \mid x)\)를 직접 학습하거나(로지스틱 회귀), 입력 공간에서 레이블로 가는 사상을 직접 학습한다(퍼셉트론).
- 생성 학습 알고리즘(generative learning algorithm): \(p(x \mid y)\)와 \(p(y)\)를 모델링한다. 예를 들어 \(p(x \mid y = 0)\)은 개의 특성 분포, \(p(x \mid y = 1)\)은 코끼리의 특성 분포다.
베이즈 규칙
\(p(y)\)를 클래스 사전 확률(class prior) 이라 한다. \(p(y)\)와 \(p(x \mid y)\)를 모델링하고 나면 베이즈 규칙(Bayes rule) 으로 사후 분포를 얻는다.
\[p(y \mid x) = \frac{p(x \mid y) p(y)}{p(x)}, \qquad p(x) = p(x \mid y = 1) p(y = 1) + p(x \mid y = 0) p(y = 0)\]예측만 할 때는 분모가 \(y\)와 무관하므로 계산할 필요가 없다.
\[\arg\max_y p(y \mid x) = \arg\max_y \frac{p(x \mid y) p(y)}{p(x)} = \arg\max_y p(x \mid y) p(y)\]다변량 정규분포
정의
첫 번째 생성 학습 알고리즘인 가우시안 판별 분석(Gaussian discriminant analysis, GDA) 은 \(p(x \mid y)\)를 다변량 정규분포로 가정한다. \(d\)차원 다변량 정규분포(multivariate normal distribution) 는 평균 벡터 \(\mu \in \mathbb{R}^d\)와 대칭 양의 준정부호(positive semi-definite) 공분산 행렬 \(\Sigma \in \mathbb{R}^{d \times d}\)로 정해지며, \(\mathcal{N}(\mu, \Sigma)\)로 쓴다. 밀도는 다음과 같다.
\[p(x; \mu, \Sigma) = \frac{1}{(2\pi)^{d/2} \lvert \Sigma \rvert^{1/2}} \exp\left( -\frac{1}{2} (x - \mu)^T \Sigma^{-1} (x - \mu) \right)\]\(\lvert \Sigma \rvert\)는 행렬식이다. \(X \sim \mathcal{N}(\mu, \Sigma)\)이면 평균은 \(\mathbb{E}[X] = \mu\)다. 벡터 확률 변수 \(Z\)의 공분산은 분산의 일반화로 다음과 같이 정의하며, 두 정의는 동치다.
\[\text{Cov}(Z) = \mathbb{E}\left[ (Z - \mathbb{E}[Z])(Z - \mathbb{E}[Z])^T \right] = \mathbb{E}[Z Z^T] - (\mathbb{E}[Z])(\mathbb{E}[Z])^T\]\(X \sim \mathcal{N}(\mu, \Sigma)\)이면 \(\text{Cov}(X) = \Sigma\)다.
매개변수에 따른 모양
노트는 2차원 예시로 매개변수의 효과를 보여 준다.
- 평균 0, \(\Sigma = I\)인 경우를 표준 정규분포(standard normal distribution) 라 한다. \(\Sigma = 0.6I\)처럼 공분산이 작아지면 분포가 “압축”되고, \(\Sigma = 2I\)처럼 커지면 “퍼진다”.
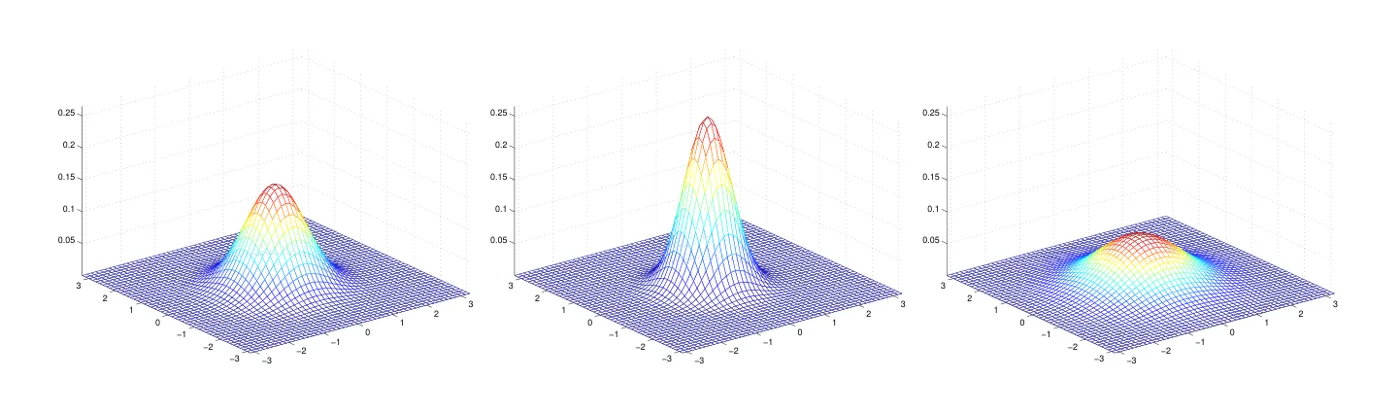 평균이 0인 2차원 가우시안 밀도를 3차원 곡면으로 그린 그림이다. 왼쪽부터 \(\Sigma = I\), \(0.6I\), \(2I\)이며, 공분산이 작을수록 봉우리가 높고 좁다. 출처: CS229 lecture notes.
밑면의 두 축은 \(x_1\), \(x_2\)이고 높이는 밀도 \(p(x; \mu, \Sigma)\)다. 세 곡면 아래의 부피는 모두 1이므로, 가운데 그림처럼 확률 질량이 원점 근처에 몰리면 봉우리가 높아지고, 오른쪽 그림처럼 넓게 퍼지면 봉우리가 낮고 평평해진다. 밀도 식의 정규화 상수 \(1/\lvert \Sigma \rvert^{1/2}\)이 바로 이 높이 차이를 만든다. \(\Sigma\)가 단위 행렬의 배수이면 어느 방향으로 보아도 퍼진 정도가 같아 봉우리가 원형으로 대칭이다.
- 비대각 성분을 키우면(\(\Sigma = \begin{bmatrix} 1 & 0.5 \\ 0.5 & 1 \end{bmatrix}\), \(\begin{bmatrix} 1 & 0.8 \\ 0.8 & 1 \end{bmatrix}\)) 밀도가 45도 직선 \(x_1 = x_2\) 쪽으로 압축된다. 비대각 성분을 음수로 하면 반대 방향으로 압축된다.
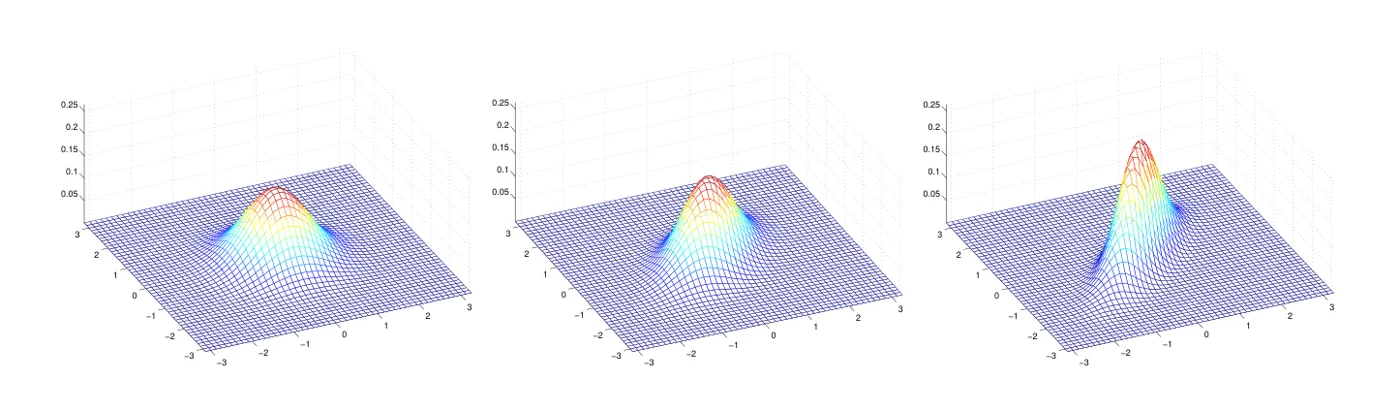 비대각 성분이 0, 0.5, 0.8인 공분산 행렬의 가우시안 밀도다(대각 성분은 1). 비대각 성분이 커질수록 봉우리가 한 대각선 방향으로 길고 얇아진다. 출처: CS229 lecture notes.
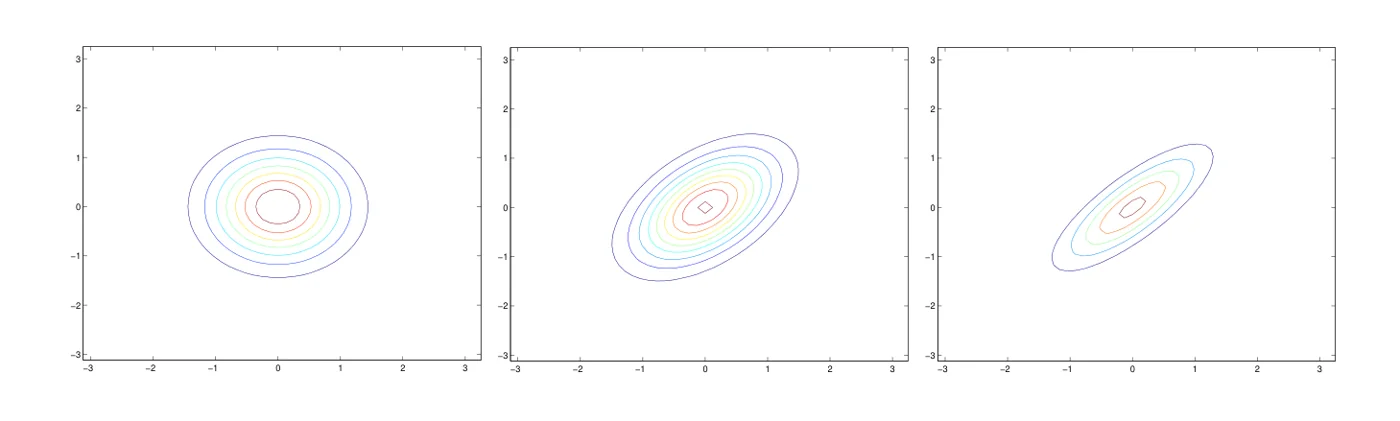 위 세 밀도를 위에서 내려다본 등고선이다. 원(왼쪽)이 \(x_1 = x_2\) 방향으로 기울어진 타원(가운데)으로, 다시 더 납작한 타원(오른쪽)으로 바뀐다. 출처: CS229 lecture notes.
3차원 곡면만으로는 방향을 읽기 어렵기 때문에 노트는 같은 분포를 등고선으로도 보여 준다. 비대각 성분 \(\Sigma_{12}\)는 \(x_1\)과 \(x_2\)의 공분산이다. 양수이면 \(x_1\)이 클 때 \(x_2\)도 큰 경향이 있으므로 확률 질량이 1사분면과 3사분면을 잇는 45도 직선을 따라 늘어선다. 그 결과 등고선이 이 직선 방향으로 길쭉한 타원이 되고, 직선에 수직인 방향으로는 좁아진다. 비대각 성분이 0.8까지 커지면 두 좌표의 상관이 강해져 타원이 훨씬 납작해진다. 기하학적으로 타원의 축 방향은 \(\Sigma\)의 고유벡터, 축의 길이는 고유값의 제곱근에 비례한다.
- 일반적으로 등고선은 타원이다(\(\Sigma = \begin{bmatrix} 3 & 0.8 \\ 0.8 & 1 \end{bmatrix}\)).
- \(\Sigma = I\)로 고정하고 \(\mu\)를 바꾸면 밀도의 중심이 이동한다.
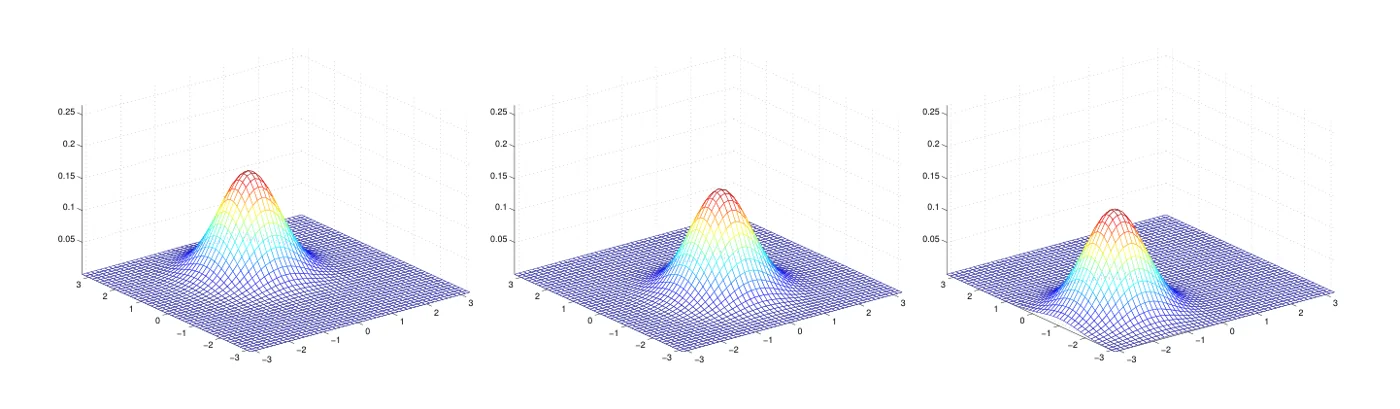 \(\Sigma = I\)로 두고 평균만 \(\mu = (1, 0)\), \((-0.5, 0)\), \((-1, -1.5)\)로 바꾼 가우시안이다. 봉우리의 모양은 그대로이고 위치만 옮겨진다. 출처: CS229 lecture notes.
세 곡면은 모양과 높이가 모두 같고, 봉우리가 놓인 자리만 다르다. 즉 \(\mu\)는 분포의 위치를, \(\Sigma\)는 모양(퍼짐과 방향)을 정한다. GDA는 이 두 역할을 나누어 쓴다. 클래스마다 다른 \(\mu_0\), \(\mu_1\)로 위치를 달리하고, 모양은 공유하는 \(\Sigma\) 하나로 정한다.
가우시안 판별 분석
모델
입력 특성 \(x\)가 연속값인 분류 문제에서 GDA는 다음 모델을 쓴다.
\[y \sim \text{Bernoulli}(\phi), \qquad x \mid y = 0 \sim \mathcal{N}(\mu_0, \Sigma), \qquad x \mid y = 1 \sim \mathcal{N}(\mu_1, \Sigma)\]분포를 풀어 쓰면 다음과 같다.
\[\begin{aligned} p(y) &= \phi^y (1 - \phi)^{1-y} \\ p(x \mid y = 0) &= \frac{1}{(2\pi)^{d/2} \lvert \Sigma \rvert^{1/2}} \exp\left( -\frac{1}{2} (x - \mu_0)^T \Sigma^{-1} (x - \mu_0) \right) \\ p(x \mid y = 1) &= \frac{1}{(2\pi)^{d/2} \lvert \Sigma \rvert^{1/2}} \exp\left( -\frac{1}{2} (x - \mu_1)^T \Sigma^{-1} (x - \mu_1) \right) \end{aligned}\]매개변수는 \(\phi\), \(\Sigma\), \(\mu_0\), \(\mu_1\)이다. 평균 벡터는 클래스마다 따로 두지만 공분산 행렬 \(\Sigma\)는 보통 하나를 공유한다.
최대우도 추정
판별 모델은 조건부 우도 \(\prod_i p(y^{(i)} \mid x^{(i)})\)를 최대화했지만, 생성 모델은 결합 우도(joint likelihood)를 최대화한다.
\[\ell(\phi, \mu_0, \mu_1, \Sigma) = \log \prod_{i=1}^{n} p(x^{(i)}, y^{(i)}; \phi, \mu_0, \mu_1, \Sigma) = \log \prod_{i=1}^{n} p(x^{(i)} \mid y^{(i)}; \mu_0, \mu_1, \Sigma) \, p(y^{(i)}; \phi)\]예를 들어 \(\phi\)가 들어 있는 항은 \(\sum_i \left( y^{(i)} \log \phi + (1 - y^{(i)}) \log(1 - \phi) \right)\)뿐이므로, \(\phi\)로 미분해 0으로 두면 \(\phi\)는 \(y^{(i)} = 1\)인 예제의 비율이 된다. \(\mu_0\), \(\mu_1\), \(\Sigma\)도 같은 방식으로 미분해 0으로 두면 최대우도 추정값을 얻는다.
\[\begin{aligned} \phi &= \frac{1}{n} \sum_{i=1}^{n} 1\{y^{(i)} = 1\} \\ \mu_0 &= \frac{\sum_{i=1}^{n} 1\{y^{(i)} = 0\} x^{(i)}}{\sum_{i=1}^{n} 1\{y^{(i)} = 0\}} \\ \mu_1 &= \frac{\sum_{i=1}^{n} 1\{y^{(i)} = 1\} x^{(i)}}{\sum_{i=1}^{n} 1\{y^{(i)} = 1\}} \\ \Sigma &= \frac{1}{n} \sum_{i=1}^{n} (x^{(i)} - \mu_{y^{(i)}})(x^{(i)} - \mu_{y^{(i)}})^T \end{aligned}\]해석은 직관적이다. \(\phi\)는 양성 예제의 비율, \(\mu_0\)과 \(\mu_1\)은 각 클래스 예제의 평균, \(\Sigma\)는 각 예제를 자기 클래스 평균에서 뺀 뒤 구한 공분산이다.
결정 경계
학습된 두 가우시안은 공분산을 공유하므로 등고선의 모양과 방향은 같고 중심만 \(\mu_0\), \(\mu_1\)로 다르다. \(p(y = 1 \mid x) = 0.5\)가 되는 점들이 결정 경계이며, 이 경우 경계는 직선(초평면) 이다. 경계의 한쪽에서는 \(y = 1\), 다른 쪽에서는 \(y = 0\)으로 예측한다.
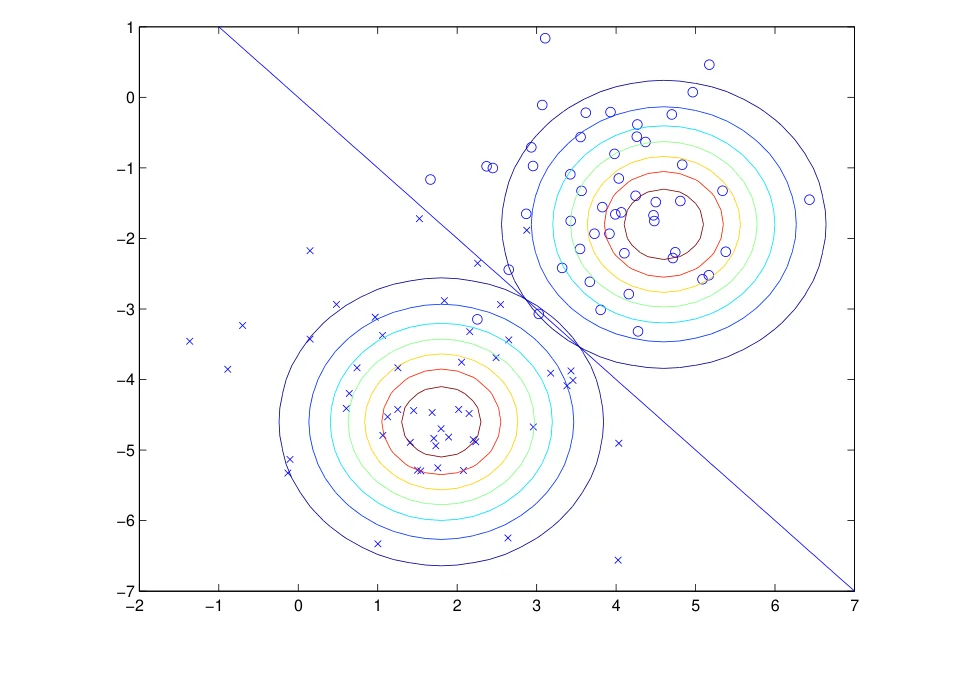 GDA를 학습 데이터에 맞춘 결과다. ×와 ○는 두 클래스의 학습 예제, 동심 타원은 각 클래스에 맞춘 가우시안의 등고선, 대각선은 \(p(y = 1 \mid x) = 0.5\)인 결정 경계다. 출처: CS229 lecture notes.
그림에서 왼쪽 아래의 × 무리와 오른쪽 위의 ○ 무리가 두 클래스다. 동심 타원들의 중심이 각 클래스 예제의 평균, 즉 최대우도 추정값 \(\mu_0\)과 \(\mu_1\)이다. 두 타원 묶음은 같은 \(\Sigma\)를 쓰기 때문에 크기, 모양, 기울기가 똑같고 중심만 다르다.
결정 경계는 두 평균을 잇는 선분을 가로지르는 직선이다. 경계 위의 점에서는 두 클래스의 (사전 확률을 곱한) 밀도가 같고, 경계를 넘어 한쪽 평균에 가까워질수록 그 클래스의 사후 확률이 커진다. 경계 근처에는 반대편 클래스의 예제도 몇 개 섞여 있는데, 두 가우시안이 겹치는 영역에서는 어떤 직선 경계로도 모든 예제를 맞힐 수 없기 때문이다. 공분산을 공유하면 경계가 직선이 된다는 사실은 아래에서 사후 확률이 로지스틱 함수 꼴이라는 것으로 확인한다.
GDA와 로지스틱 회귀
GDA의 사후 확률은 로지스틱 함수다
\(p(y = 1 \mid x; \phi, \mu_0, \mu_1, \Sigma)\)를 \(x\)의 함수로 보면 다음 꼴로 쓸 수 있다.
\[p(y = 1 \mid x; \phi, \Sigma, \mu_0, \mu_1) = \frac{1}{1 + \exp(-\theta^T x)}\]여기서 \(\theta\)는 \(\phi, \Sigma, \mu_0, \mu_1\)의 적당한 함수이고, \(x\)에는 \(x_0 = 1\)을 덧붙였다. 확인해 보자. 베이즈 규칙으로 다음이 성립한다.
\[p(y = 1 \mid x) = \frac{1}{1 + \frac{p(x \mid y = 0) p(y = 0)}{p(x \mid y = 1) p(y = 1)}}\]분모의 비에 로그를 취하면, 공분산이 같으므로 정규화 상수와 이차항 \(x^T \Sigma^{-1} x\)가 상쇄된다.
\[\log \frac{p(x \mid y = 1) p(y = 1)}{p(x \mid y = 0) p(y = 0)} = (\mu_1 - \mu_0)^T \Sigma^{-1} x - \frac{1}{2} \mu_1^T \Sigma^{-1} \mu_1 + \frac{1}{2} \mu_0^T \Sigma^{-1} \mu_0 + \log \frac{\phi}{1 - \phi}\]이는 \(x\)에 대한 일차식이다. 따라서 \(x\)의 계수를 \(\Sigma^{-1}(\mu_1 - \mu_0)\), 절편을 나머지 상수항으로 두면 정확히 로지스틱 회귀의 형태가 된다. 결정 경계가 직선인 이유도 여기에 있다.
어느 쪽을 쓸 것인가
같은 데이터로 학습해도 GDA와 로지스틱 회귀는 일반적으로 다른 결정 경계를 준다. 핵심은 가정의 강도다.
- \(p(x \mid y)\)가 (공분산을 공유하는) 다변량 가우시안이면 \(p(y \mid x)\)는 반드시 로지스틱 함수다. 하지만 역은 성립하지 않는다. 따라서 GDA가 로지스틱 회귀보다 더 강한 모델링 가정을 한다.
- 가정이 맞으면 GDA가 데이터를 더 잘 맞춘다. \(p(x \mid y)\)가 정말 공분산을 공유하는 가우시안이면 GDA는 점근적으로 효율적(asymptotically efficient) 이다. 학습 집합이 매우 클 때 \(p(y \mid x)\)를 GDA보다 엄밀하게 더 정확히 추정하는 알고리즘이 없다는 뜻이며, 학습 집합이 작을 때도 대개 GDA가 낫다.
- 로지스틱 회귀는 가정이 약해서 모델링 가정이 틀렸을 때 더 강건(robust) 하다. \(p(y \mid x)\)를 로지스틱으로 만드는 가정은 많다. 예를 들어 \(x \mid y = 0 \sim \text{Poisson}(\lambda_0)\), \(x \mid y = 1 \sim \text{Poisson}(\lambda_1)\)이어도 \(p(y \mid x)\)는 로지스틱이다. 로지스틱 회귀는 이런 포아송 데이터에서도 잘 작동하지만, GDA로 비가우시안 데이터에 가우시안을 맞추면 결과를 예측하기 어렵다.
| GDA | 로지스틱 회귀 | |
|---|---|---|
| 모델링 대상 | \(p(x \mid y)\), \(p(y)\) | \(p(y \mid x)\) |
| 가정 | 강하다 (공분산을 공유하는 가우시안) | 약하다 |
| 가정이 맞을 때 | 데이터 효율이 높다, 점근적으로 효율적 | 더 많은 데이터가 필요하다 |
| 가정이 틀릴 때 | 성능을 예측하기 어렵다 | 강건하다, 데이터가 많으면 거의 항상 더 낫다 |
이 때문에 실제로는 로지스틱 회귀가 GDA보다 더 자주 쓰인다.
나이브 베이즈
스팸 분류와 특성 벡터
GDA에서는 특성 벡터가 연속값이었다. 이제 특성 \(x_j\)가 이산값인 생성 학습 알고리즘을 본다. 동기가 되는 예는 이메일 스팸 필터이며, 이는 텍스트 분류(text classification) 문제의 한 예다.
이메일을 사전 단어 수만큼의 길이를 가진 벡터로 표현한다. 이메일에 사전의 \(j\)번째 단어가 있으면 \(x_j = 1\), 없으면 \(x_j = 0\)이다. 예를 들어 “a”와 “buy”는 있고 “aardvark”, “aardwolf”, “zygmurgy”는 없는 이메일은 해당 위치만 1인 벡터가 된다. 특성 벡터에 담긴 단어 집합을 어휘(vocabulary) 라 하며, \(x\)의 차원은 어휘 크기와 같다. 실제로는 영어 사전 대신 학습 집합에 한 번 이상 나온 단어로 어휘를 만드는 경우가 많고, “the”, “of”, “and”처럼 너무 흔해서 정보가 거의 없는 불용어(stop word) 는 빼기도 한다.
나이브 베이즈 가정
이제 \(p(x \mid y)\)를 모델링해야 한다. 어휘가 50000개라면 \(x \in \{0, 1\}^{50000}\)이고, 이를 \(2^{50000}\)가지 결과 위의 다항 분포로 직접 모델링하면 매개변수가 \(2^{50000} - 1\)개 필요하다. 너무 많다.
그래서 매우 강한 가정을 한다. \(y\)가 주어지면 \(x_j\)들이 조건부 독립이라고 가정한다. 이를 나이브 베이즈(Naive Bayes, NB) 가정이라 하고, 그 결과 얻는 알고리즘을 나이브 베이즈 분류기라 한다. 예를 들어 “buy”가 2087번, “price”가 39831번 단어라면, 이메일이 스팸(\(y = 1\))이라는 것을 알고 나면 “buy”의 등장 여부는 “price”의 등장 여부에 대한 믿음에 영향을 주지 않는다는 가정이다. 즉 \(p(x_{2087} \mid y) = p(x_{2087} \mid y, x_{39831})\)이다. 이는 \(x_{2087}\)과 \(x_{39831}\)이 그냥 독립이라는 \(p(x_{2087}) = p(x_{2087} \mid x_{39831})\)과는 다르다. \(y\)가 주어졌을 때만 독립이라는 뜻이다.
확률의 연쇄 법칙과 NB 가정으로 다음을 얻는다.
\[\begin{aligned} p(x_1, \dots, x_{50000} \mid y) &= p(x_1 \mid y) \, p(x_2 \mid y, x_1) \, p(x_3 \mid y, x_1, x_2) \cdots p(x_{50000} \mid y, x_1, \dots, x_{49999}) \\ &= p(x_1 \mid y) \, p(x_2 \mid y) \, p(x_3 \mid y) \cdots p(x_{50000} \mid y) = \prod_{j=1}^{d} p(x_j \mid y) \end{aligned}\]첫 등호는 확률의 일반적 성질이고, 둘째 등호에서 NB 가정을 썼다. 극단적으로 강한 가정이지만 이렇게 얻은 알고리즘은 많은 문제에서 잘 작동한다.
매개변수와 최대우도 추정
모델의 매개변수는 다음과 같다.
\[\phi_{j \mid y=1} = p(x_j = 1 \mid y = 1), \qquad \phi_{j \mid y=0} = p(x_j = 1 \mid y = 0), \qquad \phi_y = p(y = 1)\]학습 집합의 결합 우도 \(L(\phi_y, \phi_{j \mid y=0}, \phi_{j \mid y=1}) = \prod_{i=1}^{n} p(x^{(i)}, y^{(i)})\)를 최대화하면 다음 추정값을 얻는다. \(\wedge\)는 “그리고”다.
\[\phi_{j \mid y=1} = \frac{\sum_{i=1}^{n} 1\{x_j^{(i)} = 1 \wedge y^{(i)} = 1\}}{\sum_{i=1}^{n} 1\{y^{(i)} = 1\}}, \qquad \phi_{j \mid y=0} = \frac{\sum_{i=1}^{n} 1\{x_j^{(i)} = 1 \wedge y^{(i)} = 0\}}{\sum_{i=1}^{n} 1\{y^{(i)} = 0\}}, \qquad \phi_y = \frac{\sum_{i=1}^{n} 1\{y^{(i)} = 1\}}{n}\]해석은 자연스럽다. 예를 들어 \(\phi_{j \mid y=1}\)은 스팸 이메일 중 단어 \(j\)가 등장한 이메일의 비율이다.
예측
새 예제 \(x\)에 대해 베이즈 규칙으로 사후 확률을 계산하고, 사후 확률이 더 큰 클래스를 고른다.
\[p(y = 1 \mid x) = \frac{\left( \prod_{j=1}^{d} p(x_j \mid y = 1) \right) p(y = 1)}{\left( \prod_{j=1}^{d} p(x_j \mid y = 1) \right) p(y = 1) + \left( \prod_{j=1}^{d} p(x_j \mid y = 0) \right) p(y = 0)}\]이산화
이진 특성뿐 아니라 \(x_j \in \{1, 2, \dots, k_j\}\)인 경우로 일반화하는 것도 간단하다. \(p(x_j \mid y)\)를 베르누이 대신 다항 분포로 모델링하면 된다. 거실 면적처럼 원래 연속값인 특성도 몇 개의 구간으로 이산화(discretize) 해서 나이브 베이즈를 적용하는 일이 흔하다.
| 거실 면적 (sq. feet) | < 400 | 400-800 | 800-1200 | 1200-1600 | > 1600 |
|---|---|---|---|---|---|
| \(x_j\) | 1 | 2 | 3 | 4 | 5 |
예를 들어 면적이 890제곱피트이면 \(x_j = 3\)이다. 원래의 연속 특성이 다변량 정규분포로 잘 모델링되지 않을 때는, 이산화한 뒤 GDA 대신 나이브 베이즈를 쓰는 편이 더 좋은 분류기가 되는 경우가 많다.
본 적 없는 단어 때문에 생기는 문제와 그 해결책인 라플라스 스무딩, 텍스트용 다항 사건 모델은 6강에서 이어진다.
정리
- 판별 모델은 \(p(y \mid x)\)를 직접 학습하고, 생성 모델은 \(p(x \mid y)\)와 \(p(y)\)를 학습한 뒤 베이즈 규칙으로 \(\arg\max_y p(x \mid y) p(y)\)를 예측한다.
- GDA는 \(y \sim \text{Bernoulli}(\phi)\), \(x \mid y \sim \mathcal{N}(\mu_y, \Sigma)\)(공분산 공유)로 모델링한다. 최대우도 추정값은 클래스 비율, 클래스별 평균, 클래스 평균을 뺀 공분산이다.
- 공분산을 공유하는 GDA의 사후 확률 \(p(y = 1 \mid x)\)는 로지스틱 함수이며, 결정 경계는 초평면이다.
- GDA는 더 강한 가정을 하므로 가정이 맞으면 데이터 효율이 높고, 로지스틱 회귀는 가정이 약해 모델이 틀렸을 때 더 강건하다. 실제로는 로지스틱 회귀가 더 많이 쓰인다.
- 나이브 베이즈는 \(y\)가 주어지면 특성들이 조건부 독립이라고 가정해 \(p(x \mid y) = \prod_j p(x_j \mid y)\)로 매개변수 수를 크게 줄인다.
- 나이브 베이즈의 최대우도 추정값은 각 클래스에서 단어 \(j\)가 등장한 비율 같은 단순한 개수 비율이다.