- UC Berkeley CS 182 (Spring 2021) 1강 정리
- 강의: Sergey Levine
- 관련 Discussion: Discussion 1
표현 학습의 예: 다국어 번역과 강의 개요
짝지은 데이터의 한계
세상에는 6000개가 넘는 언어가 있다. 기계 번역(machine translation) 시스템은 보통 짝지은 데이터(paired data), 즉 같은 뜻의 영어 문장과 프랑스어 문장 쌍을 모은 말뭉치로 학습한다. 영어-프랑스어처럼 자료가 풍부한 언어 쌍은 문제가 없지만, 몰타어-티베트어처럼 드문 조합은 짝지은 문장이 거의 없다. 언어 쌍마다 따로 모델을 학습하는 방식으로는 이 문제를 풀 수 없다.
다국어 번역 모델
“표준” 방식은 언어 쌍마다 번역 모델을 하나씩 둔다(영-프, 영-스, 프-스 등). Google의 다국어 신경망 번역(Johnson et al., 2016)은 대신 하나의 모델에 여러 언어 쌍을 모두 학습시키고, 입력에 원하는 출력 언어를 표시하는 토큰을 붙인다. 이 실험에서 다음이 관찰되었다.
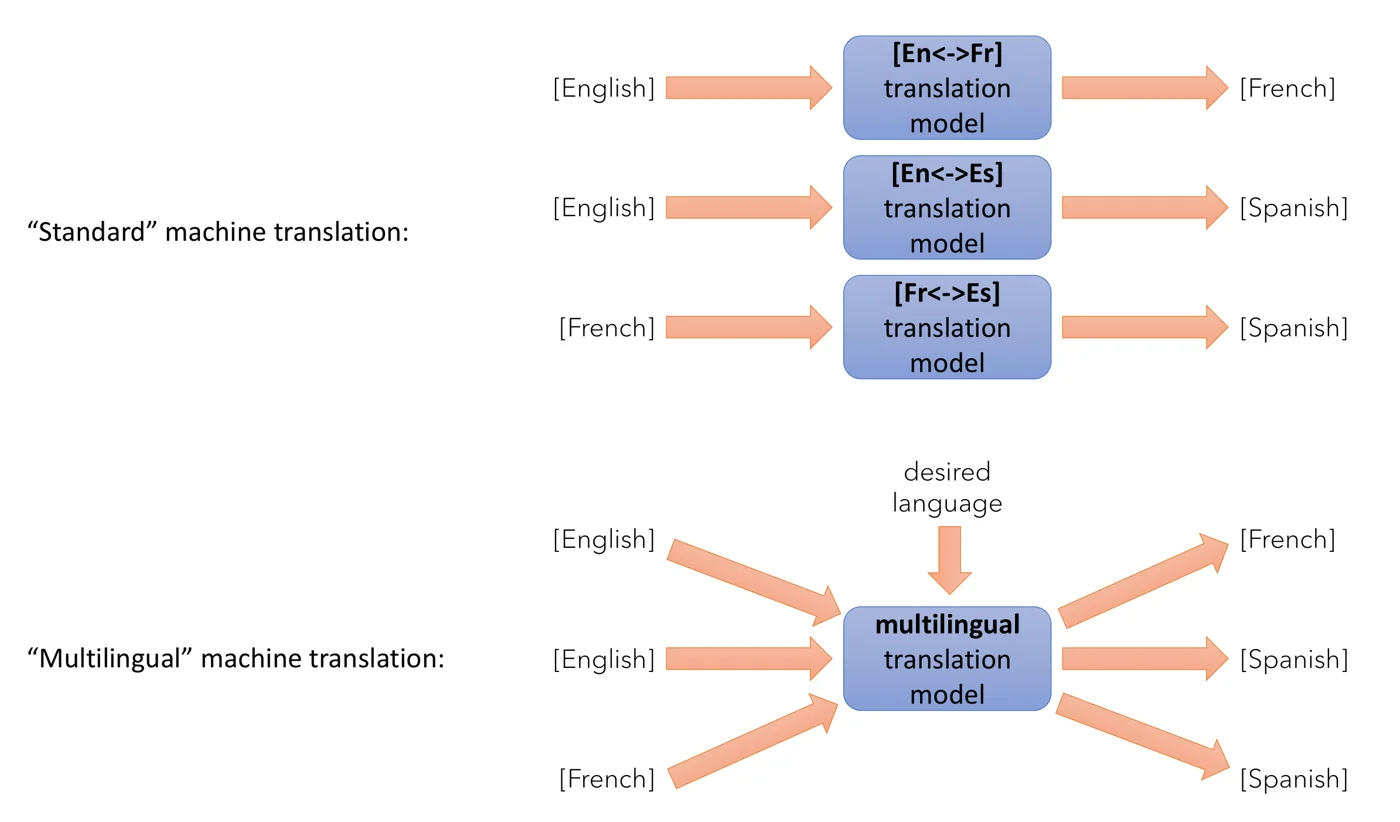 위는 언어 쌍마다 별도 모델을 두는 “표준” 기계 번역, 아래는 원하는 출력 언어를 함께 입력받는 하나의 다국어 번역 모델이다. 출처: CS 182 Lecture 1 slides.
그림의 위쪽에서는 영-프, 영-스, 프-스 모델이 각자 자기 언어 쌍의 데이터만 본다. 언어가 \(n\)개라면 이런 모델이 대략 \(n^2\)개 필요하고, 각 모델은 다른 모델이 배운 것을 전혀 공유하지 못한다. 아래쪽에서는 모든 입력 문장이 같은 모델로 들어가고, 위에서 내려오는 “desired language” 화살표가 어떤 언어로 출력할지만 알려 준다. 모든 언어 쌍의 데이터가 하나의 매개변수 집합을 함께 학습시키므로, 언어 사이에 공통된 구조를 공유할 여지가 생긴다. 아래 관찰들은 모두 이 공유에서 비롯된다.
- 제로샷 번역(zero-shot translation). 영어→프랑스어, 프랑스어→영어, 영어→스페인어로만 학습했는데도 프랑스어→스페인어 번역이 어느 정도 가능하다. 한 번도 본 적 없는 언어 쌍이다.
- 효율 향상. 희귀 언어로의 번역이나 희귀 언어에서의 번역은, 흔한 언어도 함께 학습할 때 더 잘 된다.
- 언어 섞기. 출력 언어 토큰을 섞어서(예: 스페인어 40%, 프랑스어 60%) 넣을 수 있다. 영어를 스페인어와 포르투갈어의 혼합으로 번역하면 가중치에 따라 출력이 한 언어에서 다른 언어로 넘어간다. 일본어와 한국어 혼합도 마찬가지다. 러시아어와 벨라루스어를 섞으면 두 언어 어느 쪽도 아닌 문장이 나오기도 한다.
“생각”은 표현이다
이런 현상은 모델 내부에 언어와 무관한 중간 상태가 있다고 보면 설명된다. 입력 문장을 일종의 “생각(thought)”으로 바꾸고, 그 생각을 원하는 언어로 풀어 내는 것이다. 이 “생각”이 바로 표현(representation) 이다.
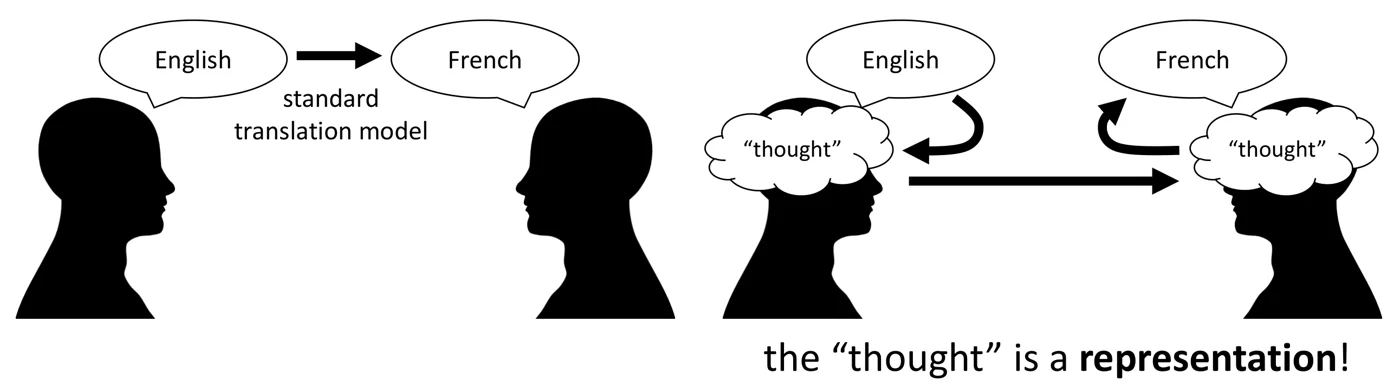 왼쪽은 영어 문장을 프랑스어 문장으로 곧바로 바꾸는 표준 번역 모델, 오른쪽은 영어를 먼저 “생각”으로 바꾼 뒤 그 생각을 프랑스어로 풀어내는 방식이다. 출처: CS 182 Lecture 1 slides.
오른쪽 그림에서 번역은 두 단계로 나뉜다. 첫 단계는 영어 문장을 머릿속 “생각”으로 옮기는 부호화이고, 둘째 단계는 그 생각을 프랑스어 문장으로 옮기는 복호화다. 가운데의 긴 화살표가 전달하는 것은 단어가 아니라 생각이다. 생각이 어느 언어에도 속하지 않는다면, 프랑스어에서 생각으로 가는 길과 생각에서 스페인어로 가는 길을 각각 따로 배웠더라도 둘을 이어 붙여 프랑스어→스페인어 번역을 할 수 있다. 제로샷 번역이 가능한 이유가 바로 이것이다.
고전적인 관점에서 머신러닝은 입력을 출력으로 바꾸는 함수를 찾는 일이다. 그러나 문장, 이미지처럼 복잡한 입력을 다루려면 좋은 표현이 필요하다. 딥러닝의 힘은 이런 표현을 데이터로부터 자동으로 학습하는 데 있다.
강의 구성
강의는 신경망 구조, 최적화 알고리즘, 비전과 자연어 처리(NLP) 응용, 강화학습(reinforcement learning), 고급 주제를 폭넓게 다룬다. 과제는 신경망 기초, 합성곱/순환 신경망, NLP, 강화학습의 네 가지 프로그래밍 과제이고, 중간고사 두 번과 2~3인 팀 기말 프로젝트가 있다. 선수 지식으로 다변수 미분, 행렬 연산, 연속 확률변수를 포함한 확률론, 기본 머신러닝(CS189 수준), Python 프로그래밍이 요구된다.
머신러닝과 딥러닝이란 무엇인가
규칙을 직접 짜는 대신 데이터에서 얻는다
이미지를 받아 물체 이름을 내놓는 프로그램을 생각하자. 함수는 입력을 출력으로 바꾸는 규칙의 집합이다. 규칙을 사람이 직접 정의할 수 있으면 그것이 프로그래밍이다. 하지만 규칙을 모르거나, 규칙이 너무 복잡하고 예외와 특수한 경우가 많다면 직접 짜기 어렵다.
머신러닝(machine learning)은 입력-출력 관계를 손으로 정의하는 대신, 데이터로부터 그 관계를 습득하는 프로그램을 정의한다. 핵심 아이디어는 다음과 같다. 규칙이 복잡하고 예외투성이일수록, 규칙을 구현하는 것보다 예시 데이터를 제공하는 것이 더 쉽다.
무엇을 학습하는가: 매개변수
가장 단순한 예로 2차원 평면 위의 점을 두 부류로 나누는 문제를 보자. 결정 경계(decision boundary)가 직선이라면 그 직선은 몇 개의 수로 기술된다. 예를 들어 \(\theta_1 x_1 + \theta_2 x_2 + \theta_0 = 0\)이다. 학습이란 이 수, 즉 매개변수(parameter) \(\theta\)를 데이터에 맞게 정하는 일이다. 일반적으로 프로그램은 \(f_\theta(x)\) 형태의 매개변수화된 함수이고, 학습은 \(\theta\)를 고르는 과정이다.
어떤 매개변수화를 쓸 것인가: 얕은 학습
이미지처럼 입력이 픽셀 값의 거대한 배열이라면, 픽셀에 직접 선형 함수를 적용하는 것으로는 물체를 구별하기 어렵다. 전통적인 해법은 얕은 학습(shallow learning) 이다. 사람이 특징(feature)을 직접 설계하고(예: 에지나 기울기 방향 히스토그램 같은 이미지 특징), 그 위에서만 단순한 모델을 학습한다.
이는 일종의 타협이다. 규칙은 손으로 짜지 않지만 특징은 손으로 짠다. 특징 위의 학습은 앞의 2차원 예처럼 단순해도 되지만, 좋은 특징을 고안하는 일은 매우 어렵다.
얕은 학습에서 깊은 학습으로
얕은 학습에서는 입력 → 특징 → 레이블 중 마지막 단계에만 학습되는 매개변수가 있다. 특징을 만드는 단계의 매개변수도 학습하면 어떨까? 이것이 학습된 특징(learned features) 이고, 딥러닝의 출발점이다.
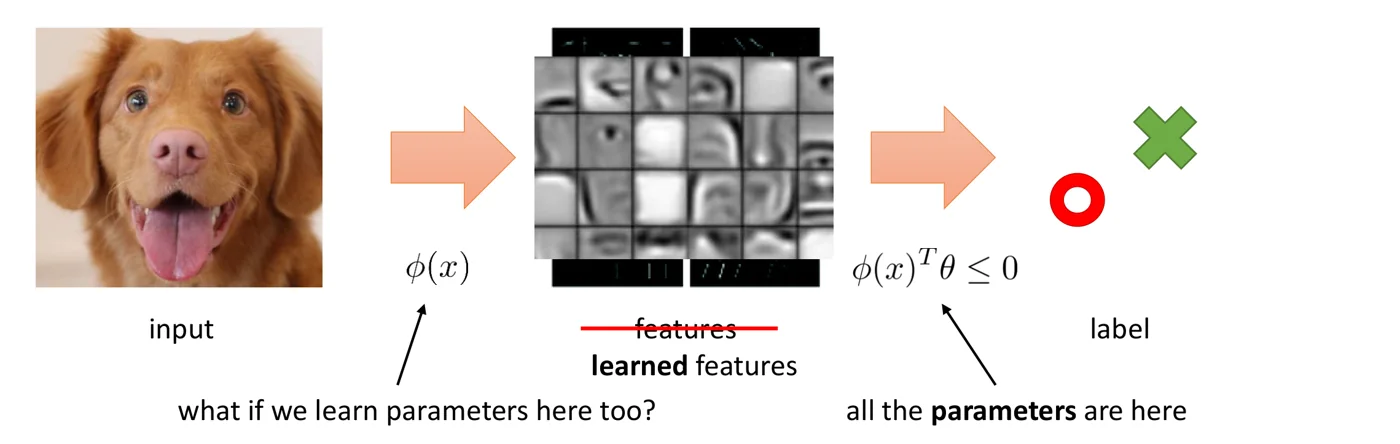 입력 이미지 \(x\)에서 특징 \(\phi(x)\)를 뽑고, 그 위의 선형 분류기 \(\phi(x)^T\theta \le 0\)으로 레이블을 정한다. 얕은 학습에서는 매개변수가 마지막 단계에만 있지만, 딥러닝은 특징 추출 단계의 매개변수도 학습한다. 출처: CS 182 Lecture 1 slides.
그림을 왼쪽부터 읽으면 입력, 특징 추출 \(\phi(x)\), 특징, 분류 규칙, 레이블 순서다. 오른쪽 아래 화살표가 가리키듯 얕은 학습에서 학습되는 매개변수 \(\theta\)는 모두 마지막 분류 규칙에 들어 있고, \(\phi\)는 사람이 고정해 둔 함수다. 왼쪽 아래 화살표의 질문, 즉 “여기서도 매개변수를 학습하면 어떨까?”에 답한 것이 딥러닝이다. 가운데의 “features”에 줄을 긋고 “learned features”라고 고쳐 쓴 부분이 이 전환을 나타낸다. 가운데 격자는 실제로 학습된 특징을 시각화한 것으로, 눈, 코, 얼굴 윤곽 같은 패턴이 사람이 지정하지 않았는데도 나타난다.
여기서 더 나아가 표현을 여러 층으로 쌓을 수 있다. 각 층은 이전 층을 입력으로 받는 단순한 매개변수화된 변환이다. 이미지 모델을 시각화하면 앞쪽 층은 에지 같은 단순한 패턴을, 뒤쪽 층은 물체의 부분이나 전체 같은 복잡한 패턴을 포착한다. 높은 층의 표현은 다음 성질을 가진다.
- 더 추상적이다.
- 방해 요인(nuisance)에 더 불변(invariant)하다. 예를 들어 조명이나 위치 변화에 덜 민감하다.
- 레이블을 예측하기 더 쉽다.
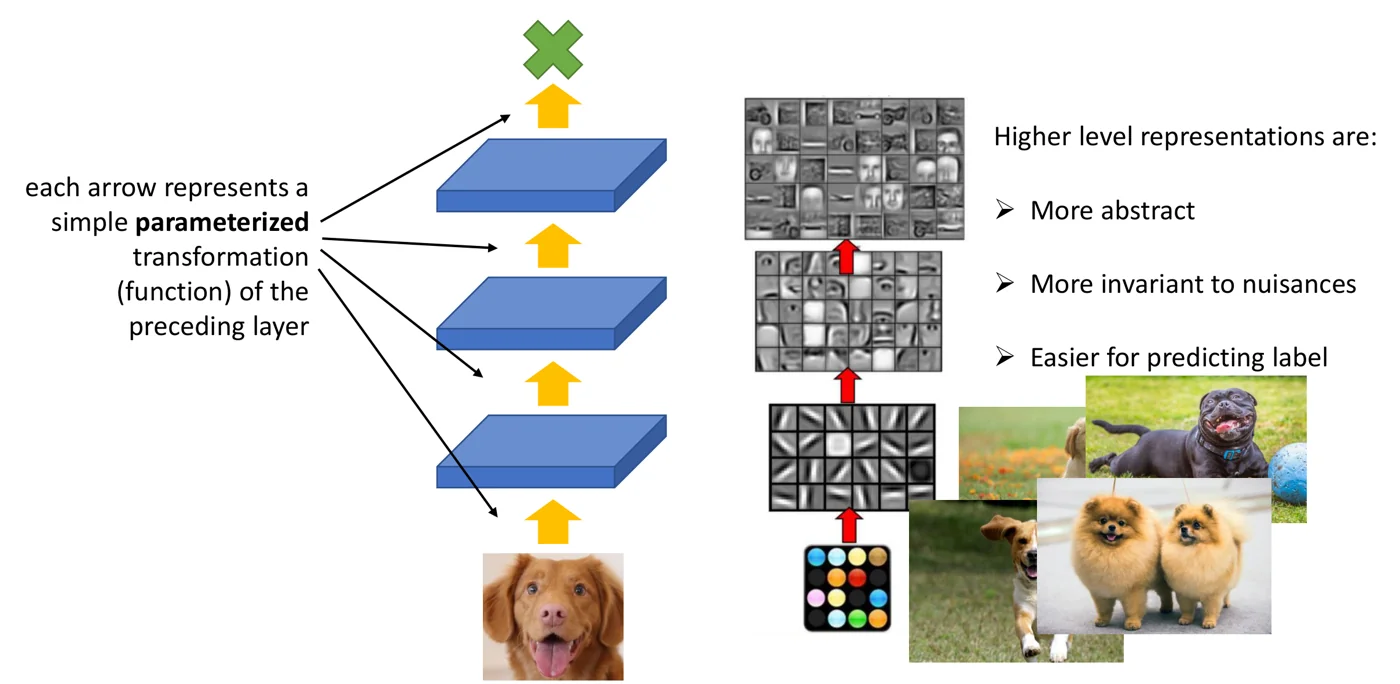 왼쪽은 입력에서 레이블까지 여러 층의 표현을 쌓은 구조로, 각 화살표가 이전 층에 대한 단순한 매개변수화된 변환이다. 오른쪽은 실제로 학습된 층별 특징을 아래(픽셀)에서 위(얼굴, 물체)로 보여 준다. 출처: CS 182 Lecture 1 slides.
왼쪽 그림에서 파란 판 하나가 한 층의 표현이고, 노란 화살표 하나가 그 층을 만드는 변환이다. 변환 하나하나는 단순하지만 여러 개를 합성하면 복잡한 함수가 된다. 오른쪽 그림을 아래에서부터 읽으면 이 합성이 무엇을 만들어 내는지 알 수 있다. 맨 아래는 픽셀 색, 그 위 층은 여러 방향의 에지와 줄무늬, 그 위는 눈이나 코 같은 부분, 맨 위는 얼굴이나 물체 전체에 가까운 패턴이다. 층을 올라갈수록 같은 개 사진이라도 자세, 배경, 조명이 달라지는 차이는 점점 무시되고 “개”라는 공통점만 남는다. 위 세 성질은 이 관찰을 정리한 것이다.
딥러닝의 정의
딥러닝(deep learning) 은 학습된 표현이 여러 층으로 쌓인 머신러닝이다. 입력에서 내부 표현을 거쳐 출력으로 가는 변환은 보통 깊은 신경망(deep neural network)으로 나타낸다. 다만 학습되는 매개변수를 가진 다층 매개변수 함수는 거의 모두 신경망이라 부를 수 있으므로 이 정의는 다소 순환적이다.
각 층의 매개변수는 보통(항상은 아니다) 전체 과제의 목적함수(예: 정확도)에 대해 함께 학습된다. 이를 종단간 학습(end-to-end learning) 이라 한다.
딥러닝은 왜 작동하는가
짧은 역사
- 1950: Turing이 학습을 기계 지능으로 가는 길로 제시한다.
- 1957: Rosenblatt의 퍼셉트론(perceptron)이 실용적 학습 방법으로 제안된다.
- 1969: Minsky와 Papert가 신경망의 근본적 한계를 지적한 책을 낸다. 이후 주류 연구는 대체로 얕은 학습에 집중한다.
- 1986: 역전파(backpropagation)가 깊은 신경망을 학습하는 실용적 방법으로 자리 잡는다.
- 1989: 필기체 인식을 위한 신경망 LeNet이 나온다.
- 1990~2000년대: 확률적 방법과 볼록 최적화(convex optimization)가 큰 관심을 받지만 대부분 얕은 모델이다.
- 2006년 무렵: 깊은 신경망이 다시 주목받기 시작한다.
- 2012: Krizhevsky의 AlexNet이 ImageNet에서 다른 모든 방법을 크게 앞선다.
세 가지 요인
2012년 전후에 일어난 변화는 세 가지로 요약된다.
- 층이 많은 큰 모델. LeNet(1989)은 7층, AlexNet(2012)은 8층, ResNet-152(2015)는 152층이다.
- 예시가 많은 큰 데이터셋. MNIST는 6만 장, CalTech 101(2003)은 약 9천 장, CIFAR-10(2009)은 약 6만 장, ImageNet(ILSVRC, 2009)은 약 150만 장이다.
- 이를 감당할 계산 자원. 모델 성능은 계산량에 따라 계속 좋아진다. NLP도 마찬가지이며, 슬라이드의 예시 모델은 약 16개의 TPU 같은 전용 하드웨어에서 학습되었다.
이는 두 가지로 볼 수 있다. 딥러닝은 거대한 모델, 데이터, 계산을 요구하므로 비싸고 좋지 않다는 관점이 있다. 반대로 데이터와 층과 계산을 늘릴수록 모델이 계속 좋아지므로 훌륭하다는 관점도 있다. ImageNet 오류율은 사람의 오류율(약 5%)보다 낮아졌다. 다만 어떤 사람을 기준으로 했는지는 따져 볼 문제다.
강의를 관통하는 주제
딥러닝의 핵심은 고용량 모델과 많은 데이터로 표현을 얻는 것이다. 특징이나 표현을 사람이 설계할 필요가 없다.
- 자동화. 좋은 특징이 무엇인지 몰라도 모델이 데이터에서 찾아낸다.
- 더 나은 성능. 표현을 종단간으로 학습하면 현재 과제에 더 잘 맞춰진다.
- 학습 대 귀납적 편향(nature vs. nurture). 딥러닝 모델은 성능의 대부분을 설계자의 통찰이 아니라 데이터에서 얻는다. 그래도 모델에 넣는 사전 지식, 즉 귀납적 편향을 완전히 없앨 수는 없다. 지식을 모델에 넣을 것인지, 학습 장치와 규모를 개선할 것인지가 늘 질문으로 남는다.
- 확장되는 알고리즘(algorithms that scale). 데이터, 표현 용량, 계산을 늘릴수록 계속 좋아지는 방법을 말한다.
용어를 정리하면 다음과 같다.
- 모델 용량(model capacity): 한 모델 집합이 나타낼 수 있는 함수가 얼마나 다양한지. 예를 들어 선형 결정 경계만 가능한 모델보다 비선형 경계까지 가능한 모델의 용량이 크다.
- 귀납적 편향(inductive bias): 학습을 돕기 위해 모델에 넣은 지식이나 편향. 어떤 해를 더 그럴듯하게, 어떤 해를 덜 그럴듯하게 만든다는 의미에서 “편향”이다.
- 확장성(scaling): 데이터와 모델 용량을 늘릴수록 알고리즘이 더 잘 작동하는 성질.
왜 “신경망”이라 부르는가
초기에 신경망은 뇌의 뉴런을 단순화한 모델로 제안되었다. 생물학적 뉴런은 수상돌기(dendrite)로 다른 뉴런의 신호를 받고, 들어온 신호에 따라 발화할지 “결정”하며, 축삭(axon)으로 신호를 내보낸다. 인공 “뉴런”(유닛, unit)은 상류 유닛의 활성값(activation)을 가중합하고, 활성화 함수(activation function) 로 얼마나 강하게 발화할지 정한 뒤 그 값을 하류 유닛에 전달한다.
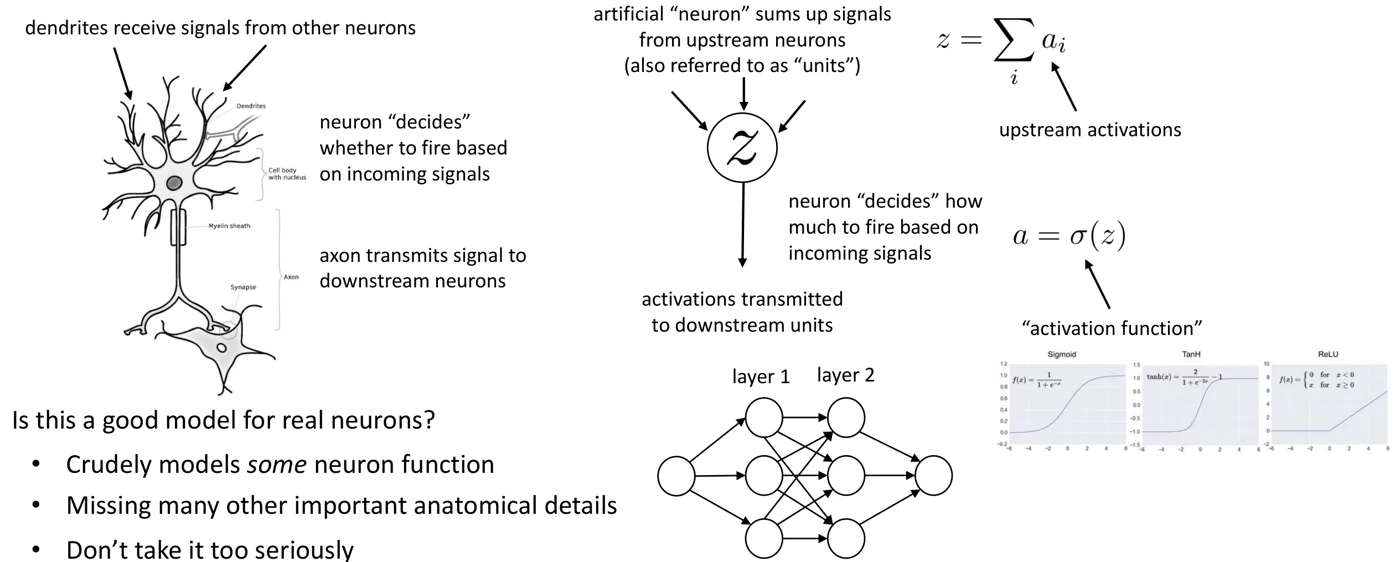 왼쪽은 생물학적 뉴런의 구조, 가운데는 상류 활성값을 합한 \(z\)에 활성화 함수 \(\sigma\)를 적용해 \(a=\sigma(z)\)를 내보내는 인공 뉴런, 오른쪽 아래는 대표적 활성화 함수(sigmoid, tanh, ReLU)다. 출처: CS 182 Lecture 1 slides.
그림의 대응 관계는 다음과 같다. 수상돌기로 들어오는 신호는 상류 활성값 \(a_i\)이고, 세포체가 신호를 모으는 과정은 합 \(z=\sum_i a_i\)이다(실제로는 가중치를 곱한 가중합이다). 뉴런이 발화할지, 얼마나 강하게 발화할지 정하는 부분은 활성화 함수 \(a=\sigma(z)\)이고, 축삭으로 신호가 나가는 것은 이 \(a\)가 다음 층의 입력이 되는 것이다. 이런 유닛을 여러 개 나란히 두면 한 층이 되고, 층을 이어 붙이면 가운데 아래의 “layer 1, layer 2” 그림 같은 신경망이 된다. 오른쪽 아래 세 곡선 중 sigmoid와 tanh는 입력이 크면 출력이 포화되고, ReLU는 음수에서 0, 양수에서 항등함수다.
이 모델은 뉴런의 일부 기능을 거칠게 흉내 낼 뿐 해부학적 세부는 대부분 빠져 있으므로 너무 진지하게 받아들일 필요는 없다. 다만 깊은 신경망이 학습한 표현과 뇌의 표현이 비슷해 보이는 경우가 있다는 점은 흥미로운 질문을 던진다. 뇌가 딥러닝을 하는 것인지, 아니면 충분히 강력한 학습 기계라면 결국 비슷한 해에 도달하는 것인지는 열린 질문이다.
정리
- 다국어 번역 모델은 언어에 무관한 내부 “생각”을 학습하며, 그 덕분에 제로샷 번역과 언어 혼합이 가능하다. 이 내부 상태가 표현이다.
- 머신러닝은 입력-출력 규칙을 손으로 짜는 대신 데이터로부터 매개변수 \(\theta\)를 학습해 함수 \(f_\theta(x)\)를 얻는다.
- 얕은 학습은 사람이 설계한 특징 위에서 단순한 모델을 학습한다. 딥러닝은 특징까지 여러 층에 걸쳐 학습하며, 높은 층일수록 추상적이고 불변하며 예측에 유용하다.
- 각 층을 과제 목적함수에 대해 함께 학습하는 것을 종단간 학습이라 한다.
- 딥러닝이 2012년 무렵부터 성공한 이유는 큰 모델, 큰 데이터셋, 충분한 계산 자원의 결합이다.
- 강의 전체의 주제는 수작업 대신 학습으로 표현을 얻는 것, 그리고 귀납적 편향과 확장성 사이의 균형이다.