- UC Berkeley CS 182 (Spring 2021) 8강 정리
- 강의: Sergey Levine
- 관련 Discussion: Discussion 5
컴퓨터 비전 문제와 물체 위치 추정
표준적인 컴퓨터 비전 문제
지금까지의 합성곱 신경망은 이미지를 하나의 출력값, 예를 들어 “자전거” 같은 의미 범주로 매핑했다. 컴퓨터 비전에는 그 밖에도 표준적인 문제들이 있다.
- 물체 분류(object classification): 이미지 전체에 하나의 레이블을 붙인다.
- 물체 위치 추정(object localization): 이미지 안의 (하나의) 물체에 대해 레이블과 함께 경계 상자(bounding box)를 출력한다.
- 물체 검출(object detection): 이미지 안의 여러 물체 각각에 대해 레이블과 경계 상자를 출력한다.
- 의미론적 분할(semantic segmentation): 모든 픽셀에 클래스 레이블을 붙인다. 장면 이해(scene understanding)라고도 한다.
물체 위치 추정의 설정
데이터셋은 \(\mathcal{D} = \{(x_i, y_i)\}\)이고, 레이블 \(y_i\)는 범주형 클래스 레이블 \(\ell_i\)와 경계 상자 좌표로 이루어진다.
\[y_i = (\ell_i, \; x_i, \; y_i, \; w_i, \; h_i)\]여기서 \((x_i, y_i)\)는 상자의 위치, \(w_i, h_i\)는 너비와 높이다(이미지 \(x_i\)와 기호가 겹치지만 슬라이드의 표기를 따른다).
위치 추정 정확도의 측정: IoU
학습된 모델은 예측 경계 상자와 예측 점수(예: 확률)를 출력한다. 예측이 맞았는지 어떻게 판단할까? IoU(Intersection over Union) 를 쓴다. 예측 상자와 정답 상자의 교집합 넓이 \(I\)를 합집합 넓이 \(U\)로 나눈다.
\[\mathrm{IoU} = \frac{I}{U}\]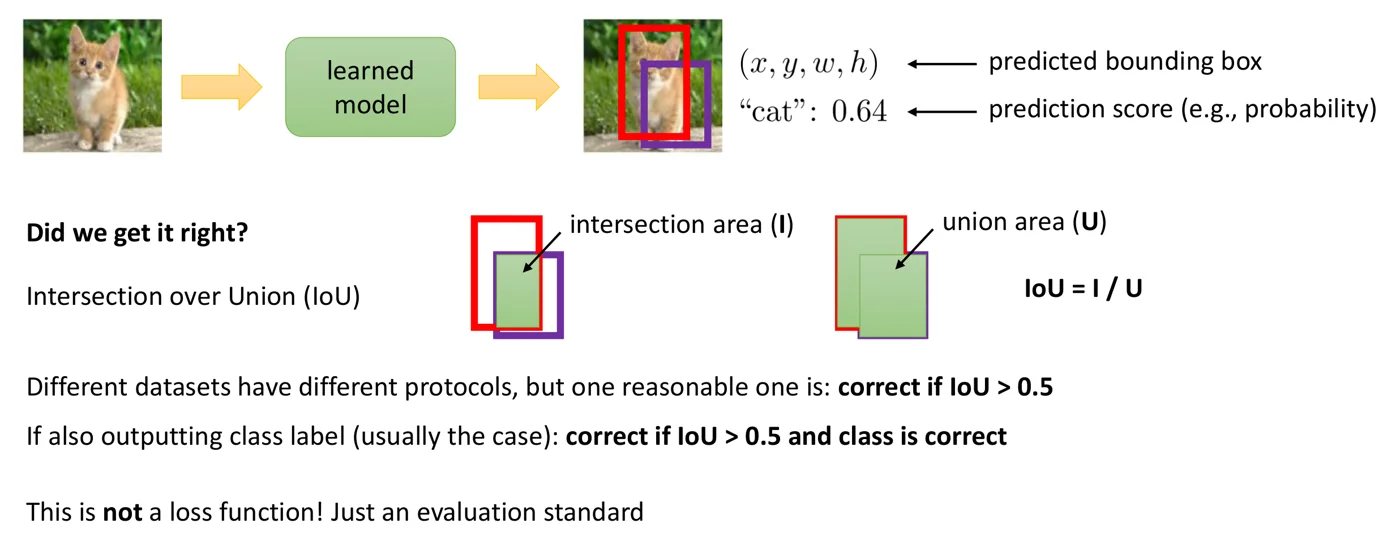 모델이 예측한 상자(보라)와 정답 상자(빨강)의 겹친 넓이 I를 두 상자를 합친 넓이 U로 나눈 값이 IoU다. 출처: CS 182 Lecture 8 slides.
그림의 위쪽 줄은 위치 추정 모델의 입출력이다. 고양이 이미지를 넣으면 모델은 상자 좌표 \((x, y, w, h)\)와 “cat”: 0.64 같은 예측 점수를 함께 낸다. 아래쪽 줄은 이 예측을 채점하는 방법이다. 두 상자가 겹친 초록 영역이 교집합 \(I\)이고, 두 상자가 덮는 전체 영역이 합집합 \(U\)다. 두 상자가 완전히 일치하면 \(I = U\)이므로 IoU는 1이고, 전혀 겹치지 않으면 0이다. 상자가 정답보다 조금 밀려 있거나 크기가 조금 다르면 그 정도에 따라 0과 1 사이의 값이 나온다.
IoU는 상자의 크기에 대해 정규화된 값이라는 점도 중요하다. 좌표 차이를 픽셀 단위로 재면 큰 물체의 몇 픽셀 오차와 작은 물체의 몇 픽셀 오차를 같은 무게로 다루게 되지만, IoU는 겹친 비율을 보므로 물체의 크기와 무관하게 “얼마나 잘 맞았는가”를 잴 수 있다.
데이터셋마다 규약이 다르지만, 합리적인 기준 하나는 IoU가 0.5보다 크면 맞은 것으로 보는 것이다. 클래스 레이블도 출력한다면(대개 그렇다) IoU > 0.5이고 클래스도 맞아야 정답이다. IoU는 손실 함수가 아니라 평가 기준일 뿐이다.
회귀로서의 위치 추정
가장 단순한 설계는 합성곱 특징 위에 두 개의 헤드를 두는 것이다.
- 분류 헤드: 클래스 레이블을 출력하고 교차 엔트로피 손실로 학습한다.
- 회귀 헤드: \((x, y, w, h)\)를 출력하고 회귀 손실(예: 가우시안 로그 가능도, MSE)로 학습한다.
두 손실을 더해 함께 학습하거나(다중 과제 학습, multi-task), 분류를 먼저 학습한 뒤 회귀 헤드를 학습할 수도 있다. 대체로 그럭저럭 작동하지만, 이것만으로는 보통 쓰지 않는다. 그 이유는 곧 나온다.
슬라이딩 윈도우
이미지의 모든 조각(patch)을 각각 분류하면 어떨까? 여러 위치의 창(window)을 잘라 분류기에 넣으면 창마다 클래스 확률이 나온다. 가장 높은 클래스 확률을 가진 상자를 고르면 된다. 더 일반적으로는 비최대 억제(non-maximal suppression) 를 쓴다(뒤에서 설명한다).
OverFeat과 계산 재사용
OverFeat: 실용적인 접근
OverFeat(Sermanet et al., 2013)은 슬라이딩 윈도우에 회귀를 결합한다. 회귀 헤드는 슬라이딩 윈도우에 작은 “보정”을 제공하는 역할이다.
- 분류만으로 먼저 사전학습한다.
- 분류 특징 위에 회귀 헤드를 학습한다.
- 이미지의 서로 다른 영역을 여러 스케일로 훑는다. 각 스케일·위치에서 클래스 출력(예: 곰일 확률)과 예측 상자 \((x, y, w, h)\)가 나온다.
- 상자들을 “평균”해 하나의 최종 답을 얻는다.
슬라이딩 윈도우와 계산 재사용
문제는 슬라이딩 윈도우가 매우 비싸다는 점이다. 창이 36개면 계산 비용도 36배다. 그런데 이 과정은 합성곱과 많이 닮았다. 창들 사이에서 계산을 재사용할 수 없을까?
핵심은 완전연결 층도 합성곱 층으로 볼 수 있다는 것이다. 마지막 합성곱 특징 맵이 \(h \times w \times c\)일 때, 이를 평탄화해 4096 유닛 FC 층에 넣는 것은 \(h \times w \times c\) 크기의 필터 4096개로 합성곱하는 것과 같다. 그 뒤의 FC 층들은 \(1 \times 1 \times 4096\) 필터를 쓰는 \(1 \times 1\) 합성곱이다.
- 이전: 4096 유닛의 FC 층 2개
- 이후: \(1 \times 1 \times 4096\) 필터의 합성곱 층 2개
이렇게 바꾼 “합성곱 분류기(convolutional classification)” 에 더 큰 이미지를 넣으면, 출력이 \(1 \times 1\)이 아니라 공간 격자가 된다. 격자의 각 칸이 바로 한 창의 분류 결과이고, 겹치는 창들의 계산은 자동으로 공유된다.
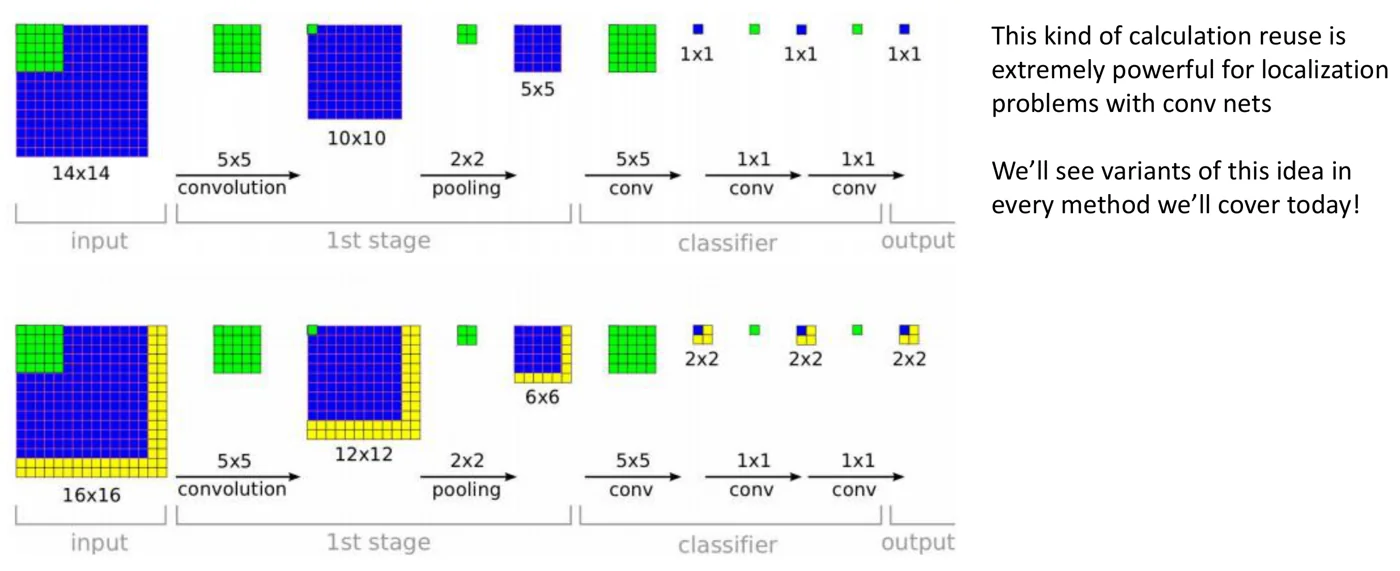 위: 14x14 입력에 맞춰 학습한 합성곱 분류기는 1x1 출력을 낸다. 아래: 같은 신경망에 16x16 입력을 넣으면 출력이 2x2가 되고, 각 칸이 서로 다른 창의 분류 결과다. 출처: CS 182 Lecture 8 slides.
그림의 위쪽 줄을 따라가 보자. 14x14 입력에 5x5 합성곱을 적용하면 10x10이 되고, 2x2 풀링으로 5x5가 된다. 분류기 부분은 원래 FC 층이지만 5x5 합성곱(5x5 특징 맵 전체를 덮는 필터)과 1x1 합성곱 두 개로 바꿔 놓았으므로, 결과는 1x1, 즉 하나의 분류 결과다. 초록색은 입력의 한 창(왼쪽 위 조각)이 각 단계에서 어디에 대응하는지를 보여 준다.
아래쪽 줄은 같은 가중치를 그대로 16x16 입력에 적용한 경우다. 노란색이 늘어난 부분이다. 합성곱과 풀링을 거치면 12x12, 6x6이 되고, 분류기의 5x5 합성곱을 지나면 출력이 2x2가 된다. 이 네 칸은 입력에서 가로·세로로 2픽셀씩 어긋난 네 개의 14x14 창을 각각 분류한 결과와 정확히 같다. 네 창을 따로 계산했다면 겹치는 부분의 합성곱을 네 번 반복했겠지만, 이 방식에서는 겹치는 부분이 한 번만 계산된다. 이것이 슬라이딩 윈도우를 “하나의 합성곱”으로 구현한다는 말의 의미다.
이런 계산 재사용은 합성곱 신경망으로 위치 관련 문제를 풀 때 매우 강력하며, 이 강의의 모든 방법에서 변형된 형태로 등장한다.
요약
- 기본 구성 요소는 클래스와 경계 상자 좌표를 함께 출력하는 합성곱 신경망이다.
- 이 신경망을 여러 스케일과 많은 잘라낸 영역에서 평가해, 각각 확률과 경계 상자를 얻는다.
- 슬라이딩 윈도우를 또 하나의 합성곱으로 구현하고, 끝의 분류기·회귀기를 \(1 \times 1\) 합성곱으로 만들어 계산을 아낀다.
물체 검출 구조
문제 설정
위치 추정에서는 물체가 하나였다. 검출에서는 이미지에 물체가 여러 개 있고, 몇 개인지 미리 알 수 없다. 출력의 개수가 가변적이다.
여러 출력을 어떻게 얻는가
방법 1: 출력 목록. 신경망이 경계 상자의 목록을 직접 출력한다. 명백한 문제는 개수를 미리 정해야 하고, 보통 꽤 작게 잡아야 한다는 점이다. 이것만으로는 좋지 않지만 다른 방법과 결합하면 아주 잘 작동한다.
방법 2: 슬라이딩 윈도우. 각 창이 서로 다른 물체일 수 있다. 확률이 가장 높은 창 하나를 고르는(또는 창들을 합치는) 대신, 확률이 임계값을 넘는 모든 창에서 물체를 출력한다.
큰 문제가 있다. 점수가 높은 창 근처에는 대개 점수가 높은 창이 또 있다. 그래서 비최대 억제(non-maximal suppression, NMS) 를 쓴다. 비공식적으로 말하면, 같은 클래스의 더 높은 점수를 가진 검출이 근처(예: IoU가 큰 위치)에 있는 검출은 모두 제거한다. 국소적으로 최대인 검출만 남는다.
사례 연구: YOLO
YOLO(“You Only Look Once”, Redmon et al., 2015)는 사실 몇 번 본다. 정확히는 49번이다.
- 이미지를 \(7 \times 7\)(49칸) 격자로 나누고, 칸마다 다른 출력을 낸다. 슬라이딩 윈도우와 비슷하다.
- 앞의 계산 재사용 기법을 써서 비용은 49배가 되지 않는다.
- 각 칸은 \(B\)개의 상자에 대해 다음을 출력한다.
- 상자 좌표 \((x, y, w, h)\)
- 신뢰도(confidence): 정답 상자와의 IoU를 예측한다. 물체가 없으면 0이다.
- 클래스 레이블 \(\ell\)
학습할 때는 각 정답 물체에 대해 어느 출력이 “책임”을 질지 정해야 한다. 그 칸에서 가장 잘 맞는(IoU가 가장 높은) 출력을 쓴다. 물체가 너무 많으면? 별수 없다. 그냥 놓친다.
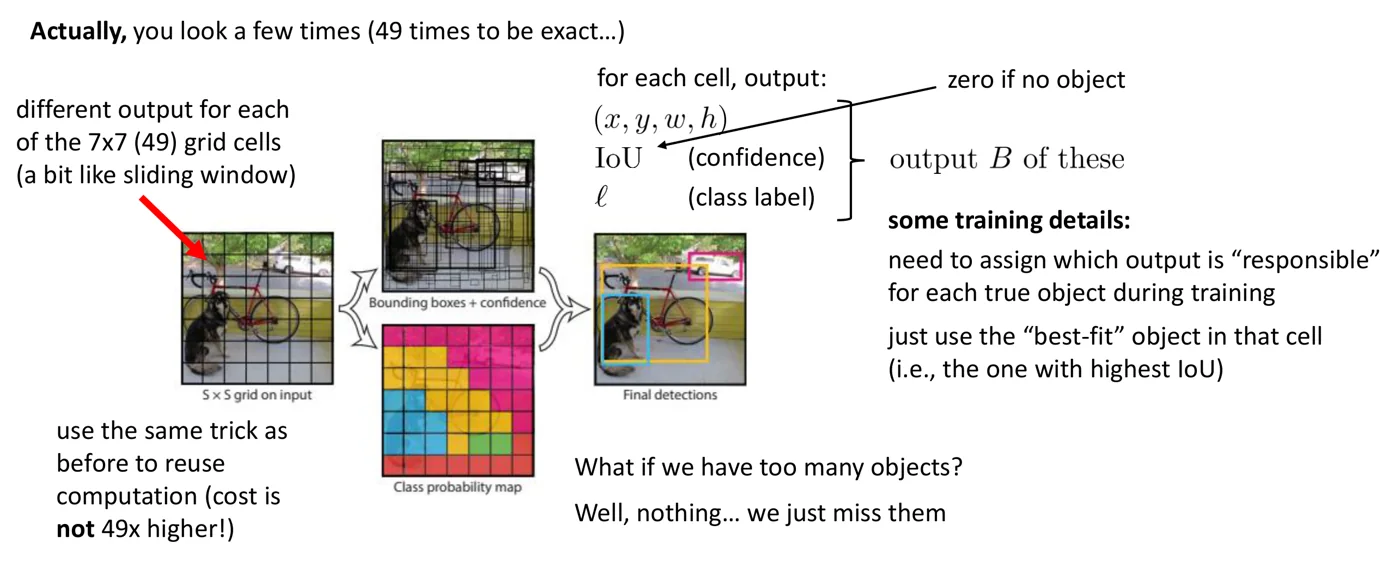 YOLO는 입력을 S x S 격자로 나누고, 칸마다 상자·신뢰도와 클래스 확률을 예측한 뒤 이를 합쳐 최종 검출을 만든다. 출처: CS 182 Lecture 8 slides.
그림의 가운데 두 패널이 YOLO 출력의 두 부분이다. 위 패널은 모든 칸이 내놓은 경계 상자들로, 선의 굵기가 신뢰도(예측 IoU)를 나타낸다. 물체가 없는 칸의 상자는 신뢰도가 0에 가깝게 학습된다. 아래 패널은 칸마다 가장 가능성이 높은 클래스를 색으로 칠한 클래스 확률 지도로, 개가 있는 칸은 파랑, 자전거가 있는 칸은 노랑 식이다. 상자의 신뢰도와 그 칸의 클래스 확률을 곱하면 “이 상자에 이 클래스의 물체가 있을 점수”가 되고, 이 점수에 임계값과 비최대 억제를 적용하면 오른쪽의 최종 검출(개, 자전거, 자동차)이 남는다.
각 칸을 따로 신경망에 넣는 것이 아니라 앞에서 본 계산 재사용 기법으로 전체 격자의 출력을 한 번의 순전파로 얻으므로, 비용은 49배가 아니다. 이름 그대로 이미지를 “한 번” 보는 셈이고, 이 덕분에 실시간 검출이 가능하다.
CNN과 영역 제안: Fast R-CNN
더 똑똑한 슬라이딩 윈도우는 관심 영역 제안(region of interest proposal) 이다. 모든 위치를 보는 대신, 물체가 있을 법한 후보 영역(RoI)만 본다.
원래 방식처럼 각 후보 영역을 잘라 CNN을 따로 돌리면 매우 느리다. 하지만 이미 고치는 법을 안다. Fast R-CNN(Girshick, 2015)은 다음과 같이 한다.
- 이미지 전체를 한 번만 합성곱 신경망에 통과시켜 고해상도 특징 맵(예: conv5)을 얻는다.
- 제안된 각 RoI에 해당하는 특징 맵 영역을 고정 크기 격자로 나눠 칸마다 최대 풀링한다(RoI 풀링). 결과는 FC 층이 기대하는 \(C \times h \times w\) 크기의 저해상도 특징이다.
- FC 층을 거쳐 softmax 분류기와 경계 상자 회귀기를 적용한다.
모든 위치를 평가하는 합성곱 방식과 비교하면, 합성곱 계산은 공유하면서 분류는 제안된 영역에서만 한다.
영역 제안을 학습하기: Faster R-CNN
영역 제안 자체는 어떻게 학습할까? Faster R-CNN(Ren et al., 2015)은 영역 제안 네트워크(Region Proposal Network, RPN) 를 쓴다. 합성곱 특징 맵 위에서 작은 창을 밀며, 각 위치에서 “물체인가/아닌가”를 분류하는 점수와 상자 좌표 회귀값을 출력한다. OverFeat이나 YOLO와 매우 비슷한 설계지만, 특정 클래스가 아니라 그 위치 근처에 어떤 물체든 있는지를 예측한다. 제안된 영역은 RoI 풀링을 거쳐 최종 분류기로 간다.
추천 읽을거리
- YOLO (Redmon et al., 2015): 각 칸에서 서로 다른 경계 상자로 회귀한다. YOLO v5 등 더 잘 작동하는 후속작이 있다.
- Fast R-CNN (Girshick, 2015): 슬라이딩 윈도우/합성곱 대신 관심 영역 제안을 쓴다.
- Faster R-CNN (Ren et al., 2015): 위와 같되 영역 제안의 학습 등 몇 가지를 개선했다.
- SSD (Liu et al., 2015): 위치마다 클래스와 경계 상자 모양을 직접 “분류”한다.
분할 구조
문제 설정
의미론적 분할은 모든 픽셀에 클래스 레이블을 붙인다. 어떤 의미에서는 검출보다 오히려 단순하다.
- 출력 개수가 더 이상 가변적이지 않다.
- 모든 픽셀에 레이블이 있다.
인스턴스는 신경 쓰지 않는다. 예를 들어 붙어 있는 두 마리 소는 하나의 “소 덩어리”가 되어도 괜찮다(인스턴스를 구분하는 문제는 인스턴스 분할이라 한다).
단순한 해법은 “픽셀별” 분류기다. 각 픽셀 주변의 조각을 잘라 CNN으로 분류한다. 문제는 출력이 입력과 같은 해상도여야 한다는 점이다. 다운샘플링을 전혀 하지 않으면(영 패딩, 스트라이드 1, 풀링 없음) 어렵지 않지만 매우 비싸다. 과제는 이 픽셀별 분류 문제를 계산적으로 다룰 만하게 만드는 구조를 설계하는 것이다.
완전 합성곱 신경망
완전 합성곱 신경망(fully convolutional network) 은 다음과 같이 구성된다.
- 중간의 저해상도(하지만 깊이가 큰) 처리 단계가 이미지 전체의 문맥(context)을 통합한다.
- 끝의 업샘플링(up-sampling) 단계가 저해상도 특징 벡터를 고해상도 픽셀별 예측으로 바꾼다.
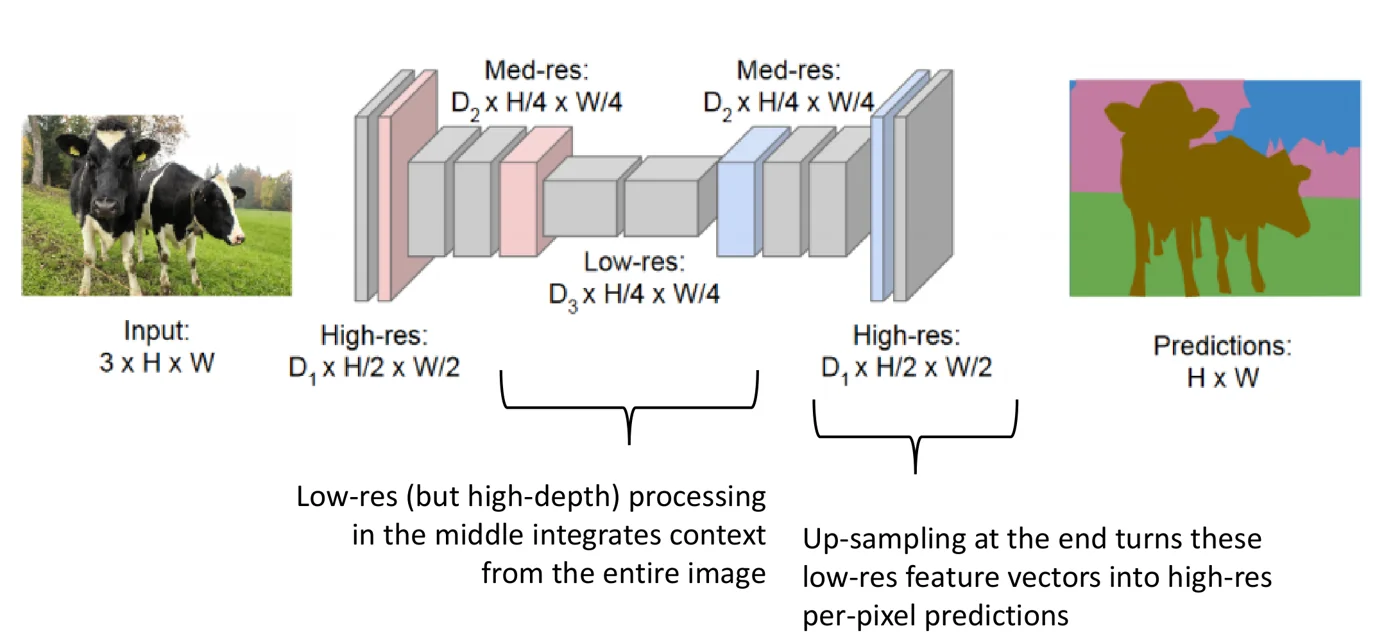 완전 합성곱 신경망은 해상도를 H/2, H/4로 줄이며 깊이를 늘린 뒤, 다시 업샘플링해 입력과 같은 H x W 크기의 픽셀별 예측을 낸다. 출처: CS 182 Lecture 8 slides.
그림을 왼쪽에서 오른쪽으로 읽으면 텐서의 모양 변화가 보인다. 입력은 \(3 \times H \times W\)이고, 첫 단계에서 \(D_1 \times H/2 \times W/2\), 다음 단계에서 \(D_2 \times H/4 \times W/4\)로 해상도는 줄고 채널 수는 늘어난다. 가운데의 저해상도 층에서는 각 위치의 수용 영역(receptive field)이 이미지의 넓은 부분을 덮으므로, “이 픽셀은 소의 일부다” 같은 판단에 필요한 전체 문맥이 모인다. 오른쪽 절반은 이 과정을 거꾸로 밟아 해상도를 \(H/4 \to H/2 \to H\)로 되돌리고, 마지막에는 픽셀마다 클래스를 고른 \(H \times W\) 분할 지도를 출력한다.
모든 층을 원래 해상도에서 계산하는 단순한 방법과 비교하면, 비싼 계산 대부분이 작은 해상도에서 일어나므로 훨씬 싸다. 남는 문제는 줄어든 해상도를 어떻게 다시 늘리느냐이고, 그것이 다음의 전치 합성곱과 언풀링이다.
업샘플링: 전치 합성곱
일반 합성곱은 스트라이드로 해상도를 줄인다. 예를 들어 스트라이드 2 합성곱에서 필터는 \(H_f \times W_f \times C_{\text{in}} \times C_{\text{out}}\)이고, 입력의 \(H_f \times W_f \times C_{\text{in}}\) 영역 하나가 출력의 \(1 \times 1 \times C_{\text{out}}\) 값 하나가 된다.
전치 합성곱(transpose convolution) 은 분수 “스트라이드”(예: 1/2)로 해상도를 늘린다. 방향이 반대다.
- 입력: \(1 \times 1 \times C_{\text{in}}\)
- 출력: \(H_f \times W_f \times C_{\text{out}}\)
- 필터: \(C_{\text{in}} \times H_f \times W_f \times C_{\text{out}}\)
입력의 각 위치가 필터 크기만큼의 출력 영역에 값을 “뿌린다”. 인접한 입력 위치가 뿌린 영역은 겹치므로, 겹치는 곳에는 두 개의 값이 생긴다. 슬라이드에서는 이를 그냥 평균한다(구현에 따라 합하기도 한다).
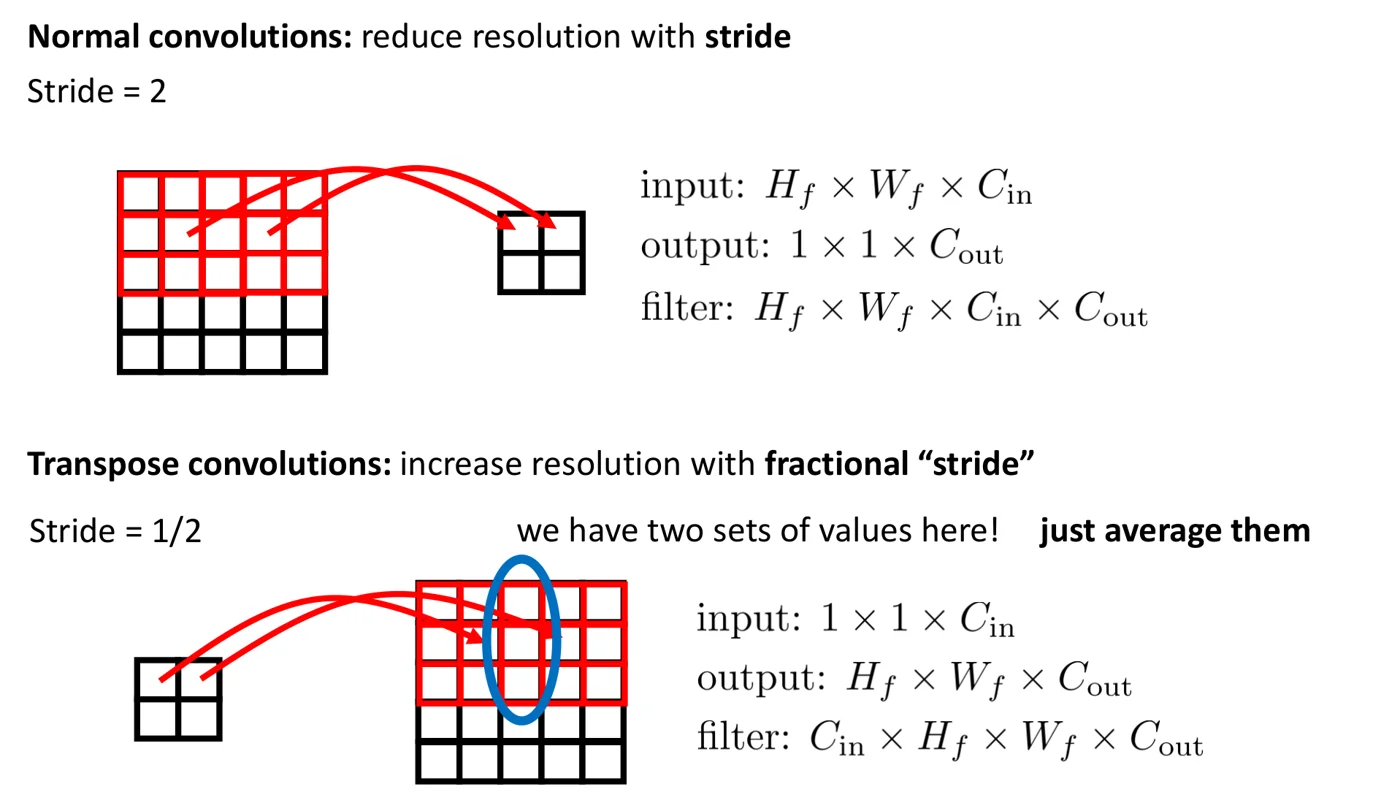 위: 스트라이드 2 합성곱은 입력의 여러 칸을 출력의 한 칸으로 모은다. 아래: 스트라이드 1/2 전치 합성곱은 입력의 한 칸을 출력의 여러 칸으로 뿌리며, 파란 타원처럼 겹치는 곳은 평균한다. 출처: CS 182 Lecture 8 slides.
그림의 위쪽에서 빨간 영역은 필터가 덮는 입력의 \(3 \times 3\) 영역이고, 화살표는 그 영역 전체가 출력의 한 칸으로 요약됨을 뜻한다. 다음 출력 칸으로 갈 때 필터는 입력에서 2칸씩 이동하므로, 출력의 해상도는 입력의 절반이 된다.
아래쪽은 이 화살표를 뒤집은 것이다. 이번에는 입력의 한 칸이 필터 크기(\(3 \times 3\))만큼의 출력 영역에 값을 써 넣고, 다음 입력 칸으로 넘어갈 때 출력에서 2칸씩 이동한다. 입력에서 1칸 이동이 출력에서 2칸 이동이므로 “스트라이드 1/2”이라 부르고, 해상도는 두 배가 된다. 필터 폭(3)이 이동 폭(2)보다 크므로 이웃한 입력 칸이 쓴 영역은 한 열씩 겹친다. 파란 타원으로 표시한 열에는 두 입력 칸에서 온 값이 둘 다 들어오며, 이를 평균(또는 합)해 하나의 값으로 만든다. 필터 가중치는 일반 합성곱처럼 학습된다.
언풀링
언풀링(un-pooling) 은 풀링의 반대다. 가장 단순하게는 값을 영역 전체에 복제하거나(최근접 이웃), 한 위치에만 두고 나머지를 0으로 채운다. “최대 언풀링(max unpooling)” 은 대응되는 최대 풀링 층에서 최댓값이 있던 위치를 기억해 두었다가 그 위치에 값을 놓는다.
병목 구조
Long et al.(2014)의 완전 합성곱 신경망은 병목(bottleneck) 구조다. 합성곱과 다운샘플링으로 해상도를 줄였다가, 업샘플링으로 다시 원래 해상도까지 늘려 픽셀별 클래스를 출력한다.
U-Net
U-Net(Ronneberger et al., 2015)은 병목 구조에 건너뛰는 연결(skip connection) 을 더한다. 다운샘플링 경로의 각 합성곱 층 활성화를 같은 해상도의 업샘플링 층에 이어 붙인다(concatenate). 병목을 지나며 잃어버린 고해상도의 세밀한 공간 정보를 업샘플링 경로가 그대로 쓸 수 있다. 원래 생의학 영상 분할을 위해 제안되었다.
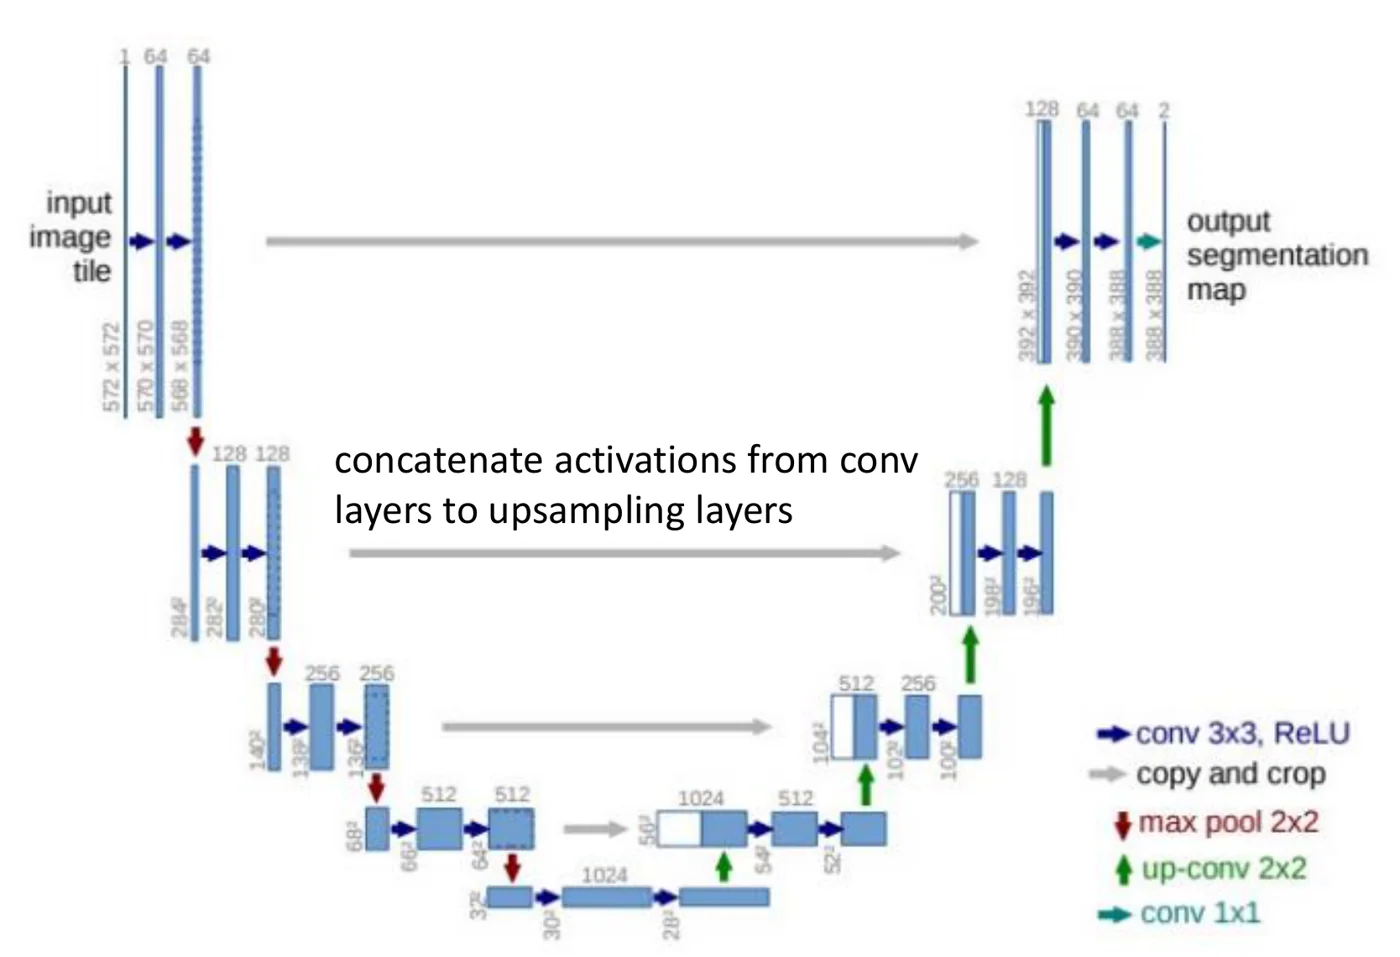 U-Net은 왼쪽 경로에서 최대 풀링으로 해상도를 줄이고 오른쪽 경로에서 up-conv로 늘리며, 회색 화살표로 같은 단계의 활성화를 복사해 이어 붙인다. 출처: CS 182 Lecture 8 slides.
그림의 U자 모양을 따라가면 구조가 보인다. 왼쪽 내리막(수축 경로)에서는 3x3 합성곱 두 번(파란 화살표) 뒤에 2x2 최대 풀링(빨간 화살표)이 반복되며, 해상도는 572에서 32 수준까지 줄고 채널 수는 64에서 1024까지 늘어난다. 오른쪽 오르막(확장 경로)에서는 2x2 up-conv(초록 화살표, 즉 전치 합성곱)로 해상도를 두 배씩 늘리고 채널 수를 줄인다.
핵심은 가로로 놓인 회색 화살표다. 수축 경로의 각 단계 출력을 복사해(크기가 조금 다르면 잘라서) 같은 높이의 확장 경로 입력에 채널 방향으로 이어 붙인다. 그림에서 확장 경로의 블록이 흰 부분과 파란 부분 두 칸으로 그려진 것이 이 이어 붙임이다. 병목을 지나며 흐려진 경계 정보가 이 연결을 통해 직접 전달되므로, 출력 분할 지도의 경계가 훨씬 정확해진다. 마지막의 1x1 합성곱(청록 화살표)은 각 픽셀의 특징 벡터를 클래스 점수로 바꾼다.
정리
- 표준적인 비전 문제는 분류, 위치 추정, 검출, 의미론적 분할이다. 위치 추정은 분류 헤드(교차 엔트로피)와 상자 회귀 헤드(MSE 등)를 함께 쓴다.
- IoU는 예측 상자와 정답 상자의 교집합/합집합으로, 보통 IoU > 0.5를 정답으로 보는 평가 기준이며 손실 함수가 아니다.
- FC 층을 \(1 \times 1\) 합성곱으로 바꾸면 슬라이딩 윈도우를 하나의 합성곱으로 구현해 창들 사이의 계산을 공유할 수 있다(OverFeat). 이 재사용이 이후 모든 방법의 바탕이다.
- 검출은 가변 개수의 출력이 필요하다. 임계값 이상의 창을 모두 출력하고 비최대 억제로 중복을 제거한다.
- YOLO는 \(7 \times 7\) 격자의 각 칸에서 상자·신뢰도·클래스를 회귀하고, Fast/Faster R-CNN은 영역 제안과 RoI 풀링을 쓰며, Faster R-CNN은 영역 제안 네트워크로 제안까지 학습한다.
- 분할은 저해상도에서 문맥을 통합한 뒤 전치 합성곱·언풀링으로 업샘플링하는 완전 합성곱 신경망으로 풀고, U-Net은 같은 해상도의 활성화를 이어 붙여 세밀한 정보를 보존한다.