- UC Berkeley CS 182 (Spring 2021) 7강 정리
- 강의: Sergey Levine
- 관련 Discussion: Discussion 4
지금까지 배운 것을 모두 따르고, 올바르게 구현하고, 오래 학습시켜도 신경망은 여전히 잘 학습되지 않을 수 있다. 신경망은 지저분하고, 잘 학습시키려면 여러 “요령(trick)”이 필요하다. 이 강의는 그 요령들을 다룬다.
- 입력과 출력의 정규화
- 활성화의 정규화(배치 정규화)
- 가중치 행렬과 편향 벡터의 초기화
- 기울기 클리핑
- 하이퍼파라미터 최적화의 모범 사례
- 앙상블과 드롭아웃
입력 표준화와 배치 정규화
큰 입력·활성화·출력의 위험
입력이 2차원인 간단한 신경망(선형 층 → ReLU → 선형 층 → softmax → 교차 엔트로피)을 생각하자. 두 가지 경우를 비교한다.
- 쉬운 경우: \(x_1\)과 \(x_2\)의 크기가 비슷하다.
- 어려운 경우: 첫 번째 차원 \(x_1\)이 \(x_2\)보다 훨씬 크다.
첫 층 가중치에 대한 기울기는 입력에 비례한다.
\[\frac{d\mathcal{L}}{dW^{(1)}} = \frac{dz^{(1)}}{dW^{(1)}} \frac{d\mathcal{L}}{dz^{(1)}} = \delta x^T\]따라서 큰 \(x\) 성분과 연결된 가중치의 기울기는 그만큼 크게 스케일된다. 쉬운 경우에는 손실 곡면의 등고선이 원에 가까워 기울기가 최솟값을 향하지만, 어려운 경우에는 등고선이 길쭉한 타원이 되어 기울기 하강법이 좁은 골짜기를 지그재그로 오가며 느리게 수렴한다.
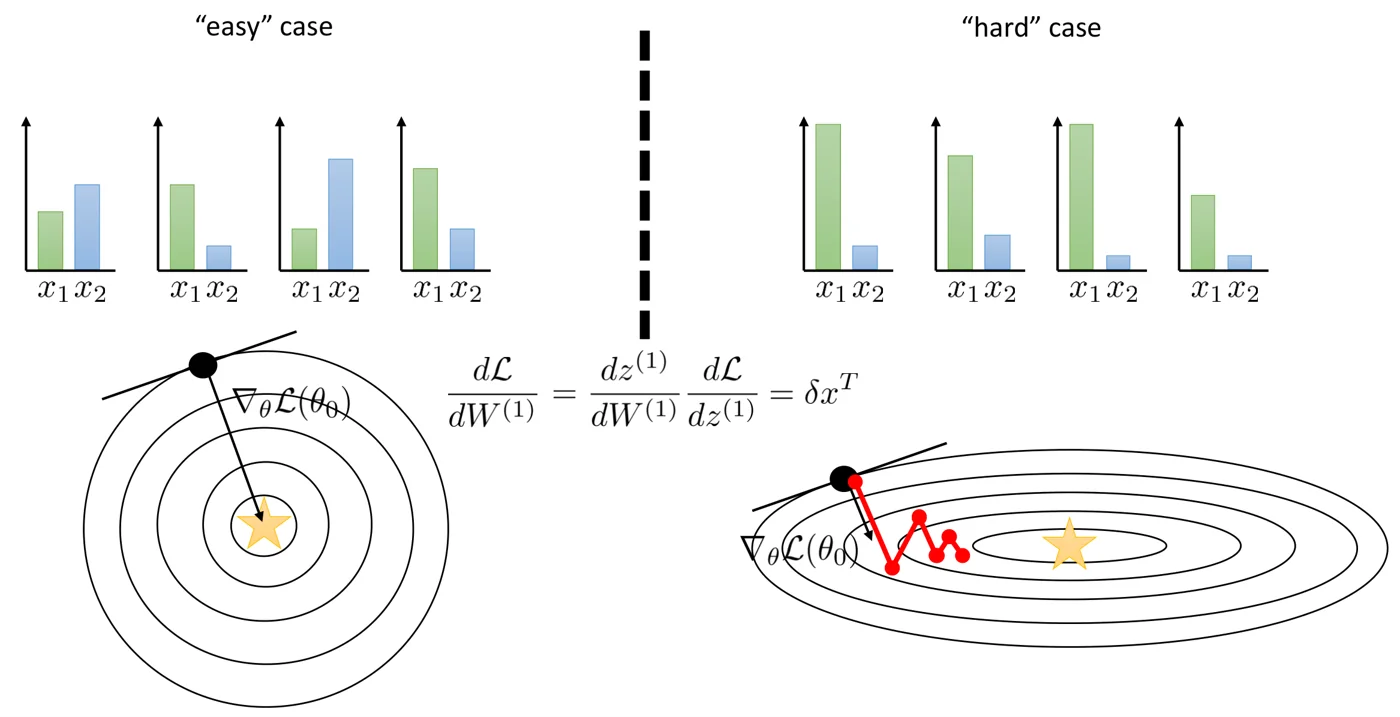 입력 스케일과 손실 곡면. 왼쪽(“easy”)은 데이터 점마다 \(x_1\)과 \(x_2\)의 크기가 비슷해 등고선이 원에 가깝고, 오른쪽(“hard”)은 \(x_1\)이 늘 훨씬 커서 등고선이 길쭉한 타원이 된다. 출처: CS 182 Lecture 7 slides.
위쪽 막대그래프는 네 개의 데이터 점에서 두 입력 성분의 크기를 비교한다. 왼쪽에서는 초록(\(x_1\))과 파랑(\(x_2\)) 중 어느 쪽이 큰지가 점마다 다르고 크기도 비슷하다. 오른쪽에서는 초록 막대가 항상 압도적으로 크다. 가운데 식 \(\frac{d\mathcal{L}}{dW^{(1)}} = \delta x^T\)에 따르면 \(W^{(1)}\)의 각 열에 대한 기울기는 해당 입력 성분 \(x_j\)에 비례하므로, 오른쪽 경우에는 \(x_1\)에 연결된 가중치 방향의 기울기만 매우 크다. 아래 그림처럼 손실이 그 방향으로 매우 가파르고 다른 방향으로는 완만한 길쭉한 골짜기가 되며, 경사하강법은 4강에서 본 지그재그를 보인다. 왼쪽에서는 기울기가 곧장 별표를 가리킨다.
일반적으로 \(x\)의 모든 성분이 대략 같은 스케일이기를 원한다.
- 문제가 안 되는 경우: 이미지는 모든 픽셀이 대략 \([0, 1]\) 또는 \(\{0, \dots, 255\}\) 범위다. NLP 같은 이산 입력은 모두 원-핫(0 또는 1)이다.
- 큰 문제가 되는 경우: 날씨 예측에서 기온은 40–100, 습도는 0.3–0.6처럼 차원마다 범위가 전혀 다르다.
표준화
해결책은 표준화(standardization), 즉 입력을 평균 0, 표준편차 1이 되도록 변환하는 것이다. 모든 연산은 차원별로 한다.
\[\bar{x}_i = x_i - E[x], \qquad E[x] \approx \frac{1}{N} \sum_{i=1}^{N} x_i\]표준편차까지 1로 만들려면 다음과 같이 한다.
\[\bar{x}_i = \frac{x_i - E[x]}{\sqrt{E[(x_i - E[x])^2]}}\]회귀 문제라면 출력도 같은 방식으로 표준화한다. 그렇다면 활성화도 표준화할 수 있을까?
활성화를 표준화하기
중간 층의 활성화도 차원마다 스케일이 크게 달라질 수 있다. 첫 번째 은닉층에 대해 데이터 전체의 평균과 표준편차로 표준화하는 것을 생각해 보자.
\[\mu^{(1)} = \frac{1}{N} \sum_{i=1}^{N} a_i^{(1)}, \qquad \sigma^{(1)} = \sqrt{\frac{1}{N} \sum_{i=1}^{N} \left(a_i^{(1)} - \mu^{(1)}\right)^2}, \qquad \bar{a}_i^{(1)} = \frac{a_i^{(1)} - \mu^{(1)}}{\sigma^{(1)}}\]원리상 가능하지만, 학습이 진행되면서 가중치가 바뀌므로 평균과 표준편차도 계속 바뀐다. 매 기울기 단계마다 데이터셋 전체를 평가하는 것은 너무 비싸다.
배치 정규화
배치 정규화(batch normalization) 는 평균과 표준편차를 현재 미니배치에 대해서만 계산한다. 배치 크기가 \(B\)이고 배치의 인덱스가 \(i_1, \dots, i_B\)일 때 다음과 같다.
\[\mu^{(1)} \approx \frac{1}{B} \sum_{j=1}^{B} a_{i_j}^{(1)}, \qquad \sigma^{(1)} \approx \sqrt{\frac{1}{B} \sum_{j=1}^{B} \left(a_{i_j}^{(1)} - \mu^{(1)}\right)^2}\]실제 버전에서는 정규화 뒤에 학습 가능한 스케일 \(\gamma\)와 편향 \(\beta\)를 곱하고 더한다. 둘 다 \(\bar{a}_i^{(1)}\)과 같은 차원의 벡터이고 곱셈은 원소별이다.
\[\bar{a}_i^{(1)} = \frac{a_i^{(1)} - \mu^{(1)}}{\sigma^{(1)}} \gamma + \beta\]\(\gamma\)와 \(\beta\) 덕분에 신경망은 필요하면 원래 스케일을 되살릴 수도 있다. 실제 구현에서는 0으로 나누는 것을 막기 위해 분모에 \(\sqrt{\sigma^2 + \epsilon}\)을 쓴다. 테스트 시에는 배치가 없을 수 있으므로, 학습 중에 모은 평균과 분산의 이동 평균을 사용하는 것이 표준적인 방식이다.
배치 정규화 층의 학습
배치 정규화는 신경망 안의 하나의 “층”으로 볼 수 있다. 학습은 그냥 역전파로 한다. \(\gamma\), \(\beta\)와 입력에 대한 미분은 직접 유도해 볼 만한 연습 문제다(Discussion 4에서 유도한다). 평균과 표준편차도 배치 안의 모든 입력에 의존하므로, 역전파할 때 이 경로를 통한 기울기도 포함해야 한다.
배치 정규화는 어디에 두는가
두 가지 배치가 있다.
- ReLU 다음에 BN: ReLU 출력은 모두 양수이므로 이를 중심화하는 것이 자연스럽다. 다만 BN의 스케일과 편향은 다음 선형 층에 흡수될 수 있을 것처럼 보인다.
- BN 다음에 ReLU: “고전적인” 방식이다. 이 경우 BN은 앞 선형 층 출력에 대한 변환처럼 보인다.
무엇이 옳은지에 대해 합의된 답은 없다. 둘 다 잘 작동하는 경우가 많으므로 몇 가지를 시도해 보고 잘 되는 것을 쓴다.
배치 정규화에 대한 고려사항
- 보통 더 큰 학습률을 쓸 수 있다.
- 학습이 훨씬 빨라진다.
- 일반적으로 정규화(regularization)가 덜 필요하다(예: 드롭아웃이 필요 없을 수 있다).
- 많은 경우 매우 좋은 아이디어다.
가중치 초기화와 기울기 클리핑
일반적인 원칙
무작위로 초기화한 가중치에서 신경망 활성화의 전체 스케일이 너무 크지도 작지도 않아야 기울기가 잘 전파된다.
- 기본 초기화: 활성화가 적절한 스케일을 갖고, 층이 늘어나도 활성화 스케일이 커지거나 줄어들지 않게 한다.
- 고급 초기화: 야코비안의 고유값(특잇값)을 직접 다룬다.
6강에서 본 것처럼, 아주 많은 수를 곱하면 대부분이 1보다 작을 때 0이 되고 1보다 클 때 무한대가 된다. 모두 1에 가까울 때만 적당한 값이 나온다.
목표는 좋은 해가 아니다
이상적으로는 손실 곡면의 최솟값 바로 위에서 시작하고 싶지만, 그곳이 어디인지 알 수 없다. 초기화의 목표는 좋은 해에서 시작하는 것이 아니라 기울기와 활성화가 잘 행동하게 하는 것이다.
간단한 선택으로 \(W_{jk}^{(i)} \sim \mathcal{N}(0, 0.0001)\)처럼 아주 작은 가우시안 가중치를 쓰면, 층을 지날 때마다 활성화의 표준편차가 빠르게 줄어 10층쯤에서는 거의 0이 된다. 이것이 왜 나쁜가? 가중치 기울기는
\[\frac{d\mathcal{L}}{dW^{(i)}} = \frac{dz^{(i)}}{dW^{(i)}} \frac{d\mathcal{L}}{dz^{(i)}} = \delta \, a^{(i-1)T}\]이므로 이전 층 활성화 \(a^{(i-1)}\)가 0에 가까우면 기울기도 0에 가까워진다.
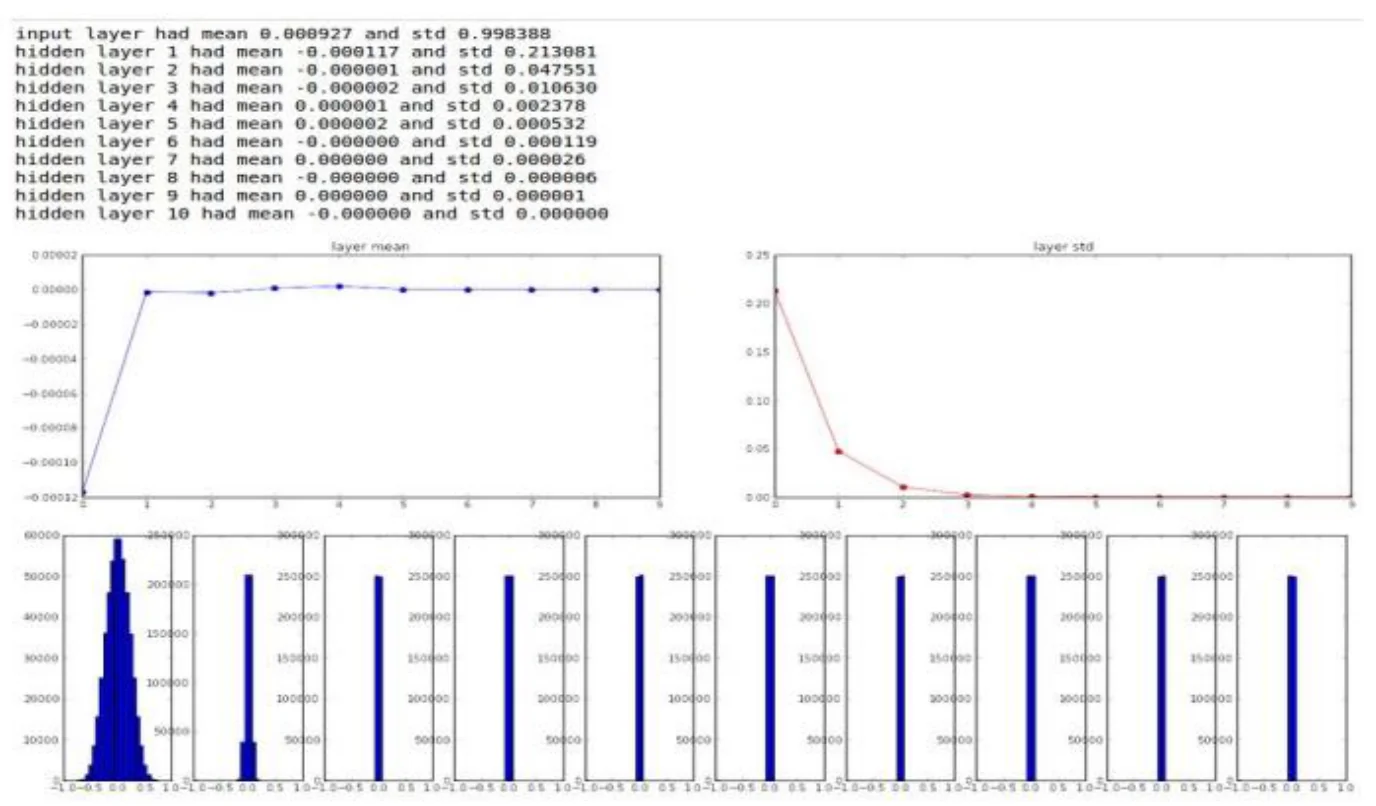 가중치를 \(\mathcal{N}(0, 0.0001)\)(표준편차 0.01)로 초기화한 10층 신경망의 층별 활성화 통계. 위는 층별 평균과 표준편차 수치, 가운데는 그 그래프, 아래는 층별 활성화 히스토그램이다. 출처: CS 182 Lecture 7 slides (그림: Fei-Fei Li & Andrej Karpathy).
위의 수치를 읽으면 표준편차가 입력층 약 1.0에서 1층 0.21, 2층 0.048, 3층 0.011로 층마다 약 5분의 1씩 줄어, 10층에서는 0.000000이 된다. 가운데 오른쪽 그래프(layer std)가 이 지수적 감소를 보여 준다. 아래 히스토그램에서도 첫 번째(입력)만 넓게 퍼져 있고, 1층부터는 모든 값이 0 근처의 막대 하나로 몰린다. 이 상태에서는 위 식의 \(a^{(i-1)}\)이 거의 0이므로 깊은 층 가중치의 기울기도 거의 0이 되어 학습이 진행되지 않는다.
기본 초기화: Xavier
선형 층 \(z = Wa + b\)에서 \(W_{ij} \sim \mathcal{N}(0, \sigma_W^2)\), \(b_i \approx 0\)으로 초기화한다고 하자. 입력을 표준화했다면 \(x \sim \mathcal{N}(0, 1)\)이므로, 일반적으로 \(a_j\)가 평균 0, 분산 \(\sigma_a^2\)이라고 가정하는 것이 합리적이다. 모든 것이 (대략) 평균 0이고 독립이므로 \(z_i\)의 크기는 다음과 같다.
\[z_i = \sum_j W_{ij} a_j, \qquad E[z_i^2] = \sum_j E[W_{ij}^2] \, E[a_j^2] = D_a \sigma_W^2 \sigma_a^2\]여기서 \(D_a\)는 \(a\)의 차원이다.
- \(D_a \sigma_W^2 > 1\)이면 층마다 크기가 커진다.
- \(D_a \sigma_W^2 < 1\)이면 층마다 크기가 줄어든다.
따라서 \(\sigma_W^2 = 1/D_a\)로 고르면 된다. 즉 \(W_{ij}\)의 표준편차를 약 \(1/\sqrt{D_a}\)로 한다. 이것을 흔히 Xavier 초기화라 부른다. 이렇게 하면 깊은 층에서도 활성화 분포가 훨씬 잘 유지된다.
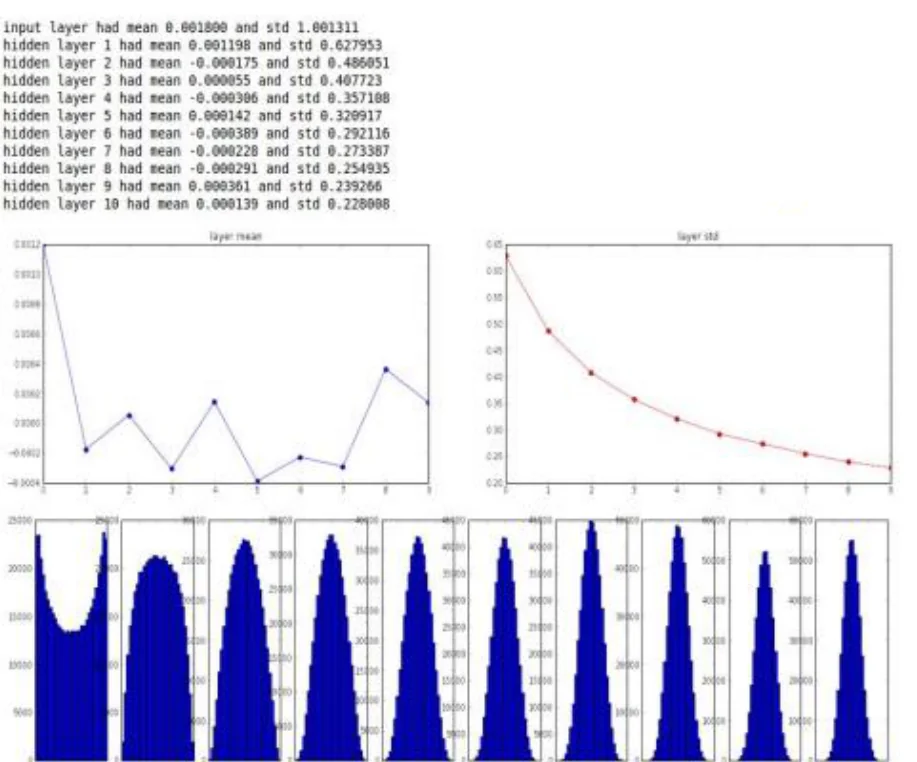 Xavier 초기화를 쓴 같은 10층 신경망의 층별 활성화 통계. 표준편차가 0.63에서 0.23 정도로 천천히 줄 뿐이고, 히스토그램이 모든 층에서 적당히 퍼져 있다. 출처: CS 182 Lecture 7 slides (그림: Fei-Fei Li & Andrej Karpathy).
앞의 그림과 비교하면 차이가 분명하다. 10층의 표준편차가 0.000000이 아니라 0.228이고, 아래 히스토그램도 모든 층에서 종 모양으로 퍼져 있어 활성화가 정보를 담고 있다. 그래도 표준편차가 층마다 조금씩 줄어드는 것은, 이 실험이 tanh 같은 비선형 함수를 썼고 위의 유도는 비선형 함수를 무시했기 때문이다. 아래의 ReLU 보정은 이런 차이를 비선형 함수에 맞춰 바로잡는 것이다.
ReLU의 작은 디테일
위 계산은 비선형 함수가 없다고 가정했다. \(a_j = \mathrm{ReLU}(z_j)\)이면 평균 0인 활성화의 “음수 절반”이 제거되어 분산이 절반으로 준다. 이를 보정하려면 표준편차를 다음과 같이 잡는다.
\[\mathrm{std}(W_{ij}) \approx \frac{1}{\sqrt{\tfrac{1}{2} D_a}} = \sqrt{\frac{2}{D_a}}\]별것 아닌 차이 같지만 층이 쌓이면 누적된다. He et al.이 ResNet에서 제안한 방식(He 초기화)으로, 150층 이상에서는 큰 차이를 만든다.
더 작은 디테일: ReLU와 편향
\(b_i \approx 0\)으로 두면 평균적으로 유닛의 절반이 처음부터 0을 출력하는 “죽은” 상태가 된다. 그래서 편향을 \(b_i = 0.1\) 같은 작은 양의 상수로 초기화하는 경우가 많다.
고급 초기화: 직교 초기화
첫 층 가중치에 대한 기울기는 야코비안들의 곱이다.
\[\frac{d\mathcal{L}}{dW^{(1)}} = \frac{dz^{(1)}}{dW^{(1)}} \frac{da^{(1)}}{dz^{(1)}} \frac{dz^{(2)}}{da^{(1)}} \frac{d\mathcal{L}}{dz^{(2)}}, \qquad \frac{d\mathcal{L}}{dW^{(1)}} = J_1 J_2 J_3 \cdots J_n \frac{d\mathcal{L}}{dz^{(n)}}\]이 곱이 폭발하거나 소실되지 않으려면 각 야코비안이 스케일을 보존하는 변환이면 좋다. 각 가중치 행렬은 특잇값 분해(SVD)로 다음과 같이 쓸 수 있다.
\[W^{(i)} = U^{(i)} \Lambda^{(i)} V^{(i)}\]여기서 특잇값 행렬 \(\Lambda^{(i)}\)를 항등행렬로 강제하면 된다.
\[W^{(i)} \leftarrow U^{(i)} V^{(i)}\]\(U\)와 \(V\)는 정규직교(orthonormal) 기저이므로 이 행렬은 벡터의 길이를 보존한다. 더 간단한 구현은 임의의 무작위 행렬(어떻게 만들든 상관없다)의 SVD를 구해 \(U\) 또는 \(V\) 중 모양이 맞는 쪽을 가중치로 쓰는 것이다. 둘 다 정규직교가 보장되고, 정사각행렬이 아닐 때는 모양에 맞는 쪽을 고른다.
기울기 클리핑
손실 곡면에서 기대하는 것은 매끄럽게 내려가는 경로지만, 실제로는 가끔 거대한 기울기가 나타나 파라미터를 엉뚱한 곳으로 날려 버린다. 원인은 다양하다.
- 잘못된 곳에서 너무 큰 걸음을 내디뎠다.
- 무언가가 아주 작은 값으로 나뉘었다(배치 정규화, softmax 등).
- 그냥 운이 나빴다.
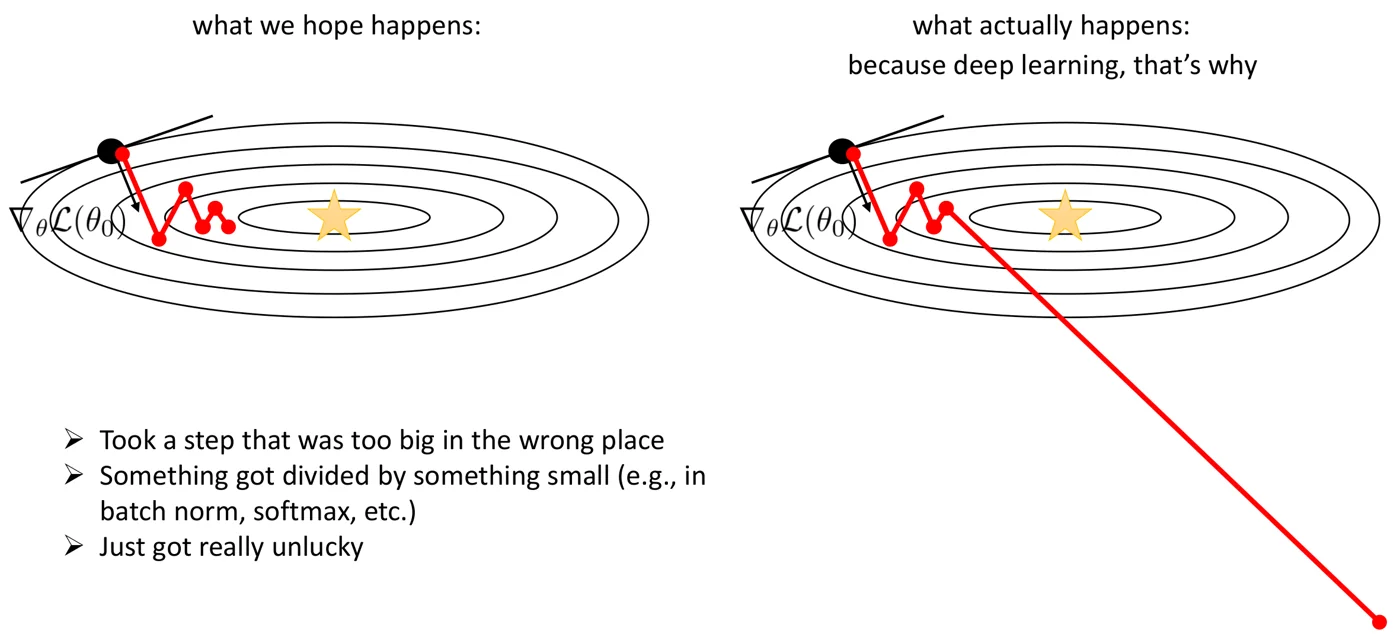 왼쪽은 기대하는 경사하강법 경로(지그재그하더라도 최적점 근처로 수렴), 오른쪽은 실제로 가끔 일어나는 일(한 번의 거대한 기울기로 파라미터가 멀리 날아감)이다. 출처: CS 182 Lecture 7 slides.
오른쪽 그림에서 경로는 처음 몇 걸음은 왼쪽과 같지만, 한 지점에서 기울기가 갑자기 매우 커지면서 손실 곡면 밖 먼 곳으로 튀어 나간다. 그곳에서는 손실이 크고 다시 돌아오는 데 오랜 시간이 걸리거나, 아예 학습이 망가진다. 이 한 걸음만 크기를 제한했다면 경로는 왼쪽처럼 계속 진행했을 것이다. 기울기 클리핑은 바로 그 한 걸음의 길이를 잘라 내는 장치이며, 평소의 “건강한” 걸음에는 영향을 주지 않도록 \(c\)를 정상 크기보다 조금 크게 잡는다.
기울기 클리핑(gradient clipping) 은 이런 “괴물 기울기”를 잘라낸다. 두 가지 방식이 있다.
원소별 클리핑은 각 성분을 \([-c_i, c_i]\) 범위로 자른다.
\[\bar{g}_i \leftarrow \max\!\left(\min(g_i, c_i), -c_i\right)\]노름 클리핑은 방향은 유지하고 길이만 \(c\) 이하로 줄인다.
\[\bar{g} \leftarrow g \, \frac{\min(\lVert g \rVert, c)}{\lVert g \rVert}\]\(c\)는 몇 에폭을 (폭발하지 않는다고 가정하고) 돌려 보고, “건강한” 기울기의 크기가 어느 정도인지 관찰해서 정한다.
앙상블, 드롭아웃, 하이퍼파라미터
모델이 실수를 한다면
신경망은 파라미터가 많아 분산이 높은 경우가 많다. 기본 학습 이론이 예측하는 것만큼 높지는 않지만(과적합이 보통 파국적이지는 않다), 여전히 높다. 흥미로운 아이디어가 있다. 분산이 높은 학습기가 여러 개 있으면, 이들은 정답에는 동의하고 오답에서는 서로 엇갈릴 수 있다. 다르게 말하면 틀리는 방법이 맞는 방법보다 훨씬 많다.
이론적인 앙상블: 배깅
데이터셋 \(\mathcal{D} = \{(x_i, y_i)\}\)가 있다. 서로 독립인 데이터셋 \(M\)개를 어디서 구할까? 하나의 데이터셋에서 만들어낼 수 있다. 각 \(\mathcal{D}_j\)마다 \(\{1, \dots, N\}\)에서 \(N\)개의 인덱스 \(i_{j,1}, \dots, i_{j,N}\)을 무작위로 뽑는다.
\[\mathcal{D}_j = \left\{(x_{i_{j,1}}, y_{i_{j,1}}), \dots, (x_{i_{j,N}}, y_{i_{j,N}})\right\}\]같은 인덱스가 여러 번 뽑힐 수 있다. 이를 복원 추출을 통한 재표본(resampling with replacement) 이라 한다. 각 \(\mathcal{D}_j\)로 별도의 모델 \(p_{\theta_1}(y \mid x), \dots, p_{\theta_M}(y \mid x)\)를 학습한다.
예측할 때의 원칙적인 방법은 확률을 평균하는 것이다.
\[p(y \mid x) = \frac{1}{M} \sum_{j=1}^{M} p_{\theta_j}(y \mid x)\]간단한 방법은 다수결 투표다.
실제 앙상블
신경망 학습에는 이미 무작위성이 많다. 무작위 초기화, 무작위 미니배치 섞기, 확률적 기울기 하강법이 그렇다. 그래서 실제로는 재표본 없이 같은 데이터로 여러 번 학습해도 같은 이점을 상당 부분 얻는다.
더 빠른 앙상블
- 특징 공유: 특징 추출부(어느 정도 과제와 무관하고, 대개 가장 비싼 부분)는 모든 모델이 공유하고, 과제별 분류 층인 “헤드(head)”만 여러 개 두어 앙상블한다.
- 스냅샷 앙상블(snapshot ensembles) (Huang et al., “Train 1, Get M For Free”): 한 번의 SGD 최적화 과정에서 파라미터 스냅샷을 여러 번 저장하고, 각 스냅샷을 앙상블의 한 모델로 쓴다. 학습을 여러 번 돌릴 필요가 없다는 장점이 있지만, 스냅샷끼리 실제로 달라지도록 신중하게 설정해야 한다. 예측을 합칠 때는 확률을 평균하거나 투표하거나, 아예 파라미터 벡터를 평균할 수도 있다.
어느 방식이 얼마나 좋은지는 상황에 따라 다르다.
드롭아웃
앙상블은 클수록 (대개) 잘 작동하지만, 거대한 앙상블은 비싸다. 하나의 신경망으로 여러 모델을 만들 수는 없을까?
드롭아웃(dropout) 은 순전파에서 일부 활성화를 무작위로 0으로 만든다. 학습 중에는 각 활성화 \(a_j^{(i)}\)를 다음으로 바꾼다.
\[a_j^{(i)} \leftarrow a_j^{(i)} m_{ij}, \qquad m_{ij} \sim \mathrm{Bernoulli}(0.5)\]즉 마스크는 50% 확률로 1, 아니면 0이다. 매번 일부 유닛이 빠진 “새로운” 신경망이 원래 신경망에서 만들어진다.
왜 이것이 작동할까? 두 가지 관점이 있다.
- 신경망이 중복된 표현(redundant representation) 을 갖도록 강제한다. 예를 들어 “고양이” 점수가 귀, 꼬리, 털, 발톱 같은 특징 중 일부가 빠져도 여전히 높게 나와야 한다.
- 각 드롭아웃 마스크가 서로 다른 모델을 정의한다고 볼 수 있다. 따라서 거대한 앙상블처럼 보인다. 유닛이 \(n\)개이면 가능한 마스크는 \(2^n\)개다.
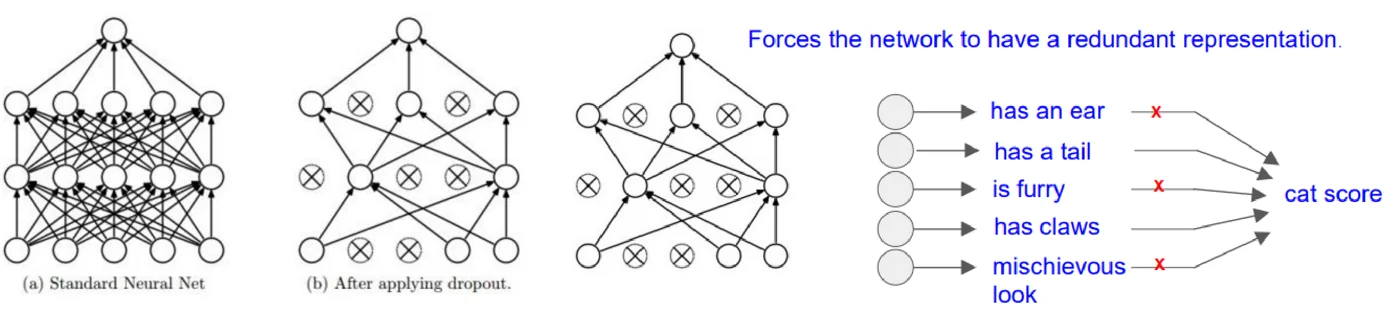 드롭아웃. (a)는 원래의 완전연결 신경망, (b)와 그 오른쪽 그림은 서로 다른 무작위 마스크로 유닛 일부(×)를 지운 두 개의 “얇은” 신경망이다. 오른쪽은 일부 특징이 지워져도 “고양이 점수”를 낼 수 있도록 중복된 특징을 학습하게 된다는 그림이다. 출처: CS 182 Lecture 7 slides.
(b)와 그 오른쪽 그림을 비교하면 지워진 유닛의 위치가 다르다. 미니배치마다 이렇게 다른 부분 네트워크가 학습되지만, 남은 유닛의 가중치는 모두 원래 네트워크와 공유된다. 그래서 하나의 네트워크 안에 수많은 부분 네트워크의 앙상블이 들어 있는 셈이다. 오른쪽 그림에서는 “귀가 있다”, “털이 있다”, “장난스러운 표정” 특징이 이번 순전파에서 지워졌지만(빨간 ×), 남은 “꼬리가 있다”, “발톱이 있다”만으로도 고양이 점수가 높아야 한다. 어떤 특징 하나에 지나치게 의존하는 것이 막히므로 표현이 중복되고 견고해진다.
테스트 시의 드롭아웃
테스트 시에는 모든 모델을 합치고 싶다. 드롭아웃 마스크를 많이 만들어 평균할 수도 있지만, 그냥 테스트 때 드롭아웃을 끄면 어떨까?
학습 때는 평균적으로 차원의 \(\tfrac{1}{2}\)이 0이었다. 테스트 때는 아무것도 0이 아니므로 \(W^{(i)} a^{(i)}\)가 약 2배 커진다. 해결책은 가중치를 절반으로 나누는 것이다.
\[\bar{W}^{(i)} = \tfrac{1}{2} W^{(i)}\]실제 구현에서는 반대로 학습 때 마스크를 유지 확률 \(p\)로 나누는 경우가 많다(역 드롭아웃, inverted dropout). 그러면 테스트 시의 순전파는 전혀 바꿀 필요가 없다.
하이퍼파라미터
이 모든 요령에는 하이퍼파라미터가 많다. 성격에 따라 두 종류로 나뉜다.
- 최적화(학습)에 영향을 주는 것: 학습률, 모멘텀, 초기화, 배치 정규화
- 일반화(검증)에 영향을 주는 것: 앙상블, 드롭아웃, 구조(층의 개수와 크기)
고르는 방법은 다음과 같다.
- 어떤 하이퍼파라미터가 어느 쪽인지 구분한다. 이것이 정말 중요할 수 있다.
- 잘못된 학습률, 모멘텀, 초기화 등은 학습 초반에 바로 드러난다.
- 구조의 효과는 보통 학습이 끝나야 드러난다.
- 거친 탐색에서 세밀한 탐색으로(coarse to fine) 간다. 넓게 훑은 뒤 좋은 영역으로 좁힌다.
- 격자 탐색(grid search)보다 무작위 탐색(random search)을 고려한다.
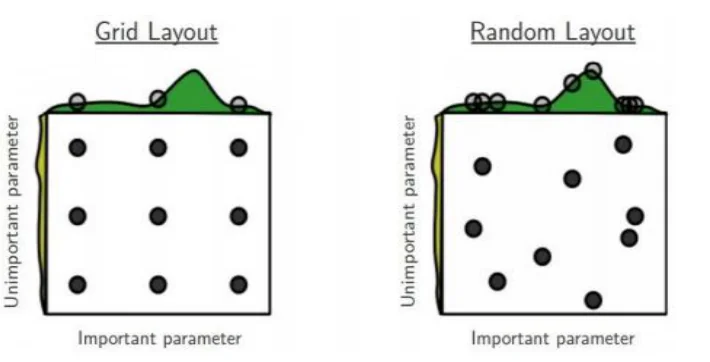 두 하이퍼파라미터에 대한 격자 탐색(왼쪽)과 무작위 탐색(오른쪽). 가로축은 성능에 큰 영향을 주는 파라미터, 세로축은 영향이 거의 없는 파라미터이며, 위쪽 초록 곡선은 중요한 파라미터에 따른 성능이다. 출처: CS 182 Lecture 7 slides.
왼쪽 격자 탐색은 9번 시도하지만, 중요한 파라미터의 값은 3가지만 시험한다. 세로 방향으로 같은 열에 있는 세 점은 성능이 거의 같으므로 시도 횟수의 3분의 2가 낭비된다. 오른쪽 무작위 탐색은 같은 9번의 시도로 중요한 파라미터의 서로 다른 값 9개를 시험하므로, 초록 곡선의 봉우리 근처를 찾을 가능성이 훨씬 크다. 실제로는 어떤 하이퍼파라미터가 중요한지 미리 모르는 경우가 많으므로 무작위 탐색이 더 안전하다.
예를 들어 학습률과 가중치 감쇠(weight decay)를 로그 스케일로 놓고 5 에폭 정도 짧게 돌려 보는 탐색이 유용하다.
정리
- 입력(회귀라면 출력도)을 차원별로 평균 0, 표준편차 1로 표준화하면 손실 곡면이 덜 찌그러져 최적화가 쉬워진다.
- 배치 정규화는 활성화를 미니배치 통계로 표준화한 뒤 학습 가능한 \(\gamma\), \(\beta\)를 적용한다. 더 큰 학습률과 빠른 학습을 가능하게 하고 정규화 필요성을 줄인다.
- 초기화의 목표는 활성화와 기울기의 스케일 유지다. \(E[z_i^2] = D_a \sigma_W^2 \sigma_a^2\)에서 Xavier는 \(\sigma_W^2 = 1/D_a\), ReLU용 He 초기화는 \(\sigma_W^2 = 2/D_a\)를 쓴다.
- 직교 초기화는 SVD로 특잇값을 1로 만들어 야코비안 곱의 폭발·소실을 막는다. ReLU 편향은 작은 양수로 초기화하기도 한다.
- 기울기 클리핑(원소별 또는 노름)은 가끔 나타나는 거대한 기울기를 억제한다.
- 앙상블은 분산을 줄인다. 학습의 무작위성만으로도 충분하며, 헤드 공유나 스냅샷 앙상블로 비용을 줄일 수 있다.
- 드롭아웃은 \(2^n\)개 모델의 암묵적 앙상블이며, 테스트 시에는 가중치(또는 학습 시 활성화)를 유지 확률에 맞게 스케일한다.
- 최적화 관련 하이퍼파라미터는 학습 초반에 판단할 수 있고, 거친 탐색에서 세밀한 탐색으로, 격자보다 무작위 탐색이 낫다.